Map

Map 接口概述

前面介绍的 List、Set、Queue 都从 Collection 这条线展开,保存的是一个个成员。Map 则单独定义了映射关系:通过一个键,找到它当前对应的值。

每个键最多对应一个值,但不同的键可以对应相同的值。因此,Map.size() 统计的是映射数量,不是键与值加起来的对象数量。是否允许 null、键怎样判定重复、遍历是否有顺序,都要继续看具体实现。

1
2
3
4
5
Map<String, Integer> scores = new HashMap<>();
System.out.println(scores.put("Java", 90)); // null:原来没有映射
System.out.println(scores.put("Java", 95)); // 90:返回旧值,映射数量不变
scores.put("SQL", 95); // 不同键允许相同值
System.out.println(scores.size()); // 2

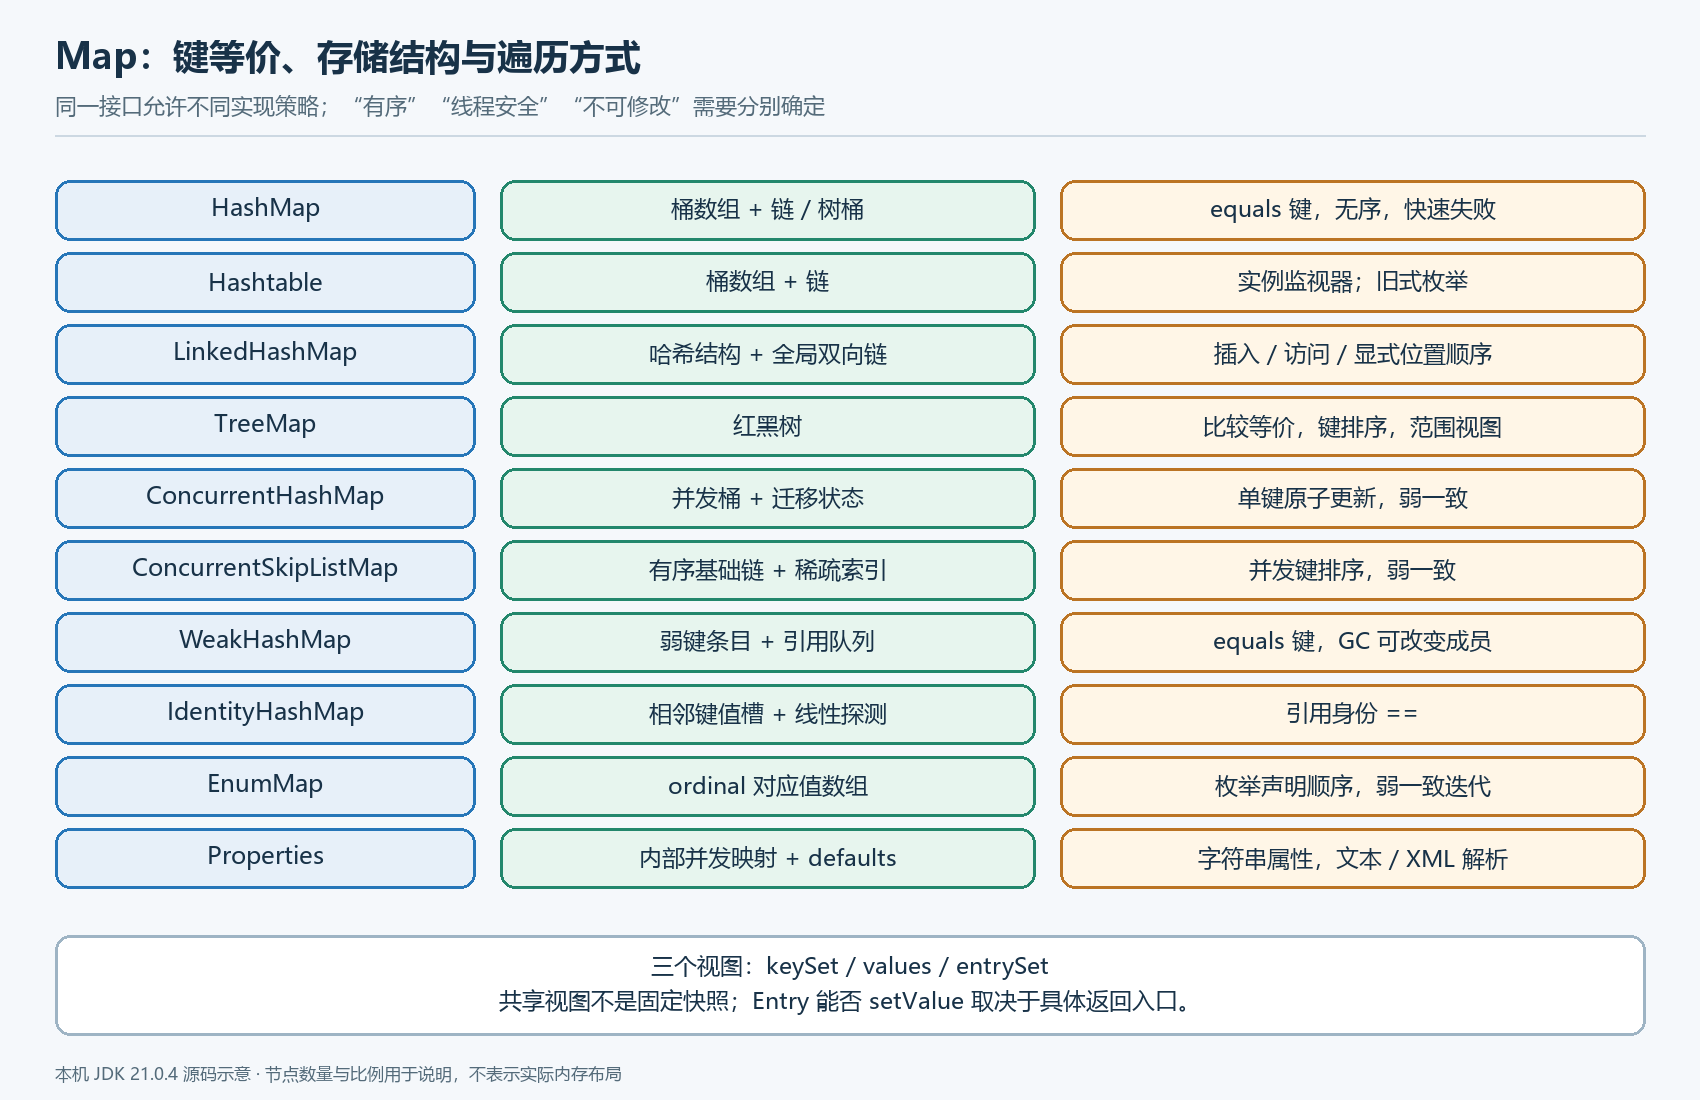
这里需要区分接口规定与实现细节。例如,HashMap 使用 hashCode() 和 equals(),TreeMap 用比较结果确定键的位置与重复,IdentityHashMap 采用引用身份。
Map 的结构、顺序与同步方式

常见操作与 null 的含义

get 返回当前值,put 返回原值,remove(key) 返回被移除的原值。对于允许 null 值的实现,这些方法返回 null 可能有两种含义:没有映射,或者存在键但对应值就是 null。

1
2
3
4
5
6
Map<String, Integer> map = new HashMap<>();
map.put("known", null);
System.out.println(map.get("known")); // null
System.out.println(map.containsKey("known")); // true
System.out.println(map.getOrDefault("known", 100)); // null,不替换已存在的 null
System.out.println(map.getOrDefault("missing", 100)); // 100

getOrDefault 只在没有键时使用默认值,putIfAbsent 则把“没有键”与“映射值为 null”都视为可以写入的状态。computeIfAbsent 在这两种状态下计算,函数返回 null 时不建立新的非空映射。

computeIfPresent 只处理已有非空值;compute 对存在与否都计算;merge 在已有非空值时合并,否则直接使用传入的非空值。计算或合并函数返回 null,通常表示删除相应映射。不同实现怎样保证原子性,还要看覆盖的方法,普通 Map 默认方法不提供统一的并发事务保证。

1
2
3
4
5
6
Map<String, Integer> counts = new HashMap<>();
counts.merge("Java", 1, Integer::sum);
System.out.println(counts.get("Java")); // 2
counts.compute("Java", (key, old) -> null);
System.out.println(counts.containsKey("Java")); // false

三种集合视图与 Entry

Map 本身不实现 Iterable,不能直接 for (var x : map)。它通过 keySet()、values()、entrySet() 提供遍历入口。

这些通常是共享底层映射的视图。对支持删除的视图执行 remove 或 clear,会影响原映射;原映射更新也会反映到视图。values() 是 Collection,允许重复值;另外两个视图是 Set。

1
2
3
4
5
6
7
8
9
Map<String, Integer> map = new LinkedHashMap<>();
map.put("A", 1);
map.put("B", 1);
System.out.println(map.values()); // [1, 1]
map.keySet().remove("A");
for (Map.Entry<String, Integer> entry : map.entrySet()) {
entry.setValue(entry.getValue() + 10); // 本实现的活动 Entry 支持写回
}
System.out.println(map); // {B=11}

不是所有 Entry 都能 setValue。TreeMap.firstEntry() 等导航结果返回的是不支持修改的快照;并发有序映射的条目也有相应限制。创建独立记录可以使用 SimpleImmutableEntry;Map.entry 和 Entry.copyOf 还会拒绝 null。

一般的视图不支持凭空 add 一个键或一个值,因为单独一方不能确定完整映射;某些并发实现额外提供可添加的键视图,后面单独说明。

JDK 21 的顺序接口

SequencedMap 表达明确的遇见顺序,提供 firstEntry、lastEntry、pollFirstEntry、pollLastEntry、putFirst、putLast 和 reversed 等入口。LinkedHashMap 能显式调整映射位置,SortedMap 则由键的比较规则决定顺序。

所以,顺序接口并不意味着每个实现都允许把任意键强放到头部。TreeMap.putFirst/putLast 抛出 UnsupportedOperationException,排序约束仍优先成立;反向视图一般共享映射,不是自动复制出的独立快照。

下面从普通哈希映射开始,再看保序、排序、并发及专用实现怎样落实这些行为。

HashMap

基本特性

我们先看最常用的 HashMap。它继承 AbstractMap,实现 Map、Cloneable 和 Serializable,以哈希表保存键值映射。允许一个 null 键,允许多个键对应 null 值,不保证插入顺序或遍历顺序,也没有并发访问保护。

键唯一性的依据是哈希值与 equals() 的协作:相等的键应有相同的 hashCode(),哈希值相同的键却不一定相等。冲突的不同键仍可以保存在同一个桶里,所以说不能把哈希碰撞理解为覆盖。

1
2
3
4
5
6
7
Map<String, Integer> map = new HashMap<>();
map.put(new String("A"), 1);
System.out.println(map.put(new String("A"), 2)); // 1,逻辑相等的键覆盖旧值
map.put(null, null);
map.put("B", null);
System.out.println(map.size()); // 3
System.out.println(map.containsKey(null)); // true

正常哈希分布下,get、put、remove 的预期成本接近 O(1);扩容需要遍历旧表,成本与旧容量及成员数量有关,正常负载关系下可达 O(n)。

HashMap 存的是对象的引用,不是对象的快照。尤其是键已经放入之后,修改参与 hashCode/equals 的字段,可能导致用同一个对象都找不到原映射,此时节点保存旧的扰动哈希,查找却按照键当前状态计算新位置。也就是说,这个键在 map 里位置对不上了,连用它自己都查不到原来的值。

HashMap 找键分两步:

  1. 存的时候:根据 key.hashCode() 算出一个“哈希值”,再经过扰动运算,决定这个键值对放在哪个桶(数组下标)里。
  2. 查的时候:拿你传进来的 key,重新算一次当前 hashCode(),再定位到桶里去找。

关键点在于:节点里保存的是放入那一刻算好的旧哈希值,而查找时用的是键当前状态算出来的新哈希值。

1
2
3
4
5
6
7
8
9
10
11
class Key {
int id;
Key(int id) { this.id = id; }
public int hashCode() { return id; }
public boolean equals(Object o) { return o instanceof Key k && id == k.id; }
}
Key key = new Key(1);
Map<Key, String> map = new HashMap<>();
map.put(key, "value");
key.id = 2;
System.out.println(map.get(key)); // null:原节点不是按当前哈希存放的

所以说,一般用不可变对象当 key,这样放进去就不会再变。

结构分析

底层字段包括 Node<K,V>[] table、size、threshold、loadFactor 和 modCount。table 保存桶入口,普通节点保存 hash/key/value/next,树节点额外保存红黑树链接与颜色。

size 是映射数量,table.length 是桶数量,threshold 是下一次扩容判断使用的阈值。这三个数不是同一个概念。默认负载因子为 0.75,默认首次正常分配桶数量为 16,最大桶数量为 1 << 30。

无参构造时不立刻创建 16 个桶。带初始容量的构造器也通常先把调整后的目标容量存在 threshold,首次写入再分配。因此,这个字段在尚未分配数组时暂时承担初始容量提示的作用。

1
2
3
4
5
6
7
8
9
10
11
12
13
// 先校验参数并保存初始容量提示,构造器此时还没有分配 table。
public HashMap(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal initial capacity: " +
initialCapacity);
if (initialCapacity > MAXIMUM_CAPACITY)
initialCapacity = MAXIMUM_CAPACITY;
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal load factor: " +
loadFactor);
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}
1
2
3
4
5
// JDK 21 用前导零数量计算足够大的 2 的幂,并限制容量上界。
static final int tableSizeFor(int cap) {
int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1);
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}

传入 new HashMap<>(100) 的 100 表达初始桶容量请求,并不是保证放入 100 个映射之前绝不扩容。调整到 128 个桶后,默认阈值约为 96。需要按预计映射数准备空间,可以使用 HashMap.newHashMap(100)。

1
2
3
4
5
6
7
// 工厂按预计映射数量和默认负载因子估算容量,再复用构造路径。
public static <K, V> HashMap<K, V> newHashMap(int numMappings) {
if (numMappings < 0) {
throw new IllegalArgumentException("Negative number of mappings: " + numMappings);
}
return new HashMap<>(calculateHashMapCapacity(numMappings));
}

哈希扰动与桶定位如下:

1
2
3
4
5
// null 键使用 0;非空键把高 16 位混入低位以参与桶定位。
static final int hash(Object key) {
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}

桶下标为 (n - 1) & hash。桶数量为 2 的幂时,可以提取所需低位,并在扩容时只看新增的容量位决定位置;扰动改善某些高位信息无法参与小表索引的问题,但不能修复所有糟糕的 hashCode()。
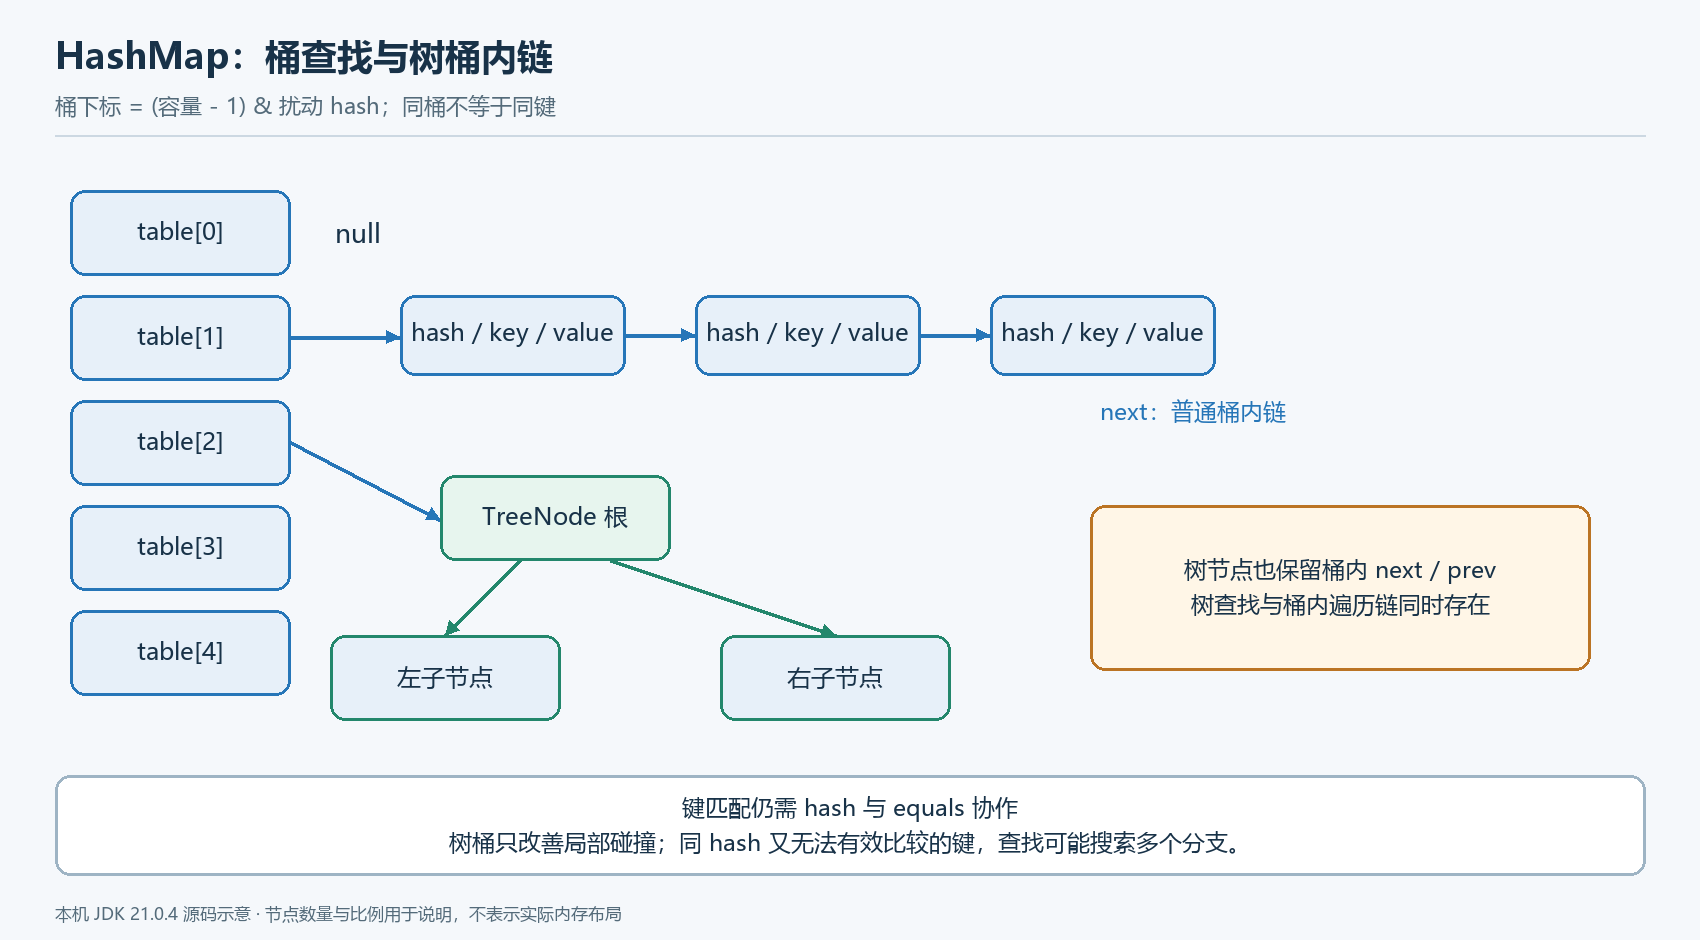
HashMap 的桶、普通节点与树节点

树桶中的节点还保留 next/prev 桶内链接,因此红黑树和桶内遍历链可以同时存在。它不是另建一个 TreeMap,也不要求所有 HashMap 键都实现 Comparable。

基本操作

put:先确定是否已有键,再决定新建映射

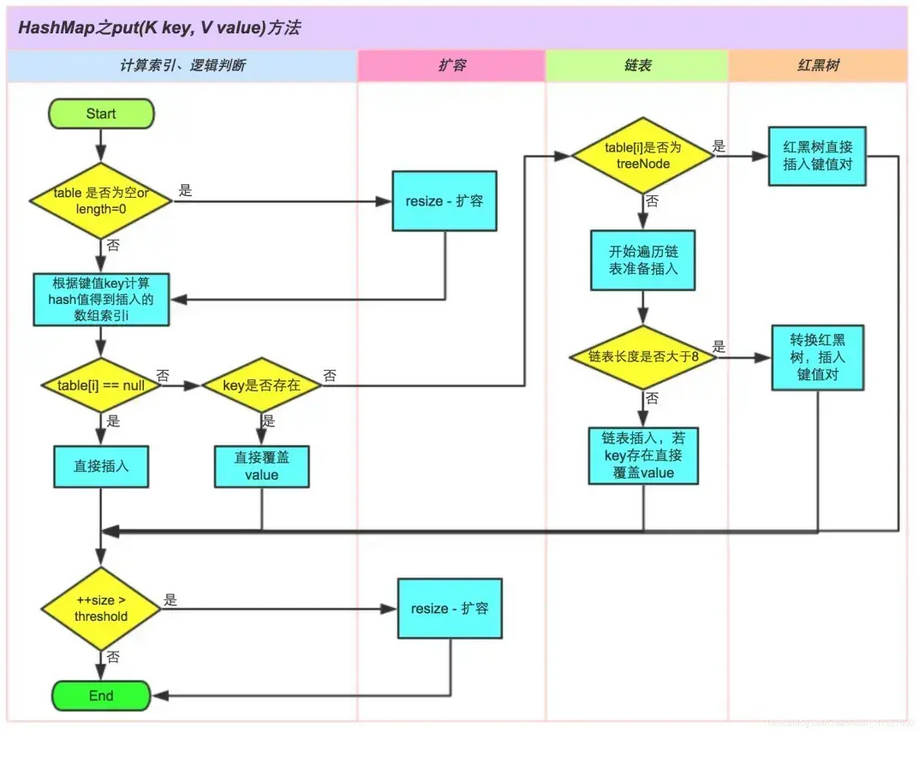
put 调用 putVal(hash(key), key, value, false, true)。把主方法展开后,可以看到空桶、首节点匹配、树桶与普通链表分别处理:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
// 覆盖已有节点只更新值;真正新增映射才更新 size、modCount 和扩容判断。
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);
else {
Node<K,V> e; K k;
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
e = p;
else if (p instanceof TreeNode)
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
else {
for (int binCount = 0; ; ++binCount) {
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
treeifyBin(tab, hash);
break;
}
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
break;
p = e;
}
}
if (e != null) { // existing mapping for key
V oldValue = e.value;
if (!onlyIfAbsent || oldValue == null)
e.value = value;
afterNodeAccess(e);
return oldValue;
}
}
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
++modCount;
// 新映射计数超过阈值时扩容,覆盖旧值不走这个分支。
if (++size > threshold)
resize();
afterNodeInsertion(evict);
return null;
}

键匹配先检查节点保存的 hash,再看是否同一引用或 key.equals(existingKey)。同一个桶不意味着键相同,查找不到等价键时才链接新节点。

覆盖已有键通常不增加 size,也不因普通值替换增加 modCount。节点继续保存原先那个键对象,不会因为用一个新的等价键调用 put,就把原节点的 key 字段替换掉。

onlyIfAbsent 控制是否保留已有非空值,evict 则供 LinkedHashMap 的插入回调等复用。afterNodeAccess、afterNodeInsertion 在普通 HashMap 中是空钩子,子类可以借此维护额外顺序。

树化:8、6、64 必须结合具体路径

常量 TREEIFY_THRESHOLD=8、UNTREEIFY_THRESHOLD=6、MIN_TREEIFY_CAPACITY=64 分别参与树化、拆分后反树化及树化容量判断。

putVal 链表分支里的 binCount 从 0 开始,走到原尾部才追加新节点。对从空桶逐次普通 put 形成的链,已有 8 个节点时再加入第 9 个,才满足这里的 binCount >= 7 并调用 treeifyBin。不能脱离计数方式写成所有入口都是“第 8 个立刻树化”。

computeIfAbsent/compute 有自己的插入与计数路径,触发时点还要看对应实现。常量给出了策略,具体操作中的第几个节点触发,需要继续分析调用代码。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 容量不足 64 时先扩容;足够大时才把普通节点替换成树节点并建树。
final void treeifyBin(Node<K,V>[] tab, int hash) {
int n, index; Node<K,V> e;
if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
resize();
else if ((e = tab[index = (n - 1) & hash]) != null) {
TreeNode<K,V> hd = null, tl = null;
do {
TreeNode<K,V> p = replacementTreeNode(e, null);
if (tl == null)
hd = p;
else {
p.prev = tl;
tl.next = p;
}
tl = p;
} while ((e = e.next) != null);
if ((tab[index] = hd) != null)
hd.treeify(tab);
}
}

小表扩容可能把原来的碰撞链分散到不同桶,减少直接维护树的成本。容量达到 64 不是数学上保证碰撞突然增多,而是源码选择的策略边界。

树内先按扰动后的 hash 分方向;hash 相同时先判断键是否相等,再尝试识别可用的 Comparable 类型与比较结果,无法据此明确区分时使用类名和身份哈希辅助插入定位。

System.identityHashCode 不是公开的内存地址,也不保证各对象之间没有碰撞。辅助定位不替代 equals 的键相等语义。对于相同 hash、又无法获得有效比较方向的不同键,查询可能需要搜索两个分支,不能保证所有树桶查找一律最坏 O(log n)。

resize:不是每个键都重新调用 hashCode
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
// 翻倍扩容按保存的 hash 拆分桶,并保留每个分组内的相对链接顺序。
final Node<K,V>[] resize() {
Node<K,V>[] oldTab = table;
int oldCap = (oldTab == null) ? 0 : oldTab.length;
int oldThr = threshold;
int newCap, newThr = 0;
if (oldCap > 0) {
if (oldCap >= MAXIMUM_CAPACITY) {
threshold = Integer.MAX_VALUE;
return oldTab;
}
else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
oldCap >= DEFAULT_INITIAL_CAPACITY)
newThr = oldThr << 1; // double threshold
}
else if (oldThr > 0) // initial capacity was placed in threshold
newCap = oldThr;
else { // zero initial threshold signifies using defaults
newCap = DEFAULT_INITIAL_CAPACITY;
newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
}
if (newThr == 0) {
float ft = (float)newCap * loadFactor;
newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ?
(int)ft : Integer.MAX_VALUE);
}
threshold = newThr;
@SuppressWarnings({"rawtypes","unchecked"})
Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
table = newTab;
if (oldTab != null) {
for (int j = 0; j < oldCap; ++j) {
Node<K,V> e;
if ((e = oldTab[j]) != null) {
oldTab[j] = null;
if (e.next == null)
newTab[e.hash & (newCap - 1)] = e;
else if (e instanceof TreeNode)
((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
else { // preserve order
Node<K,V> loHead = null, loTail = null;
Node<K,V> hiHead = null, hiTail = null;
Node<K,V> next;
do {
next = e.next;
// 新增的容量位决定留在原桶还是移到原下标加旧容量。
if ((e.hash & oldCap) == 0) {
if (loTail == null)
loHead = e;
else
loTail.next = e;
loTail = e;
}
else {
if (hiTail == null)
hiHead = e;
else
hiTail.next = e;
hiTail = e;
}
} while ((e = next) != null);
if (loTail != null) {
loTail.next = null;
newTab[j] = loHead;
}
if (hiTail != null) {
hiTail.next = null;
newTab[j + oldCap] = hiHead;
}
}
}
}
}
return newTab;
}

默认旧容量 16 扩到 32 时,原桶 i 的成员只可能留在 i,或移到 i + 16。由 e.hash & oldCap 是否为 0 决定,不需要重新对每个用户键调用 hashCode()。
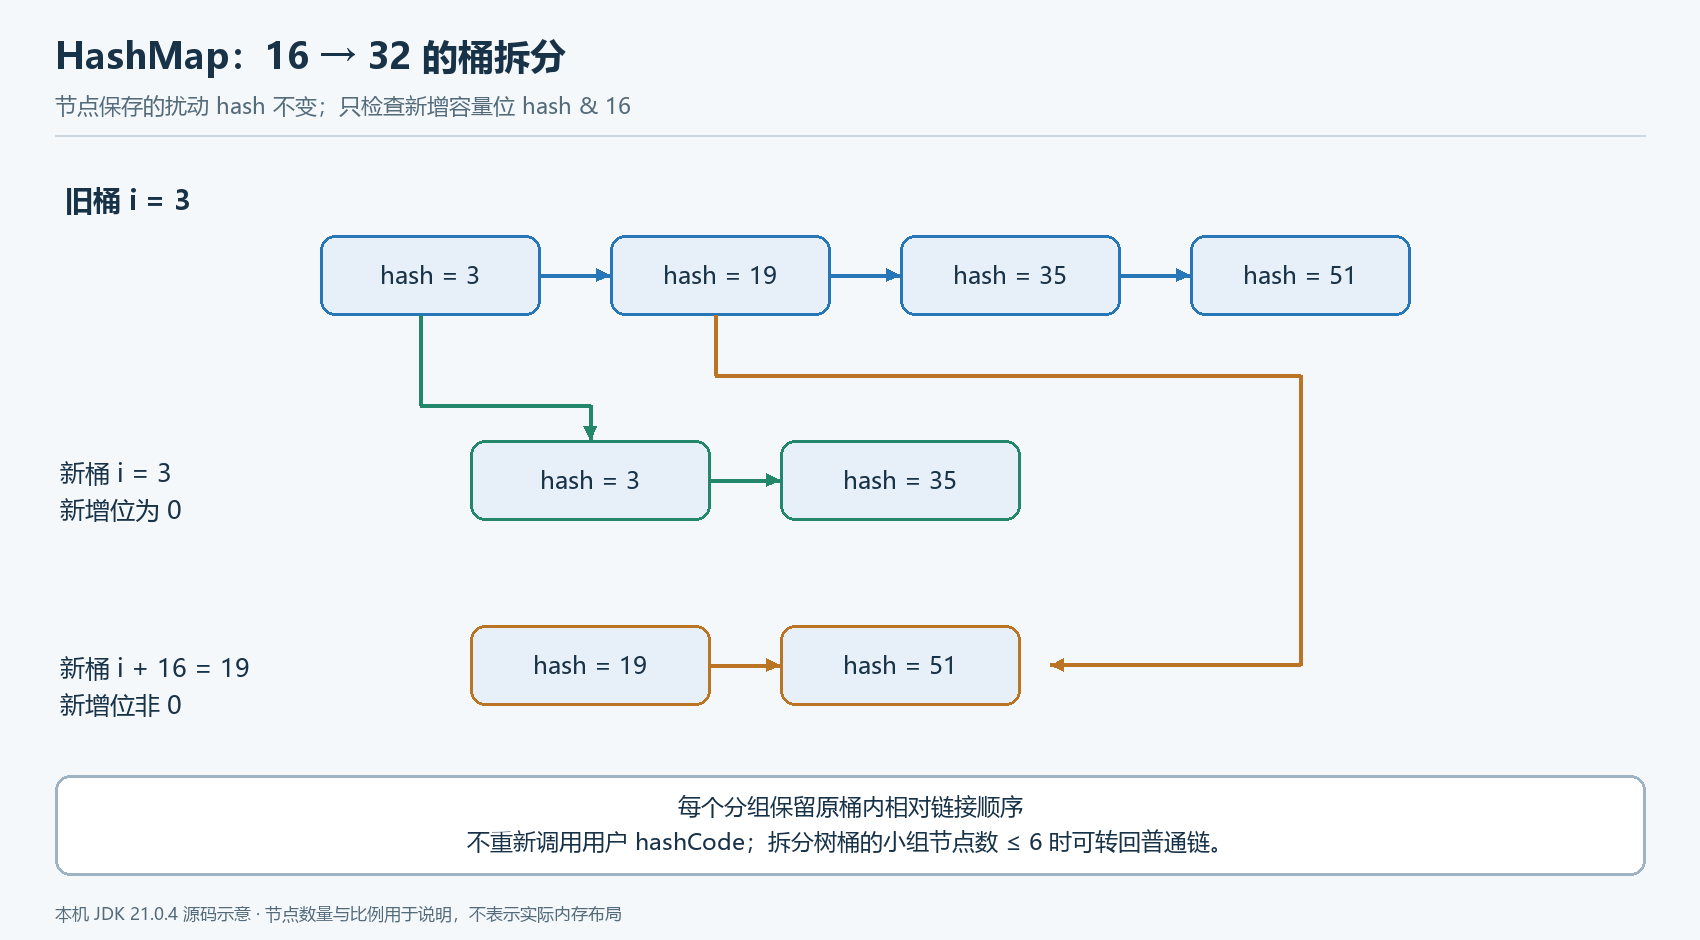
HashMap 扩容时的低位与高位拆分

源码构建 loHead/loTail 和 hiHead/hiTail 两条链,每条链保持原遍历中的相对次序。扩容改变桶分布,不承诺全映射遍历次序稳定,更不提供插入顺序。

树桶由 TreeNode.split 按相同新增位拆分。每组节点数不大于 6 时,可以转回普通链表;仍较大时保留或重建树结构。这是 UNTREEIFY_THRESHOLD 的直接计数用途。

删除路径则不同:removeTreeNode 结合树形与 movable 判断是否太小,不是先统一计数“只要 ≤6 就转链表”。迭代器删除传入的移动控制也会影响这个分支。

最大容量处不会继续无条件翻倍,阈值会调整以避免继续尝试通常的数组扩容。极端容量和内存异常不是正常业务的容量控制方案。

get、remove 与函数式更新

getNode 先看目标桶首节点;必要时进入树查找或沿链查找。containsKey 能区分不存在与已有 null 值,containsValue 则需要扫描桶及成员,最坏成本与 capacity + size 有关,正常负载关系下常写成 O(n),不会因哈希表就得到按值常数时间定位。

删除由 removeNode 找到对应节点,修正桶链接或调用树删除,减少 size,增加 modCount,再调用删除钩子。普通值替换不改变链接,删除映射则是结构修改。

1
2
3
4
5
6
7
Map<String, Integer> map = new HashMap<>();
map.put("A", null);
map.putIfAbsent("A", 10); // 原值为 null,允许写入
map.computeIfAbsent("B", key -> null); // 不建立 B 的映射
System.out.println(map); // 只包含 A=10,顺序不作为契约
System.out.println(map.remove("A", 11)); // false:值不匹配
System.out.println(map.remove("A", 10)); // true:键和值一起核对

函数式入口仍不让普通 HashMap 具备线程安全。计算过程中也不应修改同一映射的结构;通过比较 modCount 尽力发现这类重入并抛出 ConcurrentModificationException,检测不构成事务回滚承诺。

迭代器

HashIterator 在创建时保存 expectedModCount,从桶数组及各桶的 next 链逐一推进。键、值、条目迭代器共用推进逻辑,只返回节点中的不同部分。

源码定位:HashMap.java:1601–1612。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 按桶内链和桶数组推进,返回前检查外部结构修改。
final Node<K,V> nextNode() {
Node<K,V>[] t;
Node<K,V> e = next;
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
if (e == null)
throw new NoSuchElementException();
if ((next = (current = e).next) == null && (t = table) != null) {
do {} while (index < t.length && (next = t[index++]) == null);
}
return e;
}

因此,遍历主要成本与 capacity + size 有关。映射很少、桶数组却很大时,空桶扫描仍有成本;它与沿全局顺序链遍历的 LinkedHashMap 不同。

1
2
3
4
5
6
7
8
9
10
Map<String, Integer> map = new HashMap<>();
map.put("A", 1);
map.put("B", 2);
Iterator<Map.Entry<String, Integer>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<String, Integer> entry = iterator.next();
if (entry.getValue() == 1) iterator.remove();
else entry.setValue(20);
}
System.out.println(map); // {B=20}

迭代器自己的 remove 同步预期修改次数,允许继续推进;外部添加新键、删除映射或 clear 可能导致快速失败。仅覆盖已有键的值一般不是结构修改,所以不能用没有抛异常来证明遍历期间完全没有更新。

快速失败只是尽力检测,不替代同步,也不保证竞争线程每次都能观察到并发错误。需要共享写入时选择适合的并发映射或明确的外部锁,不能凭 JDK 8 之后不再使用旧的链表迁移方式,就认为普通 HashMap 安全。

entrySet 的活动节点支持 setValue 写回,keySet/values 支持删除而不支持普通添加。clone 重新建立结构,但键和值对象仍共享;序列化保存逻辑映射,反序列化重新建表,不保留原来每个桶的位置作为业务顺序。

Hashtable

基本特性

Hashtable 是较早的映射实现,继承 Dictionary,同时实现 Map、Cloneable、Serializable。它没有继承 HashMap,也不包含红黑树桶;底层仍是数组与桶内链表。

它拒绝 null 键和值,按 hashCode/equals 判断键是否相同,不保证遍历顺序。contains 是历史保留的按值查询,含义相当于 containsValue,不能把它当成 containsKey。

1
2
3
4
5
Hashtable<String, Integer> table = new Hashtable<>();
table.put("A", 1);
System.out.println(table.put("A", 2)); // 1
System.out.println(table.contains(2)); // true,检查值
System.out.println(table.containsKey("A")); // true,检查键

主要访问方法以 synchronized 协调同一个实例监视器,因此普通读写也会争用同一个锁。它可以提供方法级线程安全,但不保证任意两个方法组合具有原子性。

例如 if (!table.containsKey(k)) table.put(k,v),两个调用之间仍可被另一个线程插入。需要这类更新时,应使用本类实现的原子复合入口,或让完整组合处于同一个同步协议中。

它目前仍是 JDK 的可用类。大量并发访问通常更适合进一步分析 ConcurrentHashMap 的同步方式。

结构分析

核心字段为 Entry<?,?>[] table、count、threshold、loadFactor 和 modCount。每个 Entry 保存原始 hash、key、value、next,不为碰撞较多的桶转换红黑树。

默认构造器请求容量 11、负载因子 0.75;显式容量一般按给定大小分配,0 被调整为 1。它与 HashMap 的延迟建表、容量调整到 2 的幂并不相同。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 按给定容量立即分配桶数组,并计算扩容阈值。
public Hashtable(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal Capacity: "+
initialCapacity);
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal Load: "+loadFactor);

if (initialCapacity==0)
initialCapacity = 1;
this.loadFactor = loadFactor;
table = new Entry<?,?>[initialCapacity];
threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1);
}

桶索引使用 (hash & 0x7FFFFFFF) % table.length,先去掉符号位,再对任意容量取余。不使用 HashMap 的高低位扰动与 2 的幂掩码定位,也不能把两个类的扩容位置公式混用。
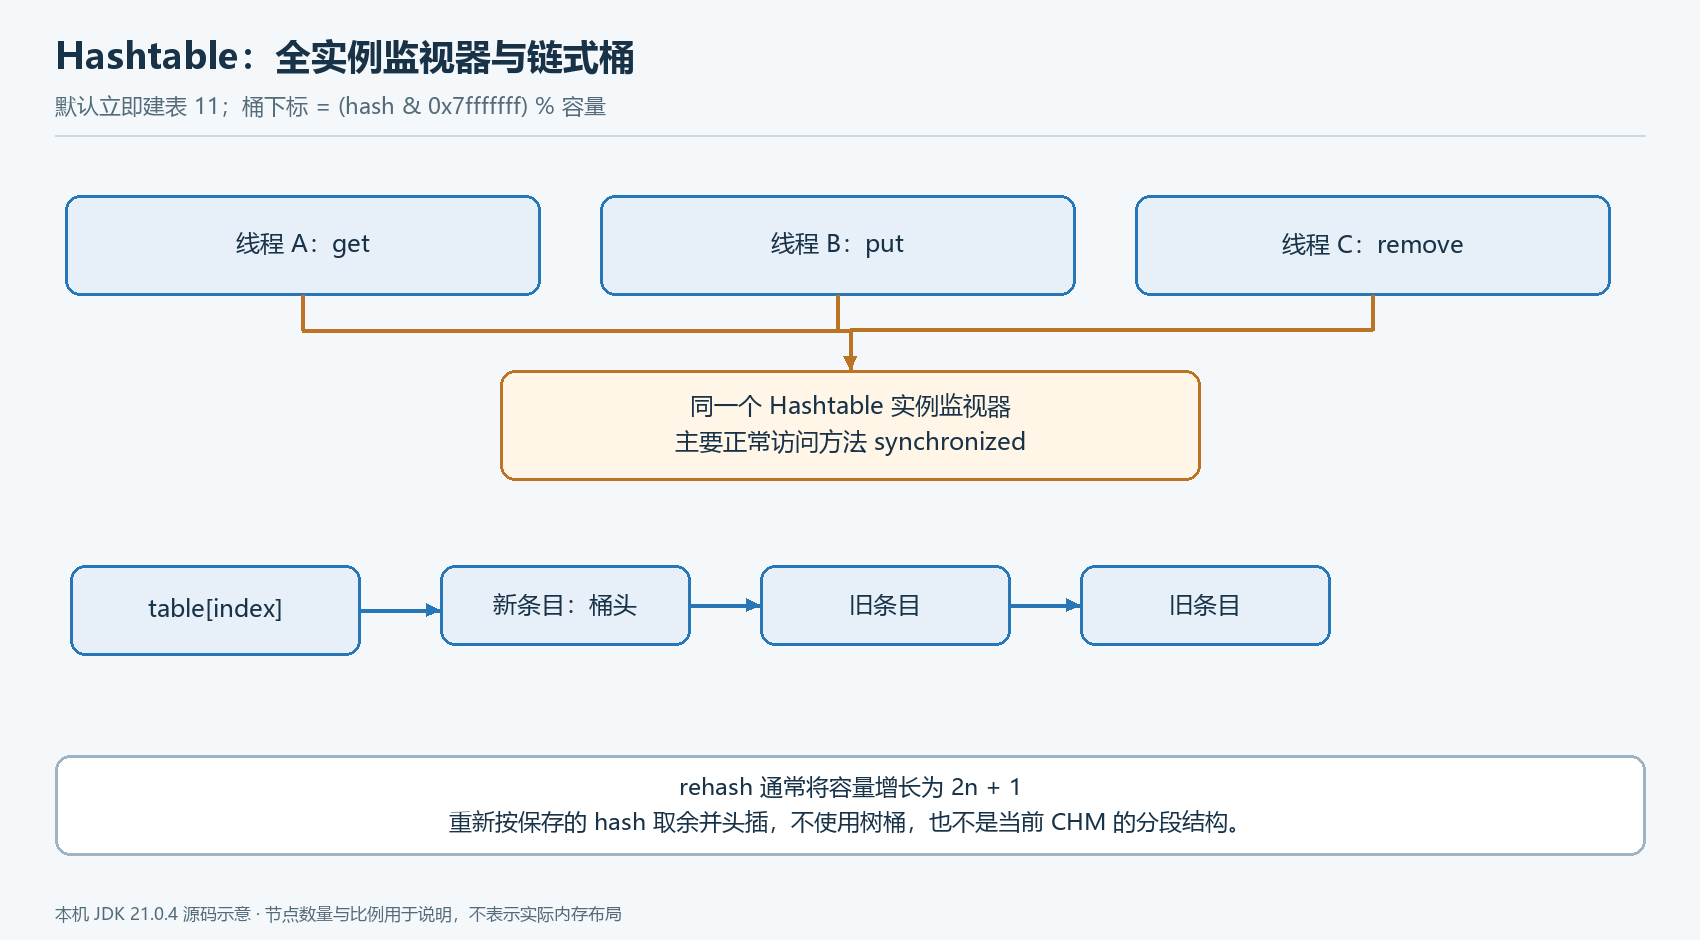
Hashtable 的同一监视器与链式桶

synchronized 保护映射结构及数量,但不自动保护被映射对象的内部字段。多个线程取得同一个可变值之后继续修改它,仍需另外的并发设计。

默认容量较小,碰撞链较长时搜索仍可能线性增长。调用 containsValue 更要遍历多个桶和节点,同时占有实例锁,影响其他线程访问。

基本操作

put:拒绝 null,覆盖或头插

源码定位:Hashtable.java:473–495。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
// 在实例锁下按 hash 和 equals 找旧键,没有旧键才创建新条目。
public synchronized V put(K key, V value) {
// Make sure the value is not null
if (value == null) {
throw new NullPointerException();
}

// Makes sure the key is not already in the hashtable.
Entry<?,?> tab[] = table;
int hash = key.hashCode();
int index = (hash & 0x7FFFFFFF) % tab.length;
@SuppressWarnings("unchecked")
Entry<K,V> entry = (Entry<K,V>)tab[index];
for(; entry != null ; entry = entry.next) {
if ((entry.hash == hash) && entry.key.equals(key)) {
V old = entry.value;
entry.value = value;
return old;
}
}

addEntry(hash, key, value, index);
return null;
}

先检查 value,再调用 key.hashCode,所以 null 值被明确拒绝,null 键也不能沿此路径写入。查找已有等价键时只更新值,返回旧值,不增加 count。

没有旧键就交给 addEntry。节点插入在桶头,与当前 HashMap.putVal 普通链表分支的尾部追加不同;但两者都不承诺用户遍历顺序。

源码定位:Hashtable.java:437–454。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// 容量阈值检查可能先扩容,随后重新算索引并把新节点放到桶头。
private void addEntry(int hash, K key, V value, int index) {
Entry<?,?> tab[] = table;
if (count >= threshold) {
// Rehash the table if the threshold is exceeded
rehash();

tab = table;
hash = key.hashCode();
index = (hash & 0x7FFFFFFF) % tab.length;
}

// Creates the new entry.
@SuppressWarnings("unchecked")
Entry<K,V> e = (Entry<K,V>) tab[index];
tab[index] = new Entry<>(hash, key, value, e);
count++;
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
}

这里判断的是插入前 count >= threshold,必要时先 rehash 再插入。它与 HashMap 新增之后执行 ++size > threshold 的判断位置不同,分析某次写入是否扩容应看实际路径。

新的桶头链入后 count 加一,结构修改增加 modCount。覆盖原值不改变链接;树化常量 8、6、64 对本类没有意义。

rehash:增长为 2n+1,重新分配每条链

源码定位:Hashtable.java:407–435。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
// 新容量通常为旧容量的两倍加一,各节点按保存的原始 hash 重新计算取余位置。
protected void rehash() {
int oldCapacity = table.length;
Entry<?,?>[] oldMap = table;

// overflow-conscious code
int newCapacity = (oldCapacity << 1) + 1;
if (newCapacity - MAX_ARRAY_SIZE > 0) {
if (oldCapacity == MAX_ARRAY_SIZE)
// Keep running with MAX_ARRAY_SIZE buckets
return;
newCapacity = MAX_ARRAY_SIZE;
}
Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];

// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1);
table = newMap;

for (int i = oldCapacity ; i-- > 0 ;) {
for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) {
Entry<K,V> e = old;
old = old.next;

int index = (e.hash & 0x7FFFFFFF) % newCapacity;
e.next = (Entry<K,V>)newMap[index];
newMap[index] = e;
}
}
}

增长上限还要结合最大数组长度和溢出处理,不能在最大容量附近继续机械执行 2n+1。阈值按新容量与负载因子更新,节点再搬到新的桶中。

源码使用节点保存的 hash,不必重新向用户键调用 hashCode。因为新容量不采用单纯 2 的幂翻倍,所以不能使用 hash & oldCapacity 直接分成两个固定目标位置。

迁移采用新桶头插,可能改变桶内次序;原有 Enumeration 又可能保留旧数组和旧节点引用,所以扩容与遍历的关系尤其不能解释为固定快照。

扩容在调用 put 的同步路径内完成,其他普通访问线程需要等待同一实例锁。数组分配、遍历旧节点和重新定位都是这次写入成本的一部分。

get 与 remove:完整链扫描受同一锁保护
1
2
3
4
5
6
7
8
9
10
11
12
// 读取也获取实例锁,再沿取余定位的桶链查找等价键。
public synchronized V get(Object key) {
Entry<?,?> tab[] = table;
int hash = key.hashCode();
int index = (hash & 0x7FFFFFFF) % tab.length;
for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {
if ((e.hash == hash) && e.key.equals(key)) {
return (V)e.value;
}
}
return null;
}

get 返回 null 可以表示不存在,因为本类不允许 null 值。查询 null 键仍会因调用其 hashCode 失败,不能理解成“找不到任意非法键都返回 null”。

删除相应桶中的节点时,需要修正桶入口或前驱 next,减少 count 并增加 modCount。被删节点的 value 会清空,减少它通过旧引用无必要地保留值对象。

1
2
3
4
5
6
Hashtable<String, Integer> table = new Hashtable<>();
table.put("A", 1);
table.put("B", 1);
System.out.println(table.remove("A", 2)); // false
System.out.println(table.remove("A", 1)); // true
System.out.println(table.containsValue(1)); // true,B 仍然存在

普通 remove(key) 与 remove(key,value) 不同,后者同时验证现有值。不能先 get 再 remove 假定中间没有更新;本类的条件删除在对应同步方法中完成。

compute 与 merge:同步覆盖方法

本类覆盖了 putIfAbsent、条件 replace/remove、computeIfAbsent、compute 和 merge 等方法,使用实例锁完成相应读取及更新,不只是继承普通 Map 的默认组合。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
// 在同一实例锁下查找并计算,函数返回 null 时不新建映射。
public synchronized V computeIfAbsent(K key, Function<? super K, ? extends V> mappingFunction) {
Objects.requireNonNull(mappingFunction);

Entry<?,?> tab[] = table;
int hash = key.hashCode();
int index = (hash & 0x7FFFFFFF) % tab.length;
@SuppressWarnings("unchecked")
Entry<K,V> e = (Entry<K,V>)tab[index];
for (; e != null; e = e.next) {
if (e.hash == hash && e.key.equals(key)) {
// Hashtable not accept null value
return e.value;
}
}

int mc = modCount;
// 用户函数参与本次计算,不能在其中递归修改相同映射。
V newValue = mappingFunction.apply(key);
if (mc != modCount) { throw new ConcurrentModificationException(); }
if (newValue != null) {
addEntry(hash, key, newValue, index);
}

return newValue;
}

函数运行期间仍然占有监视器,因此耗时网络调用或复杂回调可能阻塞其他无关键的读写。同步锁可重入也不表示回调可以任意修改本映射;源码会比较 modCount 检查结构重入,抛异常不等于撤销已经发生的副作用。

1
2
3
4
5
6
Hashtable<String, Integer> counts = new Hashtable<>();
counts.computeIfAbsent("A", key -> 1);
counts.merge("A", 2, Integer::sum);
System.out.println(counts.get("A")); // 3
counts.compute("A", (key, old) -> null);
System.out.println(counts.isEmpty()); // true

clear 清空所有桶并把 count 重置,数组通常保留供复用,不自动缩回 11。clone 复制映射结构但共享键和值对象,不能把方法级线程安全扩大为整个对象图的复制隔离。

迭代器

它保留两套使用入口:keys()/elements() 返回 Enumeration,集合视图则提供 Iterator。两套入口内部可能都由 Enumerator 实现,但有明确的模式标记。

Enumeration 使用 hasMoreElements/nextElement,不支持 Iterator 式删除,也不做相同的 modCount 快速失败检查。没有抛出 ConcurrentModificationException,不表示遍历是安全快照或能稳定看到所有成员。

Iterator.next 则先核对 expectedModCount,再调用相同的取元素过程:

源码定位:Hashtable.java:1496–1500。

1
2
3
4
5
6
// 作为 Iterator 使用时先检查结构修改次数,Enumeration 的 nextElement 不走此检查。
public T next() {
if (Hashtable.this.modCount != expectedModCount)
throw new ConcurrentModificationException();
return nextElement();
}

它从保留的桶数组反向寻找非空桶,再沿链推进,因此遍历成本与容量及成员数有关,不具有插入顺序。

1
2
3
4
5
6
7
8
Hashtable<String, Integer> table = new Hashtable<>();
table.put("A", 1);
table.put("B", 2);
Iterator<Map.Entry<String, Integer>> iterator = table.entrySet().iterator();
while (iterator.hasNext()) {
if (iterator.next().getValue() == 1) iterator.remove();
}
System.out.println(table); // {B=2}

迭代器 remove 在 synchronized(Hashtable.this) 中按记录节点身份找到条目并解除链接,更新真实及预期修改次数。尚未 next 或已经删除过时,仍要遵守 IllegalStateException 等使用规则。

源码定位:Hashtable.java:1502–1531。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
// Enumerator 的删除仅限 Iterator 模式,锁定真实映射后修复桶链与数量。
public void remove() {
if (!iterator)
throw new UnsupportedOperationException();
if (lastReturned == null)
throw new IllegalStateException("Hashtable Enumerator");
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();

synchronized(Hashtable.this) {
Entry<?,?>[] tab = Hashtable.this.table;
int index = (lastReturned.hash & 0x7FFFFFFF) % tab.length;

@SuppressWarnings("unchecked")
Entry<K,V> e = (Entry<K,V>)tab[index];
for(Entry<K,V> prev = null; e != null; prev = e, e = e.next) {
if (e == lastReturned) {
if (prev == null)
tab[index] = e.next;
else
prev.next = e.next;
expectedModCount++;
lastReturned = null;
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
Hashtable.this.modCount++;
Hashtable.this.count--;
return;
}
}
throw new ConcurrentModificationException();
}
}

删除时比较节点引用 e == lastReturned,而不是重新用一个临时键对象寻找等价成员。这能把本次返回的条目与桶中的实际节点对应起来,找到之后更新 expectedModCount,让同一迭代器合法继续推进。此处 lastReturned 置空,但并没有像普通 remove(key) 那样额外把已删除节点的 value 置空;不同删除入口的引用清理细节应分别看源码。

Enumerator 创建时保存数组引用,迭代推进本身也不把所有用户操作装进实例锁。外部同步应覆盖完整循环,而不只是每个 next 单独调用时的局部时刻。Enumeration 的无快速失败检查,更不能替代这种完整遍历协议。

需要一个期间不发生修改的完整遍历,可以让遍历过程与所有写入共同遵守 synchronized(table)。只在调用 iterator() 时获得一次锁,不能保护后面的整个循环;锁住某个视图对象也不一定是底层实例使用的监视器。

活动条目可以 setValue,但拿到 Entry 之后的直接写入并不能自动覆盖整个业务对象生命周期。因此,线程安全容器的普通方法与外部持有条目后如何使用,是不同的边界。

本类的主要价值在历史兼容接口及同步映射语义。理解其结构与旧式遍历能够帮助阅读相关代码,而不是把所有 Hashtable 子类都认定为使用同一张父类桶表,后面的 Properties 就是一个重要例外。

LinkedHashMap

基本特性

LinkedHashMap 在 HashMap 基础上增加双向链表。但这里的链不是用来代替哈希定位,而是把散落在不同桶中的所有映射串成一条独立的遇见顺序,由此做到有序,它可以按插入顺序或访问顺序维护元素顺序。

它继承 HashMap,实现 SequencedMap,保留允许 null 键和值、键按 hashCode/equals 识别的基本规则;不提供并发保护。默认按插入顺序遍历,也能通过构造参数选择访问顺序。

1
2
3
4
5
LinkedHashMap<String, Integer> map = new LinkedHashMap<>();
map.put("B", 2);
map.put("A", 1);
map.put("B", 20); // 默认插入顺序下,覆盖已有键不改变其位置
System.out.println(map); // {B=20, A=1}

get/put/remove 的正常预期定位成本与 HashMap 接近,额外维护少量顺序链接。遍历则沿全局链访问,通常为 O(size),不依赖桶数组容量;这并不保证在任意负载下都比 HashMap 快。

访问顺序构造器传入第三个参数 true。此时一些成功访问已有映射的操作,会把它移动到最近访问端,适用于表达 LRU 淘汰顺序。

1
2
3
4
5
6
LinkedHashMap<String, Integer> map = new LinkedHashMap<>(16, 0.75f, true);
map.put("A", 1);
map.put("B", 2);
map.put("C", 3);
map.get("A");
System.out.println(map); // {B=2, C=3, A=1}

访问顺序不是按 value 或访问次数排序。它记录的是哪些映射最近被指定操作访问。

结构分析

底层仍是 HashMap 的桶数组、普通链表及树桶。每个 LinkedHashMap.Entry 继承普通 Node,再增加 before/after;全局 head/tail 表示顺序链的两端,accessOrder 控制普通访问行为。
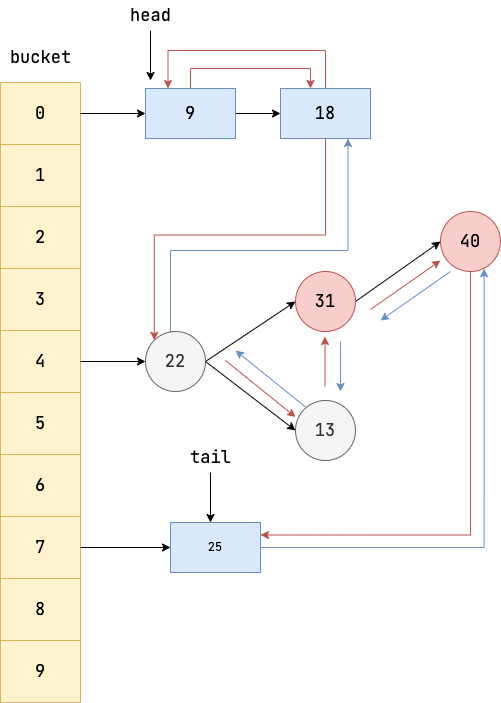
LinkedHashMap 逻辑结构

同一个条目同时属于桶内查找结构与全局顺序链。桶内 next 用于碰撞处理,before/after 用于完整映射的遇见顺序;这两类链接不能互相替代。

树节点同样保留这些顺序字段,所以某个桶树化或反树化时,需要通过 replacement 方法把原条目的前后关系转移到新节点。树形如何变化,不应破坏全局的顺序关系。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 节点类型替换时把原来的全局前后链接交给新节点,修正顺序端点。
private void transferLinks(LinkedHashMap.Entry<K,V> src,
LinkedHashMap.Entry<K,V> dst) {
LinkedHashMap.Entry<K,V> b = dst.before = src.before;
LinkedHashMap.Entry<K,V> a = dst.after = src.after;
if (b == null)
head = dst;
else
b.after = dst;
if (a == null)
tail = dst;
else
a.before = dst;
}

HashMap 留出的 newNode/replacementNode/newTreeNode/replacementTreeNode 和三个回调钩子,让子类可以接入顺序维护,不必重新写一整套哈希表算法。
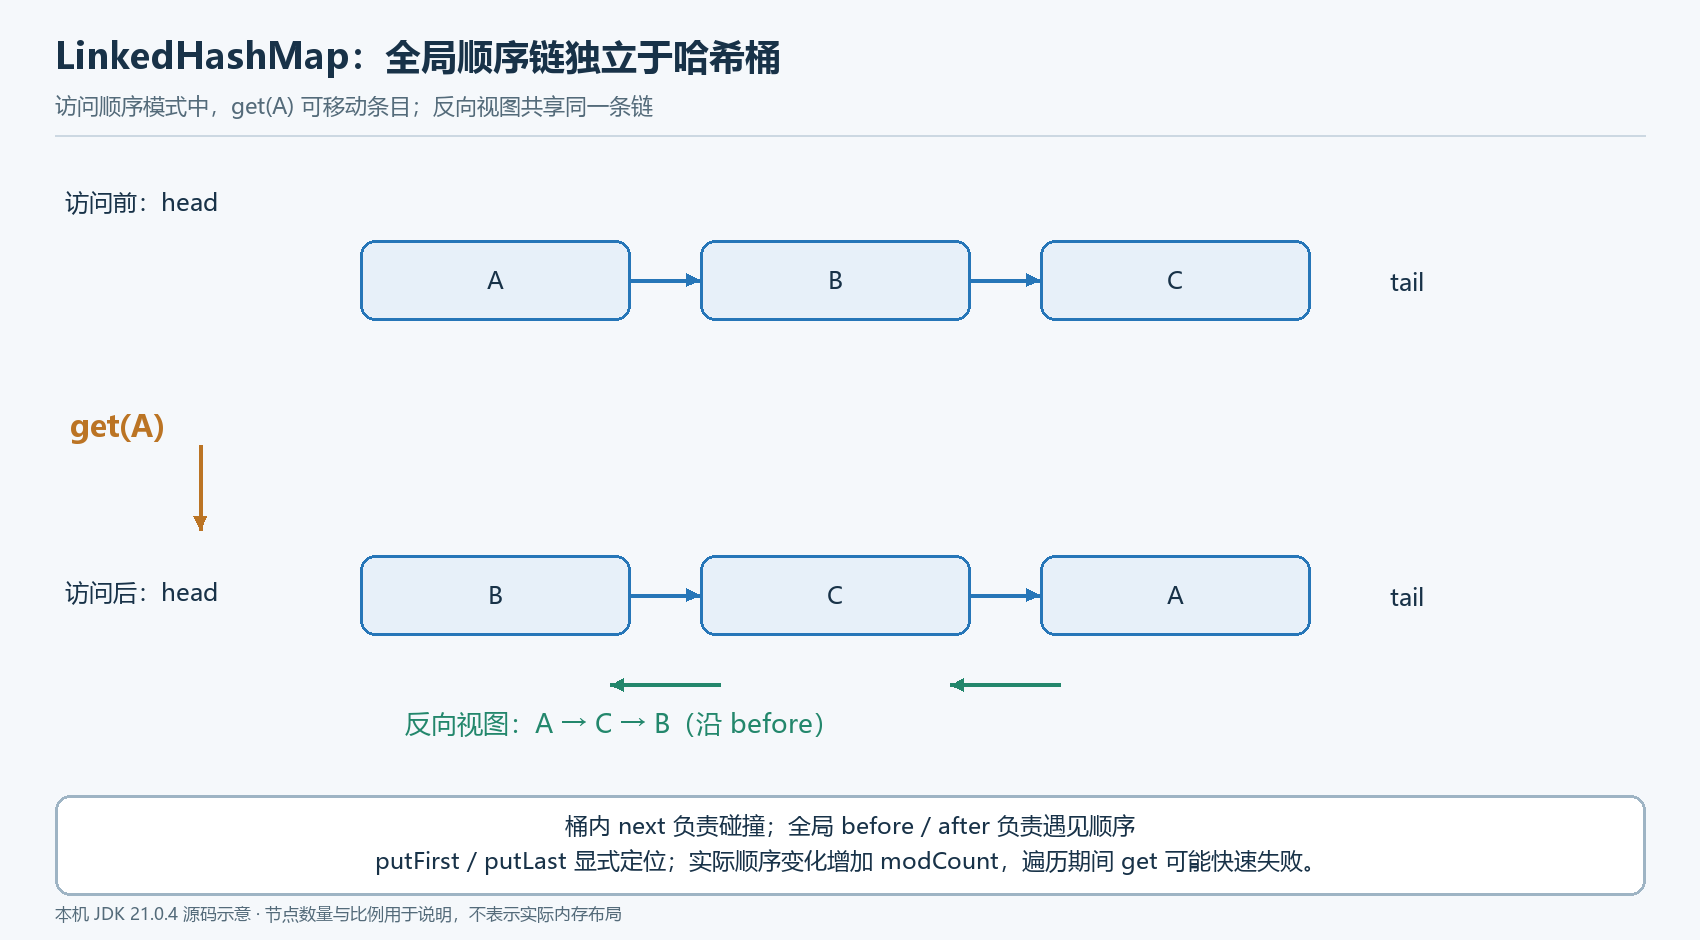
LinkedHashMap 的访问重排与反向视图

JDK 21 还增加 putMode:普通模式、显式头部模式和显式尾部模式。源码需要区分“普通访问导致重排”与 putFirst/putLast 直接指定位置,不能把新增端点方法简单当成访问操作。

基本操作

插入与覆盖:复用 HashMap,回调维护顺序

普通 put 复用 HashMap 的主路径。新条目创建时接到顺序链相应端点;已有键被覆盖时,HashMap 调用 afterNodeAccess,子类再根据 accessOrder 与 putMode 决定是否重排。

默认插入模式下,重复 put 原有键保留位置。删除再重新插入则是一次新的加入,通常来到顺序末尾,不能把两种更新方式视为同一种顺序语义。

1
2
3
4
5
6
LinkedHashMap<String, Integer> map = new LinkedHashMap<>();
map.put("A", 1);
map.put("B", 2);
map.remove("A");
map.put("A", 3);
System.out.println(map); // {B=2, A=3}

删除回调 afterNodeRemoval 从顺序链中摘下条目,同时修正 head/tail;哈希桶中的移除由父类完成。两个结构都正确更新,视图的遍历与哈希定位才能一致。

源码定位:LinkedHashMap.java:308–320。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 父类完成桶内移除之后,顺序链分别处理前驱、后继和两端边界。
void afterNodeRemoval(Node<K,V> e) { // unlink
LinkedHashMap.Entry<K,V> p =
(LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after;
p.before = p.after = null;
if (b == null)
head = a;
else
b.after = a;
if (a == null)
tail = b;
else
a.before = b;
}

先保存 p.before 与 p.after,再把被删条目自己的链接清空,避免外部暂时持有条目时继续拖住相邻链。前驱为空表示删除头部,要让 head 指向后继;后继为空表示删除尾部,要让 tail 指向前驱。删除唯一成员时两种条件同时成立,head/tail 都变为 null。

这种端点处理也解释了为什么只维护一个方向不够:从头向后遍历看似正常时,反向视图仍可能经过没有修复的 before 到达已删节点。父类负责哈希成员关系,子类负责遇见顺序关系,两部分共同完成一次删除。

clear 也同时清空父类哈希表和 head/tail,不通过逐个迭代删除实现整个过程。数组容量通常仍可复用;链为空不表示数组内存自动缩为零。

clone 会重建映射结构及顺序链接,复制当前遇见顺序,但键和值引用仍共享。若值是可变列表,修改克隆映射里的同一列表仍会被原映射看到。序列化沿本类的顺序链写出逻辑键值,而不是将桶位置当成固定遇见顺序。

get:在访问顺序模式里可能是结构修改
1
2
3
4
5
6
7
8
9
// 查找仍使用哈希结构,成功时按 accessOrder 决定是否移动到访问末端。
public V get(Object key) {
Node<K,V> e;
if ((e = getNode(key)) == null)
return null;
if (accessOrder)
afterNodeAccess(e);
return e.value;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
// 根据访问策略或显式位置模式,把已有条目移到头部或尾部并记录顺序变化。
void afterNodeAccess(Node<K,V> e) {
LinkedHashMap.Entry<K,V> last;
LinkedHashMap.Entry<K,V> first;
if ((putMode == PUT_LAST || (putMode == PUT_NORM && accessOrder)) && (last = tail) != e) {
// move node to last
LinkedHashMap.Entry<K,V> p =
(LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after;
p.after = null;
if (b == null)
head = a;
else
b.after = a;
if (a != null)
a.before = b;
else
last = b;
if (last == null)
head = p;
else {
p.before = last;
last.after = p;
}
tail = p;
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
++modCount;
} else if (putMode == PUT_FIRST && (first = head) != e) {
// move node to first
LinkedHashMap.Entry<K,V> p =
(LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after;
p.before = null;
if (a == null)
tail = b;
else
a.before = b;
if (b != null)
b.after = a;
else
first = a;
if (first == null)
tail = p;
else {
p.after = first;
first.before = p;
}
head = p;
++modCount;
}
}

从链中摘下 p 时,要修正其前后邻居;链接到尾部时,要修正旧 tail.after 与 p.before。空端点也要分别处理,不能只执行一次交换。

成功移动会增加 modCount,因为遇见顺序发生了结构变化。如果该条目本来就是末端,访问未必实际移动,也就不必同样增加次数。

containsKey 不触发访问重排,视图遍历和 Entry.setValue 也不按 get 的方式登记访问。put、getOrDefault、compute、merge 等是否形成访问,要结合文档规定的成功条件与父类钩子分析,而不是任何“读到对象”都算一次。

反向视图访问同样作用于底层策略:把条目移动到原映射末端,就会表现为移动到反向视图的前端。不能因为从反向视图 get,就认定底层 LRU 次序被独立保存了一份。

putFirst / putLast:明确指定位置

源码定位:LinkedHashMap.java:392–399。

1
2
3
4
5
6
7
8
9
// 临时设置头部模式,复用 put,并在 finally 恢复普通模式。
public V putFirst(K k, V v) {
try {
putMode = PUT_FIRST;
return this.put(k, v);
} finally {
putMode = PUT_NORM;
}
}

显式位置方法既能加入新映射,也能给已有键更新值并移动位置。finally 恢复 putMode,避免异常路径让后续普通 put 继续沿用错误的位置策略。

1
2
3
4
5
6
7
8
LinkedHashMap<String, Integer> map = new LinkedHashMap<>();
map.put("A", 1);
map.put("B", 2);
map.putFirst("B", 20);
map.putLast("C", 3);
System.out.println(map); // {B=20, A=1, C=3}
System.out.println(map.firstEntry()); // B=20,不可修改的端点条目快照
System.out.println(map.pollLastEntry()); // C=3,移除原尾端

端点快照不允许 setValue;sequencedEntrySet() 的活动条目则与普通 entrySet 类似。相同的 Entry 接口返回类型,不意味着这些对象的修改能力相同。

removeEldestEntry:有容量的 LRU 示例

每次真正新增映射之后,afterNodeInsertion 根据 removeEldestEntry 决定是否移除当前 head:

1
2
3
4
5
6
7
8
// 插入完成之后询问是否淘汰当前最旧条目,默认策略不会自动删除。
void afterNodeInsertion(boolean evict) { // possibly remove eldest
LinkedHashMap.Entry<K,V> first;
if (evict && (first = head) != null && removeEldestEntry(first)) {
K key = first.key;
removeNode(hash(key), key, null, false, true);
}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
class Lru<K, V> extends LinkedHashMap<K, V> {
final int limit;
Lru(int limit) {
super(16, 0.75f, true);
if (limit < 0) throw new IllegalArgumentException();
this.limit = limit;
}
protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
return size() > limit;
}
}
Lru<String, Integer> cache = new Lru<>(2);
cache.put("A", 1);
cache.put("B", 2);
cache.get("A");
cache.put("C", 3);
System.out.println(cache); // {A=1, C=3},B 是最近最少访问的映射

策略在插入后检查,所以条件是大于上限,而不是大于等于。这里只根据映射数量淘汰一个最旧条目,不自动管理对象字节大小、过期时间或加载失败。

覆盖已有值通常不走新增淘汰钩子。通过显式位置移动,也可能改变“谁是最旧”的业务含义;访问顺序缓存若开放这些 API,应明确是否允许绕过普通最近访问规则。

这个 LRU 仍不是并发缓存,get 也可能调整链接。多个线程共同使用时,只给 put 加锁不能保护结构,读取与淘汰要遵守同一同步方案。

reversed 与有序视图

reversed() 返回共享原映射的 SequencedMap 视图,头尾操作映射到另一端,反向迭代沿 before 推进。对视图增删会影响原映射,不额外建表或复制值对象。

1
2
3
4
5
6
7
LinkedHashMap<String, Integer> original = new LinkedHashMap<>();
original.put("A", 1);
original.put("B", 2);
SequencedMap<String, Integer> reversed = original.reversed();
reversed.putFirst("C", 3); // 映射到原来的 putLast
System.out.println(original); // {A=1, B=2, C=3}
System.out.println(reversed); // {C=3, B=2, A=1}

sequencedKeySet/Values/EntrySet 提供相应遇见顺序的视图。需要独立副本时,应明确新建映射并复制;反转方向与固定创建时的内容,是两个不同操作。

迭代器

普通键、值、条目迭代器都继承 LinkedHashIterator,保存 next、current、expectedModCount 和 reversed。正向从 head 开始,反向从 tail 开始。

源码定位:LinkedHashMap.java:1020–1029。

1
2
3
4
5
6
7
8
9
10
11
12
// 直接沿全局 before/after 链推进,不扫描空哈希桶。
final LinkedHashMap.Entry<K,V> nextNode() {
LinkedHashMap.Entry<K,V> e = next;
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
if (e == null)
throw new NoSuchElementException();
current = e;
next = reversed ? e.before : e.after;
return e;
}

因此,正常完整遍历通常为 O(size)。容量过大仍会影响数组空间,但不会像 HashMap 一样必须逐个扫描全部空桶才能遍历到每个映射。

迭代器 remove 通过父类删除入口删掉当前映射,并同步 expectedModCount,既修复桶内结构也修复顺序链。绕过当前迭代器在外部删除则可能快速失败。

访问顺序模式里尤其要留意,遍历期间调用 map.get 也可能使 modCount 改变:

1
2
3
4
5
6
7
8
9
10
11
LinkedHashMap<String, Integer> map = new LinkedHashMap<>(16, 0.75f, true);
map.put("A", 1);
map.put("B", 2);
Iterator<String> iterator = map.keySet().iterator();
System.out.println(iterator.next()); // A
map.get("A"); // A 被移动,遇见顺序发生变化
try {
iterator.next();
} catch (ConcurrentModificationException e) {
System.out.println("order changed");
}

需要遍历条目值时直接使用 entry.getValue,避免为了取得同一值再次用 get 干扰访问顺序。快速失败仍然只是诊断机制,不保证竞态一定被检测到。

相关 spliterator 保留 ORDERED 等特征。顺序来自全局链,而不是键排序;复制到 HashMap 后也不能依赖这份遇见顺序继续保留。选择本类,主要是为了让映射的遍历和端点语义有明确规则。

TreeMap

基本特性

TreeMap 继承 AbstractMap,实现 NavigableMap,而 NavigableMap 又扩展 SortedMap。JDK 21 的 SortedMap 也属于 SequencedMap 体系,因此可以按比较顺序访问端点与反向视图。

它按键排序,不按值排序;通过比较结果为 0 确定已有键。自然排序要求键能够进行相容比较,自定义比较器则由调用者决定排序和等价关系。

1
2
3
4
TreeMap<String, Integer> map = new TreeMap<>(Comparator.comparingInt(String::length));
map.put("AA", 1);
System.out.println(map.put("BB", 2)); // 1,长度比较为 0,覆盖同一位置
System.out.println(map); // {AA=2},原键对象仍保留

如果比较规则与 equals 不一致,虽然树本身仍按比较器工作,但与普通 Map 的相等契约可能产生不相容结果。需要长度相同的不同字符串都保留时,比较器可以继续比较字符串内容。

自然排序不接受 null 键;比较器能够处理 null 时可以接受一个 null 键。null 值不参与键排序,可以保存。它不是线程安全映射,正常 get/put/remove 的树高成本为 O(log n)。

1
2
3
4
5
TreeMap<Integer, String> map = new TreeMap<>(Comparator.nullsFirst(Comparator.naturalOrder()));
map.put(2, null);
map.put(null, "empty-key");
map.put(1, "one");
System.out.println(map.keySet()); // [null, 1, 2]

containsValue 仍需沿成员搜索,通常 O(n)。值没有建立独立的排序树,不能因为类名有 Tree,就把按值查询也归为对数复杂度。

结构分析

每个 Entry 保存 key/value/left/right/parent/color,字段 root 指向根,size 统计成员,comparator 保存比较规则,modCount 记录结构变化。没有哈希桶数组,不使用键的 hashCode 来定位。
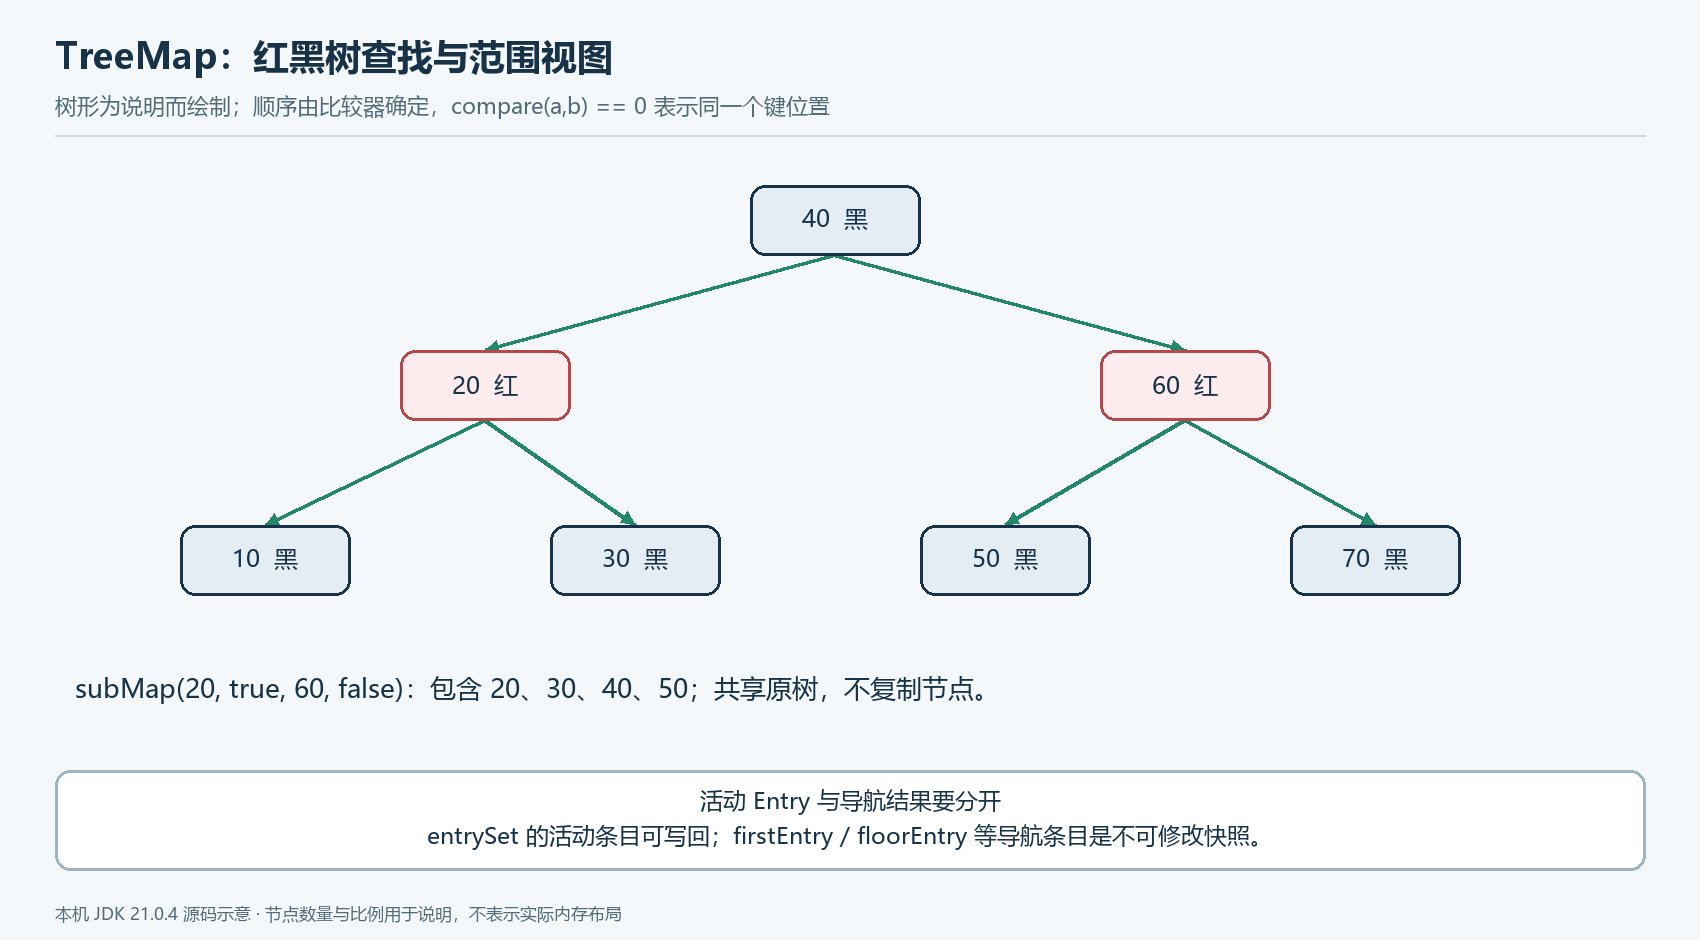
TreeMap 的红黑树与导航方向

红黑树要保持根为黑色、红节点不能直接连红孩子、从同一节点到各个空叶子的黑节点数相同等约束。空叶子按黑色理解,这些约束让树高不因顺序插入退化成线性链。

旋转主要改变父子链接,保留搜索树的中序关系;变色调整路径黑高。不能将“红黑树有序”理解成物理节点在数组里有连续下标,更没有公开的按第几个成员 O(1) 定位接口。

新键插入后通常先标红,再修复相邻关系。黑色根、叔叔颜色与局部形状共同决定变色和左/右旋转,不是每次插入都必须执行旋转。

基本操作

put:比较决定方向与覆盖

公开 put 调用内部 put(key,value,true)。核心逻辑如下:

源码定位:TreeMap.java:817–865。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
// 比较结果小于 0 向左,大于 0 向右,等于 0 更新已有节点。
private V put(K key, V value, boolean replaceOld) {
Entry<K,V> t = root;
if (t == null) {
addEntryToEmptyMap(key, value);
return null;
}
int cmp;
Entry<K,V> parent;
// split comparator and comparable paths
Comparator<? super K> cpr = comparator;
if (cpr != null) {
do {
parent = t;
cmp = cpr.compare(key, t.key);
if (cmp < 0)
t = t.left;
else if (cmp > 0)
t = t.right;
else {
V oldValue = t.value;
if (replaceOld || oldValue == null) {
t.value = value;
}
return oldValue;
}
} while (t != null);
} else {
Objects.requireNonNull(key);
@SuppressWarnings("unchecked")
Comparable<? super K> k = (Comparable<? super K>) key;
do {
parent = t;
cmp = k.compareTo(t.key);
if (cmp < 0)
t = t.left;
else if (cmp > 0)
t = t.right;
else {
V oldValue = t.value;
if (replaceOld || oldValue == null) {
t.value = value;
}
return oldValue;
}
} while (t != null);
}
addEntry(key, value, parent, cmp < 0);
return null;
}

比较器路径和自然排序路径分开,避免每一步都重复判断比较模式。自然排序会先检查键非 null 并转换到 Comparable;比较器路径允许比较器自己决定合法键范围。

找到等价位置时返回旧值,节点键通常保留原对象,size 与 modCount 不增加。找不到则把新 Entry 连到相应父节点,调用插入修复,再增加数量和修改次数。

第一项没有父节点也不能省去合法性检查:

1
2
3
4
5
6
7
8
// 空树也先比较 key 与自身,以尽早执行类型和 null 校验。
private void addEntryToEmptyMap(K key, V value) {
compare(key, key); // type (and possibly null) check
root = new Entry<>(key, value, null);
size = 1;
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
}

这一步防止第一个完全不可比较的键被悄悄放进空树,等到第二次查询时才暴露问题。后续能否与其他键相容,还要由同一比较规则保证。

fixAfterInsertion:叔叔、父节点与旋转
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
// 先标红;按叔叔颜色进行变色或旋转,最后将根设黑。
private void fixAfterInsertion(Entry<K,V> x) {
x.color = RED;

while (x != null && x != root && x.parent.color == RED) {
if (parentOf(x) == leftOf(parentOf(parentOf(x)))) {
Entry<K,V> y = rightOf(parentOf(parentOf(x)));
if (colorOf(y) == RED) {
setColor(parentOf(x), BLACK);
setColor(y, BLACK);
setColor(parentOf(parentOf(x)), RED);
x = parentOf(parentOf(x));
} else {
if (x == rightOf(parentOf(x))) {
x = parentOf(x);
rotateLeft(x);
}
setColor(parentOf(x), BLACK);
setColor(parentOf(parentOf(x)), RED);
rotateRight(parentOf(parentOf(x)));
}
} else {
Entry<K,V> y = leftOf(parentOf(parentOf(x)));
if (colorOf(y) == RED) {
setColor(parentOf(x), BLACK);
setColor(y, BLACK);
setColor(parentOf(parentOf(x)), RED);
x = parentOf(parentOf(x));
} else {
if (x == leftOf(parentOf(x))) {
x = parentOf(x);
rotateRight(x);
}
setColor(parentOf(x), BLACK);
setColor(parentOf(parentOf(x)), RED);
rotateLeft(parentOf(parentOf(x)));
}
}
}
// 完成修复后保持红黑树根为黑色。
root.color = BLACK;
}

父节点已经是黑色时,新增红节点没有破坏红红相邻约束,可以结束。父节点是红色时,就继续看叔叔:叔叔也红,父叔变黑、祖父变红,并向上检查;叔叔黑或不存在,则先把折线形状旋到合适方向,再调整父祖颜色并旋转祖父。

源码左右两边是镜像分支。阅读时把父节点位于祖父左侧的一边弄清楚,再反向理解另一边,比记若干没有父子关系的旋转口诀更可靠。

普通覆盖值不会执行插入修复,因为树的键顺序和节点关系没有改变。键的比较字段若在入树后被直接修改,则不是一次受树协调的覆盖操作,可能破坏搜索方向。

get 与邻近键导航

getEntry 使用与插入相同的比较规则向左或向右;比较结果为 0 就是目标。lower/floor/ceiling/higher 进一步寻找相邻边界,区分严格关系与包含相等位置。

方法 返回键与参数的关系
lowerKey / lowerEntry 严格小于
floorKey / floorEntry 小于或等于
ceilingKey / ceilingEntry 大于或等于
higherKey / higherEntry 严格大于
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
// 在搜索方向中保留不大于目标的候选,必要时沿父链接回退。
final Entry<K,V> getFloorEntry(K key) {
Entry<K,V> p = root;
while (p != null) {
int cmp = compare(key, p.key);
if (cmp > 0) {
if (p.right != null)
p = p.right;
else
return p;
} else if (cmp < 0) {
if (p.left != null) {
p = p.left;
} else {
Entry<K,V> parent = p.parent;
Entry<K,V> ch = p;
while (parent != null && ch == parent.left) {
ch = parent;
parent = parent.parent;
}
return parent;
}
} else
return p;

}
return null;
}

例如向左搜索但没有左子树,当前节点太大,就沿父链接寻找曾经从其右侧进入的祖先;它才可能是比当前节点更小的合法候选。找不到时返回 null。

1
2
3
4
5
6
TreeMap<Integer, String> map = new TreeMap<>();
map.put(10, "A"); map.put(20, "B"); map.put(30, "C");
System.out.println(map.lowerKey(20)); // 10
System.out.println(map.floorKey(20)); // 20
System.out.println(map.ceilingKey(25)); // 30
System.out.println(map.higherKey(30)); // null

firstKey/lastKey 在空树上抛异常,firstEntry/lastEntry 返回 null。pollFirstEntry/pollLastEntry 则取得端点快照并删除映射,不是只查看。

remove:把复杂删除转成较简单形状,再修复黑高

源码定位:TreeMap.java:2655–2701。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
// 有两个孩子时先复制中序后继的键和值,再删除至多一个孩子的节点。
private void deleteEntry(Entry<K,V> p) {
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
size--;

// If strictly internal, copy successor's element to p and then make p
// point to successor.
if (p.left != null && p.right != null) {
Entry<K,V> s = successor(p);
p.key = s.key;
p.value = s.value;
p = s;
} // p has 2 children

// Start fixup at replacement node, if it exists.
Entry<K,V> replacement = (p.left != null ? p.left : p.right);

if (replacement != null) {
// Link replacement to parent
replacement.parent = p.parent;
if (p.parent == null)
root = replacement;
else if (p == p.parent.left)
p.parent.left = replacement;
else
p.parent.right = replacement;

// Null out links so they are OK to use by fixAfterDeletion.
p.left = p.right = p.parent = null;

// Fix replacement
if (p.color == BLACK)
fixAfterDeletion(replacement);
} else if (p.parent == null) { // return if we are the only node.
root = null;
} else { // No children. Use self as phantom replacement and unlink.
if (p.color == BLACK)
fixAfterDeletion(p);

if (p.parent != null) {
if (p == p.parent.left)
p.parent.left = null;
else if (p == p.parent.right)
p.parent.right = null;
p.parent = null;
}
}
}

中序后继是右子树最靠左的节点,它没有左孩子。把后继的键和值复制到待删节点,再把实际删除目标切换到后继,能够统一后面的链接与颜色修复。

复制的是引用,不会克隆业务对象。原 Entry 实例还可能暂时存在,因此外部长期保存活动条目不能当作独立、永远稳定的键值记录。

有替代孩子时将其连到父节点;删掉黑节点需要调用 fixAfterDeletion 补足黑高。没有孩子的黑节点则可以先作为临时替身参与修复,再断开父链接。

删除修复围绕兄弟及其两侧孩子展开:红兄弟先变色旋转成黑兄弟局面;黑兄弟且两个孩子黑时,把问题向父节点上传;否则按近侧、远侧孩子颜色调整,最后通过旋转与变色平衡路径。

不需要手写这些修复就能使用 TreeMap,但需要理解它为什么能保持后续查询复杂度,也不能把树删除概括为简单摘掉一条 next 链接。

范围视图、反向视图与条目修改

subMap(from,true,to,false) 表达左闭右开范围,headMap/tailMap 表达一侧边界;它们共享同一棵树,并把可见范围约束保存在视图中。

1
2
3
4
5
6
7
8
TreeMap<Integer, String> map = new TreeMap<>();
map.put(10, "A"); map.put(20, "B"); map.put(30, "C"); map.put(40, "D");
NavigableMap<Integer, String> middle = map.subMap(20, true, 40, false);
middle.put(30, "changed");
System.out.println(map.get(30)); // changed
System.out.println(middle.descendingKeySet()); // [30, 20]
middle.clear();
System.out.println(map.keySet()); // [10, 40]

范围视图插入越界键会抛 IllegalArgumentException,而不是悄悄扩张视图。clear 只清理范围内映射;descendingMap 改变比较方向和端点解释,不另复制所有成员。

JDK 21 的 reversed 对应反向有序视图。由于位置由比较规则确定,putFirst/putLast 不允许任意重新排位,会抛 UnsupportedOperationException,这与 LinkedHashMap 的显式遇见顺序不同。

导航方法返回不支持 setValue 的条目快照,而 entrySet 迭代器返回的活动 Entry 可以写回值。需要长期保存导航结果时,快照固定的是键值引用,值对象仍可能可变。

TreeMap(SortedMap) 在比较规则相容、来源已经有序时可以通过 buildFromSorted 建树,结构构造成本 O(n);不能把它等同于逐个无序 put 的 O(n log n)。从普通 Map 构造则仍按相应插入路径排序。

迭代器

前向迭代从最小节点开始,再通过 successor 取得中序后继;反向通过 predecessor 键、值与条目迭代器共用节点推进和快速失败检查。

1
2
3
4
5
6
7
8
9
10
11
12
// 按中序后继推进,同时检查 expectedModCount。
final Entry<K,V> nextEntry() {
Entry<K,V> e = next;
if (e == null)
throw new NoSuchElementException();
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
next = successor(e);
lastReturned = e;
return e;
}

它不扫描哈希桶,也不先复制全树。完整正常遍历为 O(n),单步有时需要沿父链回退,不能把所有 successor 调用单独都描述为严格 O(1)。

删除双子节点时,deleteEntry 可能用后继内容覆盖当前节点。前向迭代器因此要在删除前调整 next,避免跳过复制后留在当前位置的映射;随后同步 expectedModCount。

1
2
3
4
5
6
7
8
9
TreeMap<Integer, String> map = new TreeMap<>();
map.put(2, "B"); map.put(1, "A"); map.put(3, "C");
Iterator<Map.Entry<Integer, String>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<Integer, String> entry = iterator.next();
if (entry.getKey() == 2) iterator.remove();
else entry.setValue(entry.getValue().toLowerCase());
}
System.out.println(map); // {1=a, 3=c}

通过另一范围视图增删同一棵树,也会改变共享的 modCount,可能让当前迭代快速失败;覆盖已有值一般不产生相同的结构变化。

spliterator 的有序、排序特征要区分视图:键遍历按键比较,条目遍历的顺序对应键,值视图有遇见顺序却不保证按值排序。不能从 TreeMap 有序就推断 values 是排序值集合。

本类的关键是将比较顺序、邻近搜索和共享范围操作建立在同一棵平衡树上。业务需要的是键范围及边界时,这些能力比仅仅“输出时排序一下”更直接。

ConcurrentHashMap

基本特性

ConcurrentHashMap 继承 AbstractMap,实现 ConcurrentMap 和 Serializable。它按 hashCode/equals 识别键,不保证遍历顺序,拒绝 null 键和值,提供并发读取、更新及原子条件操作。

拒绝 null 使 get 返回 null 可以明确表达当前没有映射。并发 get 查询之后再调用 containsKey 不是一个原子操作,因此不能沿用允许 null 的普通映射方案,靠两次独立观察精确区分同一时刻的状态是做不到的。

1
2
3
4
5
ConcurrentHashMap<String, Integer> map = new ConcurrentHashMap<>();
System.out.println(map.putIfAbsent("A", 1)); // null,成功创建
System.out.println(map.putIfAbsent("A", 2)); // 1,保留旧值
System.out.println(map.replace("A", 1, 3)); // true,条件更新
System.out.println(map.remove("A", 1)); // false,当前值已为 3

单个键的某些复合操作具有原子性,并不使多个键之间的业务转账或完整批次更新自动成为事务。putAll/clear 与并发读取交错时,读者可以观察到部分更新。

成功更新某键,与另一线程随后读取到该非空更新值之间,有文档规定的 happens-before 关系。它发布键值引用,不自动保护值对象入表之后继续发生的字段变化。

构造器的 concurrencyLevel 在本版主要参与初始容量估算,不是创建固定数量的 Segment。

结构分析

当前主体仍是桶数组、普通链表和树桶,但增加并发发布、迁移及计数状态。Node 的 key/hash 固定,val/next 支持 volatile 可见性;数组槽位通过 tabAt、casTabAt、setTabAt 等专门入口访问。

普通桶的空槽加入采用 CAS;非空桶的更新通常锁定桶入口 f,进入同步区后再次确认 tabAt(tab,i)==f。其他桶可以继续更新,不像 Hashtable 正常读写都争用一个实例监视器。
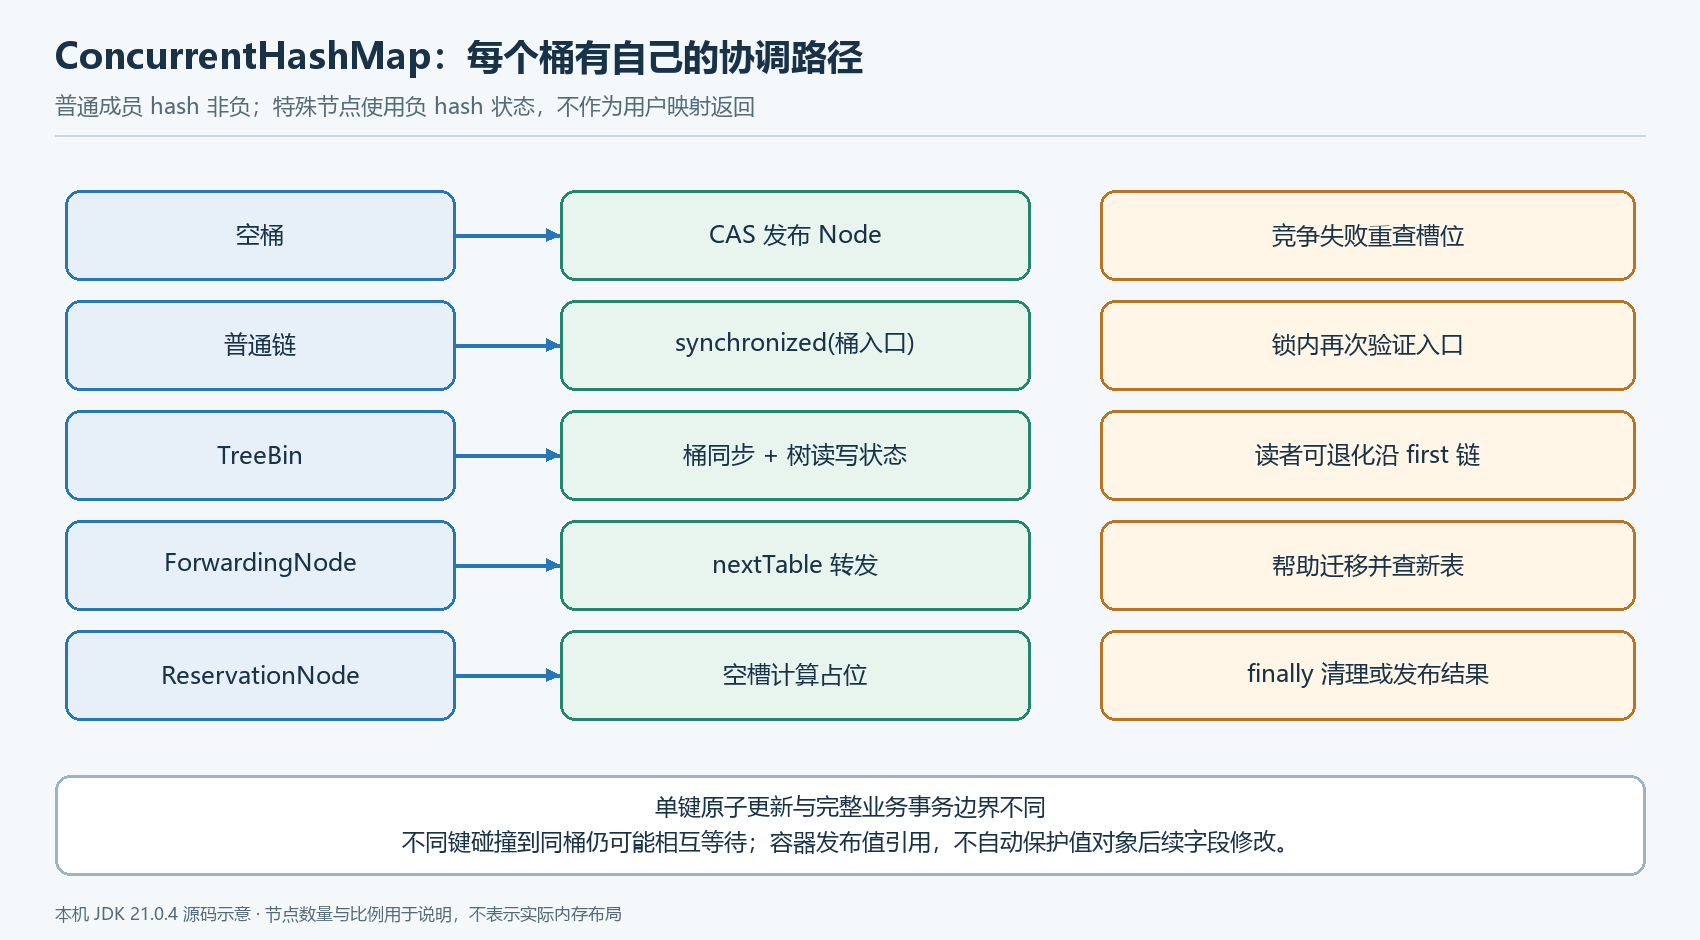
ConcurrentHashMap 的桶协调与特殊节点

ForwardingNode 的 hash 为 MOVED,指向 nextTable,表示旧桶已经迁移;TreeBin 是树桶管理入口,保存 root、first、lockState 等;ReservationNode 用于某些计算路径登记正在计算的空槽。

特殊节点不是用户成员,它们使用特殊 hash 状态,常规映射成员的扰动 hash 被限制为非负,避免与这些标记混淆。

1
2
3
4
// 混合高低位并清除符号位,非负成员 hash 与特殊节点状态区分。
static final int spread(int h) {
return (h ^ (h >>> 16)) & HASH_BITS;
}

sizeCtl 在不同阶段有不同含义:未初始化时可保存容量提示,-1 表示初始化协调,普通非负值作为扩容阈值,扩容负状态还编码版本戳及参与者信息。不能把所有负值一律解释成同一个线程的简单锁标志。

数量由 baseCount 与 CounterCell 数组共同表示,减少所有写线程争用同一计数点的压力。正常 size 通过汇总这些字段取得估计结果,不锁住全表。

基本操作

putVal:空槽 CAS,非空桶同步,迁移中帮助扩容
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
// 按空桶、迁移节点、普通链和树桶分流,再更新分散计数。
final V putVal(K key, V value, boolean onlyIfAbsent) {
if (key == null || value == null) throw new NullPointerException();
int hash = spread(key.hashCode());
int binCount = 0;
for (Node<K,V>[] tab = table;;) {
Node<K,V> f; int n, i, fh; K fk; V fv;
if (tab == null || (n = tab.length) == 0)
tab = initTable();
else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) {
// 只有槽位仍符合预期,才原子发布节点或占位状态。
if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value)))
break; // no lock when adding to empty bin
}
else if ((fh = f.hash) == MOVED)
// 遇到迁移标记时帮助扩容,并转到新表继续操作。
tab = helpTransfer(tab, f);
else if (onlyIfAbsent // check first node without acquiring lock
&& fh == hash
&& ((fk = f.key) == key || (fk != null && key.equals(fk)))
&& (fv = f.val) != null)
return fv;
else {
V oldVal = null;
// 锁定当前桶入口,进入后仍需确认入口没有被替换。
synchronized (f) {
// 验证加锁期间桶入口仍是刚刚观察到的节点。
if (tabAt(tab, i) == f) {
if (fh >= 0) {
binCount = 1;
for (Node<K,V> e = f;; ++binCount) {
K ek;
if (e.hash == hash &&
((ek = e.key) == key ||
(ek != null && key.equals(ek)))) {
oldVal = e.val;
if (!onlyIfAbsent)
e.val = value;
break;
}
Node<K,V> pred = e;
if ((e = e.next) == null) {
pred.next = new Node<K,V>(hash, key, value);
break;
}
}
}
else if (f instanceof TreeBin) {
Node<K,V> p;
binCount = 2;
if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key,
value)) != null) {
oldVal = p.val;
if (!onlyIfAbsent)
p.val = value;
}
}
else if (f instanceof ReservationNode)
throw new IllegalStateException("Recursive update");
}
}
if (binCount != 0) {
if (binCount >= TREEIFY_THRESHOLD)
treeifyBin(tab, i);
if (oldVal != null)
return oldVal;
break;
}
}
}
addCount(1L, binCount);
return null;
}

尚未有 table 时先初始化。空槽通过 CAS 发布新节点,失败则重新检查;槽位已经出现 ForwardingNode 时帮助迁移并转到新表,不在已迁移的旧桶里另建映射。

已有普通链或树桶则进入 synchronized(f)。锁对象本身来自之前的观察,因此锁内还要验证桶入口,防止扩容、删除或其他更新已改变该位置。

找到等价键时替换 val,onlyIfAbsent 可以保留已有值。不存在则链接新成员,之后判断是否要树化、增加映射数量,并可能触发扩容。

不同键恰好在同一个桶里仍可能互相等待。所谓细粒度并发不等于任意两次不同键写入完全互不影响,耗时计算或极差哈希分布都会影响碰撞桶的访问。

读已有非空值的 putIfAbsent 等路径还有快速分支,不是每次方法调用都必然进入 synchronized。具体能否避开锁,取决于入口和观察状态。

树化仍涉及容量与链长,容量不足时倾向先扩容。TreeBin 不是把整张 ConcurrentHashMap 改造成 TreeMap,而是一个桶的查找管理结构。

get 与 TreeBin:无全表互斥,仍有读协调
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// 读取槽位与可见字段,按普通链、树桶或迁移节点寻找,不获取实例全表锁。
public V get(Object key) {
Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek;
int h = spread(key.hashCode());
if ((tab = table) != null && (n = tab.length) > 0 &&
(e = tabAt(tab, (n - 1) & h)) != null) {
if ((eh = e.hash) == h) {
if ((ek = e.key) == key || (ek != null && key.equals(ek)))
return e.val;
}
else if (eh < 0)
return (p = e.find(h, key)) != null ? p.val : null;
while ((e = e.next) != null) {
if (e.hash == h &&
((ek = e.key) == key || (ek != null && key.equals(ek))))
return e.val;
}
}
return null;
}

普通链读沿 volatile next 与 val 前进。遇到 ForwardingNode 时,它的 find 会在新表继续定位;可能经历多次迁移的表,源码也要处理继续转发。

树桶阅读不能只记一句“get 完全无锁”。TreeBin 为树旋转维护读写状态,读者在安全时登记读取状态查树;写者或等待写者处于相关状态时,可以退化沿 first 链找,而不是等待整棵树稳定。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// 树桶在写状态附近沿链查找,否则登记读取状态进入树查找。
final Node<K,V> find(int h, Object k) {
if (k != null) {
for (Node<K,V> e = first; e != null; ) {
int s; K ek;
if (((s = lockState) & (WAITER|WRITER)) != 0) {
if (e.hash == h &&
((ek = e.key) == k || (ek != null && k.equals(ek))))
return e;
e = e.next;
}
else if (U.compareAndSetInt(this, LOCKSTATE, s,
s + READER)) {
TreeNode<K,V> r, p;
try {
p = ((r = root) == null ? null :
r.findTreeNode(h, k, null));
} finally {
Thread w;
if (U.getAndAddInt(this, LOCKSTATE, -READER) ==
(READER|WAITER) && (w = waiter) != null)
LockSupport.unpark(w);
}
return p;
}
}
}
return null;
}

这里的 CAS 读状态协调与普通 synchronized 写桶是不同层次。源码避免的是一个所有 get 必须持有的全表锁,不应把“无全表互斥”扩大成没有任何原子操作、状态检查或竞争成本。

get 取得值之后,另一个线程可以立即删除或更新同一个键。调用者持有的返回对象仍可使用,但它不因此永久保持为当前映射值。

扩容:工作区间、转发节点与协作发布

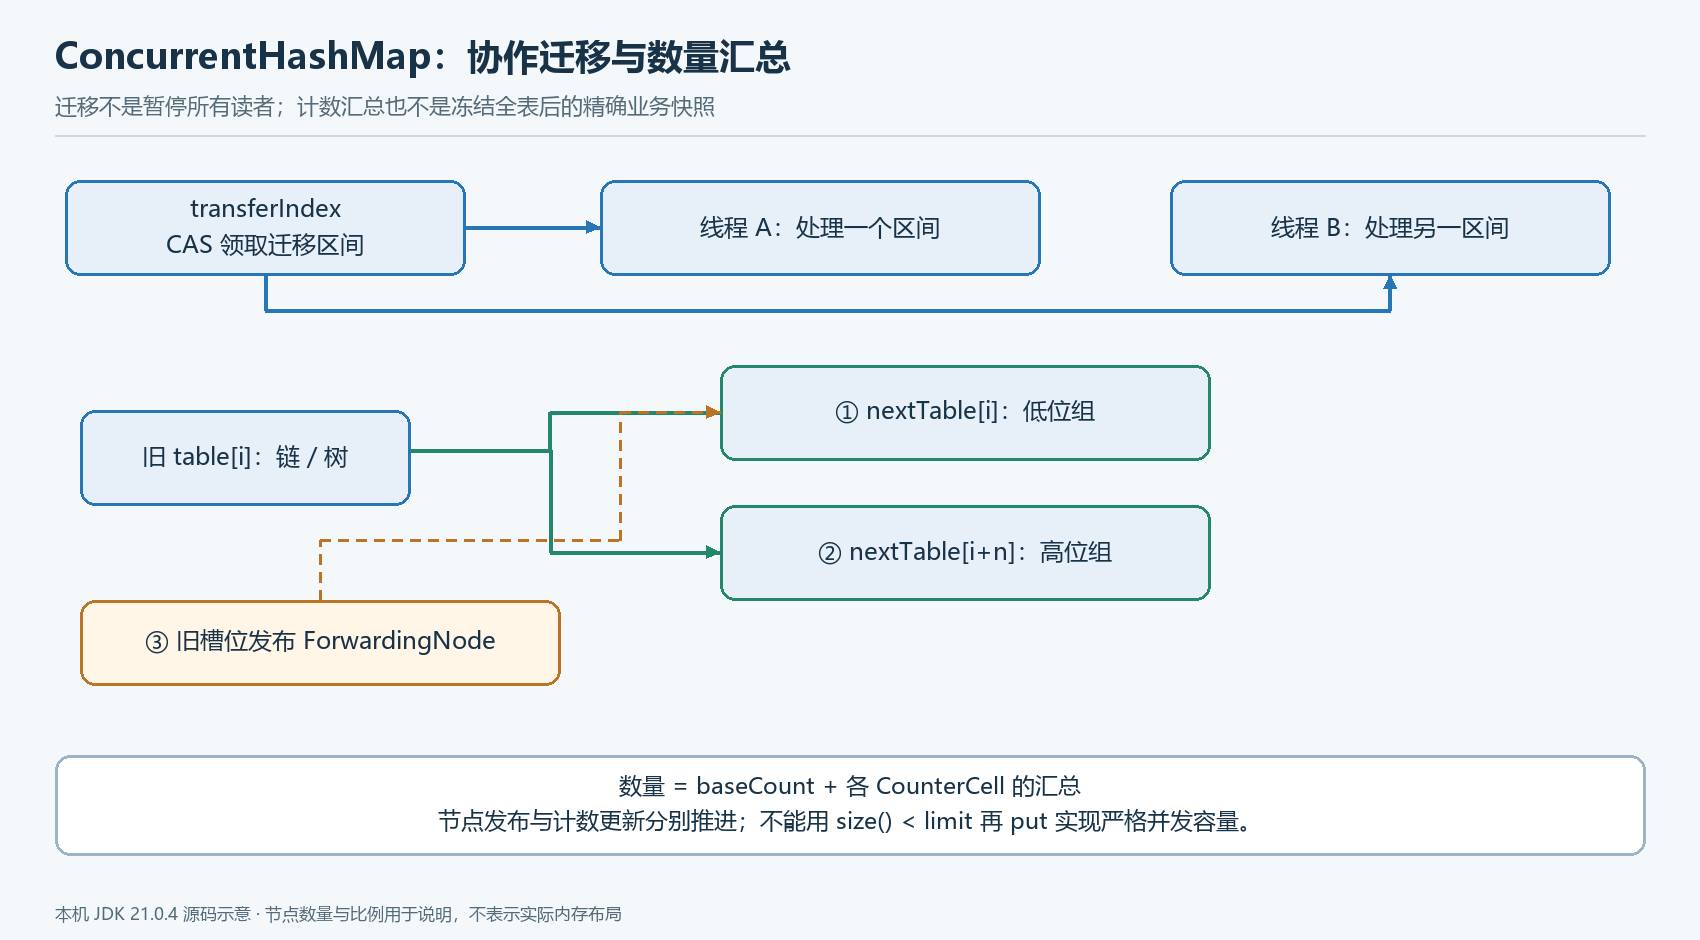
扩容通常创建两倍容量的新表,用 transferIndex 分配尚未迁移的桶区间,多个线程可以共同领取不同区间。每个区间的粒度结合 CPU 数和最小迁移步长决定。

下面摘录工作领取部分,外围是 transfer 的迁移循环:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 通过 CAS 领取一段尚未处理的桶,竞争成功后迁移对应范围。
while (advance) {
int nextIndex, nextBound;
if (--i >= bound || finishing)
advance = false;
else if ((nextIndex = transferIndex) <= 0) {
i = -1;
advance = false;
}
else if (U.compareAndSetInt
(this, TRANSFERINDEX, nextIndex,
nextBound = (nextIndex > stride ?
nextIndex - stride : 0))) {
bound = nextBound;
i = nextIndex - 1;
advance = false;
}
}
if (i < 0 || i >= n || i + n >= nextn) {
ConcurrentHashMap 的协作扩容与分散计数

迁移非空桶时仍需要协调桶入口。链表按 hash & oldCapacity 分成原位置与原位置加旧容量两组。源码可以复用最后一段同组后缀 lastRun,对前面的部分建立新节点,以避免破坏旧路径上的并发读者。

两组先发布到新表,再把旧桶槽位替换成 ForwardingNode。这个发布顺序使看到迁移标记的线程可以顺着它找到已经准备好的新桶。

1
2
3
4
5
// 先发布新表的低位组和高位组,再把旧槽位变为转发入口。
setTabAt(nextTab, i, ln);
setTabAt(nextTab, i + n, hn);
setTabAt(tab, i, fwd);
advance = true;

树桶也按新增容量位分组,短组可以反树化,较大组保留或重建 TreeBin。迁移完成后的最后参与者还要进行最终检查,再正式替换 table 并更新 sizeCtl 阈值。

读者并非都停止到扩容结束,写者遇到迁移标记还可以帮助工作。但某个线程可能因为协作迁移做额外工作,所以扩容也不是没有代价的背景动作。

computeIfAbsent:原子建立映射,不承诺永久只计算一次

先看空桶计算分支节选,外围仍处在检查桶状态的重试循环中:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
// 空槽用 ReservationNode 协调,finally 发布结果或清除占位状态。
else if ((f = tabAt(tab, i = (n - 1) & h)) == null) {
Node<K,V> r = new ReservationNode<K,V>();
synchronized (r) {
// 只有槽位仍符合预期,才原子发布节点或占位状态。
if (casTabAt(tab, i, null, r)) {
binCount = 1;
Node<K,V> node = null;
try {
// 用户函数参与本次计算,不能在其中递归修改相同映射。
if ((val = mappingFunction.apply(key)) != null)
node = new Node<K,V>(h, key, val);
} finally {
setTabAt(tab, i, node);
}
}
}
if (binCount != 0)
break;
}

如果首节点已经保存目标非空值,可直接返回;否则在锁定并验证桶入口之后,普通链分支如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 非空链中的查找与计算节选;用户函数仍在对应桶的同步范围中执行。
for (Node<K,V> e = f;; ++binCount) {
K ek;
if (e.hash == h &&
((ek = e.key) == key ||
(ek != null && key.equals(ek)))) {
val = e.val;
break;
}
Node<K,V> pred = e;
if ((e = e.next) == null) {
// 用户函数参与本次计算,不能在其中递归修改相同映射。
if ((val = mappingFunction.apply(key)) != null) {
if (pred.next != null)
throw new IllegalStateException("Recursive update");
added = true;
pred.next = new Node<K,V>(h, key, val);
}
break;
}
}

树桶分支则先查找相等键,再计算候选值,并通过树插入方法验证是否发生可检测的递归更新。遇到迁移节点帮助扩容,遇到同槽占位引发的可检测递归抛异常;真正新增之后再执行树化检查和数量更新。

对一次调用,已有非空值时返回当前值而不计算;缺失时以原子方式建立计算结果。不能把多次调用或“删除后重新建立”概括成某个键一辈子只执行一次函数。

函数返回 null 不建立映射,抛异常也不会正常发布计算值。之后另一次调用仍可能继续计算。ReservationNode 的 finally 保证空槽的占位状态能被清理或替换成真实节点。

函数应短小,不能递归更新同一映射,也不应修改这张表;可检测到的递归更新会抛 IllegalStateException。耗时函数可能挡住相关更新,原子计算不是免费执行外部慢任务的许可。

1
2
3
4
ConcurrentHashMap<String, LongAdder> counts = new ConcurrentHashMap<>();
counts.computeIfAbsent("Java", key -> new LongAdder()).increment();
System.out.println(counts.get("Java").sum()); // 2,无并发删除时的计数

这个写法把频繁计数分散到 LongAdder,而不是每次替换一个 boxed Long。若另一个线程删除映射,已经取得旧 LongAdder 的线程仍可能继续增加旧对象;业务需要精确统计删除边界时,要另外协调。

merge、compute 与条件 replace/remove 适合表达当前映射上的原子更新;普通 get 后自己加一再 put 仍可能丢失并发更新。

size、mappingCount 与视图修改
1
2
3
4
5
6
7
8
9
10
11
// 汇总 baseCount 与各计数槽,避免每次更新争用一个精确全表计数点。
final long sumCount() {
CounterCell[] cs = counterCells;
long sum = baseCount;
if (cs != null) {
for (CounterCell c : cs)
if (c != null)
sum += c.value;
}
return sum;
}

size 把汇总结果限制到 int,mappingCount 返回 long 估计数量。并发期间节点发布与计数更新有各自时序,汇总不是一个锁住所有桶得到的瞬时快照。

因此,不要用 size() < limit 再 put 实现硬容量,不要用 isEmpty 判断整个系统没有正在提交或正在执行的任务。需要容量令牌时,令牌的取得、删除、取消和消费要共同遵守完整生命周期。

普通 keySet 不支持无值添加;keySet(mappedValue) 可以把新增键统一映射到指定非空值,静态 newKeySet() 则使用 Boolean.TRUE 建立可添加的并发键集合。

1
2
3
4
5
6
ConcurrentHashMap<String, Integer> map = new ConcurrentHashMap<>();
Set<String> keys = map.keySet(7);
keys.add("A");
System.out.println(map.get("A")); // 7
keys.remove("A");
System.out.println(map.isEmpty()); // true

迭代器

键、值、条目迭代器通过 Traverser 跨桶前进,不保存整个映射副本,也不依赖 modCount 快速失败;它们具有弱一致语义,允许遍历与并发更新交错。

迁移时遇到 ForwardingNode,Traverser 会保存相应表层级状态,在新表中继续访问对应区域,再恢复原来的遍历进度。不能简单把迁移期间迭代解释成只读旧数组或无条件从新数组 0 重新开始。

条目迭代器创建自己的 MapEntry 对象,保存当次观察的键和值,而不是直接把内部 Node 暴露给用户:

源码定位:ConcurrentHashMap.java:3497–3506。

1
2
3
4
5
6
7
8
9
10
11
// 把当前观察值包装为外部条目,原子节点状态仍留在映射内部。
public final Map.Entry<K,V> next() {
Node<K,V> p;
if ((p = next) == null)
throw new NoSuchElementException();
K k = p.key;
V v = p.val;
lastReturned = p;
advance();
return new MapEntry<K,V>(k, v, map);
}

该条目支持 setValue,通过 map.put 写回;条目自身保存的 value 随这次调用更新,却不会自动跟随所有其他线程对同键的后续替换。

1
2
3
4
5
6
7
8
9
ConcurrentHashMap<String, Integer> map = new ConcurrentHashMap<>();
map.put("A", 1); map.put("B", 2);
Iterator<Map.Entry<String, Integer>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<String, Integer> entry = iterator.next();
if (entry.getKey().equals("A")) iterator.remove();
else entry.setValue(20);
}
System.out.println(map); // 无其他线程修改时:{B=20}

迭代器 remove 根据最近返回的键删除当前映射,不是对旧值做条件删除。因此,同键在观察后被别人更新,remove 仍可能删掉当前更新后的映射;需要值匹配保护时直接使用 remove(key,expectedValue)。

spliterator 报告 CONCURRENT、NONNULL,键和条目还具有相应 DISTINCT 特征,不报告稳定全表快照的 SIZED。并行批量查询也只能组合并发观察,不能自动得到多键事务时刻的完整状态。

同一个 Iterator 的游标仍通常交给一个线程推进。容器支持并发访问,与任意多个线程同时操纵同一个迭代器对象,是不同的协议。

ConcurrentSkipListMap

基本特性

ConcurrentSkipListMap 继承 AbstractMap,实现 ConcurrentNavigableMap,将并发映射、键排序与范围导航结合在一起。它允许重复值,不允许 null 键和值,通过自然比较或 Comparator 确定键位置与重复。

如果需要多线程访问,同时还需要 floorEntry、subMap 等有序能力,不能只把 HashMap 换成 ConcurrentHashMap 就认为保留了排序。本类解决的正是并发条件下的键顺序与范围访问。

1
2
3
4
5
ConcurrentSkipListMap<Integer, String> map = new ConcurrentSkipListMap<>();
map.put(30, "C"); map.put(10, "A"); map.put(20, "B");
System.out.println(map.keySet()); // [10, 20, 30]
System.out.println(map.floorEntry(25)); // 20=B
System.out.println(map.putIfAbsent(20, "new")); // B

键比较为 0 就视为已有键,与 TreeMap 相似;但即使比较器能够处理 null,本类也明确拒绝 null 键。

查找、插入与删除在正常随机索引分布下有预期 O(log n) 成本,不是红黑树那种由平衡性质约束的最坏树高保证。线程竞争、重试和用户比较器的成本还会影响实际耗时。

它不提供完整映射的事务快照,putAll、clear 与批量遍历可以被并发观察到部分进展。单个键的原子条件更新与任意多键组合,是不同边界。

结构分析

跳表可以理解为底层有序链表上增加若干稀疏索引。基础链保存全部有效映射,索引链只帮助快速越过一段键范围;去掉部分索引可能降低性能,但不应改变基础成员的正确性。
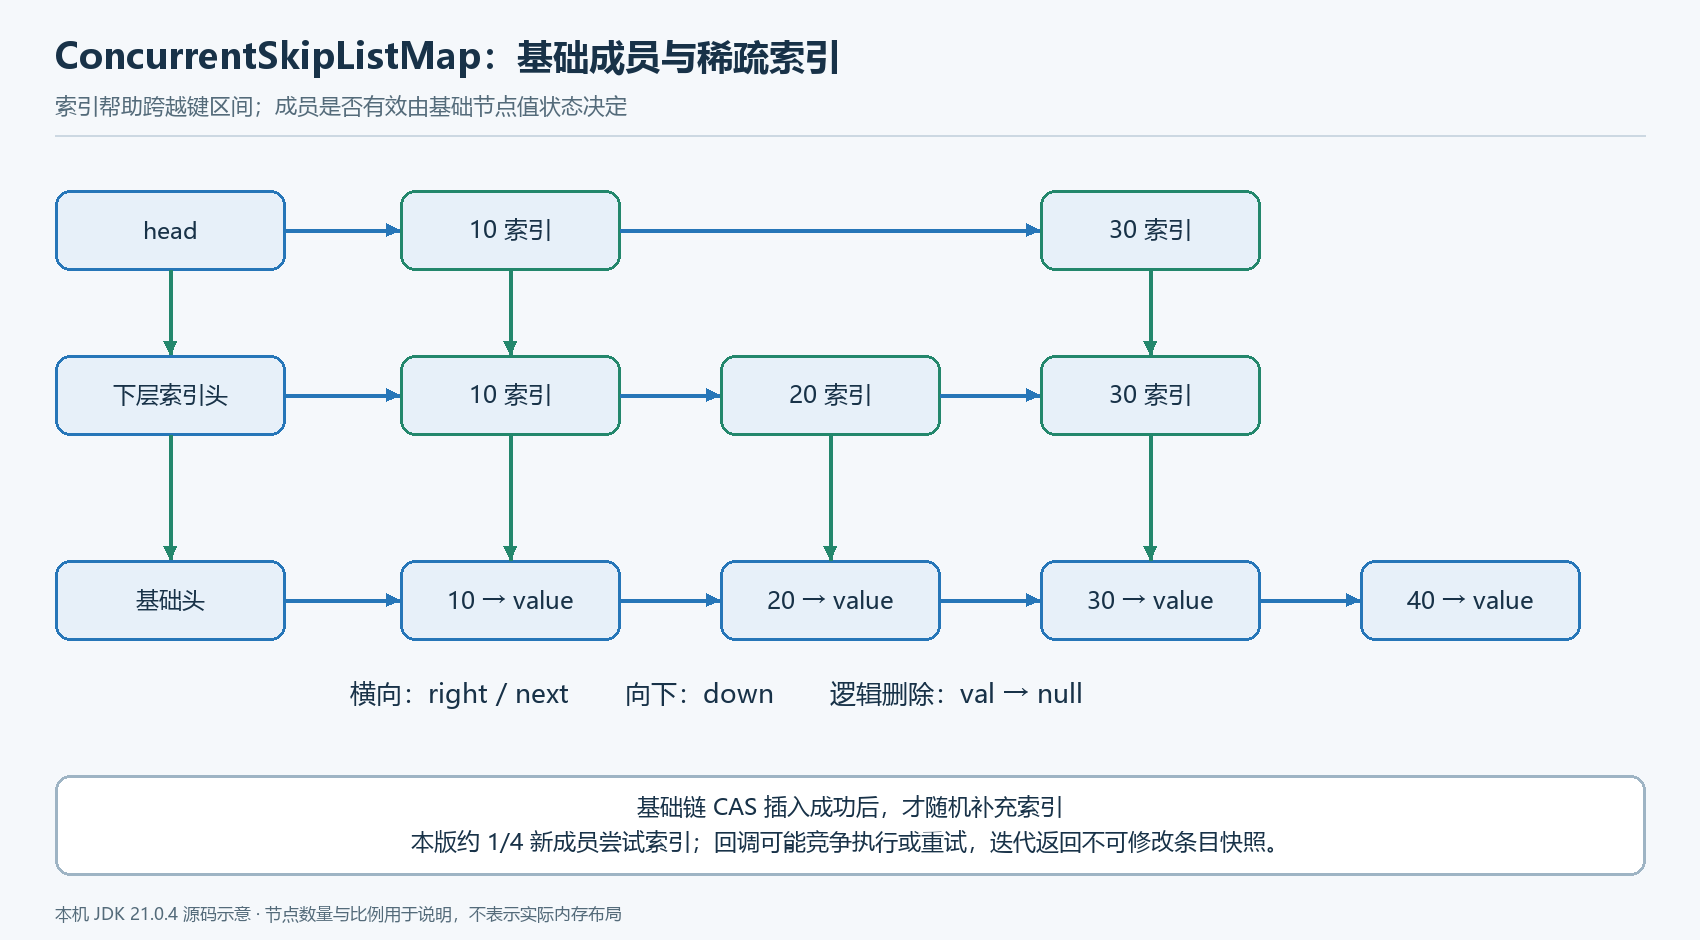
ConcurrentSkipListMap 的基础链与稀疏索引

Node 保存 key、val、next,Index 保存 node、right、down。当前源码没有让每个 Node 自带一个“所有层的 next 数组”。head 是最高层索引入口,基础头节点没有普通用户键。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
// 基础节点保存完整键值,索引节点只持有基础节点及横向、向下链接。
static final class Node<K,V> {
final K key; // currently, never detached
V val;
Node<K,V> next;
Node(K key, V value, Node<K,V> next) {
this.key = key;
this.val = value;
this.next = next;
}
}

/**
* Index nodes represent the levels of the skip list.
*/
static final class Index<K,V> {
final Node<K,V> node; // currently, never detached
final Index<K,V> down;
Index<K,V> right;
Index(Node<K,V> node, Index<K,V> down, Index<K,V> right) {
this.node = node;
this.down = down;
this.right = right;
}
}

本版本 val/next/right 等字段没有简单统一写成 volatile,而是配合 VarHandle 的原子访问、发布与 acquireFence 等保证算法所需关系。不能只看字段声明就断言它们未同步,也不能把其他版本的声明替换到本段源码里。

查找从较高层向右走,直到下一键不再小于目标,再向下继续。在底层找到候选前驱后,还要检查后继是否仍活跃,因为索引或节点可能刚被其他线程删除。

有效用户值必须非 null;val 为 null 表示逻辑删除。基础节点还可能出现 key 为 null 的标记节点,用于阻止并发插入错误地接到即将被摘除的节点后面。

结构修改主要由 NEXT、VAL、RIGHT、HEAD 等原子操作协调,竞争失败后可以重新查找,遍历也会协助清理已经失效的节点和索引。

基本操作

doPut:定位、原子链接、再补充索引

公开 put 先拒绝 null 值,再进入 doPut;doPut 自身还拒绝 null 键。这里不能只靠自然比较时的空指针错误表达参数限制。

先看已经取得候选前驱 b 之后的基础链节选,外围还有初始化和索引定位的重试循环:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
// 在基础链查找相等键或插入点,链接变更通过 CAS 验证前驱关系。
Node<K,V> z = null; // new node, if inserted
for (;;) { // find insertion point
Node<K,V> n, p; K k; V v; int c;
if ((n = b.next) == null) {
if (b.key == null) // if empty, type check key now
cpr(cmp, key, key);
c = -1;
}
else if ((k = n.key) == null)
break; // can't append; restart
else if ((v = n.val) == null) {
unlinkNode(b, n);
c = 1;
}
else if ((c = cpr(cmp, key, k)) > 0)
b = n;
else if (c == 0 &&
// 确认旧值未变后,原子发布新值或逻辑删除。
(onlyIfAbsent || VAL.compareAndSet(n, v, value)))
return v;

if (c < 0 &&
// 前驱链接仍符合预期时,原子接入或替换后继。
NEXT.compareAndSet(b, n,
p = new Node<K,V>(key, value, n))) {
z = p;
break;
}
}

新节点成功加入之后,再按下面的分支补充索引并更新数量:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
// 索引随机增加,基础成员已经可用;整理索引后更新计数并返回。
if (z != null) {
int lr = ThreadLocalRandom.nextSecondarySeed();
if ((lr & 0x3) == 0) { // add indices with 1/4 prob
int hr = ThreadLocalRandom.nextSecondarySeed();
long rnd = ((long)hr << 32) | ((long)lr & 0xffffffffL);
int skips = levels; // levels to descend before add
Index<K,V> x = null;
for (;;) { // create at most 62 indices
x = new Index<K,V>(z, x, null);
if (rnd >= 0L || --skips < 0)
break;
else
rnd <<= 1;
}
if (addIndices(h, skips, x, cmp) && skips < 0 &&
head == h) { // try to add new level
Index<K,V> hx = new Index<K,V>(z, x, null);
Index<K,V> nh = new Index<K,V>(h.node, h, hx);
HEAD.compareAndSet(this, h, nh);
}
if (z.val == null) // deleted while adding indices
findPredecessor(key, cmp); // clean
}
addCount(1L);
return null;
}

空结构先 CAS 初始化基础头与索引头。已有索引则逐层向右、向下,计数经过的层数,并清理指向失效基础节点的索引。

到了底层,发现相等键时,如果 onlyIfAbsent 为 true 就返回旧值,否则 CAS 更新 val。遇到 val 为 null 的节点帮助 unlink,遇到标记或路径变化则重新寻找,不能沿着失效前驱强行追加。

新键的成员加入点是 NEXT.compareAndSet(b,n,newNode) 成功。索引随后才按照随机数补充,因此一个已经可用的映射可以暂时还没有新的高层索引。

当前源码先用 lr & 0x3 决定约四分之一的新成员尝试建立索引,再根据后续随机位确定继续层数。不能把其他版本常见的“每一层固定 1/2”的节点模型当作本版所有细节。

索引补充失败、节点又被删除或某个层级调整,并不意味着已成功的基础成员必须回滚。算法围绕基础链正确性运行,索引属于加速结构。

doGet 与比较等价

读取也需要跳过失效节点与清理过期索引,但不获取一把覆盖全映射的互斥锁。比较器仍可能执行复杂逻辑,因此它应保持稳定并符合一致的比较关系。

1
2
3
4
5
6
ConcurrentSkipListMap<String, Integer> map =
new ConcurrentSkipListMap<>(Comparator.comparingInt(String::length));
map.put("AA", 1);
map.put("BB", 2);
System.out.println(map.size()); // 1
System.out.println(map.get("CC")); // 2,比较等价而非 equals 相等

同长度键被视为同一映射位置,原键仍保存为 AA。业务要求不同字符串分别存在时,应把内容也加入比较器,而不是试图再给这些键调整 hashCode。

修改已入表键的比较字段同样可能破坏搜索方向。并发容器并不会追踪对象变化并自动重排,稳定键与稳定比较规则仍是使用前提。

doRemove:先清值,再处理链与索引

源码定位:ConcurrentSkipListMap.java:758–792。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
// 值从旧对象 CAS 为 null 表示逻辑删除,后续 unlink 和层级整理负责物理清理。
final V doRemove(Object key, Object value) {
if (key == null)
throw new NullPointerException();
Comparator<? super K> cmp = comparator;
V result = null;
Node<K,V> b;
outer: while ((b = findPredecessor(key, cmp)) != null &&
result == null) {
for (;;) {
Node<K,V> n; K k; V v; int c;
if ((n = b.next) == null)
break outer;
else if ((k = n.key) == null)
break;
else if ((v = n.val) == null)
unlinkNode(b, n);
else if ((c = cpr(cmp, key, k)) > 0)
b = n;
else if (c < 0)
break outer;
else if (value != null && !value.equals(v))
break outer;
// 确认旧值未变后,原子发布新值或逻辑删除。
else if (VAL.compareAndSet(n, v, null)) {
result = v;
unlinkNode(b, n);
break; // loop to clean up
}
}
}
if (result != null) {
tryReduceLevel();
addCount(-1L);
}
return result;
}

value 非 null 时还要核对已有值 equals 匹配,才能尝试条件删除;参数为 null 的内部含义是无需附加值匹配,不表示用户可以存储 null。

删除成功后减少数量并可能压缩空的高层索引。高层整理允许在竞争中出现暂时不最优的层数,这影响定位速度,不改变基础链里有效成员的关系。

物理摘链之前,需要给待删节点的后继建立标记,防止另一个生产线程基于旧前驱继续插入造成路径丢失:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
// 先给失效节点建立删除标记,再尝试把前驱直接连到后继。
static <K,V> void unlinkNode(Node<K,V> b, Node<K,V> n) {
if (b != null && n != null) {
Node<K,V> f, p;
for (;;) {
if ((f = n.next) != null && f.key == null) {
p = f.next; // already marked
break;
}
// 前驱链接仍符合预期时,原子接入或替换后继。
else if (NEXT.compareAndSet(n, f,
new Node<K,V>(null, null, f))) {
p = f; // add marker
break;
}
}
NEXT.compareAndSet(b, n, p);
}
}

标记节点也是内部算法对象,不会被导航结果或迭代器当成 null 用户键返回。逻辑删除与链接清理分开,允许慢线程沿旧路径发现自己需要重试。

computeIfAbsent:与 ConcurrentHashMap 的计算边界不同
1
2
3
4
5
6
7
8
9
10
11
12
// 先计算候选值,再通过只在缺失时插入的 doPut 竞争发布。
public V computeIfAbsent(K key,
Function<? super K, ? extends V> mappingFunction) {
if (key == null || mappingFunction == null)
throw new NullPointerException();
V v, p, r;
if ((v = doGet(key)) == null &&
// 用户函数参与本次计算,不能在其中递归修改相同映射。
(r = mappingFunction.apply(key)) != null)
v = (p = doPut(key, r, true)) == null ? r : p;
return v;
}

两个线程都先观察到缺失时,可以各自运行 mappingFunction,最终只有一个候选值被保留,另一方返回已经存在的值。因此,不应把函数外部副作用理解成受单次发布原子性保护。

1
2
3
4
ConcurrentSkipListMap<String, Integer> map = new ConcurrentSkipListMap<>();
map.computeIfAbsent("A", key -> 1);
map.compute("A", (key, old) -> old + 1);
System.out.println(map.get("A")); // 2,单线程示例

compute/merge 等基于重试的入口还可能重新计算候选结果,函数最好可安全重复执行。写入数据库、扣款或发送一次消息等副作用,不应藏在未经额外幂等协调的重试函数里。

与 ConcurrentHashMap 空槽占位并同步计算的具体路径相比,本类的函数调用不保证同样的只计算一次边界。两者都实现 ConcurrentMap,不意味着它们在用户函数执行次数上完全相同

size、范围视图与端点
1
2
3
4
5
6
7
// 本版本维护 LongAdder 计数,不是每次 size 都扫描整条基础链。
private void addCount(long c) {
LongAdder a;
do {} while ((a = adder) == null &&
!ADDER.compareAndSet(this, null, a = new LongAdder()));
a.add(c);
}
1
2
3
4
5
6
7
// 读取并发计数结果并限制 int 范围,竞争期间仍不是冻结全表后的精确快照。
public int size() {
long c;
return ((baseHead() == null) ? 0 :
((c = getAdderCount()) >= Integer.MAX_VALUE) ?
Integer.MAX_VALUE : (int) c);
}

这个实现与常见旧版资料的线性 size 说明不同。读取数量的结构成本不用简单归为沿所有节点 O(n),但并发更新下的估计性质仍然存在。

subMap/headMap/tailMap 共享基础结构并限制范围。区间内 put 可以更新原映射,越界 put 会抛异常;范围清空与并发提交也不构成统一事务。

1
2
3
4
5
6
ConcurrentSkipListMap<Integer, String> map = new ConcurrentSkipListMap<>();
map.put(10, "A"); map.put(20, "B"); map.put(30, "C");
ConcurrentNavigableMap<Integer, String> view = map.subMap(10, true, 30, false);
view.remove(20);
System.out.println(map.keySet()); // [10, 30]
System.out.println(map.descendingMap().firstKey()); // 30

firstEntry、ceilingEntry、pollFirstEntry 等返回键值快照,不支持 setValue。poll 端点操作会尝试原子移除当前合适节点,而不是先给业务返回一个活动节点再等待以后删除。

反向范围的比较顺序与上下界解释相应变化。前向遍历能直接沿基础 next 走,反向定位要利用搜索路径,因此文档说明升序视图与遍历通常比降序更快。

迭代器

普通 Itr 保存 next 及 nextValue,构造和推进时寻找 val 非 null 的节点。它弱一致,不复制所有成员,不记录 expectedModCount,也不因合法外部更新就快速失败。

源码定位:ConcurrentSkipListMap.java:2122–2131。

1
2
3
4
5
6
7
8
9
10
11
// 沿基础链跳过逻辑删除节点,并缓存下一节点当前的非空值。
final void advance(Node<K,V> b) {
Node<K,V> n = null;
V v = null;
if ((lastReturned = b) != null) {
while ((n = b.next) != null && (v = n.val) == null)
b = n;
}
nextValue = v;
next = n;
}

缓存使已确认的下一键值可以返回,但它不保证返回时该键还在映射中。后续新加入成员是否被当前遍历看到,取决于链上位置和推进时序,不是创建时固定快照。

1
2
3
4
5
6
7
8
9
10
// 每次返回独立的不可修改条目快照,不把基础节点暴露为活动 Entry。
public Map.Entry<K,V> next() {
Node<K,V> n;
if ((n = next) == null)
throw new NoSuchElementException();
K k = n.key;
V v = nextValue;
advance(n);
return new AbstractMap.SimpleImmutableEntry<K,V>(k, v);
}
1
2
3
4
5
6
7
ConcurrentSkipListMap<Integer, String> map = new ConcurrentSkipListMap<>();
map.put(1, "A"); map.put(2, "B");
Iterator<Map.Entry<Integer, String>> iterator = map.entrySet().iterator();
Map.Entry<Integer, String> entry = iterator.next();
System.out.println(entry); // 1=A
iterator.remove(); // 根据最近返回的键删除当前映射
System.out.println(map); // {2=B}

迭代删除按最近返回键执行,不是一条带旧值校验的 compare-and-remove。业务担心同键的新值被删除时,应显式使用 remove(key,observedValue) 并检查结果。

值视图按键顺序遍历,但值本身不必有序,允许不同键保存相等值。相关有序 spliterator 还要区分键、值、条目各自的 SORTED/DISTINCT 特征,不能一概认为所有视图都是排序且去重。

本类在需要并发范围查找时很实用,但不提供零代价的排序或严格业务快照。比较稳定、回调可重复、范围共享与弱一致遍历,是理解其使用边界的几个重点。

WeakHashMap

基本特性

WeakHashMap 是采用弱键的哈希映射,继承 AbstractMap,不保证顺序,也没有线程安全保护。它允许 null 键和值,正常键识别仍使用 hashCode/equals,而不是按引用身份去重。

“弱”针对键的引用关系:映射节点不会用普通强引用长期保住非空键。某个键不再被其他强引用保留时,可能被垃圾收集器清除,相关条目随后由映射操作清理。

1
2
3
4
5
6
WeakHashMap<String, Integer> map = new WeakHashMap<>();
String key = new String("A");
map.put(key, 1);
System.out.println(map.get(new String("A"))); // 1,仍按 equals 查找
System.out.println(map.size()); // 1
Reference.reachabilityFence(key); // 确保示例查询期间键保持强可达

不是把 key 变量设为 null 就保证下一行 size 立刻变小,也不能用一次 System.gc 保证通知已经处理。引用清除、入队通知与失效条目清理,是有各自时序的步骤。

值被节点强持有。如果值又直接或间接强持有键,那么“映射 → 值 → 键”形成强可达路径,弱键设计就无法让这个键按预期消失。将值简单设成持有 key 的对象,是常见的生命周期错误。

本类不适合表达固定容量、稳定命中率或精确到期时间的缓存。弱可达性由对象引用关系和 GC 决定,不是业务选择的缓存淘汰策略。

结构分析

核心是 Entry 数组、size、threshold、loadFactor、modCount 及 ReferenceQueue。Entry 自身继承 WeakReference<Object>,弱引用 referent 就是键,同时以普通字段保存 value、hash 和 next。
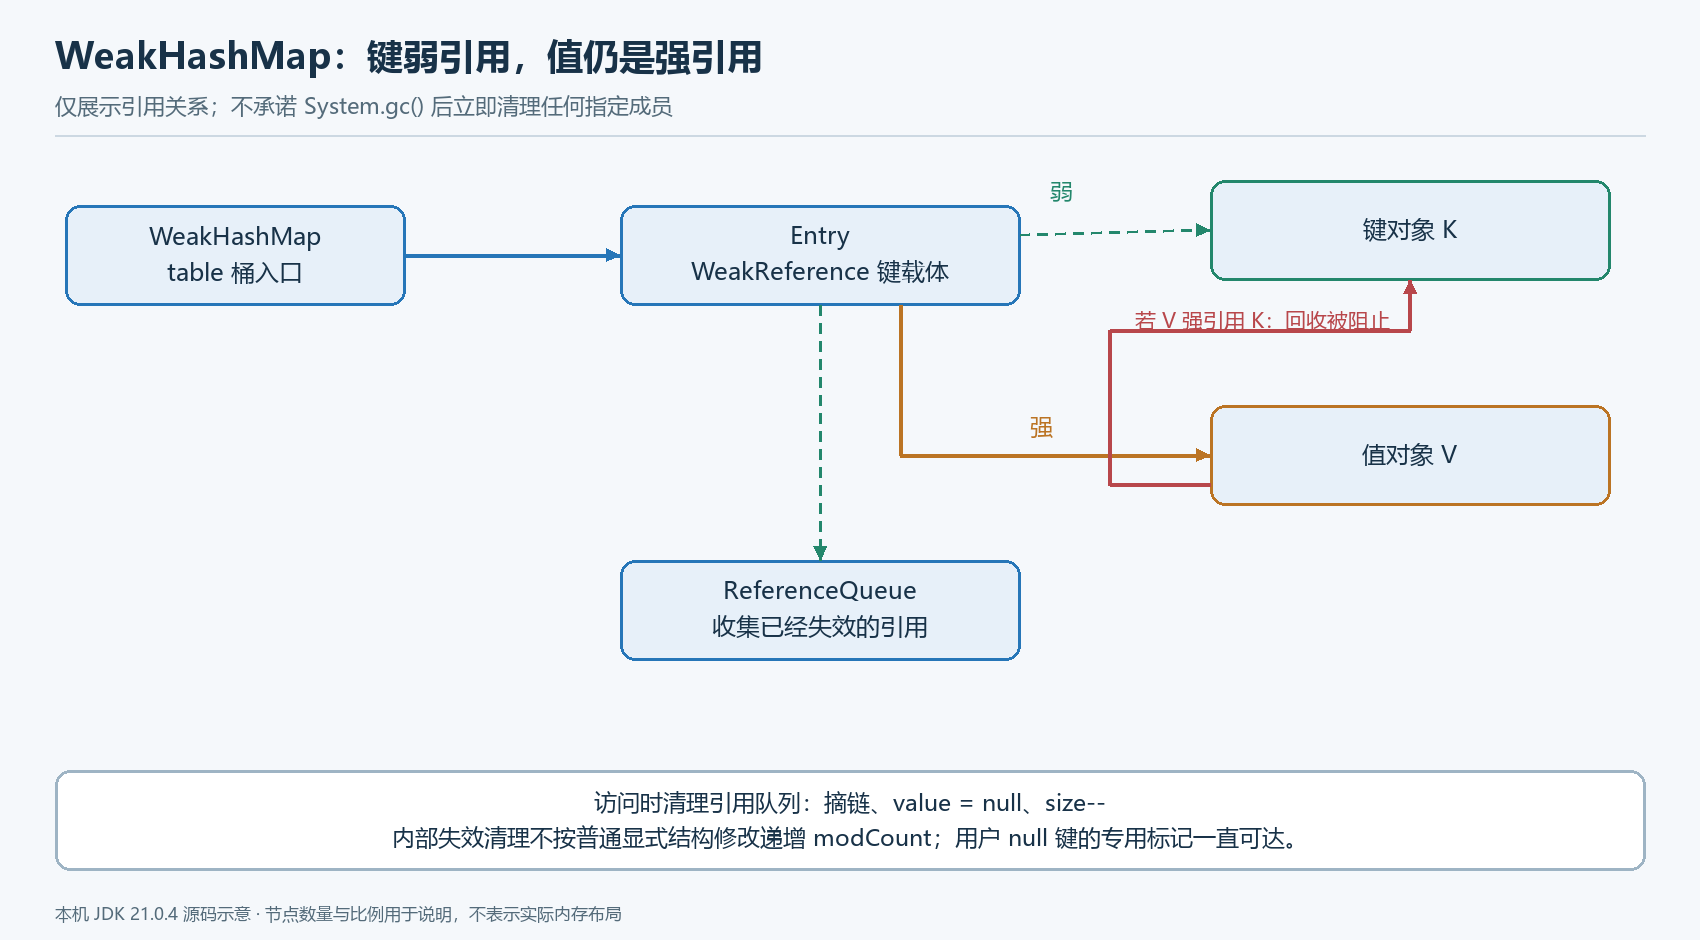
WeakHashMap 的弱键、强值与通知清理

这里不再单独创建“普通 Node 再包一个弱引用键”,而是节点本身就承担弱引用包装。登记到内部 ReferenceQueue 的对象也就是这个 Entry,后续通知可以直接定位失效条目。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
// Entry 类节选:条目继承 WeakReference 保存弱键,value 与 next 仍是普通强引用字段。
private static class Entry<K,V> extends WeakReference<Object> implements Map.Entry<K,V> {
V value;
final int hash;
Entry<K,V> next;

/**
* Creates new entry.
*/
Entry(Object key, V value,
ReferenceQueue<Object> queue,
int hash, Entry<K,V> next) {
super(key, queue);
this.value = value;
this.hash = hash;
this.next = next;
}

@SuppressWarnings("unchecked")
public K getKey() {
return (K) WeakHashMap.unmaskNull(get());
}

public V getValue() {
return value;
}

public V setValue(V newValue) {
V oldValue = value;
value = newValue;
return oldValue;
}

hash 在键尚可取得时保存下来。键被清除之后,清理仍需要知道原桶位置,不能再依靠已经返回 null 的 Entry.get 调用用户键 hashCode。

用户 null 键用一个内部静态 NULL_KEY 掩码替代。这个哨兵被静态强引用保留,不会像普通弱键那样因业务没有保留 key 变量而被收集;用户 null 映射不会自动因为“null 不可达”消失。

数组槽位 null 表示没有条目;Entry.get 返回 null 则可能表示其弱键已失效。两个 null 所处的结构层次不同,迭代器和迁移需要分别判断。

默认容量 16,默认负载因子 0.75;本类的数组与桶链不增加 HashMap 的树桶策略,碰撞严重时仍可能线性搜索。

基本操作

getTable 与失效条目清理

常规查找、更新等路径通过 getTable 先处理通知队列,取出已经入队的 Entry:

源码定位:WeakHashMap.java:328–355。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
// 按失效条目保存的 hash 找原桶,并按节点身份摘链及清空强值引用。
private void expungeStaleEntries() {
for (Object x; (x = queue.poll()) != null; ) {
synchronized (queue) {
@SuppressWarnings("unchecked")
Entry<K,V> e = (Entry<K,V>) x;
int i = indexFor(e.hash, table.length);

Entry<K,V> prev = table[i];
Entry<K,V> p = prev;
while (p != null) {
Entry<K,V> next = p.next;
if (p == e) {
if (prev == e)
table[i] = next;
else
prev.next = next;
// Must not null out e.next;
// stale entries may be in use by a HashIterator
// 解除失效条目对值对象的强引用,便于后续回收。
e.value = null; // Help GC
size--;
break;
}
prev = p;
p = next;
}
}
}
}

queue.poll 返回原节点,源码使用保存的 hash 计算桶位置,然后用 p==e 找到这份具体条目。不能用 equals 再找一个当前等价键,因为原键已经清除,通知必须关联原来的物理节点。

摘除时减少 size,清空 e.value,解除值对象的强引用;但不能随意清空 e.next,某个迭代器仍可能拿着这个旧节点继续定位后继。

内部 synchronized(queue) 是协调清理步骤,不代表整张 WeakHashMap 变成线程安全。用户的 put、resize、遍历等仍没有统一并发保护。

清理失效条目不按普通用户结构删除那样统一增加 modCount。因此,弱键消失可能改变实际内容,却不一定触发当前迭代器的快速失败检查。

put 与 get:先掩码、再普通哈希查找
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
// 先清理失效条目,再按 hash 与键相等关系更新或新建弱引用 Entry。
public V put(K key, V value) {
// 用户 null 键转换为内部专用标记。
Object k = maskNull(key);
int h = hash(k);
Entry<K,V>[] tab = getTable();
int i = indexFor(h, tab.length);

for (Entry<K,V> e = tab[i]; e != null; e = e.next) {
if (h == e.hash && matchesKey(e, k)) {
V oldValue = e.value;
if (value != oldValue)
e.value = value;
return oldValue;
}
}

// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
Entry<K,V> e = tab[i];
tab[i] = new Entry<>(k, value, queue, h, e);
// 新映射计数超过阈值时扩容,覆盖旧值不走这个分支。
if (++size > threshold)
resize(tab.length * 2);
return null;
}

覆盖旧值保留已有弱键对象,不会因为传入一个新的 equals 相等对象,就重新建立以新对象为 referent 的弱引用。键相等与“哪一个对象实际被弱持有”需要分开理解。

这个差别很重要:应用只强保留后来那个等价键,却没有保留最初入表的实际键,并不能保证旧 referent 保持存活。若旧键被清除,映射可能消失,即使应用还能创建或持有 equals 相等的另一个对象。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
// 查询使用掩码后的键与扰动哈希,弱引用已清除的条目不会再匹配有效用户键。
public V get(Object key) {
// 用户 null 键转换为内部专用标记。
Object k = maskNull(key);
int h = hash(k);
Entry<K,V>[] tab = getTable();
int index = indexFor(h, tab.length);
Entry<K,V> e = tab[index];
while (e != null) {
if (e.hash == h && matchesKey(e, k))
return e.value;
e = e.next;
}
return null;
}
1
2
3
4
5
6
7
8
9
WeakHashMap<Object, String> map = new WeakHashMap<>();
Object key = new Object();
map.put(key, "value");
map.put(null, "null-key");
System.out.println(map.get(key)); // value
System.out.println(map.get(null)); // null-key
map.remove(key);
System.out.println(map.size()); // 1
Reference.reachabilityFence(key);

get 即使没有显式用户删除,也可能调用清理改变内部链。对本类而言,读取方法不一定只是读取几个字段,不能把查询成本与 GC 通知处理完全分开。

resize 与 transfer:搬迁中再次识别失效键

容量达到阈值时通常扩为两倍,转移过程不仅计算桶索引,还要读取每个弱键,判断当前是否仍然有效:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 活跃弱键搬到新桶,已经清除的键直接解除条目引用并减少数量。
private void transfer(Entry<K,V>[] src, Entry<K,V>[] dest) {
for (int j = 0; j < src.length; ++j) {
Entry<K,V> e = src[j];
src[j] = null;
while (e != null) {
Entry<K,V> next = e.next;
if (e.refersTo(null)) {
e.next = null; // Help GC
// 解除失效条目对值对象的强引用,便于后续回收。
e.value = null; // " "
size--;
} else {
int i = indexFor(e.hash, dest.length);
e.next = dest[i];
dest[i] = e;
}
e = next;
}
}
}

迁移时若键已清除,可直接丢弃条目并清空 value,不必等所有通知都经过同一轮 queue.poll。GC 关系本身可能在迁移过程中变化,代码需要继续按读到的状态工作。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
// 迁移后成员骤减时可以放弃本轮增长,清理后把活跃条目放回旧表。
void resize(int newCapacity) {
Entry<K,V>[] oldTable = getTable();
int oldCapacity = oldTable.length;
if (oldCapacity == MAXIMUM_CAPACITY) {
threshold = Integer.MAX_VALUE;
return;
}

Entry<K,V>[] newTable = newTable(newCapacity);
transfer(oldTable, newTable);
table = newTable;

/*
* If ignoring null elements and processing ref queue caused massive
* shrinkage, then restore old table. This should be rare, but avoids
* unbounded expansion of garbage-filled tables.
*/
if (size >= threshold / 2) {
threshold = (int)(newCapacity * loadFactor);
} else {
expungeStaleEntries();
transfer(newTable, oldTable);
table = oldTable;
}
}

这里的退回旧容量是一个针对失效键清理的优化,不是普通 HashMap 那种常规翻倍后不自动缩容的路径。它也不等于每次 remove 都会收缩桶数组。

若清理后仍有足够成员,就保留新表并更新 threshold;若数量降得很低,就避免因已经失效的条目而长期持有不必要的大数组。

remove、containsValue 与集合视图

remove(key) 在当前桶链里寻找等价键并摘除,用户触发的删除记录结构修改;remove(key,value) 等默认复合方法的并发安全性不能从弱引用关系推导。

1
2
3
4
5
6
7
8
WeakHashMap<String, Integer> map = new WeakHashMap<>();
String key = new String("A");
map.put(key, null);
System.out.println(map.containsKey(key)); // true
System.out.println(map.get(key)); // null
map.values().remove(null); // 删除一个对应 null 值的映射
System.out.println(map.isEmpty()); // true
Reference.reachabilityFence(key);

containsValue 沿所有桶扫描,不能利用键的哈希快速按值定位。values 不是一个弱值容器,值仍强持有到相应条目清理或删除;存入很大的值对象后,仅让 key 失去可达性也不保证值在下一行已经释放。

size 会处理失效通知,因此连续 size 查询在没有显式 put/remove 的情况下也可能变小。多个观察之间的内容稳定性要结合 GC,而不是只数业务线程调用了多少次写方法。

需要验证业务是否主动删除了某个条目,应使用确定的删除路径和结果;GC 驱动消失不适合当成必须在某个固定时间触发的控制信号。

如何正确安排弱键生命周期

若值保存业务元数据,元数据不应该强保存同一个弱键,也不要通过外部全局登记表把所有键永久保活。需要登记处理状态时,尽量保存与键无强可达关系的标识或另外设计生命周期。

常量字符串可能被字符串池等机制保留,装箱小整数也可能由缓存保留,因此用这些对象演示“立刻 GC 掉弱键”容易得出错误结论。示例使用新对象并明确强可达范围,才能区分具体引用关系。

WeakHashMap 不直接声明 Serializable 或 Cloneable,不能仅凭它是一种 Map 或来自 AbstractMap 就推导序列化和 clone 能力。需要保存长期数据时,应主动复制当前逻辑映射并设计键的持久化表示。

迭代器

HashIterator 保存 expectedModCount,支持用户结构修改的快速失败;同时还保存 nextKey 与 currentKey 的强引用,保护已经确认或最近返回的弱键。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 扫描桶链时跳过已清除的弱键,并把下一键强保存在迭代器中。
public boolean hasNext() {
Entry<K,V>[] t = table;

while (nextKey == null) {
Entry<K,V> e = entry;
int i = index;
while (e == null && i > 0)
e = t[--i];
entry = e;
index = i;
if (e == null) {
currentKey = null;
return false;
}
nextKey = e.get(); // hold on to key in strong ref
if (nextKey == null)
entry = entry.next;
}
return true;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
// 返回前核对修改次数,把缓存键转为 currentKey 以维持当前条目可达性。
protected Entry<K,V> nextEntry() {
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
if (nextKey == null && !hasNext())
throw new NoSuchElementException();

lastReturned = entry;
entry = entry.next;
currentKey = nextKey;
nextKey = null;
return lastReturned;
}

如果 hasNext 已经确认一个键,随后键只剩弱可达,迭代器的 nextKey 会暂时强保留它,避免确认之后又无法返回。遍历对象本身因此可能延长某些键的生命,这不是稳定全表快照。

GC 清理不一定改变 expectedModCount,但显式 put/remove 等用户结构更新可能触发 ConcurrentModificationException。没有快速失败不意味着本类拥有并发映射的弱一致线程安全契约。

1
2
3
4
5
6
7
8
9
10
WeakHashMap<Object, Integer> map = new WeakHashMap<>();
Object a = new Object(), b = new Object();
map.put(a, 1); map.put(b, 2);
Iterator<Map.Entry<Object, Integer>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
if (iterator.next().getValue() == 1) iterator.remove();
}
System.out.println(map.size()); // 1,示例中的键明确保持强可达
Reference.reachabilityFence(a);
Reference.reachabilityFence(b);

活动 Entry 支持 setValue,但其中 getKey 受弱引用状态影响。需要独立留存键值记录时,应复制成自己的条目,并理解复制可能建立新的强引用,反过来影响弱键回收。

视图的数组复制也不能被一概理解为对弱键不产生影响。例如条目数组可以保存复制后的强键值记录,延长返回数组中键的生命。使用本类时,最核心的是弄清谁正在强持有键,而不只是记住名称中有 Weak。

IdentityHashMap

基本特性

IdentityHashMap 继承 AbstractMap,实现 Map、Serializable、Cloneable。它使用引用身份比较键,刻意不采用普通 Map 的 equals 键匹配规则,适合保存对象图遍历、深复制中的“原对象 → 处理结果”关系。

两个对象即使 equals 相等,只要不是同一个引用,就可以成为两个键。null 键和值允许保存,不保证遍历顺序,也不提供线程安全保护。

1
2
3
4
5
6
7
String a = new String("A");
String b = new String("A");
IdentityHashMap<String, Integer> map = new IdentityHashMap<>();
map.put(a, 1); map.put(b, 2);
System.out.println(a.equals(b)); // true
System.out.println(map.size()); // 2
System.out.println(map.get(new String("A"))); // null,不是那两个引用

这里的身份不是公开的内存地址。System.identityHashCode 给出与默认对象身份哈希相关的整数,可能碰撞;真正的键匹配仍依靠 ==,哈希只用于找探测起点。

本类的值查询和条目等价也采用相关身份语义,不能只记“键按 ==,其他都与 HashMap 一样”。与普通 Map 比较 equals 时,甚至可能出现不对称结果,业务不应把它作为任意普通映射的透明替代。

结构分析

它没有桶链和树节点,而是开放寻址表:一个 Object[] 交替保存 key、value。偶数槽存键,其后奇数槽存对应值,碰撞时向后探测下一对槽位,到数组末端再回绕。
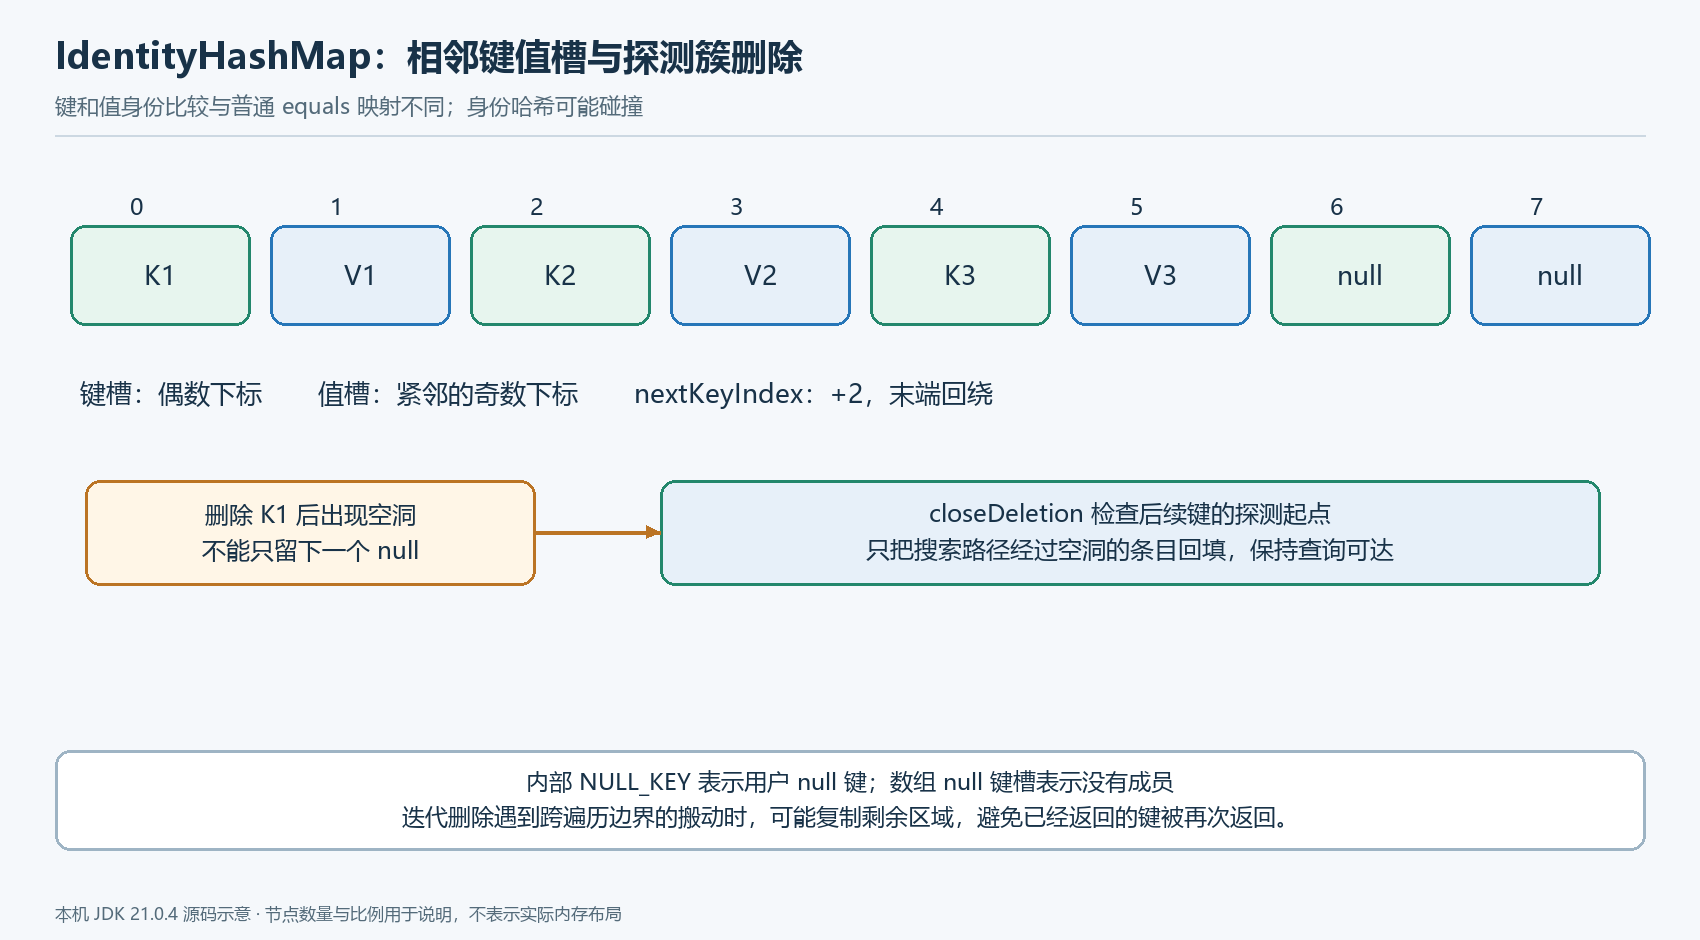
IdentityHashMap 的相邻键值槽与线性探测

空键槽 null 表示探测可以停止,用户 null 键用内部 NULL_KEY 掩码代替。值槽为 null 则可能表示真实 null 值,不能据此判断整对槽位不存在。

数组长度是键容量的两倍,默认预计最大规模为 21,对应默认键容量 32、数组长度 64。构造参数 expectedMaxSize 表达预计映射数,不等于直接指定 Object[] 长度。

预期负载控制大约为键容量的 2/3,源码通过数组长度与映射数的关系判断是否增长。数组还需要保持空键槽,才能让线性探测有明确停止位置。

1
2
3
4
5
6
// 用身份哈希混合后定位偶数键槽,结果只决定探测起点。
private static int hash(Object x, int length) {
int h = System.identityHashCode(x);
// Multiply by -254 to use the hash LSB and to ensure index is even
return ((h << 1) - (h << 8)) & (length - 1);
}
1
2
3
4
// 每次跨过一对键值槽,超过数组边界就回到 0。
private static int nextKeyIndex(int i, int len) {
return (i + 2 < len ? i + 2 : 0);
}

开放寻址避免为每个映射另外分配 Node,但分布与占用程度决定探测长度。正常情况下预期查找接近常数成本,不能保证冲突严重时每次只读一个槽位。

基本操作

get:探测到同一引用或空槽

源码定位:IdentityHashMap.java:336–349。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 从身份哈希起点探测,遇到同一引用返回相邻值,遇到空键槽停止。
public V get(Object key) {
// 用户 null 键转换为内部专用标记。
Object k = maskNull(key);
Object[] tab = table;
int len = tab.length;
int i = hash(k, len);
while (true) {
Object item = tab[i];
if (item == k)
return (V) tab[i + 1];
if (item == null)
return null;
i = nextKeyIndex(i, len);
}
}

等价字符串、重写了 equals 的业务对象,都不会被这个查找流程视为同一键。如果业务实际需要按编号等价,应该使用普通哈希映射或明确的编号键,而不是选择身份映射后再期待 equals 发挥作用。

1
2
3
4
5
6
7
IdentityHashMap<Object, String> map = new IdentityHashMap<>();
Object key = new Object();
map.put(key, "A");
map.put(null, "N");
System.out.println(map.get(key)); // A
System.out.println(map.get(null)); // N
System.out.println(map.containsKey(new Object())); // false

containsValue 也按值引用身份搜索。两个内容相同但分别创建的字符串,不会因此成为同一个值;null 值则仍可通过视图或查询判断。

put:更新引用相同的键或找到空对槽
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
// 线性探测到相同引用则覆盖,否则在空键槽写入键值对,必要时先扩容重试。
public V put(K key, V value) {
// 用户 null 键转换为内部专用标记。
final Object k = maskNull(key);

retryAfterResize: for (;;) {
final Object[] tab = table;
final int len = tab.length;
int i = hash(k, len);

for (Object item; (item = tab[i]) != null;
i = nextKeyIndex(i, len)) {
if (item == k) {
@SuppressWarnings("unchecked")
V oldValue = (V) tab[i + 1];
tab[i + 1] = value;
return oldValue;
}
}

final int s = size + 1;
// Use optimized form of 3 * s.
// Next capacity is len, 2 * current capacity.
if (s + (s << 1) > len && resize(len))
continue retryAfterResize;

// 记录结构或遇见顺序的变化,供快速失败遍历检查。
modCount++;
tab[i] = k;
tab[i + 1] = value;
size = s;
return null;
}
}

遇到相同引用,直接替换值返回旧值,不增加数量和结构修改次数。找到空槽时,先检查新增规模是否需要扩容,扩容成功就回到外层重新计算新起点,再写入。

这与 HashMap 先尾插节点再判断阈值的路径不同,也没有要树化的链。两个对象身份哈希相同仍可共存,后一个对象沿探测序列寻找自己的空槽。

键对象的普通 hashCode/equals 字段修改,不改变引用身份,因此不会产生普通 HashMap 中重新算业务哈希导致找不到的那种错误。但对象自己的状态变化仍需业务同步,本类并不保护字段。

resize:按新长度重新探测全部映射
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
// 新数组中重新定位每个键引用,并清除旧槽对不必要引用的保留。
private boolean resize(int newCapacity) {
// assert (newCapacity & -newCapacity) == newCapacity; // power of 2
int newLength = newCapacity * 2;

Object[] oldTable = table;
int oldLength = oldTable.length;
if (oldLength == 2 * MAXIMUM_CAPACITY) { // can't expand any further
if (size == MAXIMUM_CAPACITY - 1)
throw new IllegalStateException("Capacity exhausted.");
return false;
}
if (oldLength >= newLength)
return false;

Object[] newTable = new Object[newLength];

for (int j = 0; j < oldLength; j += 2) {
Object key = oldTable[j];
if (key != null) {
Object value = oldTable[j+1];
oldTable[j] = null;
oldTable[j+1] = null;
int i = hash(key, newLength);
while (newTable[i] != null)
i = nextKeyIndex(i, newLength);
newTable[i] = key;
newTable[i + 1] = value;
}
}
table = newTable;
return true;
}

由于探测位置依赖新数组长度,每个活跃键都要重新计算起点并找到空位。不是 HashMap 桶链的低/高两组链接拆分,也不是单纯 Arrays.copyOf 保持旧下标。

扩容复制键值引用,不深拷贝对象。旧数组槽位清空后,已有迭代器仍可能持有旧遍历路径,结构变化会通过 modCount 尽力被检测。

容量达到上限时,源码不能再普通翻倍,并要保证至少留出能让探测终止的空间。构造器的预估容量也不是无限内存承诺,输入过大仍可能失败。

remove:删除空洞为什么还要回填

假设几个键从同一个起点连续探测,删除其中一个位置后直接留下 null,会让后续 get 在这个空槽停止,误认为后面的键不存在。删除必须把部分后续键搬到更早的空洞,保留每个键的有效搜索路径。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
// 沿探测簇检查每个键的起点,只有空洞落在其搜索路径上才向前搬动。
private void closeDeletion(int d) {
// Adapted from Knuth Section 6.4 Algorithm R
Object[] tab = table;
int len = tab.length;

// Look for items to swap into newly vacated slot
// starting at index immediately following deletion,
// and continuing until a null slot is seen, indicating
// the end of a run of possibly-colliding keys.
Object item;
for (int i = nextKeyIndex(d, len); (item = tab[i]) != null;
i = nextKeyIndex(i, len) ) {
// The following test triggers if the item at slot i (which
// hashes to be at slot r) should take the spot vacated by d.
// If so, we swap it in, and then continue with d now at the
// newly vacated i. This process will terminate when we hit
// the null slot at the end of this run.
// The test is messy because we are using a circular table.
int r = hash(item, len);
if ((i < r && (r <= d || d <= i)) || (r <= d && d <= i)) {
tab[d] = item;
tab[d + 1] = tab[i + 1];
tab[i] = null;
tab[i + 1] = null;
d = i;
}
}
}

条件要处理数组回绕,所以不能只写“后面的键统统左移”。某些键本来的起点在空洞后方,移动过去反而会破坏它的查找序列;源码按起点、当前位置与空洞的循环相对关系判断。

1
2
3
4
5
6
7
8
IdentityHashMap<Object, Integer> map = new IdentityHashMap<>();
List<Object> keys = new ArrayList<>();
for (int i = 0; i < 100; i++) {
Object key = new Object(); keys.add(key); map.put(key, i);
}
for (int i = 0; i < 100; i += 2) map.remove(keys.get(i));
System.out.println(map.size()); // 50
System.out.println(map.get(keys.get(99))); // 99,删除没有截断其探测路径

这种删除可搬动多个槽位,最坏成本与探测簇长度相关。不能因为没有 Node 指针,就认为删除总是只清空两个槽位。

值身份、视图与对象图用途

JDK 21 明确覆盖了带值条件的 remove 与 replace,使比较值也采用引用身份。需要检验这一点时,不要沿用早期版本默认方法使用 equals 的结论。

1
2
3
4
5
6
IdentityHashMap<Object, String> map = new IdentityHashMap<>();
Object key = new Object();
String value = new String("V");
map.put(key, value);
System.out.println(map.remove(key, new String("V"))); // false,值不是同一引用
System.out.println(map.remove(key, value)); // true

keySet 的成员由键身份区分,entrySet 的条目比较涉及键和值身份。跨不同类型集合执行 equals、removeAll 等组合时,要明确相等策略,不能假定全部集合遵守相同对称语义。

对象图深复制时,两个 equals 相等但独立存在的节点可能各自拥有不同邻居,必须分别记录访问结果;而重复遇到同一个引用又应该复用已有结果。身份映射正好表达这个关系,避免错误合并拓扑节点或无限递归。

clone 新建数组结构,但原键值引用仍共享。它适合复制映射结构,不自动完成业务对象图的深复制;对象图处理需要调用者自己递归构造新对象并用身份表登记。

迭代器

IdentityHashMapIterator 沿偶数键槽寻找成员,保存 index、lastReturnedIndex、expectedModCount、indexValid 和 traversalTable。通常 traversalTable 指向当前主数组,并不在创建时复制全表。

源码定位:IdentityHashMap.java:754–764。

1
2
3
4
5
6
7
8
9
10
11
12
13
// 每次返回偶数键槽前核对结构修改次数,并记录删除所需位置。
protected int nextIndex() {
// 对比结构修改次数,尽力检测外部修改。
if (modCount != expectedModCount)
throw new ConcurrentModificationException();
if (!indexValid && !hasNext())
throw new NoSuchElementException();

indexValid = false;
lastReturnedIndex = index;
index += 2;
return lastReturnedIndex;
}

迭代器 remove 更复杂:普通 closeDeletion 可能把已经返回的成员绕回到未来待遍历区域,导致同一成员重复返回。源码在罕见的跨边界搬动情况下复制剩余数组区域,后续改用这段副本遍历。

下面是该保护分支的节选,外围仍在迭代器自己的空洞回填循环中:

源码定位:IdentityHashMap.java:823–832。

1
2
3
4
5
6
7
8
9
10
11
// 即将把已访问成员搬入未来区域时,复制剩余遍历区间以避免再次返回。

if (i < deletedSlot && d >= deletedSlot &&
traversalTable == IdentityHashMap.this.table) {
int remaining = len - deletedSlot;
Object[] newTable = new Object[remaining];
System.arraycopy(tab, deletedSlot,
newTable, 0, remaining);
traversalTable = newTable;
index = 0;
}

切换到副本后,后续 iterator.remove 还要作用于真实映射,不是只把副本中的槽位清空。这个局部副本是删除算法的补救机制,不能把整体迭代器称为创建时快照。

1
2
3
4
5
6
7
8
9
10
11
IdentityHashMap<Object, Integer> map = new IdentityHashMap<>();
Object a = new Object(), b = new Object();
map.put(a, 1); map.put(b, 2);
Iterator<Map.Entry<Object, Integer>> iterator = map.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<Object, Integer> entry = iterator.next();
if (entry.getValue() == 1) iterator.remove();
else entry.setValue(20);
}
System.out.println(map.get(b)); // 20
System.out.println(map.size()); // 1

条目对象保存槽位等内部关联,删除后的 Entry 不再适合当成稳定长期记录;条目迭代器还会将最近删除条目的索引失效。需要独立记录时应主动复制键和值引用。

外部新增或删除会影响 modCount,可能快速失败;普通已有键值覆盖一般不改变结构。遍历没有插入或排序契约,数组槽位顺序只是当前实现的扫描方式。

本类是一种有意偏离普通 equals 映射契约的专用工具。理解其身份比较与探测删除,才能在对象图场景发挥作用,而不在普通业务键值表中引入难以解释的重复键。

EnumMap

基本特性

EnumMap 是专门以枚举常量为键的映射,继承 AbstractMap,实现 Serializable、Cloneable。每个实例只服务于一个枚举类型,键的遇见顺序就是该类型的声明顺序。

它不允许 null 键,但允许 null 值;不同常量可以对应相同值。它不提供线程安全保护。part1 的概述把它写成线程安全,这里按 JDK 21 源码说明实际规则,不能因为枚举常量稳定就推导映射更新也安全。

1
2
3
4
5
6
7
enum Phase { NEW, RUNNING, DONE }
EnumMap<Phase, String> map = new EnumMap<>(Phase.class);
map.put(Phase.DONE, "finished");
map.put(Phase.NEW, null);
map.put(Phase.RUNNING, "working");
System.out.println(map.keySet()); // [NEW, RUNNING, DONE]
System.out.println(map.containsKey(Phase.NEW)); // true

enum 常量在同一类型中有稳定 ordinal,适合直接映射到槽位。本类不需要哈希桶、链表冲突或树化规则,正常按键 get/put/remove 为 O(1)。

比较两个 EnumMap 或批量复制、遍历时,成本还可能与枚举全集数量有关,不能把所有方法都概括成 O(1)。使用者也不应把 ordinal 当成永不变化的外部持久化编号:调整枚举声明顺序会改变它。

结构分析

字段 keyType 保存枚举类型,keyUniverse 保存全部枚举常量,vals 是长度等于枚举常量数量的 Object[],size 保存实际映射数量。

它与 EnumSet 的位向量不同。EnumSet 只需要记录成员是否存在;EnumMap 还要保存任意 V,所以用一个槽位对应一个常量,再存具体值引用。
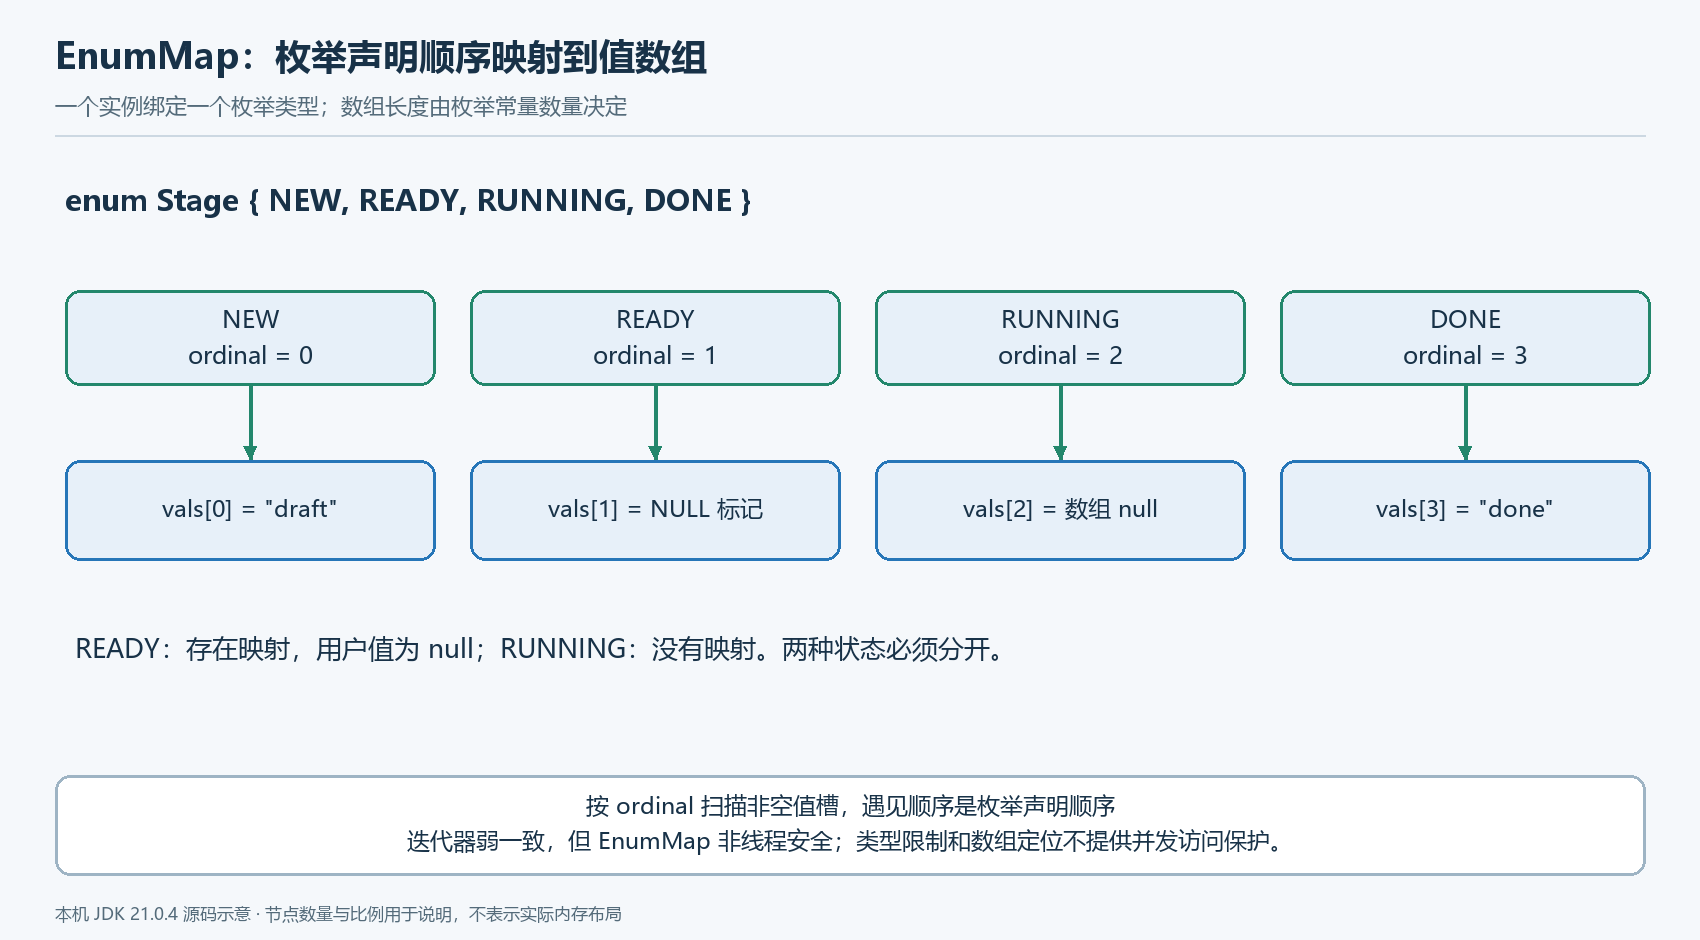
EnumMap 的枚举序号与值槽
1
2
3
4
5
6
// 确定键枚举全集,并一次创建与常量数量对应的值数组。
public EnumMap(Class<K> keyType) {
this.keyType = keyType;
keyUniverse = getKeyUniverse(keyType);
vals = new Object[keyUniverse.length];
}

即使只有一个实际映射,数组也为整个枚举全集准备槽位。空间成本与常量总数 U 有关,而不只与当前 size 有关;不过没有每条映射单独 Node 的分配开销。

vals[i] 为 null 表示没有映射。真实用户 null 值用内部 NULL 哨兵保存,maskNull/unmaskNull 负责两者转换:

1
2
3
4
// 用哨兵区分没有映射的空槽与用户真实 null 值。
private Object maskNull(Object value) {
return (value == null ? NULL : value);
}

因此,containsKey 只要检查合法键对应槽位非 null,get 再还原真实值。没有哨兵时,两种状态都落在数组 null,会无法正确维护 size 和 containsKey。

keyUniverse 可以复用枚举类型的常量信息,复制 EnumMap 时也不需要克隆枚举常量对象。枚举键本身唯一稳定,但 vals 和 size 仍是可变共享状态,所以正常并发更新依然需要同步。

基本操作

构造:显式类型与来源类型推断

显式传入 Phase.class 最直接。另一个构造器从 EnumMap 复制时,可以取得来源保存的 keyType,即使来源为空也知道枚举类型。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
// EnumMap 来源直接取得类型并复制值数组;普通非空 Map 才能从首键推断类型。
public EnumMap(Map<K, ? extends V> m) {
if (m instanceof EnumMap) {
EnumMap<K, ? extends V> em = (EnumMap<K, ? extends V>) m;
keyType = em.keyType;
keyUniverse = em.keyUniverse;
vals = em.vals.clone();
size = em.size;
} else {
if (m.isEmpty())
throw new IllegalArgumentException("Specified map is empty");
keyType = m.keySet().iterator().next().getDeclaringClass();
keyUniverse = getKeyUniverse(keyType);
vals = new Object[keyUniverse.length];
putAll(m);
}
}

普通空 Map 没有键可供推断,会抛 IllegalArgumentException。泛型 K 在运行时不是一个自动可恢复的 Class 对象,不能只因为声明为 Map<Phase,String> 就期待构造器推断成功。

1
2
3
4
5
6
7
8
9
10
enum Phase { NEW, RUNNING, DONE }
EnumMap<Phase, Integer> empty = new EnumMap<>(Phase.class);
EnumMap<Phase, Integer> copy = new EnumMap<>(empty); // 合法,类型已保存
System.out.println(copy.isEmpty()); // true
Map<Phase, Integer> ordinary = new HashMap<>();
try {
new EnumMap<>(ordinary);
} catch (IllegalArgumentException e) {
System.out.println("empty source has no enum type");
}

从普通非空来源复制时,会用首键的 getDeclaringClass 确定类型,再 putAll 校验其他键。同一批里包含不同枚举类型不能被悄悄混入。

put:类型检查、ordinal 定位、null 标记
1
2
3
4
5
6
7
8
9
10
11
12
// 枚举序号直接定位槽位;旧槽为空才增加 size,覆盖只替换值。
public V put(K key, V value) {
typeCheck(key);

int index = key.ordinal();
Object oldValue = vals[index];
// 用户 null 值使用专用标记保存,数组 null 表示没有映射。
vals[index] = maskNull(value);
if (oldValue == null)
size++;
return unmaskNull(oldValue);
}
1
2
3
4
5
6
// 允许同一枚举的常量专用类体,但拒绝其他枚举类型。
private void typeCheck(K key) {
Class<?> keyClass = key.getClass();
if (keyClass != keyType && keyClass.getSuperclass() != keyType)
throw new ClassCastException(keyClass + " != " + keyType);
}

某个枚举常量带有自己的方法实现时,运行时类可能是常量专用子类。源码允许 key.getClass 等于 keyType,或其父类等于 keyType,而不是简单要求每个常量的 getClass 都完全相同。

null 键在调用 getClass 时被拒绝,错误类型键抛 ClassCastException。原槽已经保存 NULL 哨兵时,put 覆盖它也不增加 size,因为对应键早已存在。

1
2
3
4
5
enum Phase { NEW, RUNNING, DONE }
EnumMap<Phase, Integer> map = new EnumMap<>(Phase.class);
System.out.println(map.put(Phase.NEW, null)); // null,首次加入
System.out.println(map.put(Phase.NEW, 10)); // null,原值也是 null
System.out.println(map.size()); // 1,不是两次 put 就有两个映射
get、containsKey 与 remove:查询错误类型的处理不同
1
2
3
4
5
6
7
8
9
// 查询入口先排除 null 与错误枚举类型,合法键才使用 ordinal。
private boolean isValidKey(Object key) {
if (key == null)
return false;

// Cheaper than instanceof Enum followed by getDeclaringClass
Class<?> keyClass = key.getClass();
return keyClass == keyType || keyClass.getSuperclass() == keyType;
}

get/containsKey/remove 采用 isValidKey 检查。错误类型或 null 查询通常返回 null/false,而不是都按 put 的类型异常处理;可写入范围与无结果查询行为不同。

1
2
3
4
5
6
7
8
9
10
11
// 合法键直接清空对应槽位;原来确有映射才减少 size。
public V remove(Object key) {
if (!isValidKey(key))
return null;
int index = ((Enum<?>)key).ordinal();
Object oldValue = vals[index];
vals[index] = null;
if (oldValue != null)
size--;
return unmaskNull(oldValue);
}

remove 返回 null 也可能表示删掉一个原值为 null 的映射,应结合需求明确是否要用带值条件删除或 containsKey 判断。多线程下拆成独立调用仍不建立原子保证。

1
2
3
4
5
6
7
8
9
enum Phase { NEW, RUNNING, DONE }
enum Other { NEW }
EnumMap<Phase, String> map = new EnumMap<>(Phase.class);
map.put(Phase.NEW, null);
System.out.println(map.containsKey(Phase.NEW)); // true
System.out.println(map.containsKey(Other.NEW)); // false
System.out.println(map.get(null)); // null
map.remove(Phase.NEW);
System.out.println(map.isEmpty()); // true

containsValue 会扫描 vals,用户 null 被掩码后参与比较,通常 O(U),不只扫描 size 个紧密排列的槽位。clear 也清空整个值数组,之后保留数组与类型信息供复用。

putAll、equals 与复制成本

来源也是 EnumMap 且键类型相同,可以直接按对应槽位复制活跃值,省去逐个键哈希与查找;但仍需扫描相关数组,并正确调整新增加的映射数量。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 同类型 EnumMap 直接对应槽位复制,其他 Map 复用普通逐项添加。
public void putAll(Map<? extends K, ? extends V> m) {
if (m instanceof EnumMap<?, ?> em) {
if (em.keyType != keyType) {
if (em.isEmpty())
return;
throw new ClassCastException(em.keyType + " != " + keyType);
}

for (int i = 0; i < keyUniverse.length; i++) {
Object emValue = em.vals[i];
if (emValue != null) {
if (vals[i] == null)
size++;
vals[i] = emValue;
}
}
} else {
super.putAll(m);
}
}

不同键类型的非空 EnumMap 不能复制进来;空的不同类型来源可以作为没有任何待添加项处理。具体路径与普通来源的逐个 put 不完全相同。

equals 在同类型 EnumMap 之间也可以直接对应值槽比较,普通 Map 来源则按 Map 映射关系比较。null 值仍要区别有没有键,而不是只看 get 返回 null。

clone 复制 vals 数组,让两个实例的新增、删除和替换独立;具体值对象仍共享。比如两个映射保存相同 ArrayList,clone 之后改列表内容仍可被两边看到。

1
2
3
4
5
6
7
8
enum Phase { NEW, DONE }
EnumMap<Phase, List<String>> original = new EnumMap<>(Phase.class);
original.put(Phase.NEW, new ArrayList<>(List.of("A")));
EnumMap<Phase, List<String>> copied = original.clone();
copied.put(Phase.DONE, List.of("finished"));
copied.get(Phase.NEW).add("B");
System.out.println(original.containsKey(Phase.DONE)); // false,结构独立
System.out.println(original.get(Phase.NEW)); // [A, B],值对象共享

序列化保存枚举类型与逻辑映射成员,恢复时重建与当前枚举类型对应的槽位。枚举常量作为序列化对象有自己的名称规则,不能把本类内部 ordinal 槽位直接当成外部业务编号协议。

迭代器

EnumMapIterator 从 vals 下标 0 开始跳过空槽,所以键与条目按枚举声明顺序返回,值也按对应键顺序出现。实际新增先后不改变这个顺序。

源码定位:EnumMap.java:514–550。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
// 迭代器直接扫描值槽并支持删除,不使用 modCount 快速失败机制。
private abstract class EnumMapIterator<T> implements Iterator<T> {
// Lower bound on index of next element to return
int index = 0;

// Index of last returned element, or -1 if none
int lastReturnedIndex = -1;

public boolean hasNext() {
while (index < vals.length && vals[index] == null)
index++;
return index != vals.length;
}

public void remove() {
checkLastReturnedIndex();

if (vals[lastReturnedIndex] != null) {
vals[lastReturnedIndex] = null;
size--;
}
lastReturnedIndex = -1;
}

private void checkLastReturnedIndex() {
if (lastReturnedIndex < 0)
throw new IllegalStateException();
}
}

private class KeyIterator extends EnumMapIterator<K> {
public K next() {
if (!hasNext())
throw new NoSuchElementException();
lastReturnedIndex = index++;
// 枚举序号映射回声明顺序中的常量。
return keyUniverse[lastReturnedIndex];
}
}

它没有 expectedModCount,文档称为弱一致迭代器,允许观察到某些遍历期间修改,也可能看不到。这里的遍历特征不意味着 EnumMap 已经具备线程安全。

弱一致不等于创建时快照:后续尚未访问的槽位被新写入,当前迭代可能看到;已经越过的槽位再新增则不会因而自动回头。应用需要并发保护时,仍应使用外部同步等明确方案。

1
2
3
4
5
6
7
8
enum Phase { NEW, RUNNING, DONE }
EnumMap<Phase, String> map = new EnumMap<>(Phase.class);
map.put(Phase.NEW, "A"); map.put(Phase.RUNNING, "B"); map.put(Phase.DONE, "C");
Iterator<Phase> iterator = map.keySet().iterator();
while (iterator.hasNext()) {
if (iterator.next() == Phase.RUNNING) iterator.remove();
}
System.out.println(map.keySet()); // [NEW, DONE]

删除按 lastReturnedIndex 清槽,槽仍有映射才减少 size,之后把索引置为 -1,防止同一次 next 连续删除。EntryIterator 还会让刚删除的条目对象失效。

活动条目关联枚举下标,getValue 和 setValue 直接访问对应 vals。它不是独立快照,删除后访问会受到条目有效性检查;长期留存记录应主动复制,不要期待一个槽位对象永远指同一业务提交。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// 活动条目读取和写回同一值槽,用户 null 仍经掩码转换。
public K getKey() {
checkIndexForEntryUse();
return keyUniverse[index];
}

public V getValue() {
checkIndexForEntryUse();
return unmaskNull(vals[index]);
}

public V setValue(V value) {
checkIndexForEntryUse();
V oldValue = unmaskNull(vals[index]);
// 用户 null 值使用专用标记保存,数组 null 表示没有映射。
vals[index] = maskNull(value);
return oldValue;
}

遇见顺序来自 enum 声明,不是值排序。values 可以有重复值,也不能把 EnumMap 的顺序 API 等同于 LinkedHashMap 的显式首尾位置调整,本类不实现 SequencedMap。

在枚举键全集较小、键类型稳定时,直接槽位映射非常紧凑;常量很多而使用极少时,还需要衡量整张 vals 数组的空间。选择本类的理由是已知有限键域,而不是它会自动解决并发或任意对象排序。

Properties

基本特性

Properties 继承 Hashtable<Object,Object>,用于处理字符串属性及其文本、XML 表示。它保留 Map 接口入口,但业务属性应使用 String 键和值,通常通过 setProperty/getProperty 操作。

它不允许 null 键和值,也不保证普通 entrySet 遍历顺序。defaults 可以引用另一份 Properties,形成查询时的默认属性链,不是将默认项直接复制到当前实例。

1
2
3
4
5
6
7
Properties defaults = new Properties();
defaults.setProperty("timeout", "30");
Properties config = new Properties(defaults);
config.setProperty("name", "demo");
System.out.println(config.getProperty("timeout")); // 30,来自 defaults
System.out.println(config.get("timeout")); // null,普通 get 只看当前映射
System.out.println(config.size()); // 1,不统计 defaults

它是线程安全类,但不是“读取配置文件、合并全部默认链、随后查询整个配置”这一串任意组合的统一事务。当前配置与默认配置还可能被分别更新,业务需要一致版本时应另外建立发布边界。

继承 Hashtable 不表示仍直接使用父类那张 Entry 桶数组。它维护自己的 ConcurrentHashMap<Object,Object>,大量方法覆盖后委派给它,这一点需要按源码重新认识。

结构分析

主要字段是 defaults 与 private transient volatile ConcurrentHashMap<Object,Object> map。构造器调用父类包内的 dummy 构造路径,使那些不用的父类存储字段保持占位状态,再创建自己的 map。

1
2
3
4
5
6
7
8
9
10
11
// 绕过普通 Hashtable 建表,创建实际承载属性的内部 ConcurrentHashMap。
private Properties(Properties defaults, int initialCapacity) {
// use package-private constructor to
// initialize unused fields with dummy values
super((Void) null);
map = new ConcurrentHashMap<>(initialCapacity);
this.defaults = defaults;

// Ensure writes can't be reordered
UNSAFE.storeFence();
}
Properties 的内部映射与默认属性链

普通 get、size、contains 等委派到内部 CHM;put/remove/load 等方法还以 Properties 实例的 synchronized 协调。这既保留历史同步协议,也利用内部映射的并发访问能力。

不能据此把全部路径概括成“每个方法都 synchronized”,也不能相反认定“所有写操作都完全绕开实例锁”。它是具体方法覆盖和委派组合,不是继承关系图就能给出的性能结论。

defaults 是另一对象引用,可以继续拥有自己的 defaults。查询逐级回退,不会预先展开成一张永久不变的合并表;应避免形成循环默认链,否则递归查询没有正常终点。

基本操作

setProperty 与 getProperty:字符串接口和普通 Map 的差别

源码定位:Properties.java:229–231。

1
2
3
4
// 字符串专用写入入口仍通过本类覆盖的 put 更新内部映射。
public synchronized Object setProperty(String key, String value) {
return put(key, value);
}

源码定位:Properties.java:1146–1151。

1
2
3
4
5
6
7
// 只有字符串值被视为当前属性;缺失或非字符串值时继续查 defaults。
public String getProperty(String key) {
Object oval = map.get(key);
String sval = (oval instanceof String) ? (String)oval : null;
Properties defaults;
return ((sval == null) && ((defaults = this.defaults) != null)) ? defaults.getProperty(key) : sval;
}

普通 put 的参数是 Object,可以编译通过 put("port",8080),但这不等于属性接口支持任意类型。get 返回这个 Integer,getProperty 则只接受 String,并可能回退默认链。

1
2
3
4
5
6
7
8
Properties defaults = new Properties();
defaults.setProperty("port", "80");
Properties config = new Properties(defaults);
config.put("port", 8080); // 可作为普通 Map 保存,但不是合法字符串属性
System.out.println(config.get("port")); // 8080
System.out.println(config.getProperty("port")); // 80,当前值不是 String,回退 defaults
config.setProperty("port", "8080");
System.out.println(config.getProperty("port")); // 8080

含非字符串键值的实例可能在 store、list、propertyNames 等需要字符串的路径抛 ClassCastException。既然目的是配置属性,日常写入应使用 setProperty,并在边界处转换业务类型。

getProperty(key,defaultValue) 先查完整 defaults 链,最终没有字符串结果才使用方法参数。defaults 的实际映射与这次调用临时传入的默认字符串,是两层不同来源。

load:字符 Reader 与字节 InputStream
1
2
3
4
5
// Reader 已经决定字符解码,本方法负责属性格式解析。
public synchronized void load(Reader reader) throws IOException {
Objects.requireNonNull(reader, "reader parameter is null");
load0(new LineReader(reader));
}
1
2
3
4
5
// 字节入口按属性文件规定的 ISO-8859-1 解释,不直接默认 UTF-8。
public synchronized void load(InputStream inStream) throws IOException {
Objects.requireNonNull(inStream, "inStream parameter is null");
load0(new LineReader(inStream));
}

.properties 的字节 load 采用 ISO-8859-1,超出范围的字符可用 Unicode 转义。若文件按 UTF-8 保存,应先用 UTF-8 的 Reader 解码,再调用 load(Reader),不要依赖平台默认字符集。

1
2
3
4
5
6
7
8
String text = "name=学习Java\ncount=3\n";
Properties config = new Properties();
try (Reader reader = new InputStreamReader(
new ByteArrayInputStream(text.getBytes(StandardCharsets.UTF_8)),
StandardCharsets.UTF_8)) {
config.load(reader);
}
System.out.println(config.getProperty("name")); // 学习Java

load 不负责关闭传入流,调用者可以用 try-with-resources 管理。它将解析出的项加入当前映射,重复键按后来的值覆盖,不先自动 clear,也不把文件中的注释和原排版保存为一个可原样还原的文档模型。

load0:逻辑行、分隔符与转义

LineReader 先读取逻辑行,跳过空行和注释,处理反斜杠续行。load0 再扫描未转义的等号、冒号或空白,将逻辑行拆成键与值,并经 loadConvert 还原转义。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
// 逐行判断未转义分隔符,再转换键值字符并调用 put。
private void load0(LineReader lr) throws IOException {
StringBuilder outBuffer = new StringBuilder();
int limit;
int keyLen;
int valueStart;
boolean hasSep;
boolean precedingBackslash;

while ((limit = lr.readLine()) >= 0) {
keyLen = 0;
valueStart = limit;
hasSep = false;

//System.out.println("line=<" + new String(lineBuf, 0, limit) + ">");
precedingBackslash = false;
while (keyLen < limit) {
char c = lr.lineBuf[keyLen];
//need check if escaped.
if ((c == '=' || c == ':') && !precedingBackslash) {
valueStart = keyLen + 1;
hasSep = true;
break;
} else if ((c == ' ' || c == '\t' || c == '\f') && !precedingBackslash) {
valueStart = keyLen + 1;
break;
}
if (c == '\\') {
precedingBackslash = !precedingBackslash;
} else {
precedingBackslash = false;
}
keyLen++;
}
while (valueStart < limit) {
char c = lr.lineBuf[valueStart];
if (c != ' ' && c != '\t' && c != '\f') {
if (!hasSep && (c == '=' || c == ':')) {
hasSep = true;
} else {
break;
}
}
valueStart++;
}
String key = loadConvert(lr.lineBuf, 0, keyLen, outBuffer);
String value = loadConvert(lr.lineBuf, valueStart, limit - valueStart, outBuffer);
put(key, value);
}
}

以 # 或 ! 开始的注释行被忽略;分隔符前的反斜杠决定其是否属于键内容,不能简单用 line.split("=") 替代整个解析器。

逻辑续行也不是把每个反斜杠都看成续行标记,末尾连续反斜杠的奇偶数影响是否转义换行。\t、\n、\r、\f 等有规定含义,Unicode 转义要求合法的四位十六进制。

1
2
3
4
Properties config = new Properties();
config.load(new StringReader("a=1\na=2\nescaped\\ key:hello\n"));
System.out.println(config.getProperty("a")); // 2,重复键后项覆盖
System.out.println(config.getProperty("escaped key")); // hello,键中空格被转义

这里 Java 字符串自身也有转义,所以代码中要写两层反斜杠。阅读实际属性文件和 Java 字符串示例时,应先分清哪一层负责解释字符。

store:字符串编码、键排序与默认项

store(Writer,comments) 使用调用者选择的字符输出,store(OutputStream,comments) 按 ISO-8859-1 写出并对相应字符转义。它们一般写当前实例的映射,不自动把 defaults 全部展开成正文。

源码定位:Properties.java:913–948。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
// 当前标准 entrySet 路径先复制并按字符串键排序,再转义写出。
private void store0(BufferedWriter bw, String comments, boolean escUnicode)
throws IOException
{
if (comments != null) {
writeComments(bw, comments);
}
writeDateComment(bw);

synchronized (this) {
@SuppressWarnings("unchecked")
Collection<Map.Entry<String, String>> entries = (Set<Map.Entry<String, String>>) (Set) entrySet();
// entrySet() can be overridden by subclasses. Here we check to see if
// the returned instance type is the one returned by the Properties.entrySet()
// implementation. If yes, then we sort those entries in the natural order
// of their key. Else, we consider that the subclassed implementation may
// potentially have returned a differently ordered entries and so we just
// use the iteration order of the returned instance.
if (entries instanceof Collections.SynchronizedSet<?> ss
&& ss.c instanceof EntrySet) {
entries = new ArrayList<>(entries);
((List<Map.Entry<String, String>>) entries).sort(Map.Entry.comparingByKey());
}
for (Map.Entry<String, String> e : entries) {
String key = e.getKey();
String val = e.getValue();
key = saveConvert(key, true, escUnicode);
/* No need to escape embedded and trailing spaces for value, hence
* pass false to flag.
*/
val = saveConvert(val, false, escUnicode);
bw.write(key + "=" + val);
bw.newLine();
}
}
bw.flush();
}

它会识别标准返回的同步 EntrySet,复制为列表并按键自然顺序排序;如果子类覆盖 entrySet 提供别的类型,则沿该来源顺序写出。不能从普通映射遍历无序推导本版 store 必然无序。

排序只针对这次写出的条目,不把内部 CHM 改造成 TreeMap。默认输出还包含日期等注释,因此同一内容两次 store 也不必字节完全相同,更不自动保留输入文件的注释、空格和顺序。

1
2
3
4
5
6
7
8
9
10
Properties defaults = new Properties();
defaults.setProperty("default-only", "D");
Properties config = new Properties(defaults);
config.setProperty("z", "last");
config.setProperty("a", "first");
StringWriter writer = new StringWriter();
config.store(writer, "demo");
String stored = writer.toString();
System.out.println(stored.contains("default-only=")); // false,默认项不直接保存
System.out.println(stored.indexOf("a=first") < stored.indexOf("z=last")); // true,本版标准路径按键排序

store 会 flush 相应包装输出,不替调用者关闭普通传入流。需要格式无损编辑配置文件时,仅 load 再 store 不能满足,应该采用保存语法及排版信息的其他文档模型。

XML 入口 loadFromXML/storeToXML 有独立格式与编码规则,默认 XML 输出使用 UTF-8,不能与普通 InputStream load 的 ISO-8859-1 规则混同。loadFromXML 会按文档规定关闭输入流,这与普通 load 的资源行为不同。

默认链查询、名称集合与普通视图

propertyNames 合并当前及 defaults 的名称到临时 Hashtable,再返回 Enumeration;键必须是字符串,遇到非字符串键可能抛异常。

1
2
3
4
5
6
// 合并键和值均为字符串的属性名,返回独立的不可修改集合。
public Set<String> stringPropertyNames() {
Map<String, String> h = new HashMap<>();
enumerateStringProperties(h);
return Collections.unmodifiableSet(h.keySet());
}

stringPropertyNames 只收集字符串键且字符串值的条目,并考虑默认链。结果不是实时视图,后续 setProperty 不会自动加入这次已经返回的 Set。

1
2
3
4
5
6
Properties config = new Properties();
config.setProperty("A", "1");
Set<String> names = config.stringPropertyNames();
config.setProperty("B", "2");
System.out.println(names.contains("B")); // false,名称集合已经独立生成
System.out.println(config.keySet().contains("B")); // true,普通键视图共享当前映射

get、containsKey、size、entrySet 仅看当前内部 map,不自动包含 defaults。因此,用户看到 getProperty 有值而 containsKey 返回 false,是默认回退的正常结果,不能据此判定映射结构矛盾。

clone 新建内部 CHM,键值引用仍共享,defaults 引用也不是递归深拷贝。序列化则通过兼容路径保存相关逻辑数据,不能把父类 unused table 当作实际属性存储去分析。

迭代器

普通 entrySet、keySet、values 被同步包装,并委派到内部 ConcurrentHashMap 的视图。遍历具有弱一致行为,不采用 Hashtable 原 Enumerator 的快速失败规则。

1
2
3
4
// 同步包装内部 CHM 条目视图,并限制添加能力以保持 Properties 的视图契约。
public Set<Map.Entry<Object, Object>> entrySet() {
return Collections.synchronizedSet(new EntrySet(map.entrySet()), this);
}

内部 EntrySet 包装还有一个作用:CHM.entrySet 提供某些添加能力,但 Properties 的条目视图不应因此接受 add/addAll,所以包装层明确抛 UnsupportedOperationException。

同步包装不在 iterator 创建之后自动持锁直到遍历结束。若应用需要让一段遍历与通过 Properties 正常同步方法进行的写入互斥,应明确在同一个实例监视器下组织操作;任意外部条目修改和默认链更新仍需考虑各自边界。

1
2
3
4
5
6
7
8
9
10
Properties config = new Properties();
config.setProperty("A", "1");
config.setProperty("B", "2");
Iterator<Map.Entry<Object, Object>> iterator = config.entrySet().iterator();
while (iterator.hasNext()) {
Map.Entry<Object, Object> entry = iterator.next();
if (entry.getKey().equals("A")) iterator.remove();
}
System.out.println(config.getProperty("A")); // null
System.out.println(config.getProperty("B")); // 2

keys/elements 用 Collections.enumeration 包装当前内部视图,不直接暴露 CHM 自己那个可同时当 Iterator 使用的 Enumeration。propertyNames 则属于临时合并结果,stringPropertyNames 属于独立名称集合,这三类入口不能统一解释成同一张快照。

通过 getProperty 读取的是属性字符串,通过普通 Entry 遍历的是当前 Object 映射。理解这两层用途,再区分编码、默认链和输出排序,才能避免配置内容看似保存成功却在下一次读取时产生不同结果。

视图、不可修改映射与实现选择

Map.of、Map.copyOf 与不可修改包装

JDK 21 的 Map.of/Map.ofEntries 创建不可修改映射,拒绝 null 键和值。重复键也会被拒绝,而不是像普通 put 一样由后来的条目覆盖。

1
2
3
4
5
6
7
Map<String, Integer> map = Map.of("A", 1, "B", 2);
System.out.println(map.get("A")); // 1
try {
map.put("C", 3);
} catch (UnsupportedOperationException e) {
System.out.println("unmodifiable");
}

本机源码对单项使用 Map1,对较多项使用 MapN 等内部实现。它们不是完整可变 HashMap 的只读子类,不能拿 HashMap 的容量、树化和迭代顺序解释这些工厂对象。

MapN 也使用相邻键值槽与开放寻址,但键匹配仍采用普通 equals,与 IdentityHashMap 的身份规则不同。其遍历方向与起点还有内部随机化,不应依赖某次输出顺序作为长期契约。

下面的工厂源码也说明它如何选择内部实现

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// 空映射与单映射有专用分支,多项交给 MapN 校验键值和重复键。
static <K, V> Map<K, V> ofEntries(Entry<? extends K, ? extends V>... entries) {
if (entries.length == 0) { // implicit null check of entries array
@SuppressWarnings("unchecked")
var map = (Map<K,V>) ImmutableCollections.EMPTY_MAP;
return map;
} else if (entries.length == 1) {
// implicit null check of the array slot
return new ImmutableCollections.Map1<>(entries[0].getKey(),
entries[0].getValue());
} else {
Object[] kva = new Object[entries.length << 1];
int a = 0;
for (Entry<? extends K, ? extends V> entry : entries) {
// implicit null checks of each array slot
kva[a++] = entry.getKey();
kva[a++] = entry.getValue();
}
return new ImmutableCollections.MapN<>(kva);
}
}

Map.copyOf 复制输入当前内容形成不可修改结果,后续输入的增删不反映到结果中;适当来源可能直接复用已有不可修改映射。复制仍只复制对象引用,不冻结值对象字段。

1
2
3
4
5
6
7
Map<String, Integer> source = new HashMap<>();
source.put("A", 1);
Map<String, Integer> copy = Map.copyOf(source);
Map<String, Integer> view = Collections.unmodifiableMap(source);
source.put("B", 2);
System.out.println(copy.containsKey("B")); // false,独立内容
System.out.println(view.containsKey("B")); // true,共享包装视图

unmodifiableMap 是限制从包装入口修改的共享视图,不要求源映射拒绝 null,也不会自动将源映射变成线程安全。需要有序包装时,JDK 21 还有相应的顺序接口包装入口,但顺序与可修改性仍然是两个属性。

几种映射放在一起看

实现 主要结构 键判定 遍历次序 null 键 / 值 并发与遍历
HashMap 桶数组、链、树桶 hashCode 与 equals 无保证 允许 / 允许 非线程安全,尽力快速失败
Hashtable 桶数组与链 hashCode 与 equals 无保证 拒绝 / 拒绝 实例监视器;Iterator 与 Enumeration 有区别
LinkedHashMap 哈希结构与全局双向链 hashCode 与 equals 插入、访问或显式位置 允许 / 允许 非线程安全,顺序变化也可能快速失败
TreeMap 红黑树 比较结果为 0 键比较顺序 比较器可支持 / 允许 非线程安全,范围共享,尽力快速失败
ConcurrentHashMap 并发桶、树管理、迁移节点 hashCode 与 equals 无保证 拒绝 / 拒绝 单键原子更新,弱一致遍历
ConcurrentSkipListMap 有序基础链及稀疏索引 比较结果为 0 键比较顺序 拒绝 / 拒绝 单键原子更新,函数可能重算,弱一致
WeakHashMap 弱键 Entry 桶链 hashCode 与 equals 无保证 允许 / 允许 非线程安全,GC 也可改变内容
IdentityHashMap 相邻键值槽与线性探测 引用身份 == 无保证 允许 / 允许 非线程安全,身份条目语义
EnumMap ordinal 对应值数组 同类型枚举常量 枚举声明顺序 拒绝 / 允许 非线程安全,弱一致迭代
Properties 内部 CHM 及 defaults 链 普通映射键规则 普通遍历无保证 拒绝 / 拒绝 线程安全;字符串属性与普通视图区分

普通业务键值查找通常从 HashMap 开始考虑;需要保持遇见顺序看 LinkedHashMap,需要键范围及邻近搜索看 TreeMap,并发情况下再分别对照 CHM 与跳表实现。有限枚举键域、对象身份记录、弱键生命周期、属性格式解析,则由对应专用类表达。

线程安全、键等价、遍历顺序、是否有快照,以及值对象自己的可变性应分别确定。一个方法能原子更新当前键,不代表整张映射的每一项都属于统一事务时刻;一个条目不可修改,也不代表它指向的值对象不可变。

一些面试题

HashMap 和 Hashtable 的区别

  • 线程是否安全:HashMap 是非线程安全的,Hashtable 是线程安全的,因为 Hashtable 内部的方法基本都经过synchronized 修饰。正常读写会竞争同一个实例监视器;如果需要大量并发访问,可以考虑 ConcurrentHashMap,仍要结合具体 API 与业务同步需求选择。
  • 效率: 单线程且不需要同步时,HashMap 通常避免了 Hashtable 的实例锁开销;并发吞吐还取决于实际负载。Hashtable 仍是可用的历史兼容类。
  • 对 Null key 和 Null value 的支持:HashMap 可以存储 null 的 key 和 value,但 null 作为键只能有一个,null 作为值可以有多个;Hashtable 不允许有 null 键和 null 值,否则会抛出 NullPointerException。
  • 初始容量大小和每次扩充容量大小的不同:
    • 创建时如果不指定容量初始值,Hashtable 默认的初始大小为 11,之后每次扩充,容量变为原来的 2n+1。HashMap 默认首次正常分配的桶容量为 16,无参构造时还没有创建桶数组。之后每次扩充,容量变为原来的 2 倍。
    • 创建时如果给定了容量初始值,那么 Hashtable 会直接使用你给定的大小,而 HashMap 会将其扩充为 2 的幂次方大小(HashMap 中的tableSizeFor()方法保证)。也就是说 HashMap 总是使用 2 的幂作为哈希表的大小,后面会介绍到为什么是 2 的幂次方。
  • 底层数据结构: JDK1.8 以后的 HashMap 在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)时,将链表转化为红黑树(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树),以减少搜索时间。Hashtable 没有这样的机制。
  • 哈希函数的实现:HashMap 对哈希值进行了高位和低位的混合扰动处理以减少冲突,而 Hashtable 直接使用键的 hashCode() 值。

HashMap 的构造函数中有一个 tableSizeFor(int cap) 方法,它的作用就是在源码允许的容量上限内,将有效初始容量请求调整为足够大的最小 2 的幂,并处理零值与上界。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public HashMap(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal initial capacity: " +
initialCapacity);
if (initialCapacity > MAXIMUM_CAPACITY)
initialCapacity = MAXIMUM_CAPACITY;
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal load factor: " +
loadFactor);
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}
public HashMap(int initialCapacity) {
this(initialCapacity, DEFAULT_LOAD_FACTOR);
}

下面这个方法保证了 HashMap 总是使用 2 的幂作为哈希表的大小。

源码定位:HashMap.java:377–380。

1
2
3
4
5
// 按 JDK 21 的前导零计算实现返回足够大的 2 的幂。
static final int tableSizeFor(int cap) {
int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1);
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}

HashMap 和 TreeMap 区别

TreeMap 和HashMap 都继承自AbstractMap ,但是需要注意的是TreeMap它还实现了NavigableMap接口和SortedMap 接口。所以说,TreeMap是有序的
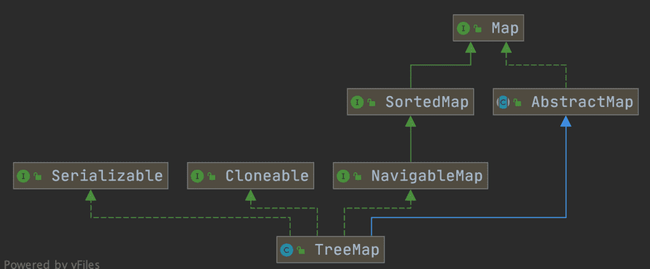
TreeMap 继承关系图
  • 实现 NavigableMap 接口让 TreeMap 有了对集合内元素的搜索的能力。因为NavigableMap 接口提供了丰富的方法来探索和操作键值对

    1. 定向搜索: ceilingEntry(), floorEntry(), higherEntry()和 lowerEntry() 等方法可以用于定位大于等于、小于等于、严格大于、严格小于给定键的最接近的键值对。
    2. 子集操作: subMap(), headMap()和 tailMap() 方法可以高效地创建原集合的子集视图,而无需复制整个集合。
    3. 逆序视图:descendingMap() 方法返回一个逆序的 NavigableMap 视图,使得可以反向迭代整个 TreeMap。
    4. 边界操作: firstEntry(), lastEntry(), pollFirstEntry()和 pollLastEntry() 等方法可以方便地访问和移除元素。

    这些方法都是基于红黑树数据结构的属性实现的,红黑树保持平衡状态,从而保证了搜索操作的时间复杂度为 O(log n),这让 TreeMap 成为了处理有序集合搜索问题的强大工具。

  • 实现SortedMap接口让 TreeMap 有了对集合中的元素根据键排序的能力。默认是按 key 的升序排序,不过我们也可以指定排序的比较器。

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    26
    27
    28
    29
    30
    31
    32
    /**
    * @author shuang.kou
    * @createTime 2020年06月15日 17:02:00
    */
    public class Person {
    private Integer age;

    public Person(Integer age) {
    this.age = age;
    }

    public Integer getAge() {
    return age;
    }


    public static void main(String[] args) {
    TreeMap<Person, String> treeMap = new TreeMap<>(new Comparator<Person>() {
    @Override
    public int compare(Person person1, Person person2) {
    return Integer.compare(person1.getAge(), person2.getAge());
    }
    });
    treeMap.put(new Person(3), "person1");
    treeMap.put(new Person(18), "person2");
    treeMap.put(new Person(35), "person3");
    treeMap.put(new Person(16), "person4");
    treeMap.entrySet().stream().forEach(personStringEntry -> {
    System.out.println(personStringEntry.getValue());
    });
    }
    }

综上,相比于HashMap来说, TreeMap 主要多了对集合中的元素根据键排序的能力以及对集合内元素的搜索的能力

描述一下HashMap 的底层实现

JDK1.8 之前

JDK1.8 之前 HashMap 底层是 数组和链表 结合在一起使用也就是 链表散列。

HashMap 通过 key 的 hashcode 经过扰动函数处理过后得到 hash 值,然后通过 (n - 1) & hash 判断当前元素存放的位置,如果当前位置存在元素的话,就判断该元素与要存入的元素的 hash 值以及 key 是否相同,如果相同的话,直接覆盖,不相同就通过拉链法解决哈希冲突。

HashMap 中的扰动函数(hash 方法)是用来优化哈希值的分布。通过对原始的 hashCode() 进行额外处理,扰动函数可以减小由于高低位的分配问题的 hashCode() 实现导致的碰撞,从而提高数据的分布均匀性。

JDK 1.8 的 hash 方法 相比于 JDK 1.7 hash 方法更加简化,但是原理不变。

1
2
3
4
5
6
7
static final int hash(Object key) {
int h;
// key.hashCode():返回散列值也就是hashcode
// ^:按位异或
// >>>:无符号右移,忽略符号位,空位都以0补齐
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}

所谓 “拉链法” 就是:将链表和数组相结合。也就是说创建一个链表数组,数组中每一格就是一个链表。若遇到哈希冲突,则将冲突的值加到链表中即可。
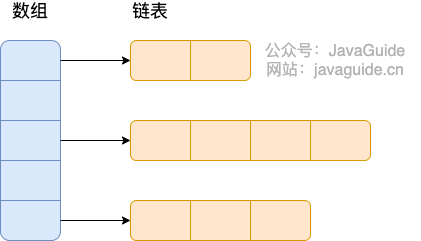
jdk1.8 之前的内部结构-HashMap

JDK1.8 之后

相比于之前的版本, JDK1.8 之后在解决哈希冲突时有了较大的变化,当链表长度大于阈值(默认为 8)(将链表转换成红黑树前会判断,如果当前数组的长度小于 64,那么会选择先进行数组扩容,而不是转换为红黑树)时,将链表转化为红黑树。

这样做的目的是减少搜索时间:链表的查询效率为 O(n)(n 是链表的长度),红黑树是一种自平衡二叉搜索树,其查询效率为 O(log n)。当链表较短时,O(n) 和 O(log n) 的性能差异不明显。但当链表变长时,查询性能会显著下降。
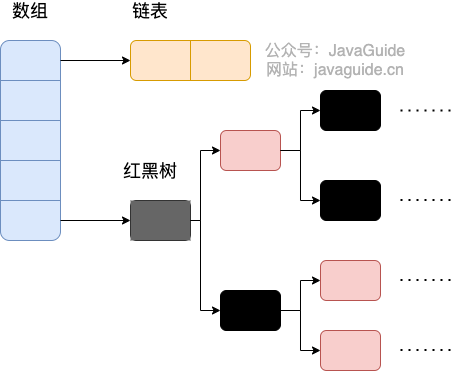
jdk1.8之后的内部结构-HashMap

数组扩容能减少哈希冲突的发生概率(即将元素重新分散到新的、更大的数组中),这在多数情况下比直接转换为红黑树更高效。因为红黑树需要保持自平衡,维护成本较高。并且,过早引入红黑树反而会增加复杂度。

为什么选择阈值 8 和 64?

  1. 源码以平均桶占用约 0.5 的理想随机散列作泊松近似时,桶长度达到 8 的概率极低,小于千万分之一;这不描述所有实际哈希分布。在上述理想模型下,长碰撞链很少出现;阈值 8 是源码在普通节点与树节点成本之间采用的策略,不能保证任意实际负载都达到相同平衡。
  2. 数组长度阈值 64 是当前源码设定的最小树化容量。在小数组中扩容成本低,优先扩容可以避免过早引入红黑树。64 是源码选择的最小树化容量边界;是否碰撞主要还取决于哈希分布和成员数量,不能由达到 64 单独推出冲突变多。

TreeMap、TreeSet 以及 JDK1.8 之后的 HashMap 底层都用到了红黑树。红黑树就是为了解决二叉查找树的缺陷,因为二叉查找树在某些情况下会退化成一个线性结构。

我们来结合源码分析一下 HashMap 链表到红黑树的转换。

  • 源码中定义了三个关键常量,它们共同决定了转换逻辑:

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    /** 
    * 链表转红黑树的阈值。
    * 树化策略阈值为 8;普通 putVal 链表路径的实际触发时点需结合 binCount。
    */
    static final int TREEIFY_THRESHOLD = 8;

    /**
    * 红黑树转回链表的阈值。
    * resize 拆分组节点数 <= 6 时会 untreeify;removeTreeNode 另按树形及 movable 判断。
    */
    static final int UNTREEIFY_THRESHOLD = 6;

    /**
    * 能够进行 treeify 的最小哈希表容量。
    * 如果当前 table.length < 64,即使已触发树化检查,也会优先选择 resize(扩容)而不是 treeify。
    */
    static final int MIN_TREEIFY_CAPACITY = 64;
  • 当你调用 map.put(key, value) 时,最终会进入 putVal 方法。在遍历链表插入新节点后,有如下判断:

源码定位:HashMap.java:647–652。

1
2
3
4
5
6
7
// 普通 put 链表追加后按 binCount 判断是否进行树化检查。
if ((e = p.next) == null) {
p.next = newNode(hash, key, value, null);
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
treeifyBin(tab, hash);
break;
}
  • treeifyBin 方法进行树化,这是执行转换的核心方法

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    22
    23
    24
    25
    final void treeifyBin(Node<K,V>[] tab, int hash) {
    int n, index; Node<K,V> e;
    //如果 table 太小(<64),则优先扩容,而不是树化!
    if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)
    resize(); // 扩容后,元素会被 rehash 到更多桶中,可能就不再冲突了
    else if ((e = tab[index = (n - 1) & hash]) != null) {
    // table 足够大,才真正执行树化
    TreeNode<K,V> hd = null, tl = null;
    // 第一步:将链表中的所有普通 Node 节点替换为 TreeNode 节点
    do {
    TreeNode<K,V> p = replacementTreeNode(e, null);
    if (tl == null)
    hd = p; // hd 是新树的头节点
    else {
    p.prev = tl;
    tl.next = p;
    }
    tl = p;
    } while ((e = e.next) != null);

    // 第二步:将这个 TreeNode 链表真正构建成一棵红黑树
    if ((tab[index] = hd) != null)
    hd.treeify(tab); // 核心树化逻辑
    }
    }

    TreeNode 在插入时会进行排序,以维护树形;可有效按哈希或键比较定位时有对数搜索优势,同哈希且无法比较的键可能需要搜索多个分支:

    1. 首先按节点保存的扰动 hash 分方向。
    2. 如果扰动 hash 相同:
      • 先检查键相等;若能识别合适的 Comparable 类型且比较结果有效,再用该方向定位。
      • 否则,使用 tieBreakOrder():先比较类名,再比较 System.identityHashCode() 辅助确定插入方向;它不是公开内存地址,可能碰撞,也不提供用户插入顺序契约。

    这部分逻辑在 TreeNode.putTreeVal 和 TreeNode.find 方法中有体现。

  • 这其中还有个反向转换,也就是当红黑树中的节点因删除或扩容而减少时,会尝试转回链表以节省空间,在 remove 或 resize 过程中可能触发

    1
    2
    3
    // resize 拆分后的低位组节点数 ≤ UNTREEIFY_THRESHOLD(即 6)。
    if (lc <= UNTREEIFY_THRESHOLD)
    tab[index] = loHead.untreeify(map);

HashMap 的长度为什么是 2 的幂次方

HashMap 的容量被设计为 2 的幂次方,主要是出于性能优化和算法实现简便性的考虑

  1. 使用高效的位运算替代取模运算,提升索引计算速度

    首先,在 HashMap 中,我们需要根据 key 的哈希值来确定它应该存放在底层数组桶(table)中的哪个位置(索引)。最直观的方法是使用取模运算:index = hash % length。

    但是,整数除法或余数计算通常比简单掩码更复杂,具体机器码还取决于 JIT 是否能优化该表达式。通常情况下,我们会用位与运算(&) 来代替它。HashMap 也是这样设计的

    当数组长度 length 是 2 的幂次方时,length - 1 的二进制表示会是一串连续的 1。例如,长度为 16(2^4)时,length - 1 = 15,其二进制是 1111。

    此时,hash & (length - 1) 对非负 hash 与 hash % length 等价;对可能为负的 Java int,不能直接等同于 %,它对应 2 的幂模数下的非负模位置,但它只进行一次非常快速的位运算,极大地提升了计算索引的性能。

  2. 让所需低位参与桶定位,并配合扰动改善某些分布问题

    其次,这个设计有助于更均匀地分布元素,从而减少哈希冲突

    因为 length - 1 全是 1,所以 hash & (length - 1) 实际上是在截取哈希值的低 n 位(n 是 length 的指数)。这使得哈希值的低位信息能够充分参与索引计算。

    如果长度不是 2 的幂,比如 10,那么 length - 1 = 9(二进制 1001),进行 & 运算时,只有特定的非0位(第0位和第3位)会起作用,其他位会被屏蔽掉。这会导致很多不同的哈希值映射到同一个索引上,造成严重的哈希冲突,降低 HashMap 的性能。

  3. 简化扩容(resize)时的元素迁移逻辑

    HashMap 扩容时,新容量是原容量的两倍,因此新容量也必然是 2 的幂次方。

    在这种情况下,一个元素在扩容后的新位置只有两种可能:

    • 要么保持在原来的位置;
    • 要么移动到 原位置 + 原容量 的位置。

    这个判断只需要检查哈希值新增的那一位是 0 还是 1 即可,即 hash & oldCap 是否为 0,如果结果为 0 则保持在原位置;非 0 时移动到原位置加 oldCap,掩码结果本身不一定等于数字 1

HashMap 的构造函数中有一个 tableSizeFor(int cap) 方法,它的作用就是在源码允许的容量上限内,将有效初始容量请求调整为足够大的最小 2 的幂,并处理零值与上界。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
public HashMap(int initialCapacity, float loadFactor) {
if (initialCapacity < 0)
throw new IllegalArgumentException("Illegal initial capacity: " +
initialCapacity);
if (initialCapacity > MAXIMUM_CAPACITY)
initialCapacity = MAXIMUM_CAPACITY;
if (loadFactor <= 0 || Float.isNaN(loadFactor))
throw new IllegalArgumentException("Illegal load factor: " +
loadFactor);
this.loadFactor = loadFactor;
this.threshold = tableSizeFor(initialCapacity);
}
public HashMap(int initialCapacity) {
this(initialCapacity, DEFAULT_LOAD_FACTOR);
}

下面这个方法保证了 HashMap 总是使用 2 的幂作为哈希表的大小。

源码定位:HashMap.java:377–380。

1
2
3
4
5
// 按 JDK 21 的前导零计算实现返回足够大的 2 的幂。
static final int tableSizeFor(int cap) {
int n = -1 >>> Integer.numberOfLeadingZeros(cap - 1);
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}

HashMap 的 put 流程是怎么样的

image-20260305101440295

说一下 HashMap 多线程操作导致死循环问题

JDK1.7 及之前版本的 HashMap 在多线程环境下扩容操作可能存在死循环问题,这是由于当一个桶位中有多个元素需要进行扩容时,多个线程同时对链表进行操作,头插法可能会导致链表中的节点指向错误的位置,从而形成一个环形链表,进而使得查询元素的操作陷入死循环无法结束。

JDK 1.8 起,普通 put 链表路径使用尾部追加,扩容按低位组与高位组保留组内相对顺序,消除了旧式头插迁移反转带来的特定成环机制;这不代表所有插入入口都尾插,也不保证任意并发误用都不会破坏结构。但是还是不建议在多线程下使用 HashMap,因为多线程下使用 HashMap 还是会存在数据覆盖的问题。并发环境下,推荐使用 ConcurrentHashMap 。

说一下HashMap 为什么线程不安全

HashMap 不是线程安全的。在多线程环境下对 HashMap 进行并发写操作,可能会导致两种主要问题:

  1. 数据丢失:并发 put 操作可能导致一个线程的写入被另一个线程覆盖。
  2. 无限循环:在 JDK 7 及以前的版本中,并发扩容时,由于头插法可能导致链表形成环,从而在 get 操作时引发无限循环,CPU 飙升至 100%。

数据丢失这个在 JDK1.7 和 JDK 1.8 中都存在,这里以 JDK 1.8 为例进行介绍。

JDK 1.8 后,在 HashMap 中,多个键值对可能会被分配到同一个桶(bucket),并以链表或红黑树的形式存储。多个线程对 HashMap 的 put 操作会导致线程不安全,具体来说会有数据覆盖的风险。

举个例子:

  • 两个线程 1,2 同时进行 put 操作,并且发生了哈希冲突(hash 函数计算出的插入下标是相同的)。
  • 不同的线程可能在不同的时间片获得 CPU 执行的机会,当前线程 1 执行完哈希冲突判断后,由于时间片耗尽挂起。线程 2 先完成了插入操作。
  • 随后,线程 1 获得时间片,由于之前已经进行过 hash 碰撞的判断,所有此时会直接进行插入,这就导致线程 2 插入的数据被线程 1 覆盖了。
1
2
3
// 空桶写入不是 CAS;无外部同步时多个线程可能根据旧观察覆盖槽位。
if ((p = tab[i = (n - 1) & hash]) == null)
tab[i] = newNode(hash, key, value, null);

还有一种情况是这两个线程同时 put 操作导致 size 的值不正确,但计数丢失与桶节点写入丢失是不同的竞争问题:

  1. 线程 1 执行 if(++size > threshold) 判断时,假设获得 size 的值为 10,由于时间片耗尽挂起。
  2. 线程 2 也读取旧计数 10,把自身的递增结果写成 11。
  3. 线程 1 恢复后也把基于旧值计算的 11 写回,导致一次计数更新丢失。
  4. 两次新增的桶节点链接发生在计数递增之前,可能仍有两个节点存在;计数只增加 1 不能证明只有一个映射被保存。桶写入丢失与 size 计数丢失需要分别分析。
1
2
3
4
5
6
7
8
// 链接完成后才更新修改次数和 size,再检查扩容及执行插入钩子。
// 记录结构或遇见顺序的变化,供快速失败遍历检查。
++modCount;
// 新映射计数超过阈值时扩容,覆盖旧值不走这个分支。
if (++size > threshold)
resize();
afterNodeInsertion(evict);
return null;

ConcurrentHashMap 和 Hashtable 的区别

ConcurrentHashMap 和 Hashtable 的区别主要体现在实现线程安全的方式上不同。

Hashtable 使用桶数组与链表,主要访问方法争用同一实例监视器,没有 Segment 或树桶。早期 ConcurrentHashMap 的分段结构不能套给 Hashtable;JDK 21 的 ConcurrentHashMap 使用桶数组、链表、TreeBin、迁移标记与分散计数,空桶 CAS、非空桶协调,读取不获取一把全表实例锁。

ConcurrentHashMap 是如何实现线程安全的

主要通过几层机制协调:

  1. 空桶用 CAS 原子发布新节点;已有普通桶通常锁定桶入口,并在锁内确认入口仍有效,再更新链或树结构。
  2. 读取使用可见字段及相应槽位访问;遇到 ForwardingNode 转到新表,遇到 TreeBin 使用树桶读协调,不能简单概括成没有任何同步状态。
  3. 扩容通过 transferIndex 分配迁移区间,线程可以协作;先发布新桶,再把旧槽位替换成转发标记。
  4. 数量通过 baseCount/CounterCell 分散维护,size/mappingCount 在并发期间不提供冻结全表的事务快照。
  5. putIfAbsent、条件 replace/remove、compute/merge 等表达单键原子更新;普通 get 后再 put 的业务组合仍可能丢失更新,多键操作也不自动成为事务。

它不允许 null 键和值,迭代器弱一致,不按 HashMap 的快速失败机制工作。值对象在写入之后的可变字段和多个映射之间的一致性,仍要由业务另行协调。