本文章持续更新
Java 基础概念和常识内容
JVM vs JDK vs JRE
Java 虚拟机(Java Virtual Machine, JVM)是运行 Java 字节码的虚拟机。JVM 有针对不同系统的特定实现(Windows,Linux,macOS),目的是使用相同的字节码,它们都会给出相同的结果。字节码和不同系统的 JVM 实现是 Java 语言 一次编译,随处可以运行 的关键所在。
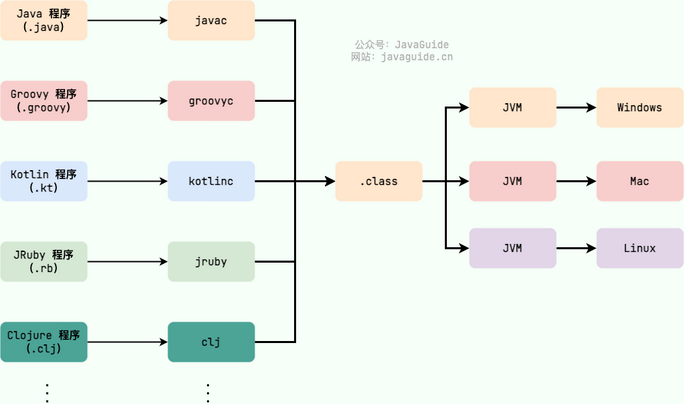
JVM 并不是只有一种!只要满足 JVM 规范,每个公司、组织或者个人都可以开发自己的专属 JVM。 也就是说我们平时接触到的 HotSpot VM 仅仅是是 JVM 规范的一种实现而已。
维基百科上就有常见 JVM 的对比:Comparison of Java virtual machines ,感兴趣的可以去看看。并且,你可以在 Java SE Specifications 上找到各个版本的 JDK 对应的 JVM 规范。
JDK(Java Development Kit)是一个功能齐全的 Java 开发工具包,供开发者使用,用于创建和编译 Java 程序。它包含了 JRE(Java Runtime Environment),以及编译器 javac 和其他工具,如 javadoc(文档生成器)、jdb(调试器)、jconsole(监控工具)、javap(反编译工具)等。
JRE 是运行已编译 Java 程序所需的环境,主要包含以下两个部分:
- JVM : 也就是我们上面提到的 Java 虚拟机。
- Java 基础类库(Class Library):一组标准的类库,提供常用的功能和 API(如 I/O 操作、网络通信、数据结构等)。
简单来说,JRE 只包含运行 Java 程序所需的环境和类库,而 JDK 不仅包含 JRE,还包括用于开发和调试 Java 程序的工具。
不过,从 JDK 9 开始,就不需要区分 JDK 和 JRE 的关系了,取而代之的是模块系统(JDK 被重新组织成 94 个模块)+ jlink 工具 (随 Java 9 一起发布的新命令行工具,用于生成自定义 Java 运行时映像,该映像仅包含给定应用程序所需的模块) 。并且,从 JDK 11 开始,Oracle 不再提供单独的 JRE 下载。
模块化系统被引入之后,JDK 被重新组织成 94 个模块,Java 应用可以通过新增的 jlink 工具,创建出只包含所依赖的 JDK 模块的自定义运行时镜像,这样可以极大的减少 Java 运行时环境的大小。这对于满足现代应用程序架构的需求,如虚拟化、容器化、微服务和云原生开发,是非常重要的。
简要介绍一下 Java 和 C++ 的区别?
- C++是平台相关的,java是平台无关的。原因就是因为 JVM 带给了 Java 一次编译到处运行的跨平台能力
- C++对所有的数字类型有标准范围限制,但是字节长度是跟具体实现相关的,相同类型,在不同操作系统长度可能不一样;java在所有平台上对所有的基本类型都有标准的范围限制和字节长度。
- C++允许直接调用本地的系统库;Java要通过JNI
- C++支持指针,引用,传值调用等内容,Java只有值传递
- C++需要显式的的内存管理,但是有第三方框架提供垃圾搜集的支持,支持析构函数。Java是自动垃圾收集的,没有析构函数的概念。
- C++支持多继承,包括虚拟继承;Java只允许单继承,需要多继承的场景要使用接口。
什么是字节码?采用字节码的好处是什么?
在 Java 中,JVM 可以理解的代码就叫做字节码,也就是扩展名为
.class 的文件,它不面向任何特定的处理器,只面向虚拟机。
Java 语言通过字节码的方式,在一定程度上解决了传统解释型语言执行效率低的问题,同时又保留了解释型语言可移植的特点。
由于字节码并不针对一种特定的机器,因此,Java 程序无须重新编译便可在多种不同操作系统的计算机上运行
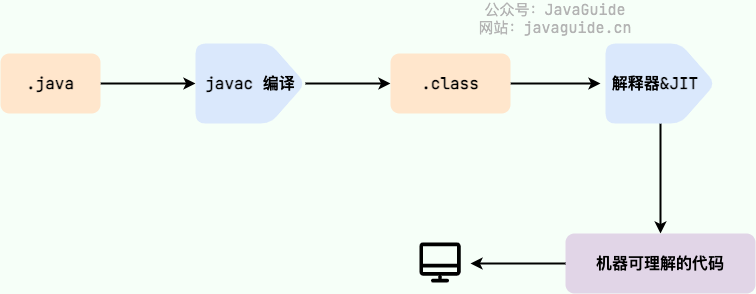
.class->机器码 这一步中,JVM
类加载器首先加载字节码文件,然后就通过解释器逐行解释执行,这种方式的执行速度会相对比较慢。而有些方法和代码块是经常需要被调用的,所以引入了
JIT,JIT 属于运行时编译。当 JIT
编译器完成第一次编译后,其会将字节码对应的机器码保存下来,下次可以直接使用。
这也解释了我们为什么经常会说 Java 是编译与解释共存的语言 。
HotSpot 采用了惰性评估(Lazy Evaluation)的做法,根据二八定律,消耗大部分系统资源的只有那一小部分的代码(热点代码),而这也就是 JIT 所需要编译的部分。JVM 会根据代码每次被执行的情况收集信息并相应地做出一些优化,因此执行的次数越多,它的速度就越快
什么是AOT?有什么好处?为什么不全部使用 AOT 呢?
JDK 9 引入了一种新的编译模式 AOT(Ahead of Time Compilation) 。和 JIT 不同的是,这种编译模式会在程序被执行前就将其编译成机器码,属于静态编译,像 Rust,GO,C++ 等语言就是静态编译,所以都调侃 Rust 编译的特别慢
AOT 避免了 JIT 预热等各方面的开销,可以提高 Java 程序的启动速度,避免预热时间长
并且,AOT 还能减少内存占用和增强 Java 程序的安全性,因为 AOT 编译后的代码不容易被反编译和修改,特别适合云原生场景。
| 对比维度 | JIT(即时编译) | AOT(提前编译) |
|---|---|---|
| 编译时机 | 运行时编译 | 运行前编译 |
| 启动速度 | 较慢(需要预热) | 快(无需预热) |
| 峰值性能 | 更高(运行时优化) | 较低(缺少运行时信息) |
| 内存占用 | 较高 | 较低 |
| 打包体积 | 较小 | 较大(包含机器码) |
| 动态特性支持 | 完全支持 | 受限(反射、动态代理等) |
| 适用场景 | 长时间运行的服务 | 云原生、Serverless、CLI 工具 |
可以看出,AOT 的主要优势在于启动时间、内存占用和打包体积。JIT 的主要优势在于具备更高的极限处理能力,可以降低请求的最大延迟。
既然 AOT 这么多优点,那为什么不全部使用这种编译方式呢?
- 首先,AOT 编译无法支持 Java 的一些动态特性,如反射、动态代理、动态加载、JNI(Java Native Interface)等。我们都知道,开发离不开这些动态特性。
- 而且,AOT 编译这种静态编译,确实比较慢
为什么Java解释和编译共存?编译型语言和解释型语言的区别是?
首先在Java经过编译之后生成字节码文件,接下来进入JVM中,就有两个步骤编译和解释。
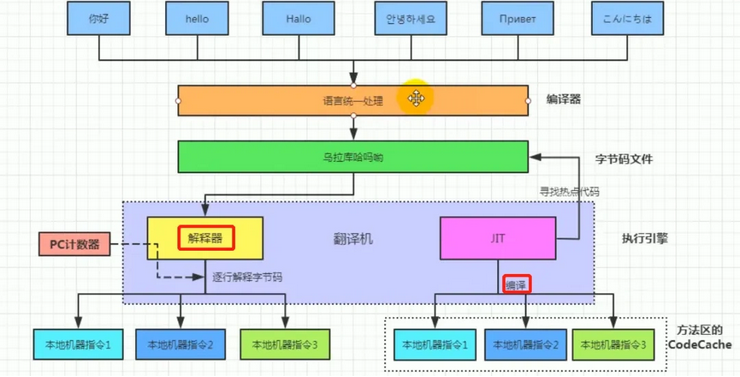
编译型语言和解释型语言的区别在于:
- 编译型语言:在程序执行之前,整个源代码会被编译成机器码或者字节码,生成可执行文件。执行时直接运行编译后的代码,速度快,但跨平台性较差。
- 解释型语言:在程序执行时,逐行解释执行源代码,不生成独立的可执行文件。通常由解释器动态解释并执行代码,跨平台性好,但执行速度相对较慢。
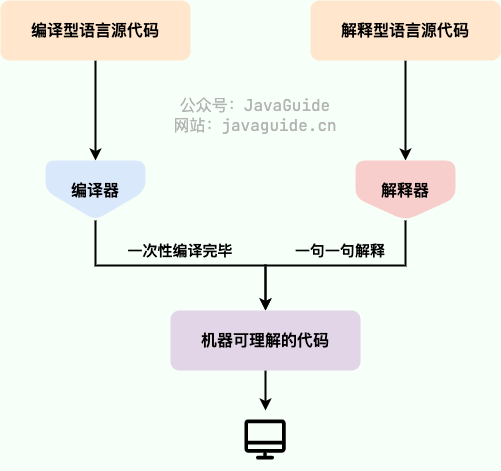
为了改善解释语言的效率而发展出的即时编译技术 JIT,已经缩小了这两种语言间的差距。这种技术混合了编译语言与解释型语言的优点,它像编译语言一样,先把程序源代码编译成字节码。到执行期时,再将字节码直译,之后执行。Java与 LLVM 是这种技术的代表产物。
为什么说 Java 语言 编译与解释并存?
这是因为 Java
语言既具有编译型语言的特征,也具有解释型语言的特征。因为 Java
程序要经过先编译,后解释两个步骤,由 Java
编写的程序需要先经过编译步骤,生成字节码(.class
文件),这种字节码必须要经过 JVM 的再次翻译才能执行
然而,跨平台的是Java程序,不是JVM。JVM是用C/C++开发的,是编译后的机器码,不能跨平台,不同平台下需要安装不同版本的JVM。
Java 到底是值传递还是引用传递?值传递和引用传递的区别?
在 Java 中,参数传递只有 值传递 一种方式,不存在真正的 引用传递。但很多人会混淆这两个概念,核心区别在于传递的是 “值的副本” 还是 “引用的副本”。
无论是基本类型还是对象,传递的都是“值”的副本,只不过对于对象来说,这个“值”是引用(内存地址)的副本。
对于值传递。传递的是实际值的副本,适用于基本数据类型,修改方法内的参数副本,不会影响原变量的值。
1
2
3
4
5
6
7
8
public static void main(String[] args) {
int a = 10;
change(a);
System.out.println(a); // 输出 10
}
static void change(int x) {
x = 20; // 修改的是副本
}a的值(10)被复制给x,方法内修改x不影响原变量。这是典型的值传递。
对于对象类型,也就是引用类型,传递的是对象引用的副本,而非对象本身
两个引用(原引用和副本)指向同一个对象,因此通过副本修改对象内部数据,会影响原对象。但如果修改副本的指向,如重新赋值,不会影响原引用的指向。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public static void main(String[] args) {
List<String> list = new ArrayList<>();
list.add("A");
modify(list);
System.out.println(list); // [A, B] —— 内容变了!
reassign(list);
System.out.println(list); // 仍是 [A, B] —— 引用没变!
}
static void modify(List<String> param) {
param.add("B"); // 修改对象内容
}
static void reassign(List<String> param) {
param = new ArrayList<>(); // 重新赋值引用
param.add("X");
}modify方法能改内容,是因为在内存中list和param都指向同一个堆对象,通过副本引用仍可操作原对象。reassign方法不能改变list的指向,因为param = ...只是让局部变量param指向了新对象,不影响原调用方 list 的引用。所以说,这是值传递,传的是地址的副本,不是地址本身
所以说,Java 中所有参数传递都是值传递
- 基本类型传递 “值的副本”,修改副本不影响原值
- 引用类型传递 “引用的副本”,通过副本可以修改对象的内容,改变副本的指向不会影响原引用的指向
i = i++
之后 i 为什么还是原来的值?请说明
++/-- 的求值顺序、&& 与
& 的区别,以及几类常见运算符的坑。
i++后缀自增的规则是:先取当前值作为整个表达式的值,也就是,返回旧值,再对
i 自增。而++i前缀自增是先自增再取值
&& 与 & 的区别如下
| 运算符 | 名称 | 操作数类型 | 短路 | 用途 |
|---|---|---|---|---|
&& |
短路逻辑与 | boolean | 是 | 逻辑判断 |
& |
逻辑与 / 按位与 | boolean / 整数 | 否 | 逻辑判断或位运算 |
|| |
短路逻辑或 | boolean | 是 | 逻辑判断 |
| |
逻辑或 / 按位或 | boolean / 整数 | 否 | 逻辑判断或位运算 |
绝大多数情况用
&&,避免不必要的计算和 NPE。而且
&& 优先级高于||
其他运算符
+的字符串拼接陷阱:+只要有一个操作数是 String,就变成拼接;否则是算术加法。char参与算术会转 int。整数除法与取模
1
2
3
4
int a = 5 / 2; // 2,不是 2.5(整数除法截断)
double d = 5 / 2; // 2.0!先算整数除法得 2,再转 double
double d2 = 5 / 2.0; // 2.5(有浮点数才走浮点除法)
int r = -7 % 3; // -1(Java 取模结果符号跟被除数一致)浮点数比较问题
float/double遵循 IEEE 754,存的是二进制近似值,==比较的是两个值的精确位模式,所以绝大多数十进制小数(0.1、0.2…)都无法用==正确比较:1
2System.out.println(0.1 + 0.2 == 0.3); // false
System.out.println(0.1f + 0.2f == 0.3f); // false正确做法
- 容差比较:
Math.abs(a - b) < eps。eps要按数值量级选择,不能用一个固定的绝对值去比较很大的数。 - 按位/严格比较:
Double.compare(a, b) == 0或Double.equals(),用来判断“是否完全同一个浮点值”。 - 精确十进制运算(金额、税额):用
BigDecimal,比较用compareTo(忽略 scale),不要用equals(1.0和1.00的 scale 不同,equals返回false)。
两个问题
NaN:NaN与任何值(包括它自己)用==比较都是false,判断必须用Double.isNaN(x)/Float.isNaN(x)。0.0 == -0.0为true,但Double.compare(0.0, -0.0)不为0;而Double.equals对NaN又认为相等,和==语义不同。float与double混用会先提升为 double 再比较,1.1f和1.1d是两个不同的近似值,f == d为false。
一句话:浮点数的
==只能用来判断“同一个值”,不能用来判断“数学上相等”;金额一律BigDecimal。- 容差比较:
数据类型
Java 的 8 种基本类型是什么?它们之间怎么转换,哪些转换会丢精度?long和int可以互转吗 ?类型互转可能产生什么问题?强制类型转换什么时候丢精度、什么时候溢出?
| 类型 | 字节 | 位数 | 取值范围 | 默认值 |
|---|---|---|---|---|
| byte | 1 | 8 | -128 ~ 127 | 0 |
| short | 2 | 16 | -32768 ~ 32767 | 0 |
| int | 4 | 32 | -2^31 ~ 2^31-1 | 0 |
| long | 8 | 64 | -2^63 ~ 2^63-1 | 0L |
| float | 4 | 32 | ±3.4e-38 ~ ±3.4e38(约 7 位有效数字) | 0.0f |
| double | 8 | 64 | ±1.7e-308 ~ ±1.7e308(约 15 位有效数字) | 0.0d |
| char | 2 | 16 | 0 ~ 65535(无符号) | ‘000’ |
| boolean | 1(JVM 依赖) | - | true / false | false |
基本数据类型转换
自动转换:小范围 → 大范围,编译器自动完成,不丢信息。
强制转换:大范围 → 小范围,必须显式
(type)强转。丢失方式:
- 整数之间,截断低位,也就是溢出,保留低 N 位二进制
- 浮点 → 整数:向零取整 + 溢出
- 浮点之间:double → float,丢精度
可以的,Java
中的long和int可以相互转换。由于long类型的范围比int类型大,因此将int转换为long是安全的,而将long转换为int可能会导致数据丢失或溢出
将int转换为long可以通过直接赋值或自动类型转换来实现。但是将long转换为int需要使用强制类型转换
1 | long longValue = 100L; |
在将long转换为int时,如果longValue的值超出了int类型的范围,转换结果将是截断后的低位部分。
float f = 1.0;
为什么编译不过,而 long x = 1; 可以?为什么
long 装得下 int,而 float
装不下所有 int?
1.0 字面量默认是
double,double → float是窄化转换,Java
不允许自动完成,必须显式强转或加 f/F 后缀
而 long x = 1;,1 是
int 字面量,int → long
是宽化转换,自动完成,安全
范围和精度是两个不同的维度:
- 范围(range):能表示的最大/最小值。
- 精度(precision):能精确表示的有效数字位数。
long 装 int,long 的整数范围完全包含 int,所以任何 int 都能精确装进 long
float 虽然也是 32
位,但它是浮点格式,只有 24
位用于有效数字,而 int 有 31 位,所以 int 中大于 2^24 的数转
float 会丢低位。但是,int → float 在 Java
里是允许自动转换的,编译器不报错,但运行时可能丢精度。
也就是说,范围看字节数,精度看有效位;小转大自动补,大转小强转截,浮点转整向零取。
数据类型转换方式你知道哪些?简单说一下?
隐式转换:当目标类型的范围大于源类型时,Java会自动将源类型转换为目标类型,不需要显式的类型转换。例如,将
int转换为long、将float转换为double等。显式转换:当目标类型的范围小于源类型时,需要使用强制类型转换将源类型转换为目标类型。这可能导致数据丢失或溢出。例如,将
long转换为int、将double转换为int等。这种触发了一般是截断,低位截断或者丢失小数这种字符串转换:Java 提供了将字符串表示的数据转换为其他类型数据的方法。例如,将字符串转换为整型
int,可以使用Integer.parseInt()方法;将字符串转换为浮点型double,可以使用Double.parseDouble()方法等数值之间的转换:Java 提供了一些数值类型之间的转换方法,如将整型转换为字符型、将字符型转换为整型等。这些转换方式可以通过类型的包装类来实现,例如
Character类、Integer类等提供了相应的转换方法对象之间的向上向下转型:向上转型是自动进行的,而且是安全的。但是向下转型需要手动进行,并且存在风险。而且如果父类对象实际上并不是目标子类的实例,转换后就会抛出异常。解决方式是需要使用
instanceof检查1
2
3
4
5
6
7
8
9
10
11
12
13class Animal {}
class Dog extends Animal {}
Dog dog = new Dog();
Animal animal = dog; // 自动向上转型
// 向下转型失败
Animal animal = new Animal();
Dog dog = (Dog) animal; // 运行时抛出ClassCastException
if (animal instanceof Dog) {
Dog dog = (Dog) animal; // 只有确认animal是Dog的实例时才进行转型
}
基本类型和包装类型的区别了解吗?能不能讲一下包装类型的缓存机制?
用途不同:除了定义一些常量和局部变量之外,在其他地方比如方法参数、对象属性中很少会使用基本类型来定义变量,因为包装数据类型能直接当作对象处理,并且,包装类型可用于泛型,而基本类型不可以。
存储方式:基本数据类型的局部变量存放在 Java 虚拟机栈中的局部变量表中,基本数据类型的成员变量(未被
static修饰 )存放在 Java 虚拟机的堆中。包装类型属于对象类型,我们知道几乎所有对象实例都存在于堆中基本数据类型的存储位置取决于它们的作用域和声明方式。如果它们是局部变量,那么它们会存放在栈中;如果它们是成员变量,那么它们会存放在堆/方法区/元空间中。
占用空间:相比于包装类型(对象类型), 基本数据类型占用的空间往往小很多。
默认值:成员变量包装类型不赋值就是
null,而基本类型有对应的默认零值。比较方式:对于基本数据类型来说,
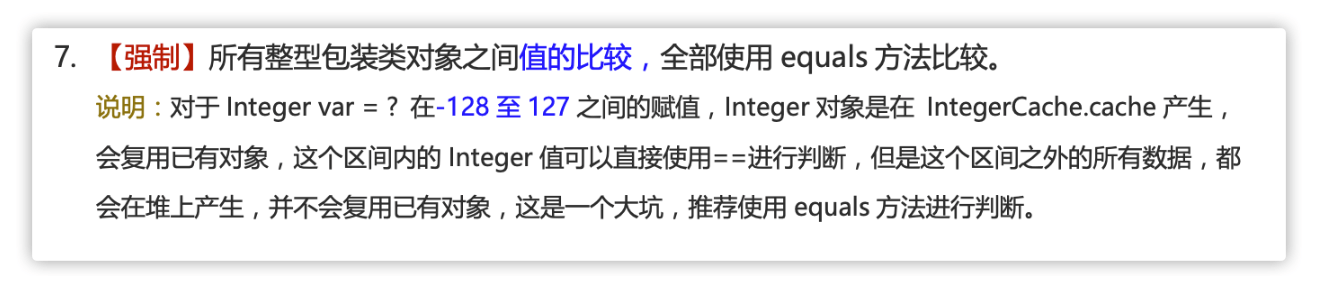
==比较的是值。对于包装数据类型来说,==比较的是对象的内存地址。所有整型包装类对象之间值的比较,全部使用equals()方法。
为什么说 几乎所有 对象实例都存在于堆中呢? 而非 所有?
首先,在没有 JIT 优化的情况下,Java 中所有新建的对象(
new XXX())都会被分配在堆内存中,JIT 编译器会分析对象的作用域,如果对象没有逃逸,JIT 会把对象拆解成基本类型,直接在栈上分配这些基本类型,而非在堆上分配整个对象。所以说,少数不在堆中的对象是这么来的,不是所有对象都在堆中分配实例
而 Java 基本数据类型的包装类型的大部分都用到了缓存机制来提升性能。
Byte,Short,Integer,Long
这 4 种包装类默认创建了数值 [-128,127]
的相应类型的缓存数据,Character 创建了数值在
[0,127] 范围的缓存数据,Boolean 直接返回
TRUE or FALSE。两种浮点数类型的包装类
Float,Double 并没有实现缓存机制。
如果超出对应范围仍然会去创建新的对象吗?
- 如果没超出就直接使用缓存的对象,缓存的范围区间的大小只是在性能和资源之间的权衡。
1 | Integer i1 = 40; |
Integer i1=40
这一行代码会发生装箱,也就是说这行代码等价于
Integer i1=Integer.valueOf(40) 。因此,i1
直接使用的是缓存中的对象。而Integer i2 = new Integer(40)
会直接创建新的对象。
所以说,所有整型包装类对象之间值的比较,全部使用 equals 方法比较。
装箱和拆箱是什么?什么时候会发生自动拆装箱?
Java 中 8 种原始类型,如
int、double、boolean
等,特点是存储值本身,不具备对象特性
- 装箱:将基本类型用它们对应的引用类型包装起来;
- 拆箱:将包装类型转换为基本数据类型;
装箱其实就是调用了
包装类的valueOf()方法,拆箱其实就是调用了
xxxValue()方法。
自动拆装箱是 Java 编译器的 “语法糖”,以下五种常见场景会触发
赋值场景:
以直接赋值的形式进行了基本类型和包装类的互转
1
2
3
4// 自动装箱:int → Integer
Integer num1 = 100;
// 自动拆箱:Integer → int
int num2 = num1;方法参数传递:实参类型与形参类型不匹配时
当方法的形参是包装类,你传入基本类型值;或形参是基本类型,你传入包装类对象时,会触发自动拆装箱。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21public class BoxUnbox {
// 形参是包装类Integer
public static void printInteger(Integer num) {
System.out.println(num);
}
// 形参是基本类型int
public static void printInt(int num) {
System.out.println(num);
}
public static void main(String[] args) {
int basic = 50;
Integer wrapper = 60;
// 传入基本类型int,自动装箱为Integer
printInteger(basic);
// 传入包装类Integer,自动拆箱为int
printInt(wrapper);
}
}方法返回值:返回值类型与实际返回值类型不匹配时
当方法声明的返回值是包装类,你返回基本类型值;或返回值是基本类型,你返回包装类对象时,会触发自动拆装箱。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18public class BoxUnbox {
// 返回值是包装类Integer
public static Integer getInteger() {
// 返回基本类型int,自动装箱为Integer
return 70;
}
// 返回值是基本类型int
public static int getInt() {
// 返回包装类Integer,自动拆箱为int
return new Integer(80);
}
public static void main(String[] args) {
System.out.println(getInteger()); // 输出 70
System.out.println(getInt()); // 输出 80
}
}运算场景:包装类参与算术运算时
包装类本身不能直接参与
+、-、*、/等算术运算,编译器会先自动拆箱为基本类型,再进行运算;如果运算结果赋值给包装类,还会触发自动装箱。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16public class BoxUnbox {
public static void main(String[] args) {
Integer a = 10;
Integer b = 20;
// 第一步:a和b自动拆箱为int(10、20)
// 第二步:计算 10+20=30(int类型)
// 第三步:结果30自动装箱为Integer,赋给c
Integer c = a + b;
System.out.println(c); // 输出 30
// 包装类与基本类型运算,同样触发拆箱
int d = a + 5; // a拆箱为int,计算10+5=15,赋给d
System.out.println(d); // 输出 15
}
}集合操作:泛型集合存储 / 获取基本类型时
Java 集合只能存储对象,不能直接存储基本类型。当你往泛型集合中添加基本类型值时,会自动装箱;从集合中取出元素赋值给基本类型变量时,会自动拆箱。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import java.util.ArrayList;
import java.util.List;
public class BoxUnbox {
public static void main(String[] args) {
// 泛型指定为Integer,只能存Integer对象
List<Integer> list = new ArrayList<>();
// 自动装箱:int(10) → Integer,存入集合
list.add(10);
list.add(20);
// 自动拆箱:从集合取出Integer对象,拆箱为int
int first = list.get(0);
System.out.println(first); // 输出 10
}
}
如果频繁拆装箱的话,也会严重影响系统的性能。我们应该尽量避免不必要的拆装箱操作。
自动拆装箱需要注意如下内容:
NPE 风险:如果包装类对象为
null,自动拆箱时会抛出空指针异常1
2Integer num = null;
int basic = num; // 运行时抛出 NullPointerException缓存池影响:
Integer、Byte、Short等包装类有缓存池,自动装箱时会优先使用缓存对象
面向对象
怎么理解面向对象?简单说一下面向对象的三大特征?多态的底层实现原理是什么?为什么字段和静态方法没有多态?
面向对象是一种编程范式,它将现实世界中的事物抽象为对象,对象具有属性(字段)和行为(方法)。面向对象编程的设计思想是以对象为中心,通过对象之间的交互来完成程序的功能,具有灵活性和可扩展性,通过封装和继承可以更好地应对需求变化。
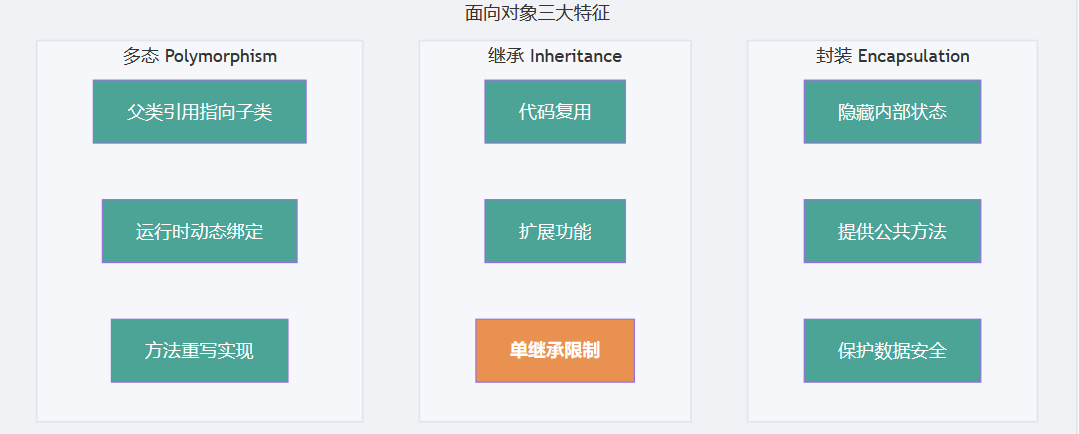
Java面向对象的三大特性包括:封装、继承、多态:
封装
隐藏内部,暴露接口,保护数据。
封装是指把一个对象的状态信息,也就是属性,隐藏在对象内部,不允许外部对象直接访问对象的内部信息,但是可以提供一些可以被外界访问的方法来操作属性。
封装的核心思想就是对内把属性私有化,对外提供公共访问方法,隐藏内部实现细节。
就好像我们看不到挂在墙上的空调的内部的零件信息(也就是属性),但是可以通过遥控器(方法)来控制空调。
1 | public class Student { |
继承
继承是使用已存在的类的定义作为基础建立新类的技术,新类的定义可以增加新的数据或新的功能,也可以用父类的功能,但不能选择性地继承父类。
通过使用继承,可以快速地创建新的类,可以提高代码的重用性。而且通过继承可以建立类与类之间的层次关系,使得结构更加清晰。
- 子类拥有父类对象所有的属性和方法(包括私有属性和私有方法),但是父类中的私有属性和方法子类是无法访问,只是拥有。
- 子类可以新增自己属性和方法,即子类可以对父类进行扩展。
- 子类可以用自己的方式 重写(override)父类方法。
多态
多态,顾名思义,表示一个对象具有多种的状态,具体表现为父类的引用指向子类的实例。
父类引用指向子类,同一方法表现不同行为。一般实现方式是编译时多态(重载)和运行时多态(重写)
多态特点:
- 对象类型和引用类型之间具有继承(类)/实现(接口)的关系;
- 引用类型变量发出的方法调用的到底是哪个类中的方法,必须在程序运行期间才能确定;
- 多态不能调用“只在子类存在但在父类不存在”的方法;
- 如果子类重写了父类的方法,真正执行的是子类重写的方法,如果子类没有重写父类的方法,执行的是父类的方法。
为什么字段和静态方法没有多态?
- 多态的本质:运行时根据对象的实际类型动态绑定方法调用。而字段和静态方法在编译期就已经绑定了,不参与运行时的动态分派
构造器里调用可重写方法会发生什么?
- 父类构造器先于子类字段初始化执行,此时子类字段还是默认值;构造器里调用被重写的方法会分派到子类版本,读到 null/0。
面向对象的设计原则你知道有哪些吗
面向对象编程中的六大原则:
- 单一职责原则(SRP):一个类应该只有一个引起它变化的原因,即一个类应该只负责一项职责。例子:考虑一个员工类,它应该只负责管理员工信息,而不应负责其他无关工作。
- 开闭原则(OCP):软件实体应该对扩展开放,对修改封闭。例子:通过制定接口来实现这一原则,比如定义一个图形类,然后让不同类型的图形继承这个类,而不需要修改图形类本身。
- 里氏替换原则(LSP):子类对象应该能够替换掉所有父类对象。例子:一个正方形是一个矩形,但如果修改一个矩形的高度和宽度时,正方形的行为应该如何改变就是一个违反里氏替换原则的例子。
- 接口隔离原则(ISP):客户端不应该依赖那些它不需要的接口,即接口应该小而专。例子:通过接口抽象层来实现底层和高层模块之间的解耦,比如使用依赖注入。
- 依赖倒置原则(DIP):高层模块不应该依赖低层模块,二者都应该依赖于抽象;抽象不应该依赖于细节,细节应该依赖于抽象。例子:如果一个公司类包含部门类,应该考虑使用合成/聚合关系,而不是将公司类继承自部门类。
- 最少知识原则 (Law of Demeter):一个对象应当对其他对象有最少的了解,只与其直接的朋友交互。
深拷贝和浅拷贝区别了解吗?什么是引用拷贝?
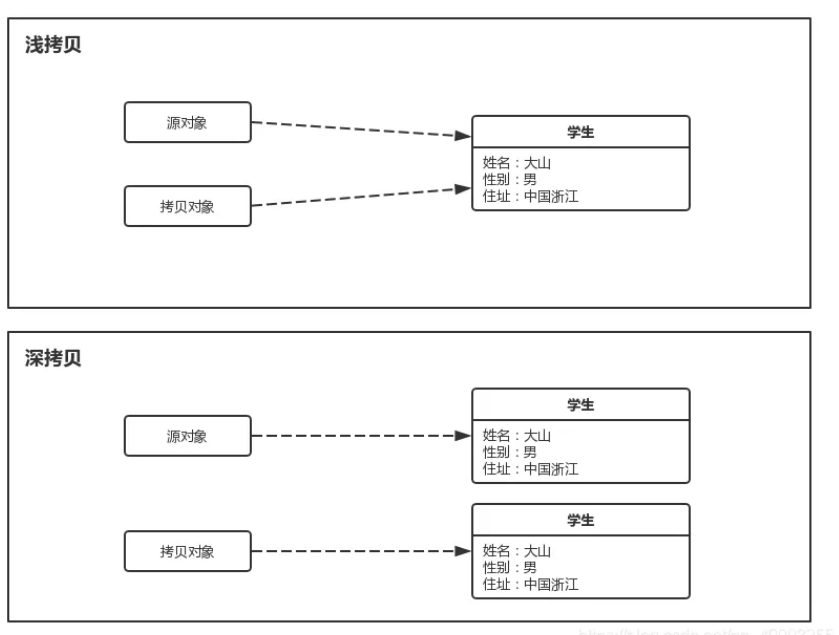
浅拷贝是复制对象本身,但是对象内部的引用类型成员变量仍指向原地址,仅基本类型的成员变量是独立的
深拷贝完全复制对象及内部所有引用类型成员变量,也就是递归拷贝,而不是共享引用。新旧对象完全独立,无任何关联。
换句话说,深拷贝会递归复制对象内部所有引用类型的字段,生成一个全新的对象以及其内部的所有对象
引用拷贝是仅复制对象的引用,新旧引用指向同一个对象,本质是 “别名”。
浅拷贝的实现方式可以通过 Object 的
clone()方法,它默认是浅拷贝深拷贝的实现方式
实现 Cloneable 接口并重写 clone() 方法
这种方法要求对象及其所有引用类型字段都实现 Cloneable 接口,并且重写 clone() 方法。在 clone() 方法中,通过递归克隆引用类型字段来实现深拷贝。
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
private String field1;
private NestedClass nestedObject;
protected Object clone() throws CloneNotSupportedException {
MyClass cloned = (MyClass) super.clone();
cloned.nestedObject = (NestedClass) nestedObject.clone(); // 深拷贝内部的引用对象
return cloned;
}
}
class NestedClass implements Cloneable {
private int nestedField;
protected Object clone() throws CloneNotSupportedException {
return super.clone();
}
}使用序列化和反序列化
通过将对象序列化为字节流,再从字节流反序列化为对象来实现深拷贝。要求对象及其所有引用类型字段都实现 Serializable 接口。
手动递归复制
成员变量与局部变量的区别是什么?那么静态变量呢?为什么成员变量有默认值,局部变量没有?
- 所属不同:从语法形式上看,成员变量是属于类的,而局部变量是出现在代码块,方法中的被定义的变量或是方法的参数;
- 语法层次不同:成员变量可以被
public,private,static等修饰符所修饰,而局部变量不能被访问控制修饰符及static所修饰;但是,成员变量和局部变量都能被final所修饰。 - 存储方式不同:从变量在内存中的存储方式来看,如果成员变量是使用
static修饰的,那么这个成员变量是属于类的,如果没有使用static修饰,这个成员变量是属于实例的。局部变量就属于它所在的那个方法或者代码块中。而对象存在于堆内存,局部变量则存在于栈内存中。 - 生存时间:从变量的生存时间上来看,成员变量是对象的一部分,它随着对象的创建而存在,而局部变量随着方法的调用而自动生成,随着方法的调用结束而消亡。
- 默认值:从变量是否有默认值来看,成员变量如果没有被赋初始值,则会自动以类型的默认值而赋值(这里就是JVM提到的零值,而一种情况例外:被
final修饰的成员变量也必须显式地赋值),而局部变量则不会自动赋值,需要手动赋初值。
为什么成员变量有默认值,局部变量没有?
核心原因是为了保证对象状态的安全和可预测性。
成员变量和局部变量在这个规则上不同,主要是因为它们的生命周期不一样,导致了编译器对它们的“控制力”也不同。
- 局部变量只活在一个方法里,编译器能清楚地看到它是否在使用前被赋值,所以编译器会强制你必须手动赋值,否则就报错。
- 成员变量是跟着对象走的,它的值可能在构造函数里赋,也可能在后面的某个
setter方法里赋。编译器在编译时无法预测它到底什么时候会被赋值。并且,如果一个变量没有被初始化,它的内存里存放的就是“垃圾值”——之前那块内存遗留下的任意数据。如果程序读取并使用了这个垃圾值,就会产生完全不可预测的结果,比如一个数字变成了随机数,一个对象引用变成了非法地址,这会直接导致程序崩溃或出现诡异的 bug。
为了避免你拿到一个含有“垃圾值”的危险对象,Java干脆为所有成员变量提供了一个安全的默认值(如 null 或 0),作为一种安全兜底机制。
静态变量就是用 static 关键字修饰的变量。代表属于类,没有当前对象
static可以修饰成员变量,不能修饰局部变量。
因为 static
的本质修饰的是类级别的成员,属于整个类所有,存储在方法区,生命周期和类一致。而局部变量属于方法级别的临时变量,存储在栈帧中,生命周期和方法调用一致,仅在方法内部可见。
无论一个类创建了多少个对象,静态变量只会在类创建的时候被分配一次内存,它们都共享同一份静态变量。
静态方法和实例方法有何不同?静态方法为什么不能调用非静态成员?同名变量遮蔽时怎么访问?
在方法调用的方式上
- 在外部调用静态方法时,可以使用
类名.方法名的方式,也可以使用对象.方法名的方式,而实例方法只有后面这种方式。也就是说,调用静态方法可以无需创建对象,因为静态方法属于类。而且不能用 this/super,也不能直接访问实例成员 - 不过,需要注意的是一般不建议使用
对象.方法名的方式来调用静态方法。这种方式非常容易造成混淆,因味我们认为静态方法不属于类的某个对象而是属于这个类。
1 | public class Person { |
访问类成员是否存在限制
静态方法在访问本类的成员时,只允许访问静态类成员,即静态成员变量和静态方法,不允许访问实例的成员,也就是实例变量和实例方法,而实例方法不存在这个限制。
而 静态方法为什么不能调用非静态成员,这个需要结合 JVM 的相关知识,主要原因如下:
- 静态方法是属于类的,在类加载的时候就会分配内存,可以通过类名直接访问。而非静态成员属于实例对象,只有在对象实例化之后才存在,需要通过类的实例对象去访问。
- 在类的非静态成员不存在的时候静态方法就已经存在了,此时调用在内存中还不存在的非静态成员,属于非法操作
同名变量遮蔽的时候,用 this.字段
访问本类成员变量,类名.静态字段
访问静态变量;局部变量与成员同名时直接写名字就是局部变量
抽象类和普通类区别?抽象类和接口的区别?
首先抽象类和普通类区别很明显:
- 抽象类是用
abstract修饰的类,某种意义上它不完整,只是为子类提供通用的模板,不可直接实例化,可包含抽象方法(无实现)和具体方法(有实现)。而且子类必须实现抽象类中所有抽象方法,除非子类也是抽象类 - 普通类就是一个完整的类,可以直接被 new 实例化,包含具体的属性和方法实现,而且只能包含具体方法,普通类的子类无强制实现要求,按需重写方法
然后是抽象类和接口
- 抽象类的继承关系是
is-a,侧重代码复用,包含子类的通用属性和方法。而且抽象类是单继承,成员方法是
public abstract抽象方法。抽象类中成员变量默认default,可在子类中被重新定义,也可被重新赋值。而且抽象类可以有构造器,这些构造器在子类实例化时会被调用,以便进行必要的初始化工作。 - 接口则是侧重
has-a,侧重子类的方法规范,强调有什么,子类可以自己实现
怎么做。接口是多实现,接口中方法默认
public abstract,JDK8 后可以添加static和default方法。接口成员变量默认为public static final,必须赋初值,不能被修改。接口没有自己的实例,因此不能包含构造函数。
简单说一下重载和重写的区别?重载和重写的判定条件、绑定时机、各自限制是什么?返回值不同、参数不同分别算不算重载?@Override
注解有什么用?
重载发生在同一个类中,方法名必须相同(访问修饰符可以不同),只要参数列表不同就行(类型/个数/顺序),返回值也可以不同,这样就能够根据不同的传参来执行不同的逻辑处理,绑定时期是编译期,是编译时多态
重载方法名必须相同,参数类型、个数、顺序,方法返回值和访问修饰符什么的可以不同。这样能够根据调用的情况做出选择处理
如果多个方法(比如
StringBuilder的构造方法)有相同的名字、不同的参数, 便产生了重载编译器必须挑选出具体执行哪个方法,它通过用各个方法给出的参数类型与特定方法调用所使用的值类型进行匹配来挑选出相应的方法。 如果编译器找不到匹配的参数, 就会产生编译时错误
重载不只发生在同一个类中,父子类之间也可以构成重载(子类定义与父类同名但参数不同的方法)。
重写发生在继承关系中,子类重写父类的某个方法,方法名和参数都一样,返回值也必须相同或者为子类,要做出有别于父类的响应时,你就要重写父类方法进行自定义化来提供新的实现,绑定时期是运行期,是运行时多态
重写发生在运行期,是是子类对父类的允许访问的方法的实现过程进行重新编写。
方法名、参数列表必须相同,返回值类型相同或为父类返回值的子类型,抛出的受检异常不能比父类更宽(运行时异常不限),访问修饰符不能比父类更严格
如果父类方法访问修饰符为
private/final/static则子类就不能重写该方法。但是被
static修饰的方法能够被再次声明。也就是子类定义一个与父类静态方法签名完全相同的方法,只是 “隐藏” 了父类的静态方法,不满足多态,本质是两个独立的方法,因为上面说的就是父类静态方法属于父类,子类静态方法属于子类,这叫做,方法隐藏构造方法无法被重写
返回值不同、参数不同分别不算重载
Java 是一门静态多分派、动态单分派的语言:
- 静态多分派:重载的确定需要同时考虑方法调用者的静态类型和参数的静态类型
- 动态单分派:重写的确定在运行时仅取决于方法接收者的实际类型
@Override
注解让编译器检查”是否真的重写了父类方法”,方法名/参数写错时直接编译报错,而不是悄悄变成一个新方法。而且向读代码的人明确声明”这是重写,不是新方法”。
final、static、abstract
分别能修饰什么?哪些修饰符组合非法?四种访问权限怎么记?怎么划范围?外部类能用哪些修饰符?abstract
和 final 为什么不能同时修饰一个类?abstract
不能和谁一起用?
final为最终的,不可改变
| 修饰对象 | 含义 |
|---|---|
| 类 | 类不能被继承(如 String) |
| 方法 | 方法不能被子类重写(override) |
| 变量(成员变量/局部变量/参数) | 变量只能赋值一次,之后不可修改(常量语义) |
final不能修饰构造方法、不能修饰接口,因为接口本身隐含 abstract
static是静态的,属于类而非实例
| 修饰对象 | 含义 |
|---|---|
| 成员变量 | 类变量,所有实例共享一份 |
| 方法 | 类方法,通过类名调用,不能访问实例成员、不能用
this/super |
| 代码块 | 静态初始化块,类加载时执行一次 |
| 内部类 | 静态嵌套类(普通成员内部类不能是 static,但嵌套类可以) |
| 导入 | import static(静态导入,修饰的是 import 语句) |
static不能修饰:普通外部类、构造方法、局部变量(实际上局部变量不能加 static)。import 用于导入类或包,而 import static 用于导入类的静态成员,使其可直接使用而无需类名限定
abstract是抽象的,未实现的契约
| 修饰对象 | 含义 |
|---|---|
| 类 | 抽象类,不能实例化,可含抽象方法,必须被子类继承(或继续抽象) |
| 方法 | 抽象方法,只有声明没有方法体,必须在子类中实现 |
abstract不能修饰:变量、构造方法、静态方法、final 方法、private 方法。
语义冲突的组合非法。例如
abstract+final:final 类不能被继承,abstract 类必须被继承才能用,矛盾;final 方法不能被重写,abstract 方法必须被重写,矛盾abstract+private:private 方法子类不可见、无法重写,abstract 方法必须被重写,矛盾abstract+static:static 方法属于类、不参与多态,无法被重写- 接口中成员变量隐式
public static final,方法隐式public abstract,不能显式加冲突修饰符 final修饰构造方法:构造方法不能被继承或重写abstract修饰构造方法:构造方法必须有实现final+volatile:final 不可变,volatile 强调可见性和有序性,冲突
四种访问权限怎么记?怎么划范围?
| 修饰符 | 同类 | 同包 | 子类(不同包) | 任意 |
|---|---|---|---|---|
private |
✅ | ❌ | ❌ | ❌ |
| 默认(无修饰符,package-private) | ✅ | ✅ | ❌ | ❌ |
protected |
✅ | ✅ | ✅ | ❌ |
public |
✅ | ✅ | ✅ | ✅ |
- 范围从小到大:private < 默认 < protected < public
外部类(顶层类)只能用:public、默认(package-private)、abstract、final。
- 不能用
private/protected:顶层类无法被封装在另一个类里 - 不能用
static:顶层类本身就是类级别 - 内部类则可以加
private、protected、static、abstract、final等,因为它是成员。
枚举的本质和用法是什么?能继承吗?能有构造器、字段、方法吗?枚举单例为什么能防反射和反序列化?
从语法上看,枚举类就是enum
关键字声明的是一个类。受几条规则约束
- 不能继承其他类:所有枚举都隐式继承
java.lang.Enum,由于 Java 单继承限制,它不能再extends任何其他类。虽然不能继承类,但枚举可以implements多个接口 - 构造器必须私有:枚举完全可以拥有自己的成员变量、方法和构造器。但构造器必须是私有的(默认包级私有),不允许
public,因为你无法在外部new一个枚举实例。 - 常量即实例:每个枚举常量本质上都是该枚举类的一个
public static final实例,在类加载阶段由 JVM 保证只创建一次。
普通单例即使构造器私有,也能被反射或反序列化攻破。枚举则通过 JVM 的规则来避免。
- 构造器层面直接防止反射
- 防反序列化:普通对象反序列化会通过反射调用构造器创建新实例。但是枚举不一样,序列化时只写入枚举常量的
name,反序列化时通过Enum.valueOf(Class, name)按名字查找并返回 JVM 中已存在的那个唯一实例。整个过程中不会创建任何新对象,自然无法破坏单例。
JavaSE
语法
标识符和关键字的区别是什么?
标识符是程序中定义的名字,如类名、变量名、方法名,一般需遵循命名的约定规则,而且不能与关键字重名。标识符必须以字母、下划线或美元符号开头,后续可以包含数字,但不能与关键字重复。
而关键字是 Java 语言预定义、具有特殊意义的保留词,不能用作标识符,编译器会对其进行特殊处理。
关键字是 Java 中已被赋予特定语法含义并正在使用的保留字,如 class、public、if 等,编译器会对其进行特殊处理,绝对不能作为标识符使用。保留字是 Java 语言预留但目前未被使用的单词,它们可能在未来版本中被赋予特定含义,如 goto、const。虽然当前未被激活,但为避免未来冲突,也不允许作为标识符使用。
创建一个对象用什么运算符?对象实例与对象引用有何不同?对象的相等和引用相等的区别是什么?
new 创建对象实例
对象实例在堆内存中,对象引用指向对象实例,对象引用存放在栈内存中
- 一个对象引用可以指向 0 个或 1 个对象
- 一个对象可以有 n 个引用指向它
对象的相等一般比较的是内存中存放的内容是否相等。
引用相等一般比较的是他们指向的内存地址是否相等。
this 和 super 分别代表什么?super 和 this 关键字的调用规则你了解吗?为什么 super() 和 this() 必须放在构造方法第一行?this() 和 super() 能同时出现在一个构造方法中吗?
| 关键字 | 含义 | 使用场景 |
|---|---|---|
this |
当前对象的引用 | 区分成员变量与局部变量、调用本类其他构造方法、调用本类方法、返回当前对象 |
super |
当前对象的父类部分(父类引用) | 访问父类成员变量或方法、调用父类构造方法 |
this 是当前对象的引用,super
不是一个真正的对象引用,而是指向父类存储空间的一个标识,不能赋值给变量
this 的四种用法
1 | class Person { |
super 的三种用法:
1 | class Student extends Person { |
为什么 super() 和 this() 必须放在构造方法第一行?
Java 要求子类对象在初始化时,必须先完成父类部分的初始化,才能继续子类自己的初始化。
super()调用父类构造、this()调用本类其他构造,因此必须最先执行。而且super()先执行(父类构造完成)→ 再执行本类构造体剩余代码。所以父类构造器先于子类构造器执行,对象初始化是从父到子的。对于编译器,如果构造方法第一行没有显式写
super()或this(),编译器会自动插入super(),若父类没有无参构造方法,则编译报错。
this() 和 super() 能同时出现在一个构造方法中吗?
不能。 两者都要求位于第一行,物理上无法同时满足;且一个构造方法只能调用一次父类构造或本类其他构造
2
3
4
5
6
7
A() {
this(1);
super(); // 编译错误:super() 不在第一行;且 this() 和 super() 冲突
}
A(int x) {}
}
一些额外的内容
没有显式写 super() 时,父类的哪个构造方法会被调用?
- 如果构造方法第一行没有写
this()或super(),编译器会自动插入super();来调用父类无参构造。所以子类不写构造器时,默认先调父类无参构造。这也是为什么父类若只定义了有参构造,无无参构造,子类必须显式super(...)。构造方法链的执行顺序是怎样的?
2
3
4
5
class B extends A { B() { super(); System.out.println("B"); } }
class C extends B { C() { super(); System.out.println("C"); } }
new C(); // 输出:A → B → C
- 先父后子,从最顶层父类开始,逐层向下初始化。
this 和 super 能用于访问 static 成员吗?
- 可以是可以,但是不推荐,会有警告
最后,下面的代码输出什么?
2
3
4
5
6
7
8
9
10
11
12
13
14
A() { System.out.println("A()"); }
A(int x) { System.out.println("A(int)"); }
}
class B extends A {
B() {
System.out.println("B()");
}
B(int x) {
this();
System.out.println("B(int)");
}
}
new B(5);输出:
2
3
B()
B(int)解析:
B(int)→this()调B()→ 编译器在B()首行插入super()→ 输出A()→ 输出B()→ 回到B(int)输出B(int)。
子类会继承父类的构造器吗?
- 子类默认继承父类的属性和方法,但不会继承父类的构造器,子类在创建的时候会调用自己的空构造器,并在空构造器会隐式调用super (),即父类的空构造器。
static 关键字的作用?static 代码块什么时候执行?解释一下 Java 中的静态内容?那么 final 呢?
static
意为静态的,关键字主要用于修饰类的成员,包括变量、方法、代码块,和内部类,使其变为静态的
那么,把他们变成静态的目的就是让他们脱离对象或者对象的实例,属于类本身的一部分
静态变量:所有对象共享同一个值,存储在方法区,不影响GC但是注意泄露;无需创建对象就能直接访问
类名.变量名,初始化的时候就创建静态方法:属于类本身,而非对象的实例,它不能访问非静态成员,直接通过
类名.方法名调用,工具类方法常用而且,静态方法不能重写,可被隐藏,子类同名静态方法不会覆盖父类
静态代码块:类加载的时候执行且只执行一次的代码块,一般是用于初始化,优先级高于构造方法
修饰内部类:静态内部类不依赖于外部类的实例,可以独立实例化,静态内部类不能直接访问外部类的非静态成员,而且静态内部类需要通过实例化外部类才能访问外部类的私有成员,静态内部类可以定义静态成员。
static
的代码库在类加载时执行(首次访问该类的任意成员时),仅执行一次,执行优先级:
1 | 静态代码块 > 构造代码块 > 构造方法 |
然后多个静态代码块按书写顺序从上到下执行
子类加载时,先执行父类的静态代码块,再执行子类的静态代码块;
接口中的变量默认是 public static final,那么再来说说
final,为什么很多情况下和 static 一起用
final 意为
最终的、不可变的,可修饰类、方法、变量,核心含义是常量,也就是限制修改
final修饰类:最终类,不能被继承,所有方法也都是默认是 finalfinal修饰方法:该方法不能被重写,这一般是防止子类篡改其逻辑final修饰变量:常量,不可重新赋值,但引用类型变量的内部属性可以修改必须在声明 / 构造方法 / 初始化块中赋值;
方法参数加
final:表示方法内不能修改 a 的值,多用于匿名内部类访问局部变量
不可变类就是对象一旦创建完成,状态就定死在那了,后面没法再改。Java 里最典型的就是 String,还有 Integer、Long、Boolean 这些基本类型的包装类。
那么,this 和 super 能在 static 环境中使用吗?
- 不能。
this代表当前对象,super代表当前对象的父类部分,二者都依赖对象实例。而 static 方法/语句块属于类级别,执行时不保证存在对象实例,所以不行 - 这也解释了为什么
main方法(static)中不能直接用this。
Java 有哪几种内部类?它们的创建方式,访问能力和内存关系是什么?匿名内部类为什么必须捕获 final/effectively final 变量?匿名内部类和 lambda 有什么区别?
| 类型 | 定义位置 | 能否 static |
访问外部类成员 | 外部类访问它 |
|---|---|---|---|---|
| 成员内部类 | 类成员位置 | 不能(非静态) | 可访问外部类所有成员(含 private),需外部类实例 | 需 outer.new Inner() |
| 静态嵌套类 | 类成员位置,加 static |
可以 | 只能访问外部类静态成员 | new Outer.Inner() |
| 局部内部类 | 方法/代码块内 | 不能 | 可访问外部类成员 + 所在方法final/effectively final 局部变量 | 仅在其作用域内 |
| 匿名内部类 | 表达式位置(new 接口/类(){}) |
不能 | 同局部内部类,且只能访问 final/effectively final 局部变量 | 无名字,一次性使用 |
- 成员内部类隐含持有外部类实例引用(
Outer.this),所以不能有静态成员(除常量),这也导致外部类对象无法被 GC(内存泄漏隐患)。 - 静态嵌套类不持有外部类引用,本质就是一个普通顶层类,只是命名空间嵌套。
- 局部/匿名内部类捕获局部变量,编译器会把这些变量复制一份到内部类中。
代码示例
成员内部类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25public class Outer {
private int outerField = 10;
private static int staticField = 20;
// 成员内部类
class Inner {
private int innerField = 100;
void show() {
// 可直接访问外部类所有成员(含 private)
System.out.println("outerField = " + outerField); // 10
System.out.println("staticField = " + staticField); // 20
System.out.println("innerField = " + innerField); // 100
}
// JDK 16 前不能有 static 成员;JDK 16+ 允许 static 常量/成员
}
public static void main(String[] args) {
// 创建成员内部类必须先有外部类实例
Outer outer = new Outer();
Outer.Inner inner = outer.new Inner();
inner.show();
}
}静态内部类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18public class Outer {
private int outerField = 10;
private static int staticField = 20;
static class Nested {
void show() {
// 只能访问外部类的静态成员
System.out.println("staticField = " + staticField); // 20
// System.out.println(outerField); // 编译错误!无外部实例
}
}
public static void main(String[] args) {
// 直接通过外部类名创建,无需外部实例
Outer.Nested nested = new Outer.Nested();
nested.show();
}
}局部内部类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24public class Outer {
private int outerField = 10;
void method() {
final int localVar = 30; // 显式 final
int effectivelyFinal = 40; // 未再赋值,effectively final
// 局部内部类,定义在方法或代码块内部
class Local {
void show() {
System.out.println("outerField = " + outerField); // 10
System.out.println("localVar = " + localVar); // 30
System.out.println("effectivelyFinal = " + effectivelyFinal); // 40
}
}
Local local = new Local();
local.show();
}
public static void main(String[] args) {
new Outer().method();
}
}- 局部内部类不能有访问修饰符,因为作用域仅限所在代码块。
- 可访问外部类成员 + 所在方法中 final / effectively final 的局部变量。
- 非静态方法中定义的局部内部类隐式持有外部类实例引用;静态方法中则没有。
匿名内部类
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30public class Outer {
private int outerField = 10;
void method() {
final int localVar = 30;
// 匿名内部类实现接口
Runnable r = new Runnable() {
public void run() {
System.out.println("outerField = " + outerField); // 10
System.out.println("localVar = " + localVar); // 30
}
};
r.run();
// 匿名内部类继承类
Thread t = new Thread() {
public void run() {
System.out.println("匿名内部类线程");
}
};
t.start();
}
public static void main(String[] args) {
new Outer().method();
}
}- 只能访问 final / effectively final 局部变量。
- 同样隐式持有外部类实例引用
内存关系
- 成员内部类:每个成员内部类实例都持有一个隐式的
this$0字段指向外部类实例。所以内部类创建的对象与外部对象强引用绑定,外部对象生命周期被延长。且外部类实例不能先于内部类实例被 GC,这就是所谓的内存泄漏风险 - 静态嵌套类:静态嵌套类不持有外部类实例引用,本质上就是一个普通类,与外部类实例完全解耦,只共享外部类的静态成员,优先推荐使用静态嵌套类。
- 局部和匿名内部类:除了可能持有外部类引用,还会持有被捕获的局部变量的副本(编译器生成的合成字段),这就是”捕获”的内存本质。
匿名内部类为什么必须捕获 final / effectively final 变量?
Java 的闭包是”值捕获”,不是”引用捕获”。
局部变量在方法栈上,方法结束后就销毁,而匿名内部类对象可能活得更久。所以编译器必须把变量复制到内部类对象的字段里。这就是合成字段。内部类访问的其实是这个副本。
如果原变量还能被修改,内部类里的副本和原变量就会不一致。为保证语义正确,Java 强制被捕获的变量不可再变,即 final。
以前必须显式写
final,JDK 8 起只要变量”事实上没被重新赋值”即可(effectively final),编译器帮你保证一致性,减少样板代码。如果捕获的是引用类型变量,final 只保证引用不变,对象内部状态仍可变
effectively final(事实上的 final):一个局部变量或参数,声明时没加
final,但初始化后从未被重新赋值,编译器就把它视为 final。
成员内部类能定义 static 成员吗?
- JDK 16 之前不能,
static final编译期常量除外,因为内部类实例依赖外部实例; - 而 JDK 16 起允许内部类声明 static 成员,之前要放静态成员就只能用静态嵌套类。
Java 的四种引用类型(强、软、弱、虚)代表什么?有什么区别?各自的应用场景?
Java 四种引用类型的核心目的是让 JVM 灵活控制对象的回收时机,不同引用类型有不同的 GC优先级,开发者可通过引用类型精准管理内存
强引用
日常开发中最常见的引用,只要强引用存在,JVM 永远不会 GC 有强引用的对象,即使 OOM 也不回收。只有手动把引用置为 null,对象才会失去强引用,进入可回收状态。
1
2
3
4
5// 强引用
Object strongRef = new Object();
// 断开强引用(只有手动置null,对象才可能被回收)
strongRef = null;软引用
用
SoftReference包装的引用,JVM 会在内存不足时回收软引用关联的对象,适合做缓存。内存充足时,即使触发 GC 也不会回收。1
2
3
4
5
6
7
8
9
10// 创建软引用(关联一个大对象,比如缓存数据)
SoftReference<byte[]> softRef = new SoftReference<>(new byte[1024 * 1024 * 10]); // 10MB
// 获取软引用对象(需判空,可能已被回收)
byte[] data = softRef.get();
if (data == null) {
// 重新加载数据(缓存失效,从数据库/Redis加载)
data = new byte[1024 * 1024 * 10];
softRef = new SoftReference<>(data);
}一般,项目中点数据缓存这种内存敏感的数据,可以用软引用存储,既保证热点数据快速访问,又避免 OOM;
弱引用
用
WeakReference包装的引用,无论内存是否充足,只要触发 GC,都会回收弱引用关联的对象,生命周期比软引用更短。1
2
3
4
5
6// 创建弱引用
WeakReference<Object> weakRef = new WeakReference<>(new Object());
// 触发GC(模拟)
System.gc();
// 此时weakRef.get()返回null,对象已被回收
System.out.println(weakRef.get()); // nullThreadLocal的ThreadLocalMap中,Key 是弱引用,避免ThreadLocal内存泄漏虚引用
用
PhantomReference包装的引用,无法获取对象,完全不影响对象的回收,唯一作用是监听对象的 GC 回收事件,因为虚引用对象被 GC 回收时,会收到一个系统通知- 无法通过虚引用获取对象(虚引用的
get()方法永远返回 null) - 必须和
ReferenceQueue配合使用,否则无意义。
1
2
3
4
5
6
7
8
9
10
11
12
13
14// 引用队列(接收回收通知)
ReferenceQueue<Object> queue = new ReferenceQueue<>();
// 创建虚引用
PhantomReference<Object> phantomRef = new PhantomReference<>(new Object(), queue);
// 触发GC
System.gc();
// 从队列中获取回收的引用(监听对象是否被回收)
Reference<?> ref = queue.poll();
if (ref != null) {
System.out.println("对象已被GC回收");
// 做资源清理(如释放文件句柄、关闭连接)
}因为其 GC 后有个通知的特性,一般做资源回收监听,通过虚引用监听对象回收,确保资源被彻底释放;
- 无法通过虚引用获取对象(虚引用的
四种引用的核心区别是回收时机和应用场景,从强到虚,回收优先级越来越高,适用场景也从业务层转向底层资源管理。”
对象
简单说一下
Stringbuffer 和 Stringbuilder
的区别,和它们都能在项目中什么地方用到?为什么循环里拼接字符串要用
StringBuilder,而+ 是性能灾难?
String
是不可变的,每次拼接都会创建新对象,也就可以理解为常量,线程安全。
而StringBuffer 同
StringBuilder,均为可变字符数组,底层是用
char[]
实现的,都支持动态扩容,避免频繁创建对象,适合大量字符串拼接场景。
每次对 String 类型进行改变的时候,都会生成一个新的
String 对象,然后将指针指向新的 String
对象。StringBuffer 和StringBuilder
每次都对对象本身进行操作,而不是生成新的对象并改变对象引用。
StringBuffer线程安全,因为方法加了
synchronized
同步锁,因此效率低,同步锁的时候会带来性能开销,
StringBuilder
非线程安全,无锁,因此效率高
StringBuffer 和StringBuilder
一般就是字符串缓冲区,需要针对字符串进行操作,例如业务逻辑中的字符串拼接,循环中拼接字符串,JSON
字符串处理,日志处理都可以用到他们
String 的任何修改都创建新对象,所以+
是性能灾难,虽然编译器会把 + 自动优化成
StringBuilder,但是进入循环,这个
StringBuilder
还是在循环体内部每轮都新建,增加 内存和 GC 压力
s = s + i会被编译成:s = new StringBuilder().append(s).append(i).toString();
正确写法是循环外创建一个 StringBuilder,然后 append
1 | StringBuilder sb = new StringBuilder(); |
String 为什么是不可变的?不可变是怎么实现的?底层实现和不可变性带来的好处?
String 的 “不可变性” 指,一旦一个 String
对象被创建,其内部的字符序列就无法被修改,看似修改的操作如substring()、replace(),实际都是创建新的
String 对象
String 类中使用 private final
关键字修饰字符byte[]数组,并且String
类没有提供修改这个字符串的方法。
而且String 类被 final
修饰导致其不能被继承,进而避免了子类破坏 String
不可变。
在 Java 9 之后,
String、StringBuilder与StringBuffer的实现改用byte数组存储字符串。以前是char[]字符数组
String 的不可变性是 JDK 设计的核心决策,带来的好处很多
线程安全:天然支持多线程并发
不可变对象的状态一旦创建就固定,无需加锁即可在多线程中安全使用。
字符串常量池节省了内存
字符串常量池是 JVM 为 String 设计的缓存机制,存储在堆中
若 String 是可变的,修改 s1 会导致所有引用该常量的变量都被修改,常量池就失去意义
不可变性保证了常量池中的字符串始终不变,实现 一处存储、多处引用,大幅节省内存。
哈希值缓存,提升集合性能
String 的
hashCode()方法会缓存哈希值不可变性保证哈希值永远不变,无需每次调用
hashCode()都重新计算,这对 HashMap、HashSet 等集合至关重要
Object 类的常见方法有哪些?简单说说?
Object 类是一个特殊的类,是所有类的父类,主要提供了以下 11 个方法:
1 | /** |
String s1 = new String("abc");这句话创建了几个字符串对象?
首先,最多会创建两个对象,但是情况也不是都一概而论的
首先,字符串常量池里没有
abc,此时会创建两个对象abc是字符串字面量,JVM 会先检查字符串常量池,如果没有,就会在字符串常量池中创建一个内容为abc的字符串对象而
new String()关键字会强制在堆内存中创建一个新的字符串对象,这个对象的内容和常量池中的abc一致,但地址不同。字符串常量池里已有
abc此时只会创建 1 个对象,因为字符串常量池里已有
abc,JVM 不会重复创建,只会因为new String()在堆中创建一个对象
1 | public class StringObjectTest { |
所以说,实际开发中,尽量使用 String s = "abc" 而非
new String("abc"),避免堆内存中创建多余对象,节省内存。
== 和 equals 有什么区别?在什么时候使用它们?
==
本质是运算符,对于基本类型,比较值是否相等(栈中存储的数值),对于引用类型,比较内存地址是否相等(对象在堆中的内存地址),也就是是否指向同一个对象
而 equals()本质是 Object
类中的方法,仅引用类型使用,基本类型无此方法,默认情况下,Object
类中的equals()等价于==,所以很多类会重写,重写后一般是比较对象内容
1 | // Object的equals默认实现源码 |
用 == 的场景
- 基本类型比较值是否相等
- 引用类型比较 “是否是同一个对象”,比如判断对象是否为 null、判断是否是同一个缓存对象
用 equals() 的场景
引用类型比较 内容是否相等
包装类型比较值
包装类型是引用类型,
==可能因为缓存池问题踩坑,必须用equals()1
2
3
4Integer a = 128;
Integer b = 128;
System.out.println(a == b); // false(超出-128~127缓存池,是不同对象)
System.out.println(a.equals(b)); // ✅ true(比较值)
自定义类需要重写 equals(),如果自定义类不重写
equals(),默认用 Object 的实现比较地址,会导致
内容相同但返回 false
String 的
equals() 和 == 的区别?intern()
方法的作用?
字符串常量池 是 JVM 为了提升性能和减少内存消耗针对字符串(String 类)专门在堆内存中开辟的一块区域,存储唯一的字符串常量
什么意思,也就是说,相同的字符串只存储一份
字面量创建 String 会进入字符串常量池,普通 new String()
创建的字符串对象,存储在堆的非常量池区域。
==
是运算符,对于基本数据类型含义是值相等,对于引用数据类型,比较内存地址是否相等,也就是是否指向同一个对象
String 用 == 比较时,只有指向常量池同一个字符串才会返回
true。
equals() 是 Object 类的方法,默认实现是
==,但 String
重写了该方法,改为比较字符串的内容是否相等。
intern() 是 String
类的本地方法,作用是,检查字符串常量池中是否存在当前字符串的内容
- 如果存在,返回常量池中的该字符串引用;
- 如果不存在,将当前字符串的内容加入常量池,并返回常量池中的引用。
- JDK6:常量池在永久代,
intern()会复制字符串内容到常量池,返回新地址;- JDK7+:常量池移到堆,
intern()不会复制内容,而是存储堆中字符串的引用,节省内存。使用场景:大量创建重复字符串时(如海量日志解析),调用
intern()可将字符串入池,减少内存占用。
Java
中 hashCode() 和 equals()方法是什么?它们与 ==
操作符有什么区别?默认 equals 是什么?为什么重写 equals()
时必须重写 hashCode() 方法?
hashCode、equals 和 == 是 Java
中三种不同层面的比较方式:
==比较的是内存地址,看两个引用是不是指向堆里同一块内存。对于基本类型,直接比值。equals比较的是对象内容,Object 类默认实现就是==,通常会重写它来定义”内容相等”的逻辑。hashCode返回一个整数哈希值,快速定位对象在哈希表中的位置。哈希码不同,对象肯定不相等;哈希码相同,对象不一定相等。主要给 HashMap、HashSet 这类哈希结构用
而 hashCode 和 equals
存在契约关系,通常重写一个需要重写另一个
- 如果
equals返回 true,那hashCode必须相同 - 如果
hashCode不同,那么equals一定返回 false - 但是如果
hashCode相同,equals不一定返回 true(哈希碰撞)
如果追问,如果我只重写了 equals 没重写
hashCode,会出什么问题?
HashMap 和 HashSet 会出问题。比如你 new
两个内容一样的对象去当 key,equals 返回 true,但
hashCode 没重写,他们的 hashcode
不一定相同,会落到不同哈希桶,HashSet 去重失败、HashMap get
不到。因为哈希容器先用 hash(key) 定位桶、再在桶内用 equals
比较,hash 不同就永远碰不到面,所以重写 equals 必须重写 hashCode。
Integer a b c d,a 和 b 都是100,c 和 d 都是1000,它们相等吗?为什么?背后的机制能不能讲清楚?自动装箱到底做了什么?
1 | public class IntegerTest { |
Java
为了优化性能,给Integer设置了缓存池,默认缓存范围是
[-128, 127]。
- 当装箱的值在
[-128, 127]范围内时,valueOf方法会直接返回缓存池中的已有对象,不会新建; - 当值超出这个范围时,
valueOf方法会新建一个Integer对象返回。
当你直接写 Integer a = 100 时,然后去进行比较,JVM
会执行自动拆装箱,底层调用的了
Integer.valueOf(int i) 方法,这个方法就是缓存机制的核心。a
和 b 指向了缓存池的同一个对象,所以 true,c 和 的
因为没有缓存的关系,是两个新对象,它们地址不同,所以
false;
所以说,包装类数值它也是对象,比较优先用equals(),而非==,避免缓存机制带来的判断错误。
其他包装类的缓存情况如下:
Byte:缓存所有值;Short/Long:默认缓存 [-128, 127];Character:缓存 [0, 127];Boolean:缓存 true 和 false 两个对象;Float/Double:无缓存(因为浮点数取值范围广,缓存无意义)。
为什么
0.1 + 0.2 != 0.3,金额该用什么算,该如何存?怎么比较两个浮点数?BigDecimal
又该怎么用才不出错?BigDecimal.equals 和
compareTo 一样吗?
二进制浮点数无法精确表示大多数十进制小数
float/double 遵循 IEEE 754 标准,用「符号位
+ 指数 + 尾数」的二进制科学计数法存储。而
0.1、0.2、0.3
这些十进制小数,转换成二进制都是无限循环小数。float/double
就只能截断,存进去的和计算的,都是近似值
1 | System.out.println(0.1 + 0.2); // 0.30000000000000004 |
计算用
BigDecimal,能精确表示十进制小数,存储用DECIMAL(p, s),是精确的定点数,或者用
BIGINT 存 分,金额 × 100
进行存储,彻底避开小数,性能和精确性都好
浮点数不能用 ==
直接比较,正确做法是比较差值是否小于一个容差
1 | double a = 0.1 + 0.2, b = 0.3; |
更严谨的方式是用 Double.compare(a, b),或对金额直接用
BigDecimal.compareTo。
BigDecimal 怎么用才不出错?
必须用 String 构造器
2
3
new BigDecimal("0.1"); // ✅ 精确的 0.1
BigDecimal.valueOf(0.1); // ✅ 内部用 Double.toString 转换,等价于 "0.1"
new BigDecimal(double)会把 double 的二进制近似值原样展开成十进制除法必须指定精度和舍入模式,否则可能抛异常
2
3
4
BigDecimal b = new BigDecimal("3");
a.divide(b); // ❌ ArithmeticException(无限循环小数)
a.divide(b, 2, RoundingMode.HALF_UP); // ✅ 0.33,指定保留 2 位、四舍五入运算结果要接住,因为 BigDecimal 不可变
2
3
x.add(new BigDecimal("2.0")); // ❌ 结果被丢弃,x 仍是 1.0
x = x.add(new BigDecimal("2.0")); // ✅ 重新赋值比较用
compareTo,不要用equals
equals:同时比较数值和 scale(标度)。1.0和1.00的数值相等,但 scale 分别是 1 和 2,equals返回false。compareTo:只比较数值大小,忽略 scale。
反射
什么是反射?反射的原理和机制了解吗?反射有什么优缺点?
简单来说,Java 反射 (Reflection) 是一种在程序运行时,动态地获取类的信息并操作类或对象(方法、属性)的能力。
通常情况下,我们写的代码在编译时类型就已经确定了,要调用哪个方法、访问哪个字段都是明确的。
但反射允许我们在运行时才去探知一个类有哪些方法、哪些属性、它的构造函数是什么样的,然后我们可以动态地获取对应对象的信息、创建对象、调用方法或修改属性,哪怕这些方法或属性是私有的。
正是这种在运行时 能够反射到其他类 并进行操作的能力,使得反射成为许多通用框架和库的基石。它让代码更加灵活,能够处理在编译时未知的类型。
优点:
- 灵活性和动态性:反射允许程序在运行时动态地加载类、创建对象、调用方法和访问字段。这样可以根据实际需求动态地适应和扩展程序的行为
- 解耦合和通用性:通过反射,可以编写更通用、可重用和高度解耦的代码,降低模块之间的依赖。
缺点
- 性能开销:反射操作通常比直接代码调用要慢。因为涉及到动态类型解析、方法查找以及 JIT 编译器的优化受限等因素。不过,对于大多数框架场景,这种性能损耗通常是可以接受的,或者框架本身会做一些缓存优化。
- 安全性问题:反射可以绕过 Java 语言的访问控制机制,破坏了封装。此外,反射还可以绕过泛型检查,带来类型安全隐患。
- 代码可读性和维护性:过度使用反射会使代码变得复杂、难以理解和调试。错误通常在运行时才会暴露,不像编译期错误那样容易发现
反射在你平时写代码或者框架中的应用场景有哪些?框架为什么离不开它,它的代价和破坏力在哪?
我们平时写业务代码可能很少直接跟 Java 的反射(Reflection)打交道。直接使用反射其实并不是很好,而且性能也一般。
但是使用框架开发中我们天天都享受反射带来的便利性,框架的底层都大量运用了反射机制,这才让它们能够那么灵活和强大。下面简单列举几个最常见的场景。
依赖注入与控制反转 DI 和 IoC
以 Spring/Spring Boot 为代表的 IoC 框架,会在启动时扫描带有特定注解,如
@Component,@Service,@Repository,@Controller等类,利用反射实例化对象作为 Bean,并通过反射注入依赖,如@Autowired、构造器注入等动态代理与 AOP
想在调用某个方法前后自动处理一些事情,例如收集用户操作,处理日志,打开事务,权限检查等。这都涉及到AOP,而动态代理是实现 AOP 的常用手段。JDK 自带的动态代理(
Proxy和InvocationHandler)就离不开反射。代理对象在内部调用真实对象的方法时,就是通过反射的Method.invoke来完成的。ORM 对象映射关系框架
像 MyBatis、Hibernate 这种框架,能帮你把数据库查出来的一行行数据,自动变成一个个 Java 对象。它是怎么知道数据库字段对应哪个 Java 属性的?还是靠反射。它通过反射获取 Java 类的属性列表,然后把查询结果按名字或配置对应起来,再用反射调用 setter 或直接修改字段值。反过来,保存对象到数据库时,也是用反射读取属性值来拼 SQL。
反射的“慢”和“破坏力”源于:它把本该在编译期或类加载期确定的事情,推迟到了运行时,并且绕过了 JVM 为静态代码准备的一系列优化通道。
- 动态解析导致 JIT 优化受限:JVM 的即时编译器(JIT)擅长优化静态可解析的代码,而反射调用涉及的类型在编译期是未知的
- 每次调用的固定开销:Method.invoke 要做访问权限检查、参数数组的包装与解包。涉及到大量的装箱拆箱以及创建临时数组和绑定对象
它的破坏力主要体现在对封装、安全和可维护性的侵蚀上。
- 破坏封装,让私有边界形同虚设
- 模块化时代的访问限制与兼容风险:JDK 9 引入模块系统后,反射访问其他模块的非公共成员默认被禁止
- 编译期检查失效,错误推迟到运行时
- 安全攻击面扩大
框架用反射,是因为框架的作者无法预知使用者的类。但框架的智慧在于把反射用在冷路径上
获取
Class
有哪几种方式?区别是什么?反射怎么创建对象、调用方法、访问私有成员?
获取 Class 对象的 5 种方式
| 方式 | 示例 | 是否触发类初始化 | 说明 |
|---|---|---|---|
类名.class |
String.class、int.class、String[].class |
否 | 编译期确定,最安全、最快;基本类型和数组也适用 |
对象 .getClass() |
obj.getClass() |
否 | 已有实例时使用;返回运行时实际类型(多态下是子类) |
Class.forName(全限定名) |
Class.forName("java.lang.String") |
是 | 最常用;可指定类加载器和是否初始化:Class.forName(name, false, loader) |
ClassLoader.loadClass(全限定名) |
loader.loadClass("java.lang.String") |
否(默认) | 只加载、不初始化;是双亲委派的入口 |
包装类 .TYPE |
Integer.TYPE |
否 | 等价于 int.class,本质仍是 类名.class |
补充
- 基本类型不能用
forName("int"),只能int.class或Integer.TYPE。 - 数组:
String[].class,或Class.forName("[Ljava.lang.String;")。 - 是否触发初始化,指的是是否执行
<clinit>(静态代码块、静态字段赋值)。Class.forName("com.mysql.cj.jdbc.Driver")能注册驱动,就是因为forName默认initialize = true会执行驱动类的静态代码块(JDBC 4 之后靠 SPI 自动加载,已经不需要手写这行)。
反射创建对象
1 | Class<?> clazz = Class.forName("com.example.User"); |
不要再用
Class.newInstance():它只能调用无参构造、抛出的受检异常不友好,JDK 9 起已标记过时,统一改成getDeclaredConstructor().newInstance()。
调用方法
1 | Class<?> clazz = User.class; |
关键点
getMethod只找public(包括继承来的);getDeclaredMethod找本类声明的全部(包括 private),但不找继承来的。- 重载方法要用参数类型精确定位;基本类型和包装类型不通用(
int.class≠Integer.class)。 invoke的参数是Object...,基本类型会自动装箱,返回值也需要强转。- 调用
static方法时,invoke的第一个参数(目标对象)可以是null。 - 方法本身是
private时,必须先setAccessible(true),否则抛IllegalAccessException。
访问字段
1 | Field field = clazz.getDeclaredField("name"); // 私有字段 |
getField只拿 public(含继承),getDeclaredField拿本类全部。setAccessible(true)关闭的是当前这个Field/Method/Constructor对象的访问检查,不是全局开关。- JDK 9+ 模块系统下,反射访问其他模块的非 public 成员会抛
InaccessibleObjectException,需要--add-opens/--add-exports启动参数。 final字段:非 static 的 final 实例字段在setAccessible后通常仍能修改,但static final的编译期常量、record 的组件等会被 JVM 优化,结果不可靠,业务代码不要这么干。
获取其他信息
1 | clazz.getName(); // 全限定名 |
反射比直接调用慢,开销主要来自访问权限检查、参数数组的封装/解包、JIT
难以内联。把 Method / Constructor /
Field
对象缓存起来是框架的常见优化手段(Spring、MyBatis
都这么做),不要每次调用都重新查找。
注解
能讲一讲Java注解的原理吗?注解的本质是什么?编译后变成什么?
注解是 Java 的元数据,用来给类、方法、字段附加说明信息,不直接影响代码逻辑,但可以被编译器 / 框架 / 反射读取并执行逻辑。
主要用于编译检查(@Override、@NonNull)、代码生成(Lombok那一套)和运行期框架扩展(Spring中的大部分注解)。
注解本质是接口,继承
java.lang.annotation.Annotation,其具体实现类是 Java
运行时生成的动态代理类
我们通过反射获取注解时,返回的是 Java
运行时生成的动态代理对象。通过代理对象调用自定义注解的方法,会最终调用
AnnotationInvocationHandler 的 invoke
方法。
而框架就是扫描注解,然后反射获取信息,自动执行逻辑(动态代理/AOP等)
编译之后,注解并不会变成可执行的代码,而是作为一种属性(Attribute) 被附加到 class 文件的结构里。
Java注解的作用域呢?
注解的作用域(Scope)指的是注解可以应用在哪些程序元素上,例如类、方法、字段等。Java注解的作用域可以分为三种:
- 类级别作用域:用于描述类的注解,通常放置在类定义的上面,可以用来指定类的一些属性,如类的访问级别、继承关系、注释等。
- 方法级别作用域:用于描述方法的注解,通常放置在方法定义的上面,可以用来指定方法的一些属性,如方法的访问级别、返回值类型、异常类型、注释等。
- 字段级别作用域:用于描述字段的注解,通常放置在字段定义的上面,可以用来指定字段的一些属性,如字段的访问级别、默认值、注释等。
除了这三种作用域,Java还提供了其他一些注解作用域,例如构造函数作用域和局部变量作用域。这些注解作用域可以用来对构造函数和局部变量进行描述和注释。
自定义注解怎么写?核心的元注解有哪些?@Retention
三档的区别?什么时候必须
RUNTIME?自定义注解能继承另一个注解吗?@Inherited
又是什么?
自定义注解用 @interface 定义,必须搭配4
个元注解:
@Target:注解能用在哪里(类 / 方法 / 字段 / 参数)@Retention:生命周期(SOURCE / CLASS / RUNTIME)@Documented:生成 javadoc@Inherited:允许子类继承父类注解
第五个核心元注解:
@Repeatable:管重复标注JDK 8 引入。没有它时,同一个位置只能贴一个同类型的注解。加上
@Repeatable后,允许在同一元素上多次标注同一个注解。
最常用的就是@Retention (RetentionPolicy.RUNTIME),而且框架几乎都用运行期注解,通过反射读取。
编译之后,注解并不会变成可执行的代码,而是作为一种属性(Attribute)
被附加到 class 文件的结构里。具体存放到哪里、叫什么名字,由
@Retention 决定:
SOURCE:仅存在于源码,编译后直接丢弃CLASS(默认):被编译进 class 文件,但 JVM 加载类时会忽略它。无法通过反射获取RUNTIME:不仅被编译进 class 文件,还会被 JVM 保留到运行期。可以通过反射获取
注解之间不存在继承关系。虽然注解不能
extends,但可以组合,把一个注解标注在另一个注解上
@Inherited
是五个元注解之一,它控制是否允许子类继承父类注解,只对类注解有效,只沿
extends 父类链向上查找,不管接口
注解处理器和运行时反射读取有什么区别?Lombok 为什么”不合规”?
注解处理器,在编译阶段运行,是 javac
的一部分,可以理解为一个插入到编译流程中的钩子,初衷是生成辅助代码
运行时反射,在程序运行阶段生效,反射 API 让你在运行时读取类上的注解,它不会生成新代码
Lombok 为什么“不合规”?
它做的事情超出了 JSR 269 的授权范围。
Lombok 本质上是一个注解处理器,但它没有只用标准的
javax.annotation.processingAPI。标准 API 给你的
Element对象,你只能看,不能改。但 Lombok 通过强制类型转换,把
Element转换成了com.sun.tools.javac.tree.JCTree,这是javac编译器内部的、未公开的抽象语法树(AST)节点类型。一旦拿到了这个内部对象,Lombok 就可以直接往 AST 里插入新的方法节点,然后让编译器基于被篡改过的 AST 继续生成字节码。
异常
Java
中 Exception 和 Error 有什么区别?Java
的异常体系怎么划分?为什么有的异常编译器强制你 try-catch 或
throws,有的却完全不检查?
首先,Exception 和 Error 都是
Throwable 类的直接子类,只有继承了 Throwable
的对象才能被 throw 和
catch。二者核心区别在于
- Exception
代表程序运行过程中可以预料、可以恢复的异常情况,属于业务逻辑范畴,可以被合理的处理,比如
NullPointerException、IOException等 - Error 代表 JVM
本身或者系统环境的严重错误,程序通常无法恢复,出现后往往要终止进程,比如
OutOfMemoryError、StackOverflowError等
Exception 是可以被处理的程序异常,Error 是系统级的不可恢复错误。
Exception 又分为 Checked Exception受检异常 和
Unchecked Exception非受检异常:
- 受检异常继承自
Exception但不继承RuntimeException,设计初衷是强制调用方处理可能出现的异常,编译时必须显式处理,要么try-catch要么throws声明抛出,比如IOException、SQLException - 非受检异常继承自
RuntimeException,通常是编程错误导致的,不需要显式捕获,运行时才抛出,比如NullPointerException、IndexOutOfBoundsException
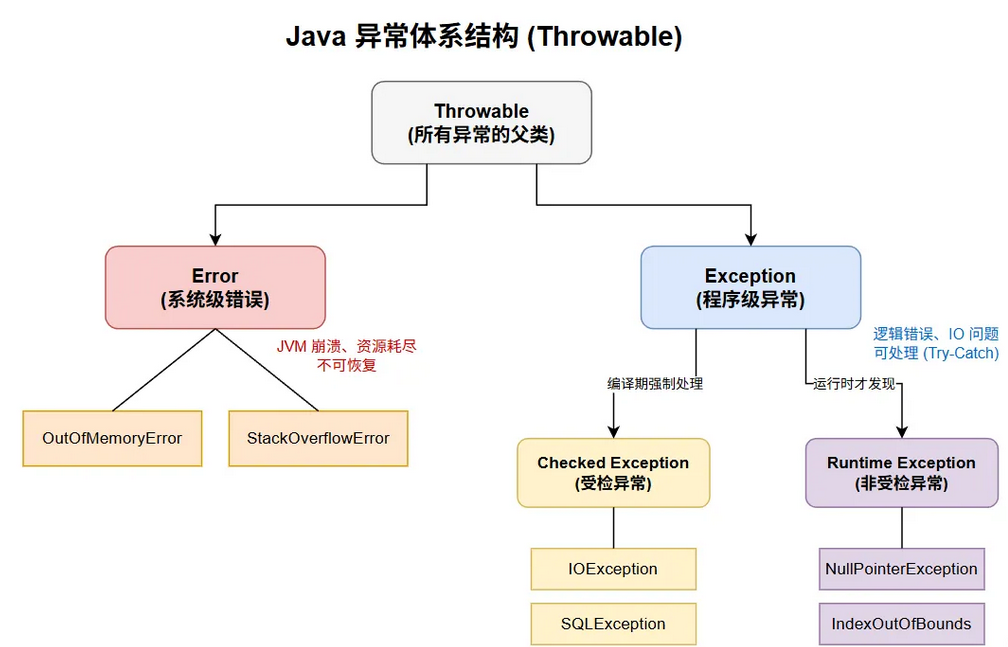
Checked Exception 和 Unchecked Exception 有什么区别?编译器到底检查哪一个?你更倾向于使用哪个?为什么有的异常强制处理,有的完全不检查?
Checked Exception 即 受检查异常 ,Java
代码在编译过程中,如果受检查异常没有被
catch或者throws
关键字处理的话,就没办法通过编译。编译器只检查受检查异常
- 除了
RuntimeException及其子类以外,其他的Exception类及其子类都属于受检查异常 - 强制检查的原因是,这种异常代表可恢复的、调用方有能力且应该处理的外部故障,逼迫开发者正视这些可能发生的故障
Unchecked Exception 即 不受检查异常 ,Java 代码在编译过程中 ,我们即使不处理不受检查异常也可以正常通过编译。
RuntimeException及其子类都统称为非受检查异常- 不受检查异常之所以不受检查,是因为这类问题不是靠
catch能处理的,代表 bug 或者不可恢复的错误,正确做法是修代码。 - 而 Error 更是 JVM 级严重问题,程序通常无力恢复,也不该捕获。
开发中,默认使用 Unchecked Exception,只在必要时才用
Checked Exception。
我们可以把 Unchecked Exception(比如
NullPointerException)看作是代码 Bug。对待
Bug,最好的方式是让它暴露出来然后去修复代码,而不是用
try-catch 去掩盖它。
一般来说,只在一种情况下使用
Checked Exception:当这个异常是业务逻辑的一部分,并且调用方必须处理它时。例如,一个余额不足异常,这不是
bug,而是一个正常的业务分支,需要抛出 Checked Exception
来强制调用者去处理这种情况,比如提示用户去充值。这样就能在保证关键业务逻辑完整性的同时,让代码尽可能保持简洁。
子类重写父类方法时,异常声明受什么限制?为什么?
子类重写方法不能抛出比父类方法 更宽 的受检异常。非受检异常不受此限制 具体来说:
- 不能抛出新的、父类方法未声明的受检异常。
- 不能抛出父类声明异常的父类型(更宽)。
- 可以抛出父类声明异常的子类型(更窄),或完全不抛。
- 可以随意抛出
RuntimeException(非受检异常不受此限制)。 - 父类方法没声明任何受检异常,子类也不能声明受检异常。
为什么这样限制?为了多态下的类型安全
考虑这个场景
1
2
3
4Parent p = new Child(); // 多态:用父类引用指向子类对象
try {
p.f(); // 编译器只知道 p 是 Parent,只准备了处理 IOException
} catch (IOException e) { }编译器根据
p的声明类型Parent,认为f()最多抛IOException,所以只要求你处理IOException。如果子类Child的f()能抛出SQLException,是父类没声明的新受检异常,那么这个异常就会穿透调用方的catch块,调用方完全没有准备,类型安全被破坏。
子类方法的行为必须能 替代 父类方法——父类承诺,最多抛这些异常,子类就不能超出这个承诺,否则多态调用时调用方按父类契约写的异常处理就会失效。这正是里氏替换原则在异常声明上的体现。
final、finally、finalize 的区别?
三者完全不同
| 关键字 | 作用 |
|---|---|
| final | 修饰类 / 方法 / 变量,限制修改 |
| finally | 异常处理的块,无论是否抛异常,finally 块都会执行(除非 JVM 退出),用于释放资源 |
| finalize | Object 类的方法,GC 回收对象前调用(不确定执行时机,已被标记为过时) |
try-catch-finally
中,finally
一定会执行吗?finally里也写return会怎样?try里return一个变量、finally`
里修改它,返回值会变吗?return 到底返回哪个值?
不一定,finally只是保证是否发生异常都会执行的代码块。通常用于释放资源,确保资源的正确关闭。
但是,只要 try/catch
块被正常进入,无论以下情况,finally
都会执行
try块正常执行完毕;try块中抛出异常(被catch捕获或未捕获);try/catch块中包含return、break、continue等跳转语句。此时,JVM 会优先执行 finally 块,再返回try里return了,finally还执行,除非被杀了顺序是,
try的 return 表达式先求值,执行finally,再真正返回。因为,
return语句分两步,先计算返回值并暂存,再执行返回动作。
但是,try-catch-finally中,finally
不是一定会执行的,例如假如 finally 执行之前 JVM
被终止运行的话,finally
中的代码就不会被执行,但是这些属于极端情况。
- 程序所在的线程死亡。如调用
System.exit(0) - 关闭 CPU。
- JVM 进程异常终止
try 里 return
一个变量、finally 里修改它,返回值会变吗?
基本类型,finally 改的是变量值,返回值不变
1
2
3
4
5
6
7
8
9int f() {
int x = 1;
try {
return x; // ① 求值:把 x 的当前值 1 暂存为返回值
} finally {
x = 2; // ② 改的是局部变量 x,不影响已暂存的返回值
}
}
// 返回 1,不是 2引用类型,finally 修改对象内部状态。返回值会变,如果 finally 让变量指向新对象,那么返回值不变
return 语句分两步,先计算返回值并暂存,再执行返回动作。finally 插在这两步之间
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19StringBuilder f() {
StringBuilder sb = new StringBuilder("a");
try {
return sb; // ① 暂存的是 sb 指向的对象引用
} finally {
sb.append("b"); // ② 通过引用修改了同一个对象的内容
}
}
// 返回的 StringBuilder 内容是 "ab"
StringBuilder f() {
StringBuilder sb = new StringBuilder("a");
try {
return sb; // ① 暂存旧对象引用
} finally {
sb = new StringBuilder("c"); // ② 只改变量指向,暂存的还是旧对象
}
}
// 返回内容仍是 "a"
finally 里的 return 会覆盖
try/catch 的返回值,且会吞掉 try
中抛出的异常
return 到底返回哪个值?
return返回的是“求值阶段暂存的那个值”,finally插在 暂存之后、返回之前
只有
try-finally、没有 catch
合法吗?catch 里能再抛异常吗?
try { } finally { } 是完整语法,catch
可以没有;反过来 try 不能单独存在,必须配
catch 或 finally
catch 里可以再抛异常,也可以包装成运行时异常抛出
try-with-resources是什么?如何使用
try-with-resources
代替try-catch-finally?try-with-resources 中如果业务代码和
close() 同时抛异常,调用方看到的是哪个?try-with-resources
能代替 finally 做业务清理吗?
try-with-resources 是 Java 7
引入的语法糖,专门用于自动关闭实现了 AutoCloseable
接口的资源,如文件流、数据库连接、Socket 连接等,替代传统的
try-catch-finally 手动关闭资源,解决资源泄漏
对于try-with-resources ,有一些特点
资源声明在
try()括号内,JVM 会在try代码块执行完毕后自动调用资源的close()方法;Java 9 进一步优化:资源可在外部声明,仅在
try()中引用。即使发生异常,资源也会被保证关闭
try-with-resources中,try块的异常是 主异常,close()抛出的异常是 抑制异常,会被附加到主异常中,不会覆盖
传统 try-catch-finally 关闭资源,需要为每个资源都在
finally 中写关闭逻辑,而且手动调用 close()
可能忘记,导致资源泄漏,并且finally 中的
close() 抛出如果异常,会覆盖 try
块的原始异常,难以排查问题
例如
1 | // 资源外部声明 |
注意,如果
try()中声明多个资源,JVM 会按声明的逆序关闭
业务代码和 close()
同时抛异常,看到的是业务代码的异常,close()
的异常被抑制了
- 因为 try 块中是主异常,自动关闭资源时如果
close()也抛出异常,后者会被Throwable.addSuppressed()添加到主异常中。可以通过getSuppressed()拿到被抑制的close()异常
try-with-resources 不能代替 finally 做业务清理
- 因为,try-with-resources 管理的是实现了
AutoCloseable的资源,但finally能做的业务清理可远远不止这些 - 所以说,有
AutoCloseable资源要关,优先用 try-with-resources;有非资源的清理逻辑,仍然用finally。两者配合使用
throw
和 throws 有什么区别?throws 后面能写
RuntimeException 吗?
throw |
throws |
|
|---|---|---|
| 位置 | 方法体内的语句 | 方法签名上的声明 |
| 作用 | 真正抛出一个异常对象(动作) | 声明这个方法可能抛出哪些异常(告知) |
| 后面跟 | 一个异常实例 | 一个或多个异常类型(逗号分隔) |
| 数量 | 一次只能抛一个 | 可以声明多个 |
| 示例 | throw new IOException("x"); |
void f() throws IOException, SQLException |
throws 后面能写 RuntimeException
吗?语法上可以写,但没有任何实际意义,属于坏实践。
throws的语义是告诉编译器和方法调用者,这些受检异常我可能抛,请处理。而RuntimeException是非受检的,编译器本来就不检查
自定义异常的实现方式?什么时候需要自定义异常?自定义异常该继承谁?多个
catch 有继承关系时顺序有什么讲究?
自定义异常是为了让异常信息更贴合业务场景、便于问题定位、统一异常处理,实现方式分为两位,针对受检异常 和 非受检异常,实际开发中优先用非受检异常。
Java 中异常分为两类,自定义异常也可以这样分类,然后去实现:
- 受检异常:继承
Exception,必须显式捕获 / 抛出(编译器强制检查);- 继承
Exception后,其余和非受检异常一致,但调用处必须try-catch或throws声明 - 异常是可恢复的、调用方有能力且应该处理的,且你希望编译器强制调用方处理
- 继承
- 非受检异常:继承
RuntimeException,无需显式捕获 / 抛出(推荐使用)。- 继承
RuntimeException后,不强制调用方try-catch或throws,一般需要提供提供无参构造、带异常信息的构造、带异常信息 + 根因的构造各种重载 - 不可恢复的编程或输入错误,用非受检异常语义更贴切,绝大多数业务自定义异常用
RuntimeException即可。
- 继承
对于构造器,至少提供 (String message) 和
(String message, Throwable cause)
两个。后者用于保留根因
- 不要继承
Throwable或Error。Error是 JVM 级严重错误,不应自定义; - 异常类应可序列化:
Exception本身实现了Serializable,如果你加了自定义字段,建议显式声明serialVersionUID
当系统自带异常无法精准描述业务场景时,就需要自定义异常
业务逻辑异常
一般是各种情况下的校验失败
业务模块的特定功能异常
一般是需要针对性的模块,需要针对性处理的业务,可以自定义异常方便处理
统一异常处理
配合 SpringMVC 的
@RestControllerAdvice做全局异常拦截,统一返回格式。或者,需要被上层 按类型 区别处理时。
需要携带结构化信息时
系统异常只能带 message,必须自定义字段需要自定义异常
多个 catch
有继承关系时,子类异常必须写在父类异常前面,否则编译报错
1 | try { |
catch是从上到下依次匹配的,一旦某个catch的类型能接住抛出的异常,就进入该块,后面的catch不再检查。如果把父类写在前面,它能接住所有子类异常。JVM 认为这是编译期错误- JDK 7+ 支持
multi-catch,
catch (IOException | SQLException e),但 multi-catch 里的类型不能有继承关系,否则编译报错
开发中异常的使用有哪些需要注意的地方?
首先,我们使用异常的目的是:让错误处理逻辑和业务逻辑分离,代码更清晰;而且精准传递错误信息,便于定位问题;保证程序在异常发生后仍能可控运行
所以说,要注意
- 抛出的异常信息一定要清晰,且有意义,能够快速定位问题
- 不要把异常定义为静态变量,因为这样会导致异常栈信息错乱。每次手动抛出异常,我们都需要手动 new 一个异常对象抛出。
- 在抛异常的时候尽量抛出更加具体的异常
- 不要滥用检查型异常,一些错误如果可以声明为运行时异常就不要声明为检查型异常
- 若错误是「用户 / 环境导致、可恢复」,自定义检查型异常;
- 若错误是「程序员编码错误」,自定义运行时异常
- 异常捕获,抓大放小,不要滥用
catch (Exception e),精准捕获类别给更细的异常 - 不要捕获异常后吞掉(不处理、不记录、不抛出)
泛型
什么是泛型? Java 泛型的作用是什么?泛型解决了什么问题?
泛型的作用是把
类型检查从运行时提前到编译时。编译器能在你写代码的时候就发现类型不匹配,不用等到程序跑起来才抛
ClassCastException。
泛型带来的改变
- 类型安全了,编译期间就检查类型是否匹配,就是 String 集合塞不进去 Integer
- 消除强转,泛型取出元素时编译器会自动进行类型转换
- 代码复用,一个泛型类可以处理各种类型,不用为每种类型写一份代码
最直观的例子是集合类:
1 | // 没泛型的时代 |
Java 5 之前是没有泛型的,集合里塞什么都行,取出来都是 Object,用的时候自己强转。如果一不小心取错类型,编译的时候能过,但是运行的时候却抛错。
泛型就是给类型加了一层约束,声明了类型之后,编译器能在写代码的时候就识别出错误的类型。
别忘了,编译时检查,运行时擦除。
Java
泛型擦除是什么?如何理解泛型的编译时检查,运行时擦除。擦除后
List<String> 和 List<Integer>
在运行时是什么?
泛型擦除就是 Java 编译器在编译期做类型检查和约束,检查完就把泛型信息擦掉,也就是编译时检查,运行时擦除
代码里写的
List<String>、Map<Integer, User>
这些泛型,编译成 class 文件后全变成了
List、Map,泛型参数被替换成它的上界,没写上界就默认是
Object。因此 List<String> 和
List<Integer>,运行时只有 List 一个
Class 对象。
代价就是 Java
的泛型是伪泛型,运行时类型信息丢了,运行时拿不到泛型的实际类型,所以可以用反射往
List<String> 里塞 Integer
是完全可以的,因为绕过了字节码编译检查,运行时根本不管
而擦除擦的是运行期对象的类型实参,不是 class
文件里的签名。泛型信息以 Signature
属性保存在类/字段/方法上,反射依然可以拿到
泛型不支持基本类型。你得写 ArrayList<Integer>
而不是 ArrayList<int>。因为擦除后泛型变成 Object,而
int 不是 Object 的子类,要兼容起来太麻烦。
泛型是编译期的语法糖,擦除后只剩上界;运行期多态靠编译器塞进去的桥接方法
为什么
List<Object> 不是 List<String>
的父类?? extends 和 ? super
到底怎么选?List<?> 和
List<Object> 有什么区别?
直觉上 Object 是 String 的父类,所以
List<Object> 应该是 List<String>
的父类。但是 Java 泛型不是这样
1 | List<Object> list = new ArrayList<String>(); // 假设允许(实际编译错误) |
如果允许,就做不到泛型的类型安全,所以编译器直接禁止
List<String> 不能赋给
List<Object>。泛型是不变的,List<String>
与 List<Object> 没有子类型关系。
类型参数之间即使有继承关系,也不传递到泛型类型上。
? extends 和 ? super
到底怎么选?规则是经典的 PECS 原则:
PECS: Producer Extends, Consumer Super
如果集合是生产者(你只从里面读),用
? extends T,上界通配符做只读1
2
3
4List<? extends Number> list = new ArrayList<Integer>();
Number n = list.get(0); // ✅ 可以读,读出来至少是 Number
list.add(1); // ❌ 编译错误!不能写(除了 null)
list.add(null); // ✅ 只能加 null如果集合是消费者(你只往里面写),用
? super T,下界通配符做只写1
2
3List<? super Integer> list = new ArrayList<Number>();
list.add(1); // ✅ 可以写 Integer(及其子类)
Object o = list.get(0); // ⚠️ 能读,但只能当 Object 用(不知道具体上界)既要读又要写,别用通配符,用精确类型
List<?> 和
List<Object>,两者看起来都能装任何东西,但语义和能力完全不同。
| 对比项 | List<?>(无界通配符) |
List<Object> |
|---|---|---|
| 本质 | List<? extends Object>,表示,元素是某种未知类型的
List |
元素类型明确是 Object 的 List |
| 能接收的实参 | 任何
List<X>(List<String>、List<Integer>、List<Object>
都能赋值) |
只能接收 List<Object>(不能接
List<String>) |
| 能否 add | ❌ 只能 add(null) |
✅ 可以 add 任何 Object |
| 能否读 | ✅ 只能读为 Object |
✅ 读为 Object |
| 用途 | 我不关心元素类型,只做与类型无关的操作(如
size()、isEmpty()、clear()) |
我要一个真正能装任意 Object 的容器 |
你在项目中哪里用到了泛型?能说说你在开发过程中针对泛型的实践吗?
在项目中大量使用泛型,主要用来做三件事
统一返回结果、或者做通用分页
用泛型做了通用返回封装
Result<T>,不管返回什么类型数据(用户、项目、文档),都能统一结构,不需要每个接口写一套,前端解析也统一。PageResult<T>通用分页也是类似,统一处理列表数据、总条数、页码,所有列表接口复用一套,不用重复写分页逻辑。1
2
3
4
5public class Result<T> {
private int code;
private String msg;
private T data;
}通用工具类、对 DAO 层封装
例如封装了
RedisUtil<T>泛型工具类,能接收任意类型的对象,然后统一处理对象序列化 / 反序列化而且 JPA 的
JpaRepository<T, ID>泛型也是很好的实践例子,每个实体只需继承接口,就能直接拥有增删改查、分页、排序,不用写重复 DAO 代码AOP 记录操作日志
AOP 记录用户的操作日志,肯定需要用泛型来接收任意方法返回值,在切面里统一处理,让日志切面能适配所有 Controller/Service,一套切面全系统通用。
RPC 接口、Dubbo 调用的类型安全
泛型让代码类型安全、不用强转、高度复用,大大减少重复代码,提升了项目可维护性。
序列化
Java 中的序列化和反序列化是什么?
Java 中序列化就是把内存中的 Java 对象转成二进制字节流,这样才能存储到硬盘或者通过网络传输。
反序列化顾名思义,就是把二进制字节流反序列化为 Java 对象。
因为硬盘和网络只认 0 和 1,不认 Java 对象,所以必须有这么一层转换。
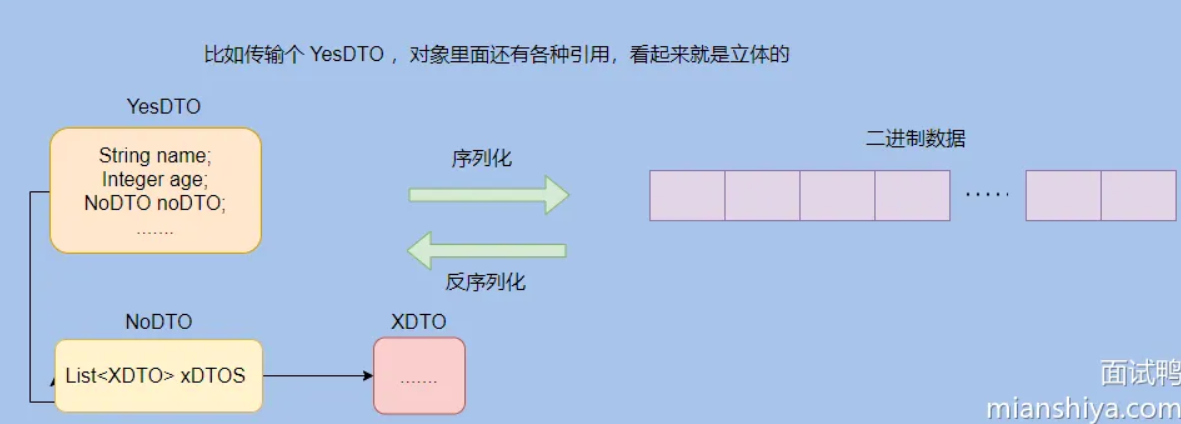
怎么做:类必须实现
Serializable接口,这就是个标记接口,没它 JDK 序列化机制压根不让你序列化怎么控制:敏感字段比如密码,加个
transient关键字,序列化的时候自动跳过怎么稳:显式定义 serialVersionUID,相当于给类打个版本戳,在反序列化时校验类版本,防止改了类结构后反序列化旧数据时报错
ID 的具体数值不重要,1L 还是 IDEA 自动生成的一长串数字都行,关键是保持一致。如果你没显式定义,编译器会根据类的结构自动生成一个,但这带来一个坑:你只是加了个字段,自动生成的 ID 就变了,之前序列化的数据就废了。
而且注意,静态变量不参与序列化,序列化存的是对象的状态,静态变量属于类,不属于对象,所以不会被序列化。
transient关键字的作用是什么?transient 和 static 修饰的字段都不会被序列化,它们有什么区别?
transient 是 Java
中的一个关键字,用于修饰类的成员变量,表示这些变量在序列化过程中不会被保存。它的主要作用是保护敏感数据或减少不必要的存储。
而两者本质不同。static
字段标记的内容属于类,压根就不是对象实例状态的一部分,所以不存在
序列化不序列化 的问题,它就不在序列化的范畴内。transient
是专门告诉序列化机制”这个实例字段我不想存”,比如密码、缓存这类不适合持久化的数据。
关于 transient 还有几点注意:
transient只能修饰变量,不能修饰类和方法。transient修饰的变量,在反序列化后变量值将会被置成类型的默认值。例如,如果是修饰int类型,那么反序列后结果就是0。static变量因为不属于任何对象(Object),所以无论有没有transient关键字修饰,均不会被序列化
serialVersionUID
和 transient 各管什么?为什么你应该手动定义
serialVersionUID?@Serial
注解有什么作用?为什么说原生序列化是”安全地雷”?
serialVersionUID是版本兼容性校验码,反序列化时,JVM
会把字节流里的 serialVersionUID 和本地类的
serialVersionUID
做比对。一致才允许还原对象。防止用旧版本的类去解析新版本的数据。
不写的话,JVM
会根据类的结构自动计算一个值。问题是,类只要发生任何改动**,重新编译后自动算出的值就会变,再用新类反序列化就会失败。手动写一个固定的
private static final long serialVersionUID = 1L;,就等于告诉
JVM,只要我没改这个数字,你就当版本没变,尽力兼容。
被 transient
修饰的成员变量不参与序列化。反序列化后,该字段恢复为默认值
@Serial 标在序列化相关的方法或字段上,编译器会校验声明是否正确
原生序列化不安全的主要核心原因是,readObject()
不是在读取数据,它本身就是在执行逻辑。攻击者构造的字节流,在反序列化过程中可能会在目标
JVM 上执行,所以说建议改用 JSON 或 XML 等更受限的格式
Java 默认的序列化有什么问题?为什么说原生序列化是”安全地雷”?序列化和反序列化让你自己实现你会怎么做?
我们很少或者说几乎不会直接使用 JDK 自带的序列化方式,主要原因有下面这些原因:
- 无法跨语言: Java 序列化目前只适用基于 Java 语言实现的框架,因此,如果是两个基于不同语言编写的应用程序相互通信,则无法实现两个应用服务之间传输对象的序列化与反序列化。
- 容易被攻击:Java 序列化是不安全的,我们知道对象是通过在
ObjectInputStream上调用readObject()方法进行反序列化的,这个方法其实是一个神奇的构造器,它将几乎所有实现了Serializable接口的对象都实例化,所以说它太自由了,这也就意味着,在反序列化字节流的过程中,该方法可以执行任意类型的代码,这是非常危险的。 - 序列化后的流太大,性能差:序列化后的二进制流大小能体现序列化的性能。序列化后的二进制数组越大,占用的存储空间就越多,存储硬件的成本就越高。如果我们是进行网络传输,则占用的带宽就更多,这时就会影响到系统的吞吐量
所以我们会考虑主流的反序列化框架,例如 Spring Boot 项目中,官方默认的
Jackson,是日常开发中最常用的反序列化工具,一个ObjectMapper加各种注解就可以实现序列化(Java
→ JSON)和反序列化。然后也偶尔使用
Fastjson,但它历史安全漏洞较多。如果是二进制序列化,例如
Dubbo 中的 RPC
背景下,Protobuf二进制序列化框架则是非常好的实现。
Java 自己的序列化是如何将对象转为二进制字节流的,具体怎么实现的?
其实,像序列化和反序列化,无论这些可逆操作是什么机制,都会有对应的处理和解析协议
序列化机制是通过序列化协议来进行处理的,和 .class
文件类似,它其实是定义了序列化后的字节流格式,然后对此格式进行操作,生成符合格式的字节流或者将字节流解析成对象。
在 Java 中通过序列化对象流来完成序列化和反序列化:
ObjectOutputStream:通过writeObject()方法做序列化操作。ObjectInputStream:通过readObject()方法做反序列化操作。
只有实现了Serializable或Externalizable接口的类的对象才能被序列化,否则抛出异常!
动态代理
如何实现动态代理?JDK 动态代理和 CGLIB 动态代理有什么区别?为什么 final 方法代理不了?
动态代理是一种非常强大的设计模式,它允许我们在不修改源代码的情况下,对一个类或对象的方法进行功能增强(Enhancement)。
在 Java 中,实现动态代理最主流的方式有两种:JDK 动态代理 和 CGLIB 动态代理。
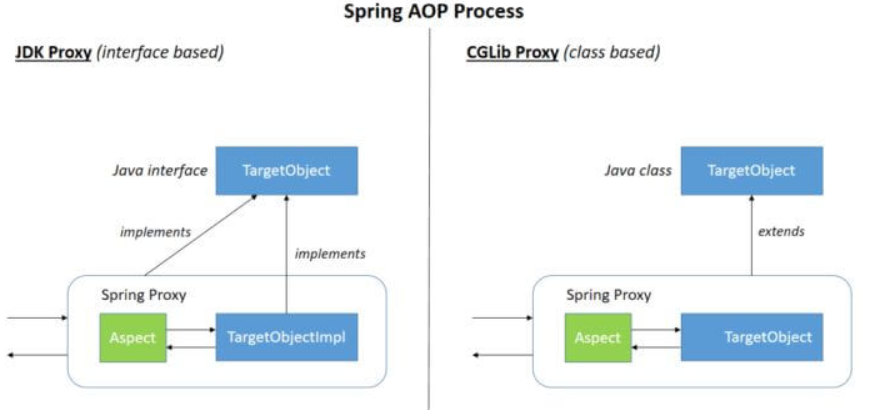
- JDK 动态代理基于接口,是 JDK
官方的,它要求被代理的类必须实现接口,持有目标对象引用,JDK
动态代理在运行时通过
Proxy.newProxyInstance()生成代理对象,调用方法时通过InvocationHandler转发到invoke方法中,最终用反射调用目标方法。 - CGLIB
动态代理基于字节码工具,是第三方的,通过继承目标类生成子类来实现代理,不需要接口,但是
final 类和 final
方法因为不能继承的特性没法被动态代理。方法调用时通过
MethodInterceptor拦截,可以用invokeSuper直接调用父类方法,不走反射。
为什么 JDK 动态代理必须要有接口呢?
- JDK 动态代理生成的代理类已经继承了
java.lang.reflect.Proxy这个类,而 Java 不支持多继承,所以只能通过实现接口的方式来代理目标类。代理类和目标类之间唯一的纽带就是共同实现的接口。
JDK 动态代理用
java.lang.reflect.Proxy类和InvocationHandler接口实现
- 通过实现 InvocationHandler 接口得到一个切面类
- 利用 Proxy 根据目标类的类加载器、接口和切面类得到一个代理类
- 代理类把所有接口方法的调用转发到切面类的 invoke() 方法上,然后根据反射调用目标方法
CGLIB 生成的代理类会为每个方法创建两个方法:一个是重写的方法用来拦截调用,一个是
CGLIB$xxx$0这种命名的方法用来调用父类原始方法。Spring AOP 会根据目标类自动选择代理方式,但是 Spring Boot 2.x 之后默认全用 CGLIB,原因是不用强制写接口,开发体验更好。如果想切回 JDK 代理:
- 目标类实现了接口,默认用 JDK 动态代理
- 目标类没有接口,自动切换到 CGLIB
就二者的效率来说,大部分情况都是 JDK 动态代理更优秀,随着 JDK 版本的升级,这个优势更加明显。
介绍一下动态代理在框架中的实际应用场景
动态代理最典型的应用场景就是 Spring AOP。
AOP 能够将那些与业务无关,却为业务模块所共同调用的逻辑或责任(例如事务处理、日志管理、权限控制等)封装起来,便于减少系统的重复代码,降低模块间的耦合度,并有利于未来的可拓展性和可维护性。
Spring AOP 就是基于动态代理的,如果要代理的对象,实现了某个接口,那么 Spring AOP 会使用 JDK Proxy,去创建代理对象,而对于没有实现接口的对象,就无法使用 JDK Proxy 去进行代理了,这时候 Spring AOP 会使用 CGlib 生成一个被代理对象的子类来作为代理,如下图所示:
IO NIO
字节流、字符流、节点流、处理流,到底怎么分?他们分别在什么时候用?包装流(处理流)解决了什么?
Java I/O 流按两个维度划分
- 数据单位:分为字节流和字符流,代表每次读写的是 byte
还是 char
- 字节流:以
InputStream/OutputStream为基类,每次读写 8 位字节。面向原始二进制数据,不关心编码。- 任何非文本或编码无关的场景的使用字节流。例如图片、音频、视频、压缩包、序列化对象、网络原始数据。
- 字符流:以
Reader/Writer为基类,每次读写 16 位字符也就是 char。面向文本数据,内部处理字符编码转换。字符流不能处理二进制数据- 需要按字符处理且关心编码的场景使用字符流,例如纯文本文件、配置文件、日志
- 字节流:以
- 职责:分为节点流和处理流,代表是否直接连接数据源,还是包装其他流
- 节点流:直接连接数据源,是流的端点。
- 使用场景:总是最底层,负责连接数据源,是必需的起点终点。
- 处理流:包装另一个流,在其上添加功能,自身不直接连数据源(装饰器模式)
- 使用场景:在节点流之上按需叠加增强能力
- 节点流:直接连接数据源,是流的端点。
一个流同时具备两个属性。
包装流的核心价值是职责分离 和 功能叠加
- 性能问题:Buffered 系列
- 例如
FileInputStream每次read()都可能触发一次系统调用,逐字节读极慢。BufferedInputStream在内存中维护一个缓冲区,一次系统调用读一大块,后续read()从内存取,大幅减少系统调用次数。
- 例如
- 编码转换(InputStreamReader / OutputStreamWriter)
- 节点流只有字节流,没有带指定编码的字符文件流。例如
InputStreamReader包装字节流,按指定字符集把字节解码成字符,使得编码可控。
- 节点流只有字节流,没有带指定编码的字符文件流。例如
- 格式化输出(PrintWriter / PrintStream)
- 便捷的文本输出,比裸
Writer方便
- 便捷的文本输出,比裸
- 功能组合
- 装饰器模式。每个处理流只加一种能力,可自由组合,例如,缓冲
+ 编码 + 按行读
,就这样写
BufferedReader(InputStreamReader(BufferedInputStream(...)))。开闭原则的典型体现
- 装饰器模式。每个处理流只加一种能力,可自由组合,例如,缓冲
+ 编码 + 按行读
,就这样写
节点流和处理流怎么区分?各举两个例子。缓冲流为什么快?什么时候必须
flush()?
这个流是否直接连接数据源/目的地,节点流直接连接数据源,包装流则包装另一个流
看构造器参数。如果构造器接收的是 文件路径/File/字节数组/socket 等数据源,就是节点流;如果构造器接收的是另一个流对象,就是处理流。
| 字节流 | 字符流 | |
|---|---|---|
| 节点流 | FileInputStream /
FileOutputStream、ByteArrayInputStream |
FileReader /
FileWriter、CharArrayReader |
| 处理流 | BufferedInputStream、DataInputStream、ObjectInputStream |
BufferedReader、InputStreamReader、PrintWriter |
FileInputStream.read()
每调用一次,通常都要陷入内核、触发一次系统调用去读磁盘。
缓冲流内部维护一个字节数组缓冲区,默认 8KB,第一次
read() 时,它一次性从底层流读入一大块填满缓冲区,后续
read()
直接从内存缓冲区取,直到缓冲区取空才再触发一次系统调用读下一块。空间换时间。
flush()
的作用是把缓冲区里尚未写出的数据强制推到底层流或目的地,只有写流才涉及
flush。
必须 flush 的场景
使用缓冲输出流,且需要在关闭前让数据立刻可见
缓冲区攒满才真正写出。如果程序在缓冲区未满时就结束,不 flush 数据就还留在内存里。
网络编程中写完请求必须 flush
不需要手动 flush 的情况:close() 会自动 flush
为什么 NIO 能用少量线程支撑大量连接?NIO 的三大核心组件是什么?
BIO 是一个连接占用一个线程,问题在于,大量连接大部分时间是空闲的,但线程却被占着干等,导致线程数量爆炸、上下文切换开销巨大。
NIO 连接非阻塞,Channel
在没有数据时会立刻返回,不会把线程卡住,而且把所有 Channel 注册到
Selector 上。一个线程调用 selector.select()
阻塞等待,至少有一个 Channel
有事件发生才返回。线程被唤醒后,只拿到那些已经就绪的 Channel
进行处理。
这样,线程数与连接数解耦了。几万连接可以只用几个 Selector 线程来管理 I/O 事件
NIO 的运作围绕三个组件展开:Channel(通道)、Buffer(缓冲区)、Selector(选择器)。
- Channel 是对传统流的模拟,但它是双向的,例如
FileChannel/SocketChannel/ServerSocketChannel - 在 NIO 中,所有数据的读写都必须经过 Buffer,Buffer
是用于盛放数据的容器。常用的有
ByteBuffer、CharBuffer、IntBuffer等。 - 一个 Selector 可以管理多个 Channel。当 Channel 注册到 Selector
上并指定感兴趣的事件后,Selector 就能在单线程下监听这些
Channel,并在事件就绪时返回对应的
SelectionKey集合,供线程处理。
AutoCloseable 和 Closeable 有什么区别?
| 维度 | AutoCloseable |
Closeable |
|---|---|---|
| 所在包 | java.lang |
java.io |
| 引入版本 | JDK 7 | JDK 5 |
close() 声明异常 |
throws Exception(更宽泛) |
throws IOException(更具体) |
| 设计定位 | 通用资源释放(事务、内存管理等) | 专用于 I/O 流 |
| 是否要求幂等 | 不要求,但强烈建议实现为幂等 | 要求:重复调用 close()
必须无副作用 |
| 与 try-with-resources 关系 | 是其管理资源的最小契约 | Closeable 继承自 AutoCloseable,是
AutoCloseable 的子接口,自然支持 |
SPI
何为 SPI?SPI 和 API 有什么区别?Java SPI 的缺点有哪些?如何解决?
SPI 即 Service Provider Interface,服务提供者接口,是 Java 提供的一种服务发现机制
SPI 定义接口标准,然后由第三方进行对应实现,之后程序自动加载实现类 的模式,核心目的是解耦接口定义和具体实现,让框架 / 程序能灵活替换不同的实现方案。
- 接口由调用方(框架 / 核心程序)定义:调用方不关心实现细节,只约定接口标准;
- 实现由第三方(服务提供者)开发:比如 JDBC 定义了
java.sql.Driver接口,具体的 MySQL、Oracle 驱动是第三方实现; - 通过配置文件自动加载实现类:Java SPI 要求在
META-INF/services/目录下创建 接口全限定名 的文件,文件内容是实现类的全限定名,程序通过ServiceLoader自动加载这些实现类。
那 SPI 和 API 有啥区别?从广义上来说它们都属于接口,而且很容易混淆。
一般模块之间都是通过接口进行通讯,因此我们在服务调用方和服务提供者之间引入一个 接口。
- 当实现方提供了接口和实现,我们可以通过调用实现方的接口从而拥有实现方给我们提供的能力,这就是 API。接口和实现都是放在实现方的包中。调用方通过接口调用实现方的功能,而不需要关心具体的实现细节。
- 当接口存在于调用方这边时,这就是 SPI。由服务调用方确定接口规则,然后由不同的厂商根据这个规则对这个接口进行实现,从而提供服务。
那么,Java 自己的 SPI 机制其实也有很多问题
- 无法按需加载:
ServiceLoader会一次性加载所有实现类,即使不需要也会初始化,浪费资源; - 线程不安全:当多个
ServiceLoader同时load时,会有并发问题。 - 不支持懒加载:实现类会被立即实例化,无法延迟加载;
- 异常处理差:加载过程中抛出的异常会被吞掉,仅打印日志,难以排查;
- 不支持优先级:无法指定实现类的加载顺序。
你在项目中用过 SPI 吗?Spring 的 SPI 机制是怎样的?Dubbo SPI 和 Java 原生 SPI 有什么区别?
首先,在项目中使用 SPI 是很常见的
就例如,在xxx项目管理平台的认证模块开发时,针对多种 OAuth2 三方登录的情况,我基于 SPI 思想设计了统一的认证接口,将不同认证方式的组织起来,先定义 OAuth2 的核心顶级接口,为每种登录方式开发对应的实现类,通过自定义 SPI 加载器扫描实现类并自动注册,后续增加新的三方登录方式的时候,仅需新增实现类无需修改核心认证逻辑,符合开闭原则
而 Spring 没有直接用 Java 原生 SPI,而是实现了自己的 SPI 机制,是 Spring Boot 自动配置,Starter 生态的支撑
- 核心配置文件:
META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports - 加载方式:通过
SpringFactoriesLoader加载配置文件中的全限定名,解析出类名后通过反射实例化,实现自动配置
Spring Boot 的 @EnableAutoConfiguration 就是基于 SPI
实现,扫描所有 Starter 中声明了 AutoConfiguration
的自动配置类,结合@Conditional系列注解做判断,仅加载项目中实际需要的配置类
而 Dubbo 作为高性能的 RPC 框架,在 Java 原生 SPI 基础上做了增强优化,解决了原生 SPI 的诸多痛点
- 按需加载 + 懒加载:Java 原生 SPI
加载
ServiceLoader时会一次性实例化所有实现类,即使项目中不需要也会初始化,造成资源浪费;而 Dubbo SPI 可通过实现类名精准加载,且只有调用实现类方法时才会实例化来实现懒加载 - 自适应扩展
@Adaptive:Dubbo 的核心特性,可根据调用参数动态选择实现类,无需手动指定。 - 自动激活
@Activate:支持根据分组、参数自动激活实现类,适用于过滤器、拦截器场景。 - 默认实现指定:通过
@SPI注解可为接口指定默认实现
JDK 新特性
Java 8 中引入的 Stream 了解吗?Stream 流的并行API是什么?
Java 8 引入了 Stream API,它提供了一种高效且易于使用的数据处理方式,特别适合集合对象的操作,如过滤、映射、排序等。
Stream API 不仅可以提高代码的可读性和简洁性,还能利用多核处理器的优势进行并行处理。
对于 Stream 流的并行 API,是
ParallelStream,将源数据分为多个子流对象进行多线程操作,然后将处理的结果再汇总为一个流对象,底层是使用通用的
fork/join 池来实现,即将一个任务拆分成多个 小任务
并行计算,再把多个 小任务 的结果合并成总的计算结果
1 | // 没有 Stream API 的做法 |
Stream串行流与并行流的主要区别
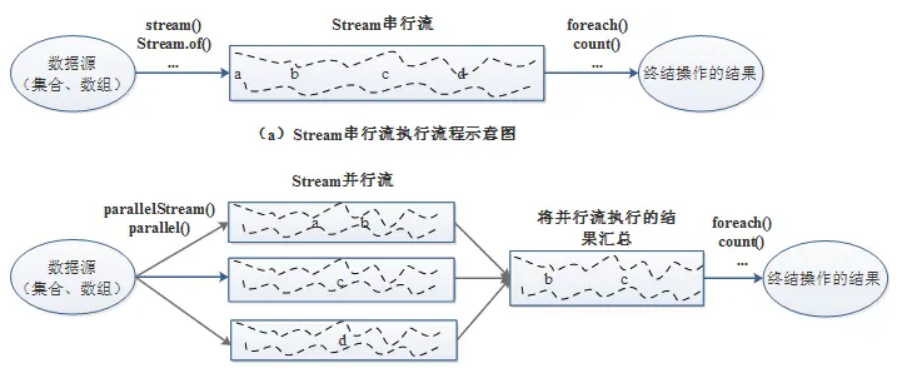
对CPU密集型的任务来说,并行流使用ForkJoinPool线程池,为每个
CPU 分配一个任务,这是非常有效率的,但是如果任务不是 CPU 密集的,而是
I/O 密集的,并且任务数相对线程数比较大,那么直接用
ParallelStream 并不是很好的选择
Stream
为什么只能消费一次?并行流底层用什么线程池?什么场景不该用?Collectors.toMap
有哪些问题,为什么会 NPE?
Stream 为什么只能消费一次
Stream 不是集合,它不存储数据,只是对数据源的一层“流水线”描述:一个源 + 一串中间操作(lazy)+ 一个终结操作。
它内部维护着遍历状态(Spliterator
的当前位置、AbstractPipeline 的
linkedOrConsumed
标志)。终结操作会消耗掉数据源,执行完后 pipeline
被标记为已消费,再执行任何终结操作都会抛:
1 | Stream<String> stream = list.stream(); |
设计成一次性的原因
- 惰性求值 + 流水线融合:中间操作不立即执行,终结操作时元素逐个走完整条链,天然只适合“流过一次”。
- 支持短路和并行:
findFirst、anyMatch需要提前终止,不能像集合那样反复遍历。 - 鼓励无副作用:一次性消费从模型上避免了反复处理同一数据源、避免了隐式状态。
要多次使用,就重新 list.stream(),或者先
collect 成集合再复用。Stream
只做转换和聚合,不会修改源数据。
并行流底层用什么线程池
parallelStream() / stream().parallel()
底层用 ForkJoinPool.commonPool(),即整个
JVM 共享的公共 ForkJoinPool,并行度默认为 CPU
核心数 - 1(至少 1)。
核心机制是 Fork/Join:Spliterator
把数据源递归拆成子任务,ForkJoinWorkerThread
用工作窃取(work-stealing)执行。
调整并行度
1 | # 全局修改 commonPool 并行度 |
1 | // 或者把任务提交到自定义 ForkJoinPool 里执行 |
commonPool是全局共享的:如果里面有 I/O 阻塞或长任务,会占满线程,拖慢同一个 JVM 里所有使用commonPool的代码(包括CompletableFuture的默认线程池)。
什么场景不该用并行流
| 场景 | 原因 |
|---|---|
| 数据量小(一般少于 1 万) | 拆分 / 合并 / 线程调度开销大于计算收益 |
| I/O 密集、有阻塞 | 占用 commonPool
线程,吞吐反而下降;该用虚拟线程或异步 |
| 有共享可变状态(非线程安全集合、外部变量累加) | 数据竞争,结果错误 |
| 依赖顺序 | forEach 不保证顺序;forEachOrdered
又会抵消并行收益 |
| 单次任务耗时差异大 | 工作窃取负载不均,长尾拖慢整体 |
| 需要调试 / 追踪 | 并行栈复杂,问题难复现 |
- 任务能无副作用地拆分、数据量大、CPU 密集、拆分成本低,才适合并行流。
Collectors.toMap 有哪些问题,为什么会
NPE
toMap 内部大致是
map.merge(key, value, mergeFunction),问题都出在这里:
key 重复:没有传 merge 函数时,
merge用默认的throwingMerger,抛IllegalStateException: Duplicate key ...。解决:1
.collect(Collectors.toMap(Item::getId, Item::getName, (a, b) -> a));
value 为 null → NPE(最常见):
HashMap.merge要求 value 非 null,会执行Objects.requireNonNull(value)直接抛 NPE。1
2
3Map<String, String> map = list.stream()
.collect(Collectors.toMap(Item::getId, Item::getName));
// 只要某个 Item.getName() 返回 null,就抛 NullPointerException解决:先
filter(i -> i.getName() != null);或改成forEach手动put(HashMap允许 null value);或改用groupingBy。key 为 null:
toMap依赖Map.merge,对 null key 的行为依赖具体 Map 实现,并行合并时更容易出问题,建议过滤。顺序丢失:默认收集到
HashMap,需要顺序就传LinkedHashMap::new:1
.collect(Collectors.toMap(Item::getId, Item::getName, (a, b) -> a, LinkedHashMap::new));
并行流下的合并:并行时
combiner会不断合并子 Map,key 冲突同样走 merge 函数,若 merge 函数返回 null 也会 NPE / 丢数据。
结论:用
toMap时永远显式考虑三件事:key 是否唯一、value 是否可能为 null、是否需要顺序;不满足就换groupingBy或手写循环。
JDK 8 之后接口有默认方法了,还需要抽象类吗?抽象类和接口在语法、设计动机上的区别是什么?JDK 8/9 给接口加了什么能力?接口里的字段和方法默认是什么修饰符?
JDK 8 引入默认方法后,抽象类依然必要,因为接口的默认方法只能提供行为,无法承载实例状态。
默认方法的设计初衷是为了接口演化。让库作者能在不破坏现有实现类的前提下,向已发布的接口添加方法。它解决的是“行为兼容”问题,而不是“状态复用”问题。
如果你需要一个既能定义契约、又能持有实例状态(如成员变量)、还能提供部分通用实现让子类复用的基类,抽象类是唯一的选择。
从设计动机看,接口表达 “能做什么”(like-a),抽象类表达 “是什么”(is-a)。一个类可以 implements 多个接口,但只能 extends 一个抽象类,这也决定了抽象类更适合承载核心身份与共享状态。
| 维度 | 抽象类 | 接口 |
|---|---|---|
| 构造器 | 有 | 不能有 |
| 成员变量 | 各种修饰符均可 | 只能 public static final 常量 |
| 方法 | 任意访问修饰符 | 方法默认 public(JDK 9 起可有
private) |
| 实例字段 | 不能有(字段隐式为 public static final) |
可以有任意实例字段 |
| 继承 | 单继承类 | 多实现,接口可多继承接口 |
对于接口,JDK 8 新增:
- 默认方法(
default):提供有方法体的实现,实现类可直接继承或重写,用于接口演化。 - 静态方法(
static):只能通过接口名调用,不被实现类继承,也不能被重写。
JDK 9 新增:
- 私有方法(
private):允许在接口中定义私有方法(包括私有静态方法),用于在多个默认方法/静态方法之间复用代码,同时不对外暴露。
接口里字段和方法默认修饰符
- 字段:隐式为
public static final,不允许其他修饰符。 - 方法:
- JDK 8 之前:隐式为
public abstract。 - JDK 8 起:普通抽象方法仍是
public abstract;default方法和static方法隐式为public; - JDK 9 起:可以显式声明
private方法,但抽象方法、默认方法、静态方法对外可见时仍是public
- JDK 8 之前:隐式为
Lambda 表达式在底层是怎么实现的?和匿名内部类有什么区别?方法引用和 Lambda 又是什么关系?
底层实现:invokedynamic +
LambdaMetafactory
Lambda 在字节码层面不是匿名内部类,而是用
invokedynamic 指令实现 —— 这是 JDK 7 引入的机制,JDK 8 为了
Lambda 大规模使用。
javac 编译时做两件事:
- 把 Lambda
体抽取成当前类中的一个私有合成方法(名字类似
lambda$main$0),Lambda 的逻辑实际在这个方法里; - 在原来 Lambda 表达式的位置生成一条
invokedynamic指令,指向启动方法(BootstrapMethod)LambdaMetafactory.metafactory,并把“要实现的函数式接口、接口方法签名、合成方法的方法句柄”作为静态参数传进去。
运行时第一次执行到这条指令时,JVM 调用 LambdaMetafactory
动态生成一个实现该函数式接口的类(早期用 MethodHandle
生成字节码,后来的版本用隐藏类 /
LambdaForm),把调用点(CallSite)链接好,之后再调用就直接走已链接的
CallSite。
用 javap -p -c 类名 可以验证:能看到
lambda$... 合成方法和 invokedynamic
指令,但看不到 Outer$1.class
这样的匿名内部类文件。
和匿名内部类的区别
| 维度 | Lambda | 匿名内部类 |
|---|---|---|
| 字节码产物 | 一条 invokedynamic + 一个私有合成方法 |
编译期生成独立的 Outer$1.class 类文件 |
| 对象创建 | 无捕获的 Lambda 由 CallSite
缓存,通常只创建一次(近似单例);有捕获的每次捕获时创建 |
每次执行 new 都创建一个新对象 |
this 语义 |
Lambda 没有自己的 this,this
指外围实例 |
this 指匿名类自身 |
| 变量捕获 | 只能捕获 effectively final 的局部变量 / 参数 | 同样只能捕获 final / effectively final 的局部变量,但可访问外部类成员 |
| 命名冲突 | Lambda 参数不能与外层局部变量同名(同一作用域) | 内部类方法内的局部变量可以和外层同名 |
| 能力 | 只能实现函数式接口(一个抽象方法) | 可实现任意接口或继承类,可有多个方法、字段、构造器、初始化块 |
| 性能 | 首次链接有开销,之后接近直接调用;类加载压力小 | 每次 new 有对象分配开销;类文件多 |
| 序列化 | 需函数式接口继承
Serializable,行为依赖实现,不推荐 |
匿名类可实现 Serializable |
一句话:Lambda 是“函数”的语法糖,匿名内部类是“类”的语法糖。优先用 Lambda;需要多方法、状态、自定义构造时再退回匿名内部类。
方法引用和 Lambda 的关系
方法引用 :: 本质上是 Lambda
的一种更简洁写法:当 Lambda
体只是转调一个已存在的方法(没有额外逻辑)时,就可以改写成方法引用。两者语义完全等价,字节码同样经由
invokedynamic 实现。
| 形式 | 示例 | 等价 Lambda |
|---|---|---|
| 静态方法引用 | Integer::parseInt |
s -> Integer.parseInt(s) |
| 特定对象的实例方法 | System.out::println |
x -> System.out.println(x) |
| 任意对象的实例方法 | String::length |
s -> s.length()(第一个参数作为接收者) |
| 构造器引用 | ArrayList::new |
() -> new ArrayList<>()(或
n -> new ArrayList<>(n)) |
| 数组构造器引用 | int[]::new |
n -> new int[n] |
不能改写的情况:Lambda 体有额外逻辑、有多条语句、需要调整参数顺序。所以方法引用不是必须的,只是可读性优化。
1 | List<String> names = list.stream() |
Optional
的设计目的是什么?orElse 和 orElseGet
有什么区别,为什么会多查一次数据库??哪些场景不该用 Optional?
设计目的
Optional<T> 是 JDK 8
引入的容器,用来在类型层面显式表达“可能没有值”,把 返回
null 这种隐式约定变成 API 契约的一部分,迫使调用方正视 空
的情况,从而减少 NPE。
它最大的价值在返回值语义:Optional<User> findById(Long id)
从签名就告诉调用方可能查不到
常用 API
1 | Optional<User> opt = Optional.ofNullable(userMapper.selectById(id)); |
orElse 和 orElseGet
的区别
orElse(T other) |
orElseGet(Supplier<? extends T> supplier) |
|
|---|---|---|
| 参数求值时机 | 立即求值:调用 orElse
时,参数表达式已经算完了 |
惰性求值:只有 Optional 为空时才调用
supplier.get() |
| 适用场景 | 默认值是常量 / 已有对象,计算成本极低 | 默认值需要计算、查库、远程调用、创建大对象 |
1 | // ❌ 多查一次数据库 |
“为什么会多查一次数据库”:orElse
的参数是普通方法调用,Java
是先求值实参、再调用方法,所以
userMapper.selectByName(...) 在进入 orElse
之前就已经执行了。orElseGet 接收的是
Supplier,查库逻辑被包进 Lambda,只有 optional
为空时才会 get()。
同理,
orElse(expensiveCreate())还可能带来副作用(插入数据、发消息),这类场景必须用orElseGet。反过来,orElse(null)、orElse("")这种常量没有区别,用哪个都行。
其他常见 API 与问题
Optional.of(x):x为 null 直接 NPE,确认非空才用;可能为空用ofNullable。Optional.empty():显式空。get():为空抛NoSuchElementException,不要裸调get(),那等于把 NPE 换成了另一个异常。orElseThrow():推荐,并应带上业务异常信息。ifPresentOrElse(JDK 9):有值 / 无值分别处理。stream()(JDK 9):Optional转Stream,方便扁平化。Optional不实现Serializable,不能作为需要序列化的字段。
哪些场景不该用 Optional
- 方法参数:
void f(Optional<String> x)会让调用方被迫Optional.of/empty包装,反而更啰嗦;参数可空用重载或明确约定。 - 字段 / 成员变量:
Optional不实现Serializable,还给每个对象增加一层包装;规范建议只用于返回值。实体 / DTO 用普通引用。 - 集合元素:
List<Optional<T>>没有意义;集合为空就返回空集合,不要返回Optional<List<T>>。 - 基本类型:用
OptionalInt/OptionalLong/OptionalDouble或哨兵值,避免装箱。 - 性能敏感的热点路径:每次都要分配
Optional对象。 - 返回值必然存在:直接返回对象,别包
Optional。 - 用
Optional写成if (opt.isPresent()) { ... }的连续判断,可读性往往还不如直接判空。
最佳实践:只在返回值用
Optional,用orElseGet/orElseThrow收口,不要get(),不要嵌套Optional<Optional<T>>。
介绍 record、sealed class、模式匹配和虚拟线程,并说明各自解决了什么问题。
record:不可变数据的语法糖
是什么:record
是一种不可变的数据载体,用来声明“一组字段 + 构造器 +
访问器 + equals/hashCode/toString”这种纯数据类。
1 | public record Point(int x, int y) { } |
编译器自动生成了什么
- 每个组件对应的
private final字段(x、y); - 规范构造器(canonical constructor),参数与组件一一对应;
- 与组件同名的访问器方法
x()、y()(不是getX()); equals()、hashCode()、toString();- 类本身被隐式声明为
final,并隐式extends java.lang.Record。
注意:record 不会自动实现
Serializable,需要自己
implements Serializable。
能继承吗
- 不能被继承:record 是隐式
final的。 - 不能继承别的类:它已经隐式继承
java.lang.Record,而 Java 是单继承。 - 可以实现接口,可以被
sealed限制,也可以嵌套定义。 - 不能声明实例字段(只能有
static字段);可以声明额外方法、静态方法、静态字段。 - 可以通过紧凑构造器(compact constructor)做参数校验,字段赋值由编译器自动完成。
1 | public record Range(int from, int to) { |
适用 / 不适用:适合 DTO、值对象、方法多返回值、模式匹配的载体;不适合需要可变状态(如 JPA 实体)、字段特别多、需要继承的类。
常被拿来和 Lombok
@Data对比:record 是语言级支持,不可变、没有 setter,语义更严格;Lombok 则是在编译期改 AST。
sealed:可控的继承体系
作用:sealed(密封)用来限定一个类
/
接口只允许指定的子类型继承,把继承体系封闭起来,让编译器掌握“所有可能的子类”。
1 | public sealed interface Shape permits Circle, Square, Triangle { } |
子类有什么限制
每个被 permits
列出的直接子类,必须显式声明为下面三者之一:
final:不再被继承;sealed:继续密封,并继续permits;non-sealed:重新开放继承(可以再被任意类继承)。
其他规则
- 子类必须和 sealed 类在同一个模块里(未命名模块则要求同一个包)。
- 如果所有子类都和父类写在同一个编译单元(同一个
.java文件)里,permits子句可以省略。 sealed不能和final同时用(语义冲突);sealed 类本身可以是abstract的。- 反射可以查:
Class.isSealed()、Class.getPermittedSubclasses()。
解决什么问题:没有 sealed
时,任何人都能扩展你的接口,编译器无法穷尽所有子类型,只能靠
default 兜底。sealed 之后,switch
可以做穷尽性检查:漏掉一种子类直接编译报错,新增子类时所有相关
switch 都会提醒你改。这就是“代数数据类型(ADT)”在 Java
里的落地方式。
模式匹配
1. instanceof 模式(JDK 16 正式)
1 | // 以前 |
变量 s
的作用域是流作用域:只有编译器能确定匹配成功的地方才可见,所以可以写在
&& 右边:
1 | if (obj instanceof String s && s.length() > 5) { ... } |
2. switch 模式匹配(JDK 21 正式)
1 | static double area(Shape shape) { |
支持的能力
- 类型模式:
case Integer i -> ...; - 守卫条件
when:case String s when s.length() > 10 -> ...; null分支:case null -> ...(选择器为 null 且没有case null时仍抛 NPE);- 记录解构模式(JDK
21):
case Point(int x, int y) -> x + y;,可以嵌套,直接拆出 record 的组件; - 多个模式合并:
case Circle c, Square s -> ...。
1 | static double distance(Object obj) { |
解决什么问题:消除“判断类型再强转”的样板和漏判风险;配合 sealed 获得编译期穷尽性;很多时候可以替代笨重的访问者模式(Visitor)。
虚拟线程:轻量级线程
和平台线程的区别
| 维度 | 平台线程(Platform Thread) | 虚拟线程(Virtual Thread) |
|---|---|---|
| 映射关系 | 1:1 映射到 OS 线程 | M:N,由 JVM 调度到少量载体线程(carrier)上 |
| 创建成本 | 高(MB 级栈、内核对象) | 极低(栈在堆上、按需增长,KB 级) |
| 数量上限 | 几千到几万就吃紧 | 百万级可行 |
| 阻塞行为 | 阻塞时占住 OS 线程 | 阻塞时 unmount,让出载体线程 |
| 调度 | 操作系统 | JVM(默认 ForkJoinPool) |
| 适用场景 | CPU 密集、需要线程本地状态 | I/O 密集、大量并发请求 |
为什么不能池化
- 虚拟线程创建和销毁极便宜,设计模型就是“一个任务一个虚拟线程,用完即弃”,池化省下的开销可以忽略。
- 池化的本质是限制并发数量、复用昂贵资源。虚拟线程的昂贵资源(载体线程)由 JVM 自己管理,不需要你池化。
- 池化反而会把并发数人为压回平台线程的量级,让请求排队,失去虚拟线程的意义,还可能引入死锁风险。
- 正确写法:
1 | try (var executor = Executors.newVirtualThreadPerTaskExecutor()) { |
注意:虚拟线程不适合 CPU
密集任务(不会比平台线程快);不要用 ThreadLocal
存大对象(每个虚拟线程一份);Thread.setPriority
对虚拟线程不生效,Thread.stop 等废弃 API 会抛
UnsupportedOperationException。
结构化并发与 ScopedValue(配套的并发工具)
虚拟线程解决了线程太贵的问题,但任务的生命周期管理和请求上下文传递还需要配套工具:
- 结构化并发(
StructuredTaskScope,JDK 21 起预览):把一组子任务当成一个整体,父任务要么等所有子任务成功,要么统一取消,避免线程泄漏、取消丢失。 ScopedValue(JDK 25 正式):不可变的、带作用域的上下文值,用来替代ThreadLocal传递请求上下文。
1 | static final ScopedValue<User> CURRENT_USER = ScopedValue.newInstance(); |
以下是一些关于上述内容的小问题
record是什么?编译器生成了什么?能继承吗?- 不可变数据载体。编译器生成
private final字段、规范构造器、同名访问器、equals/hashCode/toString;类隐式final且继承java.lang.Record。不能被继承,也不能继承其他类,但可以实现接口。
- 不可变数据载体。编译器生成
sealed的作用是什么?子类有什么限制?- 限定只有
permits列出的类型能继承,从而让编译器掌握完整的子类型集合(支持 switch 穷尽检查)。子类必须是final、sealed或non-sealed,且与父类同模块(未命名模块同包)。
- 限定只有
- 虚拟线程和平台线程的区别?为什么不能池化?
- 平台线程 1:1 映射 OS 线程、昂贵;虚拟线程由 JVM 以 M:N 调度到载体线程,栈在堆上,可百万级。因为创建极廉价且阻塞时自动让出载体线程,池化只会限制并发、引入排队,没有收益。
- 什么是 pinning?
synchronized会 pin 吗?- pinning
指虚拟线程阻塞时无法从载体线程上卸载,导致载体线程被长时间占住,吞吐下降。JDK
21~23 中,在
synchronized块 / 方法里阻塞会 pin;JDK 24(JEP 491)起已消除synchronized造成的 pinning,旧版本可改用ReentrantLock。native 方法、FFM 调用等仍可能 pin。检测方式:-Djdk.tracePinnedThreads或 JFR 事件jdk.VirtualThreadPinned。
- pinning
指虚拟线程阻塞时无法从载体线程上卸载,导致载体线程被长时间占住,吞吐下降。JDK
21~23 中,在
ScopedValue和ThreadLocal有什么区别?ThreadLocal是可变的、每个线程一份副本、需要手动remove()防泄漏,InheritableThreadLocal还会复制到子线程;虚拟线程数量巨大时副本开销和泄漏风险更明显。ScopedValue是不可变的、有明确作用域(ScopedValue.where(KEY, value).run(...),离开作用域自动失效),不需要 remove,天然无泄漏;结构化并发(StructuredTaskScope)的子任务可以继承绑定。适合“请求上下文”这类只读传递。