前言
上一篇我们解决了三个问题,Netty 是什么,为什么要有它,最小的 Netty 程序长什么样。
Echo 只验证了网络通信中的能收能发。真实项目里,麻烦往往出在收发之外,连接什么时候算真正建立,什么时候该清理会话状态,回调为什么总在同一个线程,某个 Handler 卡了一下为什么所有连接都跟着变慢,写给客户端的数据为什么悄悄失败了,异常为什么没有人处理。
我们继续沿着一条连接往下看,先看它从建立到关闭经历了哪些状态和回调,再看这些回调由谁执行,然后讨论怎么在不破坏线程模型的前提下做耗时操作,最后落到 Pipeline、Handler 共享、Channel 配置和异步结果这些日常使用最频繁的机制上。
读完应该能回答下面这些问题:
| 问题 | 对应小节 | 对应实验 |
|---|---|---|
| 一条连接从建立到关闭,各回调按什么顺序触发 | 单连接的生命周期 | LifecycleServer(9002) |
| 父 Channel 和子 Channel 是什么关系 | 单连接的生命周期 | LifecycleServer 的 accept 日志 |
| 回调线程为什么总是同一个,多个连接怎么分配线程 | 事件线程 | ThreadModelServer(9003) |
| 定时任务、跨线程任务在哪里执行 | 事件线程 / 任务调度 | TaskSchedulingDemo |
在 Handler 里 sleep 会发生什么,怎么改 |
把耗时任务移出 EventLoop | BlockingServer 与
OffloadServer(9003) |
入站和出站为什么方向相反,ctx.write 和
channel.write 差在哪 |
ChannelPipeline | PipelineServer(9004) |
| Handler 能不能被多个连接共享 | @Sharable |
SharableDemo |
option 和 childOption
有什么区别,AUTO_READ 怎么用 |
ChannelOption 与 ChannelConfig | ChannelConfigDemo |
| 异步操作的结果怎么拿,监听器在哪个线程跑 | ChannelFuture 与 ChannelPromise | FuturePromiseDemo |
单连接的生命周期
Netty 里的一条连接,从生到死有一组明确的状态和回调。
从注册到注销的状态机
Channel
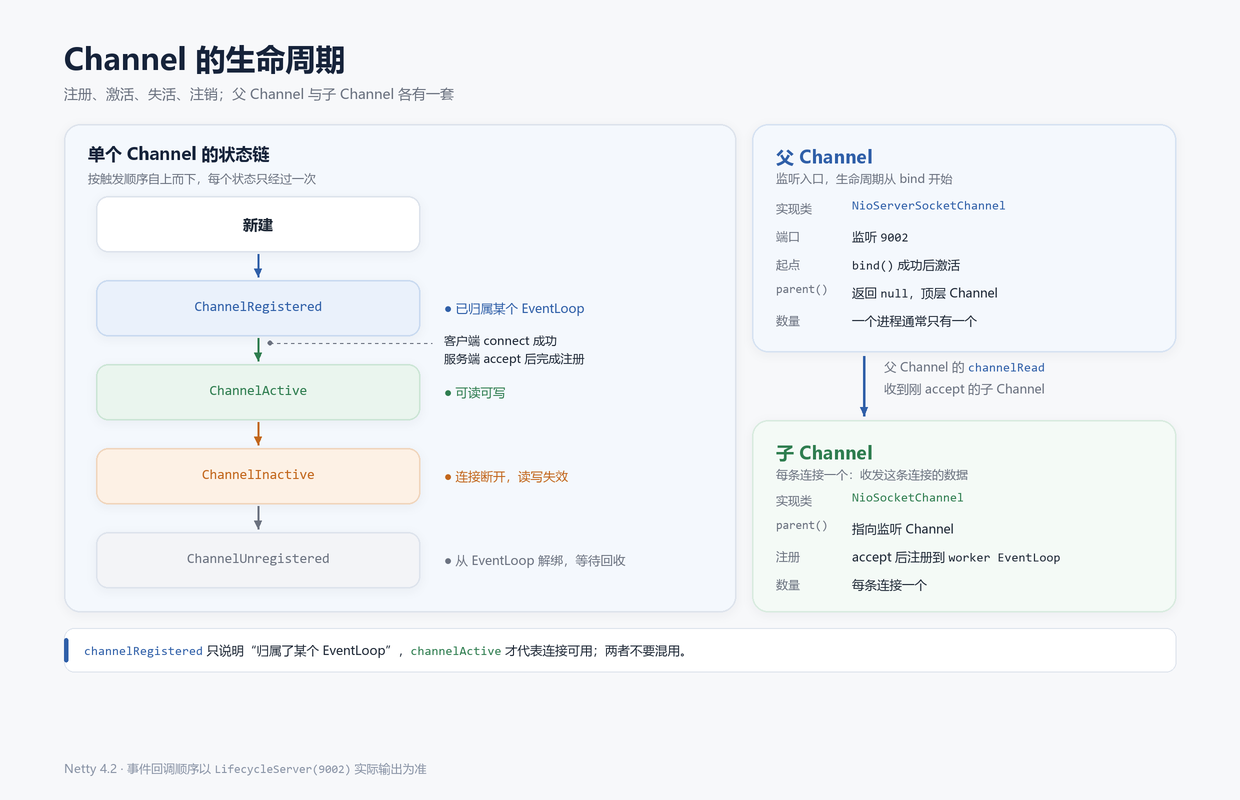
接口本身只暴露了几个布尔方法:isOpen()、isRegistered()、isActive()。它们对应四个生命周期事件:
| 事件回调 | 含义 | 触发时机 |
|---|---|---|
channelRegistered |
Channel 已注册到某个 EventLoop |
注册完成,归属确定 |
channelActive |
Channel 已激活,可以读写 | 客户端握手成功;服务端 accept 并注册完成 |
channelInactive |
Channel 已失活,读写通道关闭 | 对端关闭、本地 close、连接异常 |
channelUnregistered |
Channel 已从 EventLoop 注销 |
关闭流程的最后一步 |
状态是单向推进的:
1 | 新建 |
这四个事件的实际触发顺序可以在 AbstractChannel
的注册和关闭流程里看到:注册时先补发 handlerAdded,再
fireChannelRegistered、fireChannelActive;关闭时先
fireChannelInactive,再
fireChannelUnregistered(Netty
4.2.17 源码)。
这里最容易混淆的是 channelRegistered 和
channelActive。注册只说明这个 Channel 已经归属某个
EventLoop,不代表 TCP 连接已经建立好。客户端在 connect()
发出后、握手完成前,就已经注册了;服务端 accept 出来的子
Channel,也是先注册到 worker EventLoop,再触发
channelActive。所以涉及网络读写的动作要等
channelActive,不能放在 channelRegistered
里做。
父 Channel 与子 Channel
上一篇讲 Socket 时提过,accept() 返回一个全新的
Socket,原来的监听 Socket 继续等待下一个连接。Netty
保留了同样的结构,只是把它抽象成两套 Channel。
| 父 Channel | 子 Channel | |
|---|---|---|
| 实现类 | NioServerSocketChannel |
NioSocketChannel |
| 数量 | 一个进程通常一个 | 每条连接一个 |
| 生命周期起点 | bind() 成功后激活 |
accept 并注册后激活 |
| 绑定线程 | bossGroup 的 EventLoop | workerGroup 的 EventLoop |
parent() |
null |
指向监听 Channel |
| 用途 | 监听端口、accept | 收发这条连接的数据 |
服务端启动时,ServerBootstrap 会创建监听 Channel
并注册到 bossGroup。这个 Channel 也走完整的生命周期:bind
成功后
channelRegistered、channelActive。之后每
accept 一个连接,就创建一个子 Channel,注册到 workerGroup 的某个
EventLoop,再触发子 Channel 的
channelRegistered、channelActive。
父 Channel 的 channelRead 收到的消息不是业务数据,而是刚
accept 出来的子 Channel。这也是为什么父 Channel 的 Pipeline
通常只放日志、限流、连接统计这类 Handler,业务 Handler 要挂在
childHandler 里。
父子关系还带来一个容易忽略的事实,父 Channel
关闭只表示不再接受新连接,已经建立的子连接不会自动关闭。要主动关掉它们,得自己维护一个集合,或者使用
ChannelGroup。
关闭是一条链
close() 是异步操作,返回
ChannelFuture。真正的关闭流程在 EventLoop
线程里执行,顺序是:
1 | 调用 close() |
channelInactive是清理业务状态的可靠位置。会话表、在线列表、定时任务、待回复请求都应该在这里收尾。此时 Channel 已经不能读写,但对象还在。channelUnregistered更晚,表示和 EventLoop 解绑。适合做更底层的资源释放,不适合做需要读写的操作。
关闭之后还能不能写?可以调用,但会失败。写操作会返回一个失败的
ChannelFuture,原因通常是
ClosedChannelException。如果代码只看
writeAndFlush
的返回值、不挂监听器,这个失败会被静默吞掉。这一点后面讲 Future
时还会展开。
TCP 还有半关闭的情况。默认情况下,对端发来 FIN 后,Netty
会关闭这条连接的读端,并最终关闭整个 Channel。如果开启了
ChannelOption.ALLOW_HALF_CLOSURE,收到 FIN
只会关闭读方向,写方向还保留,同时会触发一个
ChannelInputShutdownEvent
用户事件。大部分业务不需要半关闭,半关闭可能带来难以预料的问题,知道有这个选项即可。
三个容易错的点
channelRead和channelReadComplete不是一一对应。一次读循环可能读到多条消息,channelRead被调用多次,然后channelReadComplete调用一次。它表示这一批读事件处理完了,不是一条消息处理完了。exceptionCaught不会自动关闭连接。如果不覆写,异常会一路传到 Pipeline 末尾,默认行为是记录一条警告。连接是否关闭,要由业务 Handler 自己决定。生产代码里通常是记录日志、按协议回错误、然后关闭。channelInactive之后再写数据没有意义。此时 Socket 已经关闭,写操作必然失败,还会产生一个没人处理的失败 Future。
一次连接过程发生了什么
把上面的顺序落到日志上最直观。
LifecycleServer 监听 9002,LifecycleClient
连上来,依次发送 hello 和 iron man,最后发送
bye 触发关闭。
服务器在父 Channel 的 channelRead 里打印 accept 到的子
Channel,子 Channel 的 Pipeline 里放了一个专门打印生命周期回调的
Handler。
服务端的关键代码是两段:父 Channel 的 Handler,和子 Channel 的初始器。
1 | bootstrap.group(bossGroup, workerGroup) |
父 Channel 的 Handler 只需要收到子 Channel 时打印出来,然后继续往下传。
1 |
|
- 不能在父 Channel 的
channelRead里调用child.eventLoop()。此刻子 Channel 还没有被ServerBootstrapAcceptor注册,调用会抛IllegalStateException: channel not registered to an event loop。父 Channel 能看到的只有子 Channel 的 id 和 parent,EventLoop 归属要等子 Channel 自己channelRegistered之后才知道。
子 Channel 的观察 Handler 把每个回调都打印出来:
1 |
|
日志行里带上了 Channel 短 id、父 Channel 短
id、当前线程、inEventLoop 和远端端口。服务端输出如下:
1 | 15:14:02.389 [nioEventLoopGroup-2-1 ] parent channelActive id=671e8e59 local=/127.0.0.1:9002 thread=nioEventLoopGroup-2-1 |
客户端也装了同一个观察 Handler,输出如下:
1 | 15:14:03.162 [nioEventLoopGroup-2-1 ] client handlerAdded id=68032a33 p=- loop=2-1 inEventLoop=true remote=- |
这段日志解读如下:
- 父 Channel 的 active 和 accept 都发生在 boss 线程
nioEventLoopGroup-2-1;子 Channel 的所有回调发生在 worker 线程nioEventLoopGroup-3-1。父子两个 Channel 属于不同的线程组,这正是主从 Reactor 的分工。 - 父 Channel 打印 accept 时,子 Channel 的
handlerAdded还没发生。accept 只是把子 Channel 交给 worker,注册和装配 Pipeline 是后续步骤。 - 子 Channel 的回调顺序是
handlerAdded → channelRegistered → channelActive → channelRead → channelReadComplete → ... → channelInactive → channelUnregistered。同一个连接的所有回调都在-3-1这个线程上,inEventLoop=true。 hello和iron man相隔不到 200 毫秒发送,服务端却先读到两条channelRead,然后才有一个channelReadComplete。这验证了channelReadComplete的批量语义,它对应的是一批读事件,不是一条消息。- 客户端和服务端是不同 JVM,线程编号各自从 2 开始,所以两边的
nioEventLoopGroup-2-1不是同一个线程。比较线程名只在同一个进程内有意义。 - 客户端日志里
connected出现在channelActive之前,send msg=hello出现在channelActive之后。connect().sync()只保证连接结果返回,channelActive回调是随后在 EventLoop 上触发的,两者没有严格的先后保证;实验代码用CountDownLatch等channelActive之后再发,保证顺序稳定。如果不等待,写入也可能排在channelActive之前(前一次运行就出现过),所以初始化逻辑不能依赖这个顺序。 - 服务端
channelInactive和channelUnregistered只差 1 毫秒,但语义完全不同。前者还能拿到 remote 地址,后者表示已经和 EventLoop 解绑。会话清理放前者,底层资源回收放后者。
用 EmbeddedChannel 验证生命周期
Netty 提供了 EmbeddedChannel,它用一个内嵌的 EventLoop
驱动 Channel,new EmbeddedChannel(...)
时自动完成注册和激活。
1 | EmbeddedChannel channel = new EmbeddedChannel(new Recorder(events)); |
1 | [INFO] Running hbnu.project.nettydemo.demo.core.ChannelLifecycleTest |
EmbeddedChannel 的构造过程会依次触发
handlerAdded、channelRegistered、channelActive,finish()
会触发
channelInactive、channelUnregistered。它适合验证
Handler 的顺序、编解码结果、生命周期回调,不适合验证真实网络时序。
生命周期这条线理清之后,下一个问题自然冒出来。这些回调是谁调用的?为什么同一个连接的每次回调都在同一个线程里?
事件线程
事件线程的机制回答了回调为什么总在同一个线程
Netty 的线程模型可以压缩成一句话,一个 Channel 只绑一个 EventLoop,一个 EventLoop 只用一个线程。
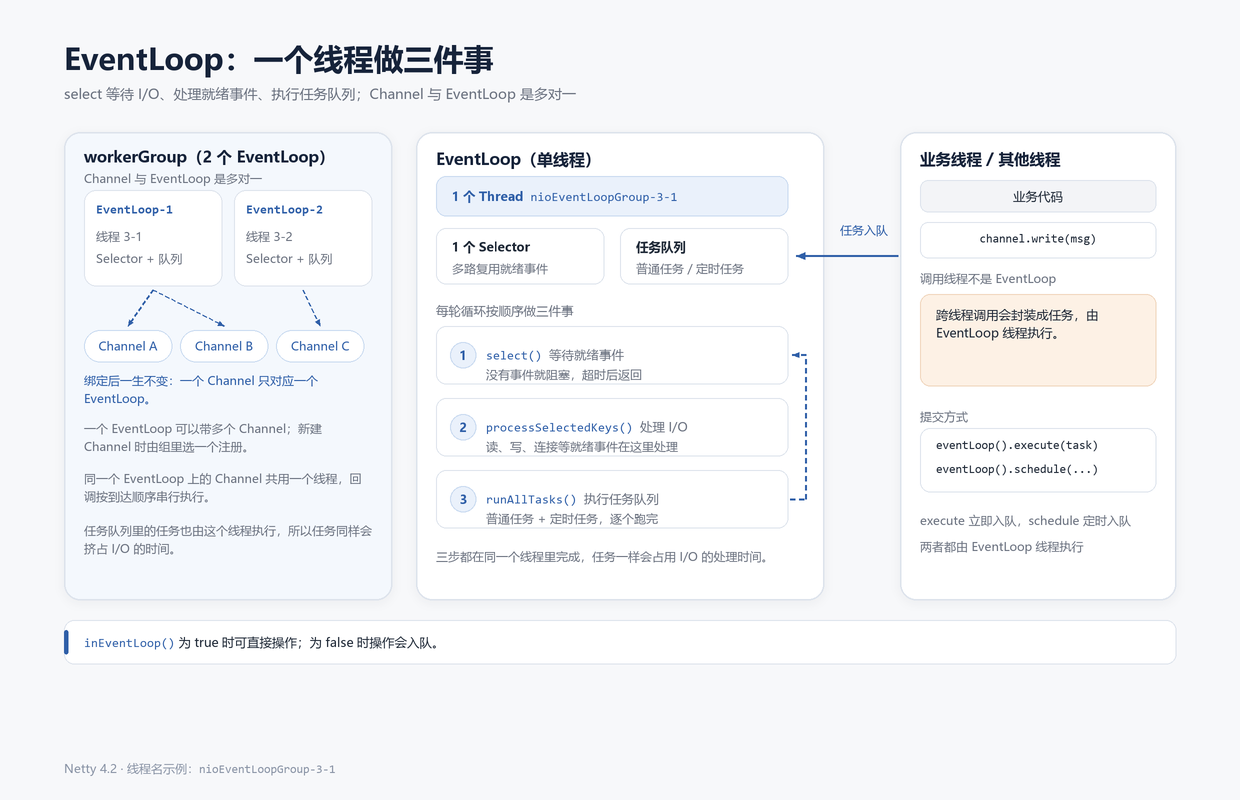
EventLoop 的三件事
EventLoop 既是一个单线程的
EventExecutor,也是一个 EventLoopGroup;它支持
ScheduledExecutorService
定时任务接口。它内部持有一个线程、一个多路复用器(NIO 下是
Selector)和一个任务队列。run()
循环反复做三件事:
1 | while (未关闭) { |
第 1 步是 I/O 等待,第 2 步是 I/O 处理,第 3 步是非 I/O 任务。
第 2 步处理就绪 key 时,触发 Channel 的
Pipeline,也就是一串 ChannelHandler 的
channelRead()、channelActive()
等回调,你写的业务 Handler 就是在这一步被调用的。
所以说 I/O 事件最终会变成 Pipeline 上的回调,任务队列里的任务则是通过
execute()、schedule()
等方式提交进来的,这些任务和 I/O
处理在同一个线程里串行执行。
所以说,EventLoop 就是 Netty 里的一个线程 + 一个
Selector + 一个任务队列。
EventExecutor本质是个单线程执行器,又能当”组”用,你execute(task)提交任务,它保证串行执行。EventLoopGroup是一组 EventLoop 的集合,通常用来管理多个连接。
Netty 4.1 用 ioRatio 控制第 2 步和第 3
步的时间比例,默认 50,也就是尽量平分。4.2
已经移除了这套逻辑,改为按固定时间片执行任务。网上很多关于
ioRatio 的调参结论在 4.2
上已经不适用,这里知道有这么个东西即可。
selector.select() 还有一个历史遗留问题:JDK 的 epoll
在某些情况下没有事件也会立即返回,导致循环空转、CPU 100%。Netty
会统计连续空轮询的次数,超过阈值就重建 Selector,默认阈值是
512,可以通过 io.netty.selectorAutoRebuildThreshold
调整。
线程亲和性
一个 Channel 只绑一个 EventLoop,因此它的所有处理都是单线程串行的
Channel 在注册到 EventLoop 的那一刻,就确定了归属,之后不会再迁移。之后这个 EventLoop 的线程负责它所有的 I/O 事件、解码、业务回调、编码和写回。因为同一连接的所有操作都在同一个线程里串行执行
1 | // 在 Handler 里随时可以确认当前线程 |
用 Channel.eventLoop() 拿到它绑定的 EventLoop,用
inEventLoop() 判断当前线程是不是这个 EventLoop
的线程。这个判断在跨线程操作时非常有用,后面会用它决定是直接执行还是提交任务。跨线程操作会被转化成任务,回到
EventLoop 线程串行执行
inEventLoop()为什么关键Netty 里一个经典套路就是:
2
3
4
5
6
7
8
// 已经在自己的线程里,直接干,零开销
doSomething();
} else {
// 在别的线程(比如业务线程池),不能直接操作 Channel,
// 得把任务"扔回"这个 EventLoop 的队列,由它自己的线程来执行
eventLoop.execute(() -> doSomething());
}Channel 的操作不是线程安全的(因为假设只有绑定的那个线程会碰它)。跨线程直接操作会破坏单线程串行的前提,导致数据错乱。所以要么我在自己线程里,直接做,要么我不在,就提交任务让主线程替我做。
EventLoopGroup 是 EventLoop 的容器,管理多个
EventLoop。
bossGroup 通常 1 个线程,只负责 accept,把连接注册到
worker;workerGroup 默认 2 × CPU 核数 个线程,负责已连接
Channel 的读写。分发策略是轮询,每来一个新连接,boss 从 workerGroup
里按顺序取下一个 EventLoop交给他。所以同一个 worker
线程会服务多个连接,这是正常的,也是 Netty
能用少量线程管理大量连接的原因。
线程名能直接反映归属,命名规则大致是
池名-组序号-线程序号
1 | boss : nioEventLoopGroup-2-1 // 监听 Channel 的 EventLoop |
不加锁也能保证同一连接状态一致的设计,李林锋的《Netty 高性能之道》里叫无锁化的串行设计:一个连接的所有处理都在同一个线程里串行执行,自然不需要锁(InfoQ 原文,腾讯云转载全文)。
- 串行:一个 Channel 的所有事件排成一条队,由同一线程依次处理,不会并发。
- 无锁:因为没有并发访问同一连接状态,所以业务 Handler 里的状态不需要加锁保护
- 代价是这个线程不能阻塞。
如何认为 一个 EventLoop 上的连接是命运共同体?
一个 worker
线程通常服务几十上百个连接。这些连接共享同一个线程、同一个
Selector、同一个任务队列。某个 Handler 里执行了
Thread.sleep(3000),受影响的不只是当前连接:
- 这个线程上的其他连接收不到读事件;
- 已经就绪的写事件无法完成;
- 提交到这个 EventLoop 的任务全部排队;
- 如果连接数多,内核缓冲区会被填满,对端开始感受到延迟。
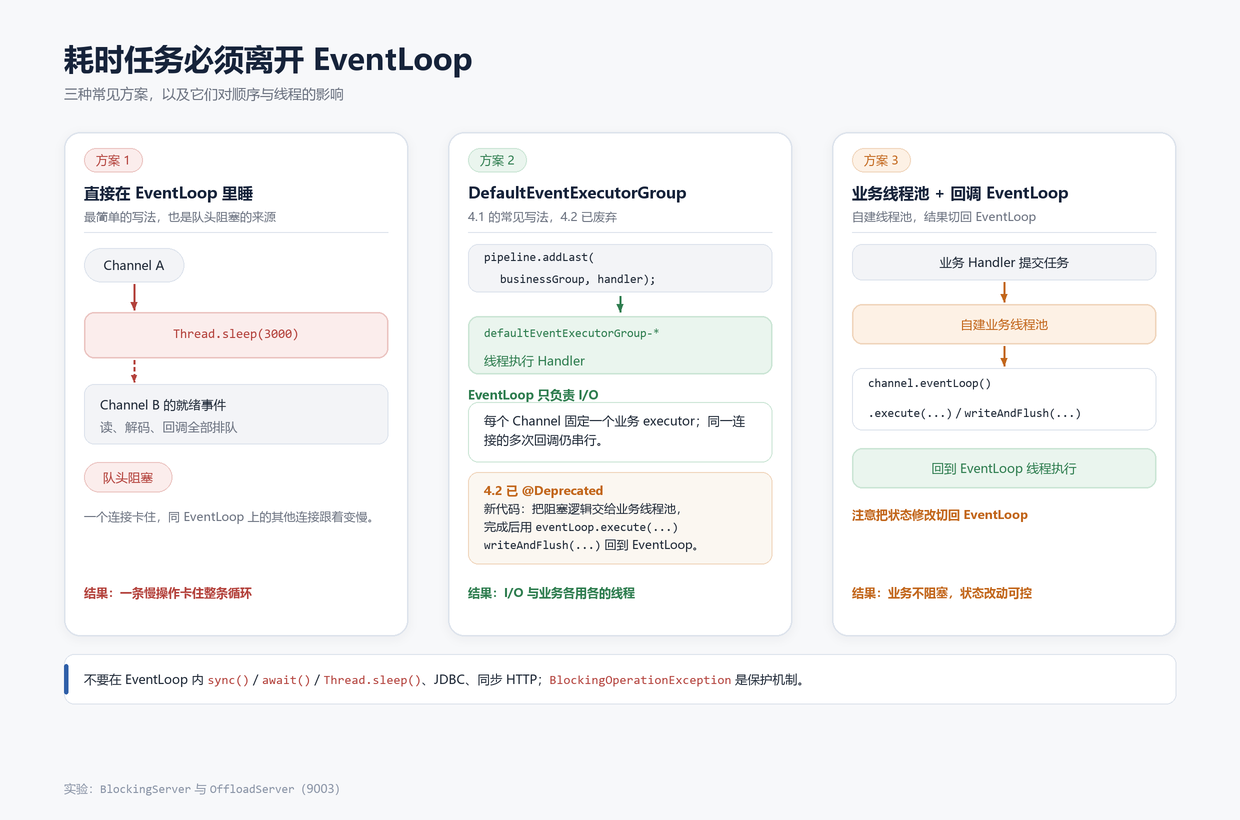
这就是“不要在 EventLoop 里做耗时操作”的真正含义,不是什么编码规范,是由线程模型决定的结果。
美团技术团队记录过一个真实的生产事故:Log4j2 同步打日志把 Netty 的 NIO 线程阻塞住,服务端无法继续处理请求,Nginx 出现大量 5xx(Netty 堆外内存泄露排查盛宴)。事故的主线是堆外内存泄漏,但排查过程恰好证明了 NIO 线程被阻塞的代价。
任务调度:execute、submit、schedule
EventLoop 本身就是一个执行器,除了跑 I/O,还可以跑提交给它的任务。常用方法有五个:
| 方法 | 返回值 | 用途 |
|---|---|---|
execute(Runnable) |
void |
提交普通任务,不关心结果 |
submit(Runnable/Callable) |
Future |
提交任务并拿结果 |
schedule(Runnable, delay, unit) |
ScheduledFuture |
延迟执行一次 |
scheduleAtFixedRate(...) |
ScheduledFuture |
固定频率重复执行 |
scheduleWithFixedDelay(...) |
ScheduledFuture |
上一次结束后再延迟 |
这些任务和 I/O 事件共用同一个线程。也就是说,如果任务里执行了耗时逻辑,I/O 处理同样会被推迟。定时任务也一样,它的执行线程仍然是 EventLoop 线程,不是额外的定时器线程。
任务的执行顺序是,普通任务按提交顺序执行;定时任务按到期时间排序。
需要注意,scheduleAtFixedRate 的间隔是 计划时间
的固定频率,如果任务执行时间超过间隔,下一次会紧接着执行。
还有一个常见误区:EventLoop 的定时任务不是用
HashedWheelTimer 实现的。HashedWheelTimer 是
Netty 提供的通用时间轮,适合海量、低精度的定时任务;EventLoop
内部用的是自己的任务队列和到期时间排序。
TaskSchedulingDemo 把四类任务放在一个
NioEventLoopGroup(1) 上跑,主线程只负责提交和等待:
1 | EventLoop eventLoop = (EventLoop) group.next(); |
运行结果:
1 | 15:14:26.747 [main ] task main thread=main inEventLoop=false |
几个观察点:
- 主线程的
inEventLoop=false,所有任务日志都在nioEventLoopGroup-2-1线程,inEventLoop=true。任务队列确实就是 EventLoop 自己的队列。 submit的返回值submit-result是主线程用get()拿到的。这里主线程阻塞等待没问题,因为它不是 EventLoop 线程;同样的get()如果写在 Handler 里,就会触发第 7 节要讲的死锁检测。schedule(200ms)实际延迟 209 毫秒,比计划多了 9 毫秒。可以看出 EventLoop 的定时任务受select唤醒和系统调度影响,不要把它当成精确的定时器。scheduleAtFixedRate的三次 tick 间隔约 93、94 毫秒,接近 100 毫秒。固定频率任务以计划时间为基准,如果任务本身执行时间超过周期,下一次会延后或紧挨着执行。- 任务内部取消后
isCancelled=true。cancel(false)表示不打断正在执行的任务;如果任务已经在跑,取消后它仍会跑完这一轮。
inEventLoop 与跨线程调用
Netty 的所有 I/O
操作都是线程安全的。write()、close()、read()
可以在任意线程调用,内部会判断:
- 如果当前线程就是 Channel 的 EventLoop 线程,直接执行;
- 如果不是,把操作封装成任务丢进 EventLoop 的任务队列,由 EventLoop 线程稍后执行。
这就是为什么业务线程可以安全地给某个连接推送消息,也是为什么回调线程不固定。安全的前提是操作本身通过 EventLoop 串行化了,而不是说多个线程可以同时改同一份业务状态。
1 | // 业务线程里给某个连接推送消息,内部会自动入队 |
自己维护的连接上下文也有同样的选择:要么只让 EventLoop
线程访问,要么用并发容器、volatile、原子类保护。Netty
给你的是 I/O 的线程安全,不是业务对象的线程安全。
实验
ThreadModelServer 监听 9003,boss 1 线程,worker 固定 2
个线程。业务 Handler 在每次读到消息时,打印当前线程名,并把 Channel id +
线程名 + 消息 回写给客户端,最后再往同一个 EventLoop 提交一个任务。
1 |
|
客户端这时候我们就一次建 4 条连接,全部 active
后每条发两条消息。
1 | for (int index = 1; index <= connections; index++) { |
服务端输出如下:
1 | 15:14:07.251 [main ] server started port=9003 boss=1 worker=2, run ThreadModelClient |
客户端收到的回写:
1 | 15:14:08.012 [nioEventLoopGroup-2-1 ] client conn=1 active local=/127.0.0.1:52546 loop=nioEventLoopGroup-2-1 |
从这些日志能读出三件事:
4 条连接分到 2 个 worker 线程上:
9703a1f4、8cc1e7ec在nioEventLoopGroup-3-1,36fea0e0、637b28c0在nioEventLoopGroup-3-2。一个线程服务多条连接,是常态,不是异常。1
2
3
4active id=9703a1f4 ... loop=nioEventLoopGroup-3-1
active id=36fea0e0 ... loop=nioEventLoopGroup-3-2
active id=8cc1e7ec ... loop=nioEventLoopGroup-3-1 ← 又回到 3-1
active id=637b28c0 ... loop=nioEventLoopGroup-3-2 ← 又回到 3-2轮询分发:1→3-1,2→3-2,3→3-1,4→3-2。结果
3-1管9703a1f4和8cc1e7ec,3-2管36fea0e0和637b28c0。这就是一个线程服务多条连接同一条连接的所有事件都在同一个线程:
active、两次read、两次[task]的线程名完全相同,inEventLoop=true。提交给channel.eventLoop().execute(...)的任务也在同一个线程执行,因为任务队列就挂在这个 EventLoop 上。以
9703a1f4为例,它的全部日志线程都是nioEventLoopGroup-3-1:text
1
2
3
4
5active → 3-1
read whoami-1 → 3-1
read whoami-2 → 3-1
[task] → 3-1
[task] → 3-1active、两次read、两次[task],线程名完全相同,全部inEventLoop=true。这说明一个 Channel 始终都在这一个线程里[task]的线程名和对应连接的read线程名完全一致。因为channel.eventLoop().execute()就是把任务塞进这个 Channel 所属 EventLoop 的队列,由它自己的runAllTasks()执行。任务没有跨线程观察
9703a1f4的任务时间:1
2
3
4read whoami-1 08.316
read whoami-2 08.332
[task] 08.341 ← 两个 read 都处理完了,任务才跑
[task] 08.355任务不是
channelRead0里立刻同步执行的,而是先攒进队列,等run()循环走到第 3 步runAllTasks()才执行。这正是EventLoop三步循环select → processSelectedKeys → runAllTasks的体现,读事件在 processSelectedKeys 阶段,任务在 runAllTasks 阶段,两者分阶段执行。
这也顺带说明一个常见误解:Netty 不是一个连接一个线程,而是一个
EventLoop 线程服务多个连接。默认 worker 线程数是
2 × CPU,连接数可以远大于线程数。
下面把这个问题摆台面上,如果耗时操作已经存在,怎么从 EventLoop 里移出去。
把耗时任务移出 EventLoop
先明确哪些操作算耗时。一般是阻塞时间不确定、且可能在秒级的操作:
- 数据库、缓存、RPC 等同步调用;
- 同步 HTTP 请求、文件 IO;
Thread.sleep()、Future.get()、锁等待;- 大量序列化、复杂计算、大日志拼接;
CountDownLatch.await()。
这些操作放在 EventLoop 里,就会延迟抖动,重则整个 worker 线程卡死。
一次 sleep 阻塞两条连接会咋样
为了能稳定复现,实验把 workerGroup 固定成 1
个线程,这样两条连接一定落在同一个 EventLoop 上。业务 Handler 收到
slow 就睡 3 秒,收到 fast 立即返回。客户端先发
slow,100 毫秒后再发 fast。
1 | // 关键:worker 只有 1 个线程,所有连接共用一个 EventLoop,阻塞会放大成全局问题 |
慢业务本身只是睡 3 秒:
1 |
|
运行结果:
1 | # 服务端 |
1 | # 客户端 |
把两条连接的时间线对上,就能看到队头阻塞。客户端在 400
毫秒左右就发出了 fast 请求,但它要等 slow 的 3
秒处理结束才被读取:
slow的begin在15:14:13.033,睡眠到15:14:16.046,耗时 3012 毫秒;fast的begin直到15:14:16.088才出现,比它实际到达服务端晚了 3 秒多;- 客户端收到两条响应的间隔只有 24 毫秒,都是在
slow结束之后;因为fast的读事件在slow结束后才被处理,两条响应都在 3 秒后集中发出。 - 连第二条连接的
active回调也被推迟到15:14:16.074。这不是 accept 出了问题,而是这个子 Channel 的注册和激活事件也排在同一个 EventLoop 的任务队列里,前面的读事件没处理完,轮不到它。
所以阻塞 EventLoop 影响的不只是读写,还包括新连接的注册、Pipeline 里的所有 Handler、以及提交到这个 EventLoop 的所有任务。他们都会被阻塞操作而延后。这个线程上排队的一切都会被延后。这就是队头阻塞
结果就是,fast 的响应时间和 slow
几乎一样,都要等 3 秒。fast
并不是没有被处理,而是它前面的读事件处理占住了线程,轮到它时已经过去 3
秒。
那么我们如何处理呢?如何把耗时操作移出去。
方案一:pipeline.addLast(group, handler)
给业务 Handler 单独指定一个执行器组:
1 | EventExecutorGroup businessGroup = new DefaultEventExecutorGroup(2); |
只改装配方式:给 Handler 指定一个执行器组。
Pipeline 在添加 Handler 时会为它分配一个 executor。这个 executor 来自
businessGroup,而且每个 Channel
固定分配其中一个。也就是说,同一个连接的所有回调仍然串行执行,只是从
EventLoop 线程换到了业务线程;不同连接之间可以并行,分布到不同的业务
executor 上。
原来靠一个 Channel 一个 EventLoop 保证串行,现在靠一个 Channel 一个业务 executor 保证串行,换了承载者
这带来两个直接结果:
- EventLoop 只负责 I/O,耗时业务不再阻塞它;
- 一个连接的多次回调不会乱序,因为仍然由同一个 executor 串行执行。
这个写法在 4.1 的官方文档里被推荐,但是 4.2 已经把
addLast(EventExecutorGroup, ...) 系列方法标记为
@Deprecated,理由是这种用法引入的问题比解决的问题多,主要是线程切换导致失去单线程简单性和DefaultEventExecutorGroup
队列默认无界,所以说新版本更推荐自己把阻塞逻辑 dispatch 出去(Netty
核心维护者 Norman Maurer 在 PR
#14538 里的原话是 “much better to dispatch it
manually”)。但是语义仍然成立,本文也用它做对照实验,因为它是把 Handler
的 executor 这件事变得可见的最短路径;新项目里不能抄这个 API。
代价是线程切换,以及失去了 所有回调都在同一个线程 的简单性。Handler 里的状态现在归业务线程所有,EventLoop 线程不能随便碰,因为排查问题时也要多看一个线程名。
把 BlockingServer 的装配改成下面这样,就得到
OffloadServer:
1 | EventLoopGroup bossGroup = new NioEventLoopGroup(1); |
业务代码一行没改,只是换了装配方式。运行同样的客户端,结果变成:
1 | # 服务端 |
1 | # 客户端 |
fast 在 404 毫秒就返回了,不再陪 slow 等 3
秒。业务线程名变成
defaultEventExecutorGroup-4-1/4-2,inEventLoop=false,这样
EventLoop 线程只负责 I/O了。
注意 channelActive 这一类回调也跟着 Handler
一起移到了业务线程,所以日志里会出现
inEventLoop=false。这不是异常,而是 Handler 的 executor
变了。
还有:
- 两条连接分别落在
defaultEventExecutorGroup-4-1和-4-2上,说明 每个 Channel 固定一个 executor 确实生效。如果业务线程组只有 1 个线程,fast仍然会被slow卡住,因为两条连接会固定到同一个业务 executor 上。移到业务线程组只是把 一个线程卡所有连接 缩小成 一个业务线程卡它负责的连接,并没有凭空增加并行度。 DefaultEventExecutorGroup的任务队列默认无界。业务处理不过来的任务会一直排队。生产环境要结合队列监控、限流和拒绝策略。
方案二:业务线程池 + 回到 EventLoop
这段讲的是上面的 手动 dispatch,不用
addLast(group, handler)
如果耗时逻辑不在 Pipeline 里,或者需要复用项目已有的线程池,可以把任务提交到自建线程池,处理完再切回 EventLoop:
1 | ExecutorService businessPool = Executors.newFixedThreadPool(8); |
两次切换:
- 切出去(
businessPool.execute):把耗时逻辑从 EventLoop 线程挪到业务线程池,I/O 线程立刻解放。 - 切回来(
eventLoop.execute):把 写回 Channel 这个动作塞回 EventLoop 的任务队列,由 EventLoop 线程执行。
这里的关键是切回去。ctx.writeAndFlush
本身是线程安全的,可以直接在业务线程调用;但如果还要修改只在 EventLoop
里访问的状态、或者做多个有顺序的操作,就应该显式切回
EventLoop,避免状态被多个线程同时修改。
writeAndFlush线程安全,为什么还切?因为它只对”写”这一个动作线程安全,不对 你的业务状态 做线程安全。
writeAndFlush内部中,如果你不在 EventLoop 线程,它自己会帮你把写任务提交回 EventLoop 队列,所以,你只写数据、不碰任何状态,直接调writeAndFlush没问题,它帮你切了,你写了数据,同时还改了别的状态,不行,因为改状态这步没被帮你切重要的还是,一个 Channel 的所有回调都在它绑定的 EventLoop 线程里串行执行,所以 Handler 里的状态默认只有 EventLoop 线程会碰,因此不用加锁。
但一旦你用
businessPool.execute(...),业务线程也来碰这个 Channel 了。如果业务线程直接改这些 默认归 EventLoop 所有 的状态,就有两个线程同时访问,就数据竞争。然后,就是 多个有顺序的操作 为什么也必须切,假设业务线程里要连续做:
2
3
someState = x; // 中间夹一个状态修改
ctx.writeAndFlush(b);如果不切回来,这三个动作在业务线程里执行,而 EventLoop 线程可能同时也在处理这个 Channel 的其他事件,顺序无法保证。切回 EventLoop 后,这些操作和该 Channel 的其他事件在同一个队列里排队,天然有序。
自己维护线程池的代价是,线程数、队列长度、拒绝策略都要自己管;任务和 Channel 的生命周期也要自己关联,连接关闭后不能继续往队列里塞任务。安全责任回到你手上了。
方案三:CompletableFuture 编排
当耗时操作本身已经是异步的,比如异步 HTTP
客户端、异步数据库驱动,可以用 CompletableFuture
做编排,避免阻塞任何线程:
1 | CompletableFuture.supplyAsync(this::slowQuery, businessPool) |
thenAccept 默认在完成上一个阶段的线程上执行,不一定是
EventLoop
线程。所以写回虽然线程安全,但状态修改仍需注意,和上面的原因是一样的。
如果希望回调固定在 EventLoop,可以在最后用
ctx.executor().execute(...) 收口。
三种方案的取舍
| 方案 | 改造成本 | 顺序保证 | 适用场景 | 主要代价 |
|---|---|---|---|---|
pipeline.addLast(group, handler)(4.1 常见,4.2
已废弃) |
低,改一行 | 同 Channel 串行 | 业务 Handler 整体耗时 | 线程切换、多一个线程组 |
| 自建业务线程池 + 回调 EventLoop | 中 | 自己保证 | 已有线程池、任务来自非 Pipeline | 生命周期与队列要自己管 |
CompletableFuture 编排 |
中 | 自己保证 | 下游本身异步 | 回调线程不确定 |
三种方案都不是越多越好。业务线程组和线程池会增加上下文切换和内存占用,队列积压时还会引入新的延迟。先确定瓶颈在 EventLoop 上,再做迁移。
阻塞检测与常见事故
Netty 对“在 EventLoop
里同步等待”有保护。ChannelFuture.sync()、await()、Promise.await()
在 EventLoop 线程里调用时,会检查是否死锁,直接抛出
BlockingOperationException,避免线程把自己等死。
1 | // 在 Handler 里这样写会抛 BlockingOperationException |
这个异常是保护机制,不是建议你换个地方继续等。它说明代码里存在“等待一个只有当前线程才能完成的操作”,换成
await(timeout) 也只是从死锁变成超时。后面第 7 节的
FuturePromiseDemo 会用一个 Handler 内的
closeFuture().sync() 把这个异常真实打印出来。
除了同步等待,还有几个容易忽略的阻塞点:
- 日志框架同步写磁盘,尤其是高并发下打大对象;
String拼接和 JSON 序列化放在回调里;- 在
channelRead里做全量数据加载; - 在
channelActive里做鉴权 RPC。
这些操作单次可能只有几十毫秒,但在高 QPS 下会叠加成明显的延迟。
ChannelPipeline:事件如何传播
前面反复出现 Pipeline 这个词,它让读事件沿它传播,写事件也沿它传播,编解码器挂在它上面。这一节把它拆开,重点搞清楚两件事,事件往哪个方向走,Handler 的先后顺序意味着什么。
结构:head、tail 与双向链表
每个 Channel 创建时,Netty 会自动为它创建一个
ChannelPipeline,一个 Channel 有且只有一个
Pipeline,从创建到销毁都不变。Pipeline 内部是一个由
ChannelHandlerContext 组成的双向链表:
1 | head ⇄ ctx(A) ⇄ ctx(B) ⇄ ctx(C) ⇄ tail |
head和tail是 Netty 内部的两个哨兵节点,也就是头尾指针,不承载业务逻辑。addLast添加的 Handler 都夹在 head 和 tail 之间。- 每个
ChannelHandlerContext持有一个 Handler、一个名字、一个 executor,以及它到前后节点的引用。 - 业务代码拿到的
ctx就是当前 Handler 对应的节点,它知道自己在这条链上的位置。
Pipeline 的增删方法是线程安全的,但事件回调本身只在对应线程执行。常用的修改方法:
| 方法 | 作用 |
|---|---|
addFirst / addLast |
加到链头 / 链尾 |
addBefore / addAfter |
相对某个 Handler 插入 |
remove |
移除 |
replace |
替换 |
get / context |
按名字或 Handler 找到 Context |
Handler 被加入和移除时,会分别回调 handlerAdded 和
handlerRemoved。ChannelInitializer 就是靠
handlerAdded 在 Channel 注册时装配
Pipeline,装配完成后把自己移除。
入站和出站是两条方向相反的路
Netty 把事件分成两类:
| 类型 | 典型事件 | 传播方向 | 常见 Handler 基类 |
|---|---|---|---|
| 入站 | 注册、激活、读到数据、读完成、失活、注销、异常 | head → tail | ChannelInboundHandlerAdapter、SimpleChannelInboundHandler |
| 出站 | bind、connect、write、flush、read、close、disconnect | tail → head | ChannelOutboundHandlerAdapter |
入站事件按 addLast 的顺序依次经过
Handler;出站事件方向相反,按 addLast 的逆序经过。
这个方向不是随意定的。入站是从网络进来,交给业务,自然从靠近网络的 head 走向业务所在的 tail;出站是从业务出去,交给网络,自然从 tail 走回 head。
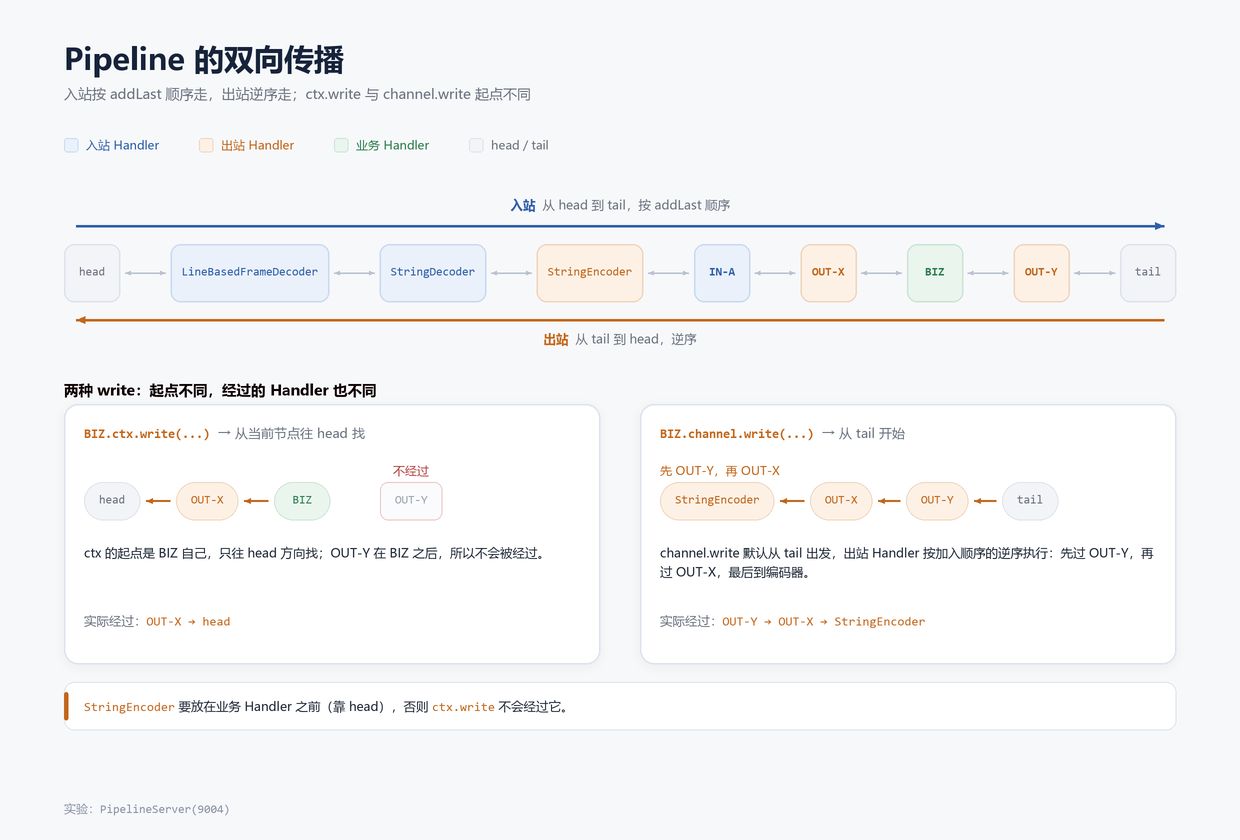
事件要往下传,需要显式调用传播方法:
1 | // 入站:把消息传给下一个入站 Handler |
如果不调用,事件就停在当前 Handler,后面的 Handler 收不到。这也是很多“我的解码器没生效”“我的日志 Handler 不打印”问题的根源,在前一个 Handler 把消息截断了。
有一点需要区分:ctx 是位置,channel
是整条链。ctx.write 从当前位置开始往前找出站
Handler;channel.write 等价于从 tail
开始。这个差别下一节展开。
ctx.write 与 channel.write
ctx.write(msg):从当前 Handler 的位置出发,沿着出站方向(向 head)找下一个出站 Handler,只经过当前 Handler 靠近 head 一侧的那些出站 Handler。channel.write(msg):从 Pipeline 的 tail 出发,经过整条链上所有的出站 Handler。
用一条具体的 Pipeline
验证。顺序是:IN-A(入站)→ OUT-X(出站)→ BIZ(业务)→ OUT-Y(出站)。
业务 Handler 收到 ctx 命令时调用
ctx.writeAndFlush,收到 channel 命令时调用
ctx.channel().writeAndFlush。先来看看装配顺序:
1 | ch.pipeline() |
业务 Handler 根据命令选择两种写法:
1 | if (msg.startsWith("ctx ")) { |
观察 Handler 只做两件事:打印,然后继续传播。
1 |
|
服务端输出:
1 | 15:14:30.183 [main ] server started port=9004 pipeline=decoder,String,encoder,IN-A,OUT-X,biz,OUT-Y |
客户端看到的响应:
1 | 15:14:31.046 [main ] client send msg=ctx hello |
结果和结论一致:
ctx路径只经过OUT-X,因为OUT-Y在业务 Handler 后面(靠 tail 一侧),向 head 方向找时不会经过它。channel路径从 tail 开始,先经过OUT-Y,再经过OUT-X。- 入站方向只经
IN-A,两个出站 Handler 都被跳过。Handler 的“方向性”由它实现的接口决定,入站事件不会因为它在链上就被调用。
这就解释了一个常见的困惑:为什么出站编码器要放在业务 Handler
之前。业务 Handler 用 ctx.writeAndFlush 写出对象,事件向
head 方向传播,只有位于业务之前的编码器才能把对象转成
ByteBuf;如果编码器放在业务之后,ctx.write
根本不会经过它,最终交给 head 的还是对象,写 Socket
时就会报不支持的消息类型。
官方资料里的说法是一致的:ChannelPipeline javadoc
的示例就是
decoder → encoder → handler,并明确出站事件的求值顺序是反过来的
5、4、3、2、1(ChannelPipeline
源码);官方 User Guide 在 Time 示例里也明确写了要把
TimeEncoder 插到 TimeServerHandler 之前(User
Guide for 4.x)。传播方向的实现细节在
AbstractChannelHandlerContext#findContextOutbound,它从当前
Context 的 prev 开始找(源码)。
上一篇在讲 Pipeline 时有一句话容易引起误解:编码器要放在业务 Handler
后面、靠近 tail 一侧。严格按传播方向看,这句话只对
channel.write 成立。用 ctx.write
时,编码器必须放在业务 Handler
之前。本文的实验就是用来把这件事一次性验证清楚的。
| 写法 | 起点 | 经过的出站 Handler | 适用场景 |
|---|---|---|---|
ctx.writeAndFlush |
当前 Handler | 靠近 head 一侧的 | 业务 Handler 写响应,编码器在业务之前 |
channel.writeAndFlush |
tail | 全部 | 在靠近 head 的 Handler 里写,或想走完整出站链 |
编解码器的位置
把上面两条规则放到一个典型 Pipeline 里:
1 | head → 帧解码器 → 消息解码器 → 消息编码器 → 业务 Handler → tail |
- 入站:字节先经过帧解码器切成完整帧,再经过消息解码器转成对象,最后到业务 Handler。
- 出站:业务 Handler 写出的对象,向 head 方向先经过消息编码器变成
ByteBuf,再由帧层处理,最后写 Socket。
如果顺序反了,入站方向业务收到的是半包,出站方向写出去的是对象,两个方向都会出问题。这也是为什么 编解码器放错位置 这一类问题排查起来很费时间:连接能建立,日志也有,只是数据不对。
动态修改 Pipeline
Pipeline 不是只能在启动时装配。运行中可以按需增删 Handler,常见场景有三个:
- 握手/鉴权完成后,把鉴权 Handler 移除,避免每条消息都走一遍;
- 协议升级,例如 HTTP 升级 WebSocket 后替换编解码器;
- 灰度或调试时临时加一个日志 Handler。
1 | // 鉴权通过后移除自己 |
运行时添加的 Handler 会立即收到 handlerAdded;如果
Channel 还没注册,回调会等到注册时统一执行。移除 Handler
时,handlerRemoved
也会被调用,适合在这里清理它持有的资源。
修改 Pipeline 时要注意一点,事件正在传播的途中,链的结构可能已经变了。Netty 内部会保证不出现悬空引用,但业务上最好避免在同一次回调里既删自己又依赖后续 Handler 的顺序。
异常与未处理消息
我们认为异常也是入站事件,从 head 传到 tail。业务 Handler 覆写
exceptionCaught 可以拦截;
1 |
|
- 一旦你覆写并不再调用
ctx.fireExceptionCaught(cause),异常就停在这里,不再往后传。
不拦截的话,异常会继续向后传,最终由 tail
记录一条警告。ChannelInboundHandlerAdapter 的默认
exceptionCaught 实现就是:
1 | public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception { |
Pipeline 末尾对未处理的入站消息有一个兜底,如果消息传到了 tail
还没有人消费,Netty 会释放它持有的
ByteBuf。对于ByteBuf ,Netty
的规则是,谁最后持有它、消费它,谁负责
release()。如果一路没人消费、传到 tail,tail
帮你释放,避免泄漏。
这也是为什么继承 SimpleChannelInboundHandler
时不需要手动 release,而继承
ChannelInboundHandlerAdapter
时如果自己消费了消息,就要自己释放。
1 | public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { |
用 EmbeddedChannel 验证传播顺序
PipelineOrderTest
把上面的顺序做成了断言,不需要真实端口:
1 |
|
测试运行结果:
1 | [INFO] Running hbnu.project.nettydemo.demo.core.PipelineOrderTest |
EmbeddedChannel 的 writeInbound
模拟入站数据,readOutbound
读出站消息,finishAndReleaseAll
收尾并释放缓冲区。顺序类的问题用它验证,比开两个进程加日志快得多。
@Sharable 代表 Handler 能不能共享
写业务 Handler 时经常遇到一个报错:
1 | is not a @Sharable handler, so can't be added or removed multiple times |
这个报错的含义很直接:这个 Handler 实例已经被加到一条 Pipeline 上了,Netty 不允许把它再加到另一条。原因是大多数 Handler 不是线程安全的。
官方 @Sharable 的 javadoc 说得很清楚: 标注它表示同一个
Handler 实例可以被加入一个或多个 Pipeline
多次而不会产生竞态;不标注时,每次加入都必须创建新实例,因为它可能有未共享的状态(ChannelHandler.Sharable
javadoc)。
为什么 Netty 要检查
Netty 在运行时无法可靠地自动判断一个 Handler 是否有状态、是否线程安全,只能通过注解把这个实例能否被多个连接共享的承诺交给开发者显式声明,并在添加时做一次廉价的一致性检查。
换句话说,@Sharable这个注解并不赋予 Handler
任何线程安全能力,它只是一个标记,表示开发者已经确认这个
Handler 是无状态的,或者其状态是线程安全的,可以被多个连接同时使用。
Handler 实例和 Channel 的关系有两种:
- 每个连接一个实例:在
ChannelInitializer.initChannel里new,每条连接独立,状态天然隔离; - 多个连接共享一个实例:需要显式标注
@Sharable,并自己保证线程安全。
Netty 无法自动判断一个 Handler
有没有状态,只能在添加时检查注解。第一次添加时记录下来,第二次添加同一个实例时,如果没有
@Sharable,就抛 ChannelPipelineException。
1 |
|
有状态 Handler 的典型事故
给有状态 Handler 加上 @Sharable
可以让报错消失,但状态会被所有连接共享。SharableDemo
里用一个计数器模拟:
1 | // 用例 1:无 @Sharable 的有状态 Handler,第二次添加到另一条 Pipeline |
运行结果:
1 | 15:14:34.557 [main ] sharable --- case1: non-sharable handler reused by two channels --- |
第一个连接写两条、第二个连接写一条,计数器最终是 3。如果这个计数器代表“当前连接的消息数”“登录用户”“待回复请求”,结果就是串数据。更糟的是并发了,多个 EventLoop 线程同时调用同一个 Handler 实例,普通成员变量会出现可见性和竞态问题。
反射结果也回答了一个常见问题,哪些内置 Handler
可以共享。StringEncoder、StringDecoder、LoggingHandler、ChannelInitializer
带 @Sharable,LineBasedFrameDecoder 和
IdleStateHandler
不带。前者只做无状态的编码转换,后者分别持有累积缓冲区和定时状态,不能共享。
所以规则是:
- 无状态 Handler 才考虑
@Sharable; - 有状态 Handler 每条连接
new一个,放在ChannelInitializer里; - 如果确实要跨连接共享状态,用
ChannelGroup、ConcurrentHashMap、原子类等显式管理,不要藏在 Handler 成员变量里。
简单说一下 Netty 的内置 Handler 的@Sharable
Netty
自带的编解码器大多是无状态的,因此可以共享。StringEncoder、LoggingHandler
这类可以直接复用;LineBasedFrameDecoder
有累积缓冲区,不能共享,所以通常在 ChannelInitializer
里为每条连接 new 一个。
在 Spring 项目里这一点尤其要注意:把 Handler 声明成单例
Bean,就等于默认所有连接共享同一个实例。除非它无状态并且加了
@Sharable,否则应该用工厂方法为每条连接创建。
内置 Handler 的注解可以用反射直接确认,结果见上面的 case4。
与 Spring 单例配合的写法如下
1 |
|
判断标准很简单:Handler 里有没有随连接变化的数据。有,就每条连接一个;没有,才考虑共享。
ChannelOption 与 ChannelConfig
启动 Netty
时总会写一串配置:SO_BACKLOG、TCP_NODELAY、CONNECT_TIMEOUT_MILLIS。这些配置写在哪里、作用在哪个
Channel 上、运行时能不能改,是这一节要解决的问题。
option 和 childOption 作用于谁
首先要清楚,配置的最终归宿是
ChannelConfig。ChannelOption 本身只是一个“键”,你通过
option() 或 childOption()
设置的值,最终会被写入对应 Channel 的
ChannelConfig 对象中。
ServerBootstrap 同时有两套配置入口。提供
option() 和 childOption()
两个方法,是因为一个服务端应用会涉及两类生命周期完全不同的
Channel。
| 方法 | 作用的 Channel | 典型选项 |
|---|---|---|
option(...) |
监听 Channel(父 Channel) | SO_BACKLOG、SO_REUSEADDR |
childOption(...) |
accept 出来的子 Channel | TCP_NODELAY、SO_KEEPALIVE、WRITE_BUFFER_WATER_MARK、AUTO_READ |
客户端 Bootstrap 没有这个区分,因为它创建的
Channel 只有一个,直接通过 option()
设置即可。
这个区分很重要,SO_BACKLOG 是 listen
系统调用的参数,只对监听 Socket 有意义;TCP_NODELAY
是已连接 Socket 的参数,必须写在 childOption
里。写错位置不生效。
常用选项
| 选项 | 作用 | 默认值与注意点 |
|---|---|---|
SO_BACKLOG |
监听队列长度 | 影响瞬时大量连接时的 accept 成功率 |
SO_REUSEADDR |
允许复用本地地址 | 重启服务时避免端口占用 |
TCP_NODELAY |
关闭 Nagle 算法 | 交互式消息通常开启,降低小包延迟 |
SO_KEEPALIVE |
TCP 保活探测 | 只能探测连接是否存活,不能替代应用层心跳 |
CONNECT_TIMEOUT_MILLIS |
客户端连接超时 | 只对 connect 有效 |
WRITE_BUFFER_WATER_MARK |
写缓冲水位线 | 默认低 32 KiB、高 64 KiB,用于背压 |
AUTO_READ |
是否自动读取 | 默认 true,设为 false 后需要手动 read() |
ALLOCATOR |
ByteBuf 分配器 |
池化/非池化、堆内/直接内存,第 03 篇展开 |
SO_RCVBUF / SO_SNDBUF |
内核收发缓冲区 | 设置不当会限制吞吐 |
这些默认值是 Netty
的默认值,操作系统和传输实现可能再叠加自己的默认行为。要以实际运行结果为准。水位线的两个默认值可以在
WriteBufferWaterMark 里直接看到,AUTO_READ
的默认值在 DefaultChannelConfig 里(WriteBufferWaterMark
源码、DefaultChannelConfig
源码)。
运行时读取和修改
运行时能不能改?能。ChannelConfig 的设计允许在 Channel
存活期间动态修改部分选项。你可以通过
channel.config().setOption(...) 或调用对应的 setter
方法来调整配置。
每个 Channel 都有 config(),返回
ChannelConfig。大部分选项可以在运行时读取,一部分可以修改:
1 | ChannelConfig config = channel.config(); |
注意 getOptions()
不一定返回全部选项,它通常只包含显式设置过的项。要读某个选项,用
getOption(ChannelOption.XXX) 更可靠。
AUTO_READ 与背压
AUTO_READ 默认是 true。Netty
在读事件处理完后会主动继续注册读事件,所以数据源源不断地进入
Pipeline。
把它设为 false 后,Netty
不再自动读,数据留在内核缓冲区里,业务处理完一批后调用
channel.read()
再要下一批。这是最朴素的背压手段,处理不过来就先不读,让 TCP
窗口自然收缩,把压力传回对面。
1 | // 关闭自动读 |
这适合“消息处理很重、下游容易被打爆”的场景;代价是代码里多了读的时机管理,调用
read() 的时机不好就会看起来像连接卡住。
运行结果:
1 | 15:14:35.682 [main ] config server started port=57497 (bind(0) random port) |
上述把 option 和 childOption 的作用对象分得很清楚:
- 父 Channel 的
SO_BACKLOG是 64,因为.option(...)设的是监听 Channel;SO_REUSEADDR没有显式设置,显示默认值 false。 - 子 Channel 的
TCP_NODELAY、SO_KEEPALIVE、WRITE_BUFFER_WATER_MARK、ALLOCATOR都来自.childOption(...),值就是设置的值。 - 客户端 Channel 的
CONNECT_TIMEOUT_MILLIS和AUTO_READ来自它自己的.option(...);SO_KEEPALIVE没有设置,默认 false;水位线默认 32768-65536 字节,也就是 32 KiB / 64 KiB。 - 4.2 的服务端 child 如果显式指定池化分配器就是
PooledByteBufAllocator,没有指定时客户端显示AdaptiveByteBufAllocator。分配器的选择对性能和内存影响很大,第 03 篇和第 06 篇会展开。
AUTO_READ=false 的实验解释得很直接:客户端 500
毫秒内没有收到任何消息,服务端明明已经写了 welcome。调用
read() 之后,welcome 才出现在
channelRead
里。数据并没有丢,只是客户端没有主动去读,事件循环就不会触发读回调。
水位线是写缓冲的背压
WRITE_BUFFER_WATER_MARK 控制的是出站方向。调用
write() 后,数据不一定立刻写到 Socket,而是先进入
ChannelOutboundBuffer。当积压的数据超过高水位,Channel
会变为不可写:
1 | if (channel.isWritable()) { |
从可写变成不可写、或者反过来,会触发
channelWritabilityChanged 回调。
所以说,它适合做慢客户端保护,客户端读得慢,服务端写缓冲堆积,超过高水位后停止向它推送或直接断开,避免一个慢连接拖垮整个服务。
水位线不是越大越好。调大只会把问题推迟到内存耗尽;此时的解法是限流、丢弃或断开。
config 与 AttributeKey
Attribute 的生命周期和 Channel 一致,Channel
关闭后自动清理。它比在 Handler 里维护
Map<ChannelId, User> 更不容易泄漏。
假设你在 Handler 里维护一个 Map<ChannelId, User>
来关联连接和用户。当一个连接断开时,你必须记得在这个 Map
里移除对应条目。如果因为异常路径、代码遗漏或并发问题没移除干净,这个 Map
就会持续增长,最终导致内存泄漏。Attribute
的设计规避了这个问题:它直接挂在 Channel 对象上。Channel
关闭并被垃圾回收时,它携带的 Attribute 也随之被回收
因为ChannelConfig
管的是传输层参数,不是业务状态。业务上要挂“当前登录用户”“会话
ID”这类数据,就要用 AttributeKey:
1 | private static final AttributeKey<User> USER = AttributeKey.valueOf("user"); |
AttributeKey
是一个类型安全的键,同一个名称的 Key 在 Netty
的全局常量池中是单例的,所以你可以在任意 Handler 里用同一个 Key
去读写同一个 Channel 上的属性。
ChannelFuture 与 ChannelPromise
Netty 的 I/O
操作都是异步的:bind、connect、write、close
调用后立即返回,真正的结果稍后才产生。拿到结果的方式就是
ChannelFuture。
异步结果的两种读法
第一种是同步等待,适合启动、测试、非 EventLoop 线程:
1 | ChannelFuture future = bootstrap.bind(9001).sync(); |
第二种是注册监听器,适合业务代码:
1 | ChannelFuture future = bootstrap.bind(9001); |
两种方式的区别不只是写法。同步等待会阻塞当前线程;监听器不会。在 EventLoop 线程里,只能用后者。
Future 的状态
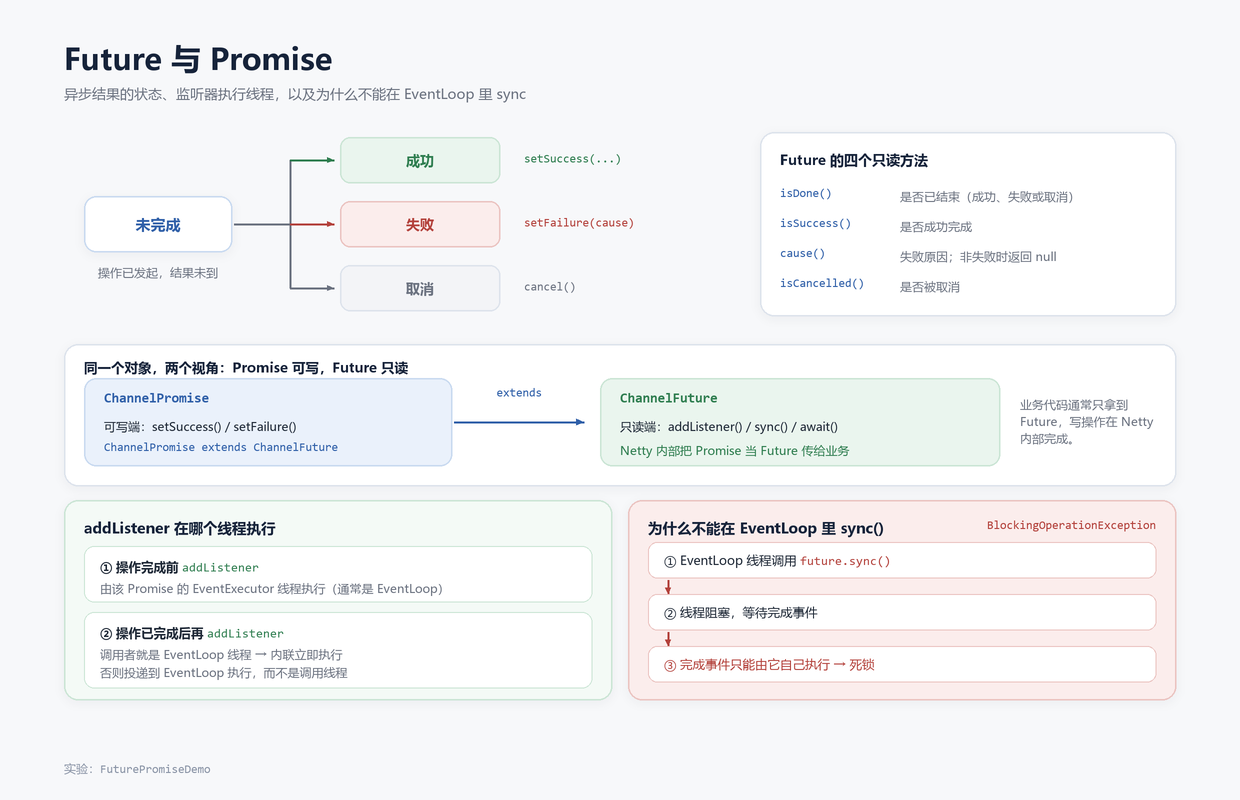
ChannelFuture 有四种状态:未完成、成功、失败、取消。
| 方法 | 含义 |
|---|---|
isDone() |
是否完成(成功、失败、取消都算) |
isSuccess() |
是否成功 |
isCancelled() |
是否被取消 |
cause() |
失败原因,成功时为 null |
getNow() |
已完成时取结果,未完成返回 null |
sync() / await() |
阻塞等待完成 |
状态只能从“未完成”变成“成功/失败/取消”中的一种,变过之后不会再变。监听器只会被通知一次,即使
Future 已经完成才添加,也会被通知;通知在哪个线程执行,取决于调用
addListener 的线程,见下文。
Promise 是可写的一端
ChannelFuture
是只读的观察端,ChannelPromise 是可写的一端。Netty
内部在操作完成时调用 setSuccess 或
setFailure;业务代码一般只读
Future,只有自己实现异步操作时才需要 Promise。
1 | EventExecutor executor = eventLoop.next(); |
Promise 和 JDK 的 CompletableFuture
都能表达异步结果,区别在于 Netty 的 Promise 和 EventLoop/Channel
绑定更紧,监听器的执行线程也更可控。需要和 Channel 生命周期关联时,用
Netty 的 Promise;纯业务编排,用 CompletableFuture
更顺手。
监听器在哪个线程执行
结论比较反直觉:监听器总是由这个 Future 的 executor
线程执行,对 ChannelFuture 来说通常就是 Channel 绑定的
EventLoop 线程。具体分三种情况:
- Future 未完成时添加:等 Future 完成的那一刻,如果完成动作发生在 EventLoop 线程上,监听器就在这个线程上执行;
- Future 已完成,且调用
addListener的线程本身就是这个 EventLoop 线程:监听器内联执行,当场跑完; - Future 已完成,但调用
addListener的是main或业务线程:监听器仍然在 EventLoop 线程执行,Netty 只是把通知任务投递到 EventLoop,稍后由它执行。
也就是说,业务线程给 Future
加监听器,不会让回调跑到业务线程。很多文章说“操作已完成时监听器在调用线程立即执行”,只对第三种情况里的“调用者恰好是
EventLoop 线程”成立,不能当成通用规则。这个判断在
DefaultPromise#notifyListeners() 里,先看
executor.inEventLoop(),不成立就把通知任务
safeExecute 给 EventLoop(DefaultPromise
源码)。
代码里用三个场景验证:
1 | // 场景 1:未完成时添加监听器,setSuccess 在 EventLoop 上执行 |
输出如下:
1 | 15:14:40.181 [main ] future main thread=main adds listener, setSuccess runs on eventLoop |
listener added by main 和
listener in eventLoop inline
这两行线程名相同,但含义不同:前者是 main
线程添加监听器后,通知任务被投递到 EventLoop 执行;后者是 EventLoop
线程自己添加,当场内联执行。单看线程名分不出来,只有结合“谁添加的”才能解释清楚。这也是为什么文章不直接写“已完成
→ 当前线程立即执行”。
所以监听器里不要做耗时操作,也不要假设线程名固定。需要固定线程时,显式切回 EventLoop。
FuturePromiseDemo 的后半段还在服务端 Handler
里放了一段代码,专门验证 EventLoop 内的同步等待:
1 | // 第一种写法:写操作的 Future 可能已经同步完成,此时 sync 不会抛异常 |
连接关闭后再写一次,观察失败的 Future:
1 | 15:14:40.524 [nioEventLoopGroup-2-1 ] future writeAndFlush(...).sync() returned (write finished before sync) |
这里有三个值得注意的结论:
- 第一次
writeAndFlush(...).sync()没有抛异常,因为这次写操作在sync()检查时已经完成。死锁检测只在 Future 未完成时触发(await()先判断isDone())。所以“在 EventLoop 里 sync 一定抛异常”的说法不准确,要看 Future 的状态。 closeFuture().sync()必然抛BlockingOperationException,因为关闭操作要等当前 Handler 返回后才执行,等待者正是自己。这是最可靠的复现方式。- 关闭后写不会抛到调用处,而是返回一个失败的
Future,
cause是StacklessClosedChannelException(ClosedChannelException的无栈版本,Netty 为了省开销做的优化)。不挂监听器就看不到这个失败。
为什么不能在 EventLoop 里 sync
sync() 和 await() 会阻塞当前线程,直到
Future 完成。如果当前线程正是负责完成这个 Future 的 EventLoop
线程,就会死锁,因为它在等自己把事件处理完。
Netty 在 await() 里做了死锁检查,发现当前线程就是 Future
的执行线程时,直接抛 BlockingOperationException:
1 | 15:14:40.527 [nioEventLoopGroup-2-1 ] future closeFuture().sync() threw io.netty.util.concurrent.BlockingOperationException |
这个检查只在 当前线程等于 Future 的 executor 线程 时触发。业务线程里
sync()
是允许的,启动代码里也常见,但要清楚它会阻塞当前线程。
写失败与关闭
写操作失败是最容易被吞掉的异常。writeAndFlush 返回的
Future 如果失败,不挂监听器就没人知道:
1 | channel.writeAndFlush(msg).addListener((ChannelFutureListener) f -> { |
常见的失败原因:
- 连接已关闭:
ClosedChannelException; - 对端重置连接:
IOException/Connection reset by peer; - 写缓冲满且连接不可写:通常不会直接失败,而是排队,需要结合水位线处理。
关闭连接时,推荐用 closeFuture()
监听真正的关闭完成,而不是 close().sync():
1 | channel.closeFuture().addListener(f -> { |
Netty
也提供了几个常用的监听器常量:ChannelFutureListener.CLOSE(操作完成后关闭
Channel)、CLOSE_ON_FAILURE(失败时关闭)、FIRE_EXCEPTION_ON_FAILURE(失败时把异常传给
Pipeline)。它们适合写在链式调用里,减少样板代码。
异步链的写法
多个异步操作有先后关系时,用监听器嵌套会越来越深。可以把每一步封装成返回
Future 的方法,再用 PromiseCombiner 或
CompletableFuture 组合。实际项目里更常见的是:
1 | bootstrap.connect(host, port) |
嵌套两层还能接受,再深就应该抽成状态机或响应式编排。第 04 篇讲客户端重连时会给一个更完整的写法。
把这一篇串起来
一次请求经过的所有机制
把本文涉及的机制放回一次完整的请求里:
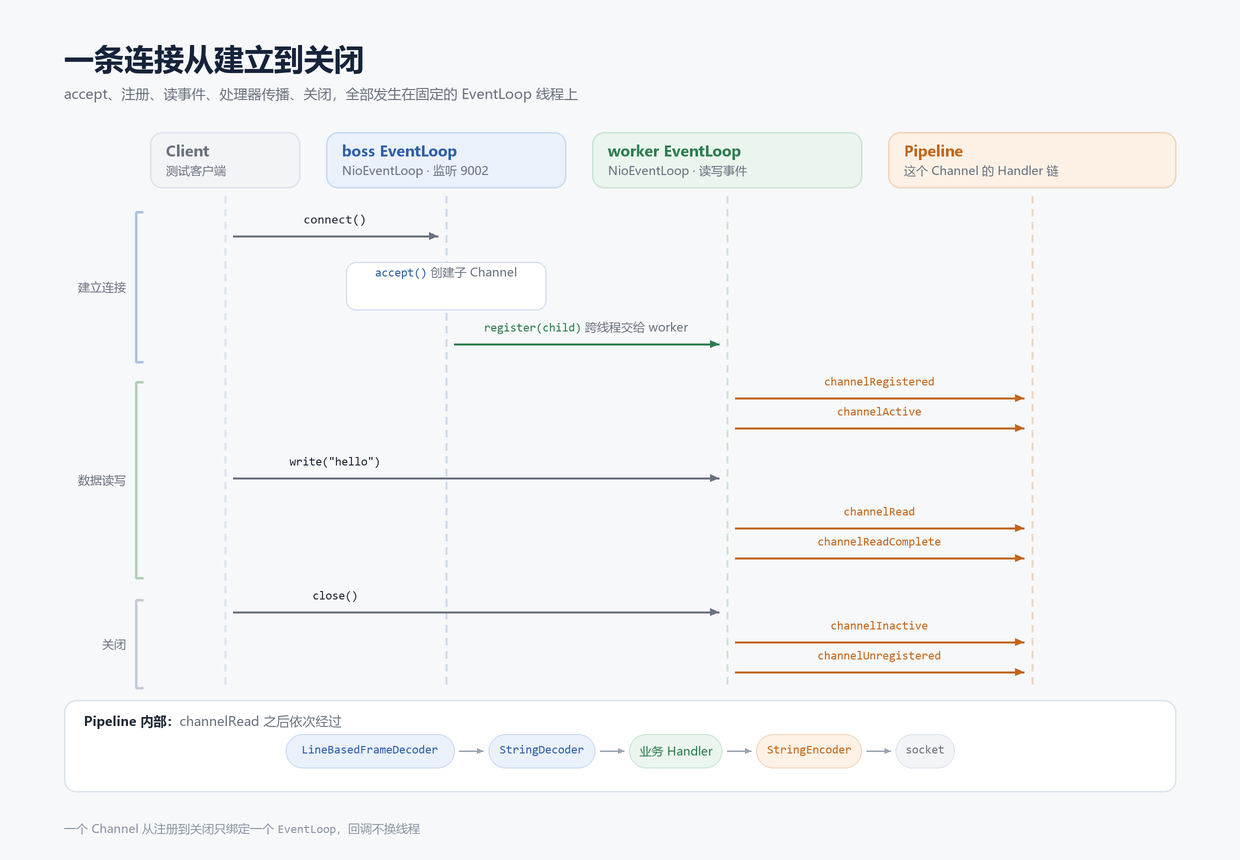
- 客户端
connect,服务端 boss EventLoopaccept出子 Channel; - 子 Channel 注册到 worker EventLoop,触发
channelRegistered、channelActive; - 数据到达,worker EventLoop 读到
ByteBuf,从 head 开始传播channelRead; - 帧解码器切出完整消息,消息解码器转成对象,业务 Handler 处理;
- 业务如果要写回,调用
ctx.writeAndFlush,事件从当前位置向 head 走,经过编码器写回; - 如果业务耗时,把它移出 EventLoop,处理完再切回来;
- 连接关闭,触发
channelInactive、channelUnregistered,closeFuture完成; - 整个过程的结果通过
ChannelFuture和监听器传递,不在 EventLoop 里同步等待。
Netty 4.2 的写法
本文的演示统一使用 NioEventLoopGroup,这是 4.1 和 4.2
都能跑的写法,也方便对照网上大多数教程。4.2 已经把它标记为
deprecated,推荐写法是:
1 | EventLoopGroup bossGroup = new MultiThreadIoEventLoopGroup(1, NioIoHandler.newFactory()); |
基本事件模型没有变:一个 EventLoop 一个线程,Channel
注册后不再迁移。但内部调度机制变了:4.1 用 ioRatio 控制 I/O
和任务的时间比例,默认 50;4.2.17
已经移除了这套逻辑,setIoRatio
是空操作、getIoRatio 恒返回 0,改为每轮 I/O
之后执行一个固定时间片的任务,默认约 1000 毫秒,可以通过
io.netty.eventLoop.maxTaskProcessingQuantumMs
调整。所以旧文章里“把 ioRatio 调成 30 让任务多跑一点”的调参结论,在 4.2
上已经不成立(4.2
迁移指南、4.2.0
发布说明)。
另外,pipeline.addLast(EventExecutorGroup, handler) 在
4.2 也已废弃,替代思路是手动 dispatch 到业务线程池,处理完再回
EventLoop。学习阶段先把 boss/worker
的职责、线程亲和性、任务队列这些机制理解清楚,比记住类名更重要;写新项目时再按
4.2 的 API 调整。
参考资料
官方源码与文档(Netty 4.2.17.Final)
- Netty
User Guide for
4.x:官方入门文档,
option/childOption、ctx.write与flush、Time 示例里编码器的位置都以此为准。 - ChannelPipeline.java(4.2.17
源码内
javadoc):入站/出站传播方向、出站求值顺序、
addLast示例。 - AbstractChannelHandlerContext.java:
ctx.write的走向、findContextOutbound、executor 切换与串行化。 - DefaultChannelPipeline.java:head/tail、
childExecutor、checkMultiplicity、handlerAdded延迟回调。 - AbstractChannel.java:注册、激活、关闭、注销的回调顺序。
- ChannelInitializer.java:
initChannel的调用时机与自我移除。 - AbstractNioByteChannel.java:
channelRead循环与一次channelReadComplete。 - SimpleChannelInboundHandler.java:自动释放与
@Sharable的关系。 - ChannelHandler.java(@Sharable 定义)、ChannelHandler.Sharable javadoc:注解的准确含义。
- DefaultPromise.java、ChannelFuture.java:监听器通知线程与死锁检测。
- DefaultChannelConfig.java、WriteBufferWaterMark.java:
AUTO_READ、水位线默认值。 - SingleThreadIoEventLoop.java、NioEventLoop.java:4.2
任务时间片与
ioRatio的移除。 - Netty 4.2 Migration Guide、Netty 4.2.0.Final released、Netty 4.2.17.Final released:版本差异与发布信息。
- PR #14538:Deprecate ChannelPipeline.add*(EventExecutorGroup…) methods:4.2 废弃该组 API 的一手动机。
中文解读与案例
- Netty 高性能之道(李林锋,InfoQ):无锁串行化设计、Reactor 与线程模型,本文事件线程一节的主要对照资料;腾讯云转载全文。
- Netty 堆外内存泄露排查盛宴(美团技术团队,2018-10-18):Log4j2 阻塞 NIO 线程的生产案例。
- Netty 源码—8. 编解码原理二(腾讯云开发者社区,2025-06-13):出站链路、编码器与写缓冲水位线。
- Netty 4.2.x 源码深度解析(二十):ChannelPipeline 结构(掘金,2026-10-21):基于 4.2 源码的 Pipeline 结构解析。
- Netty 源码—5.
Pipeline 和 Handler(博客园,2025-03-24):
ctx.write与channel.write从不同起点传播的源码对照。 - Netty 源码分析——ChannelPipeline 的事件传播(简书,2020-07-04):双向链表与传播方向的入门图景。
- Netty 源码分析之三:EventLoop(SegmentFault,2016-11-07):一个 Channel 一个 EventLoop 的早期源码分析。
- Netty 源码分析之四:Promise 与 Future(SegmentFault,2020-07-14):Promise 状态与监听器回调位置。
最后
Thank