了解HTTP协议
HTTP 简介
HTTP 是 Hyper Text Transfer Protocol,超文本传输协议,HTTP是万维网的数据通信的基础,是互联网的基石。
因为 HTTP
定义了客户端(如浏览器)与服务器之间如何通信,以传输超文本(如
HTML、图片、视频等)。作为应用层协议,HTTP
通过请求—响应模型交换消息。HTTP/1.1、HTTP/2 通常使用 TCP;HTTP/3
使用基于 UDP 的 QUIC。http URI 的默认端口为
80,https URI 的默认端口为 443。
HTTP的发展是由 蒂姆·伯纳斯·李 于1989年在欧洲核子研究组织(CERN)所发起,最初版本为HTTP/0.9,仅支持 GET 方法和纯文本响应。HTTP/1.0 默认采用非持久连接,HTTP/1.1 默认采用持久连接。
HTTP 的标准由 IETF 持续维护。RFC 2616 是理解 HTTP/1.1 历史的重要文献,但已经被后续规范取代。本文涉及的 HTTP 语义、缓存和 HTTP/1.1 消息语法,主要依据 2022 年发布的 RFC 9110、RFC 9111、RFC 9112;HTTP/2 和 HTTP/3 分别参考 RFC 9113 与 RFC 9114。
HTTP/2 与 HTTP/3 保留了 HTTP 的核心语义,主要改变消息编码、连接和传输机制。新版本并不意味着 HTTP/1.1 不再有效,也不宜用没有统计依据的“使用较少”“浏览器默认关闭”概括部署情况。
参考:RFC 9110、RFC 9112、RFC 9113、RFC 9114。
HTTP是一个客户端终端(用户)和服务器端(网站)请求和响应的应用层协议。它规定了双方如何发起请求、传递数据、返回结果,确保信息能被正确理解和处理。
HTTP
客户端向目标服务器发起请求,服务器解析请求并返回状态及可选内容。以
HTTP/1.1 为例,客户端可以建立或复用 TCP 连接,并收到形如
HTTP/1.1 200 OK 的状态行;HTTP/2、HTTP/3
的消息编码和底层传输机制有所不同,后文分别介绍。
而通过使用网页浏览器或者其它的工具,客户端发起一个HTTP请求到服务器上指定端口(默认端口为80)。我们称这个客户端为用户代理程序(user agent)。应答的服务器上存储着一些资源,比如HTML文件和图像。我们称这个应答服务器为源服务器(origin server)。在用户代理和源服务器中间可能存在多个“中间层”,比如代理服务器、网关或者隧道(tunnel)。而 HTTP 的请求通常由客户端(例如浏览器)发起,服务器根据请求生成响应。
设计 HTTP 最初的目的是为了提供一种发布和接收 HTML 页面的方法,通过 HTTP 或者 HTTPS 协议请求的资源由统一资源标识符(Uniform Resource Identifiers,URI)来标识。
HTTP是应用层协议
HTTP 本身是一个 应用层协议,它只关心 要做什么(比如获取网页、提交表单),但不关心 怎么传输,而 TCP 传输控制协议是互联网的传输层协议,负责确保数据可靠、有序地到达对方。IP 提供网络层寻址与分组传递,TCP 提供端到端的可靠、有序字节流,端口用于区分通信端点。
HTTP 的方法、状态码和头字段等语义,与具体传输版本应分开理解。HTTP/1.1、HTTP/2 常在 TCP 连接上交换消息;HTTP/3 将 HTTP 消息映射到 QUIC 流。QUIC 建立在 UDP 之上,并提供可靠传输、拥塞控制和流管理等机制。RFC 9114,§2
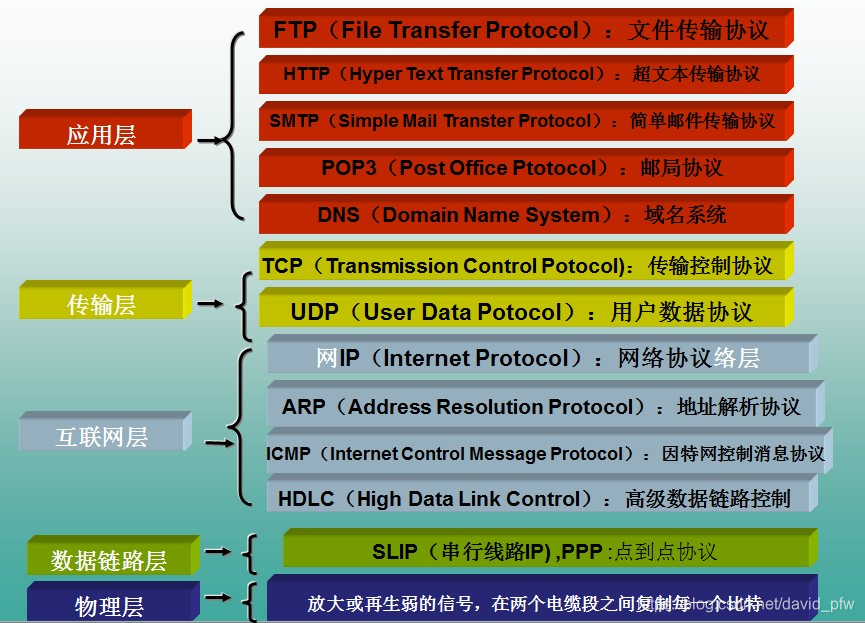
连接与流的机制随 HTTP 版本变化。以下工作流程主要以 HTTP/1.1 为例;不能把“每次 HTTP 请求都先建立 TCP 连接”推广到所有版本,已有连接通常也可以复用。
HTTP/1.1 默认支持持久连接,Connection: close
可表示当前消息后关闭连接。HTTP/2 在一个连接中复用多个流,并禁止使用
Connection 这类连接专属头字段。RFC
9112,§9.3、RFC
9113,§8.2.2
HTTP 的核心特点
HTTP 的设计简洁、灵活,也存在一些固有特性
无状态(Stateless)
HTTP 不自动建立跨请求的应用会话。服务器不能只凭“前一个请求发生过”就从协议中获得当前请求的业务上下文;应用可以使用 Cookie、认证凭据或 Session 识别用户及维护会话。无状态不代表请求、响应不能被记录或缓存。
注意,无状态描述的是协议不自动保存跨请求的应用上下文,与是否使用同一个连接无关。借助 Cookie 和服务端 Session,应用仍可以实现有状态会话;这也需要与 REST 的无状态约束区分。
非持久连接与持久连接
HTTP/1.0 默认每次请求后关闭 TCP 连接;这称为非持久连接,不代表底层无需建立连接。频繁重建连接会带来握手开销。HTTP/1.1 通过持久连接(Keep-Alive)允许同一连接处理多个请求 / 响应,大幅减少延迟。
媒体独立
HTTP 不限制传输的数据类型,支持 HTML、图片、视频、音频、文件等,只需通过Content-Type头指定数据格式。
HTTP 是简约的
HTTP/1.1 的起始行和头字段采用文本形式,便于阅读和调试,但消息体可以是二进制。HTTP/2、HTTP/3 使用帧编码,不能把所有 HTTP 报文都理解成明文文本。
HTTP是可扩展的
在 HTTP/1.0 中引入的 HTTP 标头(header)让协议扩展变得非常容易。只要服务端客户端之间对新标头的语义经过简单协商,新功能就可以被加入进来。
HTTP的工作流程
HTTP协议定义Web客户端如何从Web服务器请求Web页面,以及服务器如何把Web页面传送给客户端。
首先,HTTP采用了请求-响应模型。客户端向服务器发送一个请求报文,请求报文包含请求的方法、URL、协议版本、请求头部和请求数据。服务器以一个状态行作为响应,响应的内容包括协议的版本、成功或者错误代码、服务器信息、响应头部和响应数据。
HTTP 采用客户端—服务器交互模型;浏览器是常见客户端,但客户端也可以是移动应用、命令行工具或其他服务,不能将 HTTP 限定为 B/S 应用。普通 HTTP 交互由客户端发起请求,服务器返回响应。HTTP/2 还定义了服务器推送机制,后文会说明其使用边界。
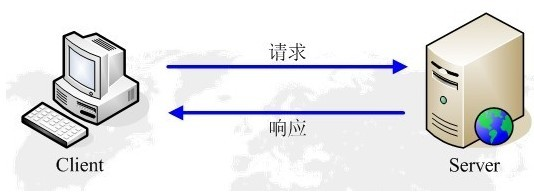
下面以获取一个网页的 HTTP/1.1 交互为例,假设需要建立新的 TCP 连接;若已有可复用连接,则不必重新握手。HTTPS 还需要建立 TLS 安全通道。步骤如下:
客户端连接到 Web 服务器,建立TCP连接
一个HTTP客户端,通常是浏览器,与Web服务器的HTTP端口(默认为80)建立一个TCP套接字连接。这部分涉及到了地址解析的相关内容(浏览器向 DNS 服务器请求解析该 URL 中的域名所对应的 IP 地址),解析出了地址信息才能开始建立连接
该连接是通过TCP来完成的,该协议与IP协议共同构建Internet,即著名的TCP/IP协议族,因此Internet又被称作是TCP/IP网络。HTTP是比TCP更高层次的应用层协议,根据规则,只有低层协议建立之后才能,才能进行更层协议的连接,因此,首先要建立TCP连接
发送 HTTP 请求
通过TCP套接字,客户端向Web服务器发送一个文本的请求报文,一个请求报文由请求行、请求头部、空行和请求数据4部分组成。应用生成 HTTP 消息,传输层再根据字节流及分段机制发送;一条 HTTP 消息不必对应一个 TCP 段
服务器接受请求并返回HTTP响应
Web服务器解析请求,定位请求资源。服务器将资源复本写到TCP套接字,由客户端读取。一个响应由状态行、响应头部、空行和响应数据4部分组成。
释放连接TCP连接
若 connection 模式为 close,则服务器主动关闭TCP连接,客户端被动关闭连接,释放TCP连接;若连接保持开放,则可继续用于后续消息,实际寿命由端点、超时和实现策略决定
这部分涉及到了 HTTP 的连接管理
Connection: keep-alive:在HTTP/1.1中,默认情况下,连接是保持活动的,即多个请求和响应可以共享同一个TCP连接,从而避免频繁建立和关闭连接的开销。这个特性称为”持久连接”。
Connection: close:客户端或服务器可以通过
Connection: close来关闭连接,表示该连接只处理当前请求和响应,之后就关闭连接。HTTP2.0 的多路复用下面说
客户端浏览器解析HTML内容,渲染页面
客户端浏览器首先解析状态行,查看表明请求是否成功的状态代码。然后解析每一个响应头,响应头告知以下为若干字节的HTML文档和文档的字符集。客户端浏览器读取响应数据HTML,根据HTML的语法对其进行格式化,并在浏览器窗口中显示。
所以说,在客户端请求的时候,数据在各层协议的整体组织如下
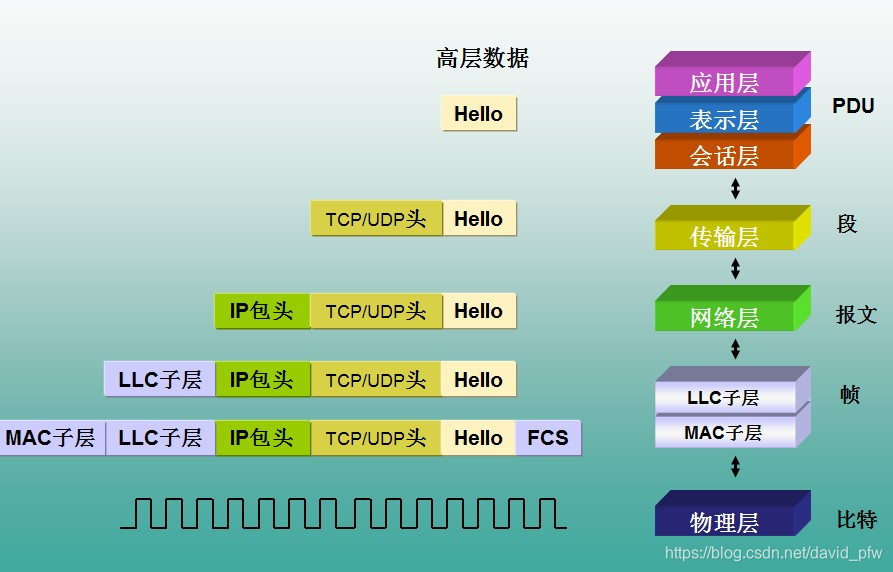
Nginx 服务器就是我们最常用的 Web 服务器
而经过上面的内容,可以总结出来 HTTP 协议由以下四部分构成
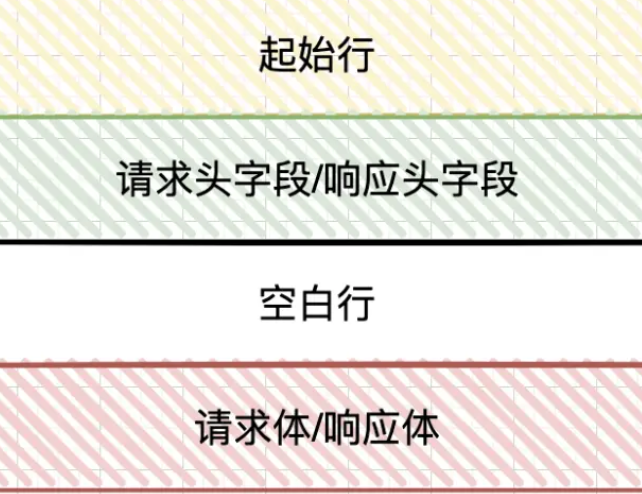
这个结构放到下面 HTTP 消息结构再详细讲解
HTTP的请求方法
HTTP 请求方法定义了客户端与服务器之间的交互方式,不同方法对应不同的语义和行为
注意:
- 方法名称是区分大小写的。当某个请求所针对的资源不支持对应的请求方法的时候,服务器应当返回状态码405(Method Not Allowed),当服务器不认识或者不支持对应的请求方法的时候,应当返回状态码501(Not Implemented)。
- HTTP服务器至少应该实现GET和HEAD方法,其他方法都是可选的。当然,所有的方法支持的实现都应当匹配下述的方法各自的语义定义。此外,除了上述方法,特定的HTTP服务器还能够扩展自定义的方法。例如PATCH(由 RFC 5789 指定的方法)用于将局部修改应用到资源。
GET
请求读取目标资源的表示,适合获取页面、文件或查询结果。
- 安全:请求语义为只读,不要求修改资源;记录日志等附带行为是允许的。
- 幂等:多次相同请求的预期效果与一次相同,不要求返回内容每次相同。
- GET 请求内容没有通用定义的语义,部分实现会拒绝它;公开接口通常使用查询参数,不应依赖 GET 请求体传参。
例如
GET /users?id=123&name=test。查询参数和请求体都不能仅凭所在位置就被视为安全:HTTPS
会保护传输中的路径、查询和内容,但 URL
还可能进入历史记录及日志。凭据不应放在 URL 中。
HTTP 没有规定统一的 GET 参数长度上限,也没有保证 POST
数据无限大。浏览器、服务器、代理和应用都可能施加限制,过长 URI
或过大内容可分别触发 414、413。
HEAD
语义与 GET 相同,但响应不包含内容。可以用于检查资源元数据、验证缓存等。
- 安全、幂等。
- 请求内容没有通用定义的语义,通常不发送。
- 响应通常提供对应 GET 会提供的头字段;规范允许省略只能在生成内容时确定的部分字段,因此不能保证一定返回资源大小。
POST
请求目标资源按自身语义处理提交内容。常见用途包括创建资源、提交表单和触发业务处理,并不限于新增数据库记录。
- 不安全:可能改变资源状态。
- 协议不保证幂等:重复提交可能重复创建或处理;具体接口可提供业务幂等机制。
- 通常携带内容,具体格式和处理规则由目标资源定义。
PUT
请求在指定 URI 创建或替换资源状态。客户端应提交接口契约要求的完整表示;不等于必须提交所有数据库字段。
- 不安全、幂等。
- 创建成功返回
201;修改已有资源成功通常返回200或204。 - 是否允许在资源不存在时创建、哪些字段由服务端管理,需要在 API 契约中明确。
DELETE
请求移除目标 URI 与其当前功能的关联。物理删除、软删除或归档属于服务端实现,不由 DELETE 方法保证。
- 不安全、幂等。
- 第一次删除返回
204、再次删除返回404,仍可能满足幂等语义,因为预期效果相同。 - 请求内容没有通用定义的语义,公开接口通常不依赖 DELETE 请求体。
PATCH
请求将补丁文档描述的修改应用于目标资源。
- 不安全,协议不保证幂等。设定固定值可以实现幂等,重复向数组追加元素则可能不幂等。
- 请求内容是修改指令,其解释依赖补丁媒体类型。常见标准包括 JSON Patch 与 JSON Merge Patch。
- 是否能创建不存在的资源,取决于补丁格式和服务端规则,不是 PATCH 的默认保证。
- 服务器必须原子地应用整份补丁,失败时不能保留部分修改。
参考:RFC 5789,§2。后文 RESTful API 部分会进一步区分 PUT、PATCH 和补丁格式。
OPTIONS
查询目标资源或服务器支持的通信选项,安全、幂等。它常用于浏览器 CORS 预检,但并非所有 OPTIONS 都是预检,也并非所有跨源请求都会预检。
OPTIONS 可以携带请求内容,但需要用 Content-Type
声明媒体类型;HTTP 没有定义通用的 OPTIONS 请求内容格式。可用
OPTIONS * 查询面向服务器整体的选项。
TRACE
执行应用层消息回环,用于诊断经过代理等组件后的请求情况,安全、幂等。TRACE 请求不得携带内容,客户端也不应发送认证凭据等敏感字段;服务端可因安全策略禁用它。
CONNECT
请求代理为目标建立隧道。传统 HTTP/1.1 示例为
CONNECT example.com:443 HTTP/1.1;成功后可在隧道中执行 TLS
握手并交换加密通信。
上述核心方法语义、请求内容限制及成功状态,参考 RFC 9110,§9。
HTTP状态码
当浏览者访问一个网页时,浏览者的浏览器会向网页所在服务器发出请求。当浏览器接收并显示网页前,服务器会在响应消息中提供 HTTP 状态码,表示这次请求的处理结果。
HTTP/1.1 响应的第一行是状态行;HTTP/2、HTTP/3 使用
:status 伪头字段表示状态,不存在相同的文本状态行。HTTP/1.1
状态行依次包含当前HTTP版本号,3位数字组成的状态代码,以及描述状态的短语,彼此由空格分隔。
状态代码的第一个数字代表当前响应的类型:
- 1xx消息——请求已被服务器接收,继续处理
- 2xx成功——请求已成功被服务器接收、理解、并接受
- 3xx重定向——需要后续操作才能完成这一请求
- 4xx请求错误——请求含有词法错误或者无法被执行
- 5xx服务器错误——服务器在处理某个正确请求时发生错误
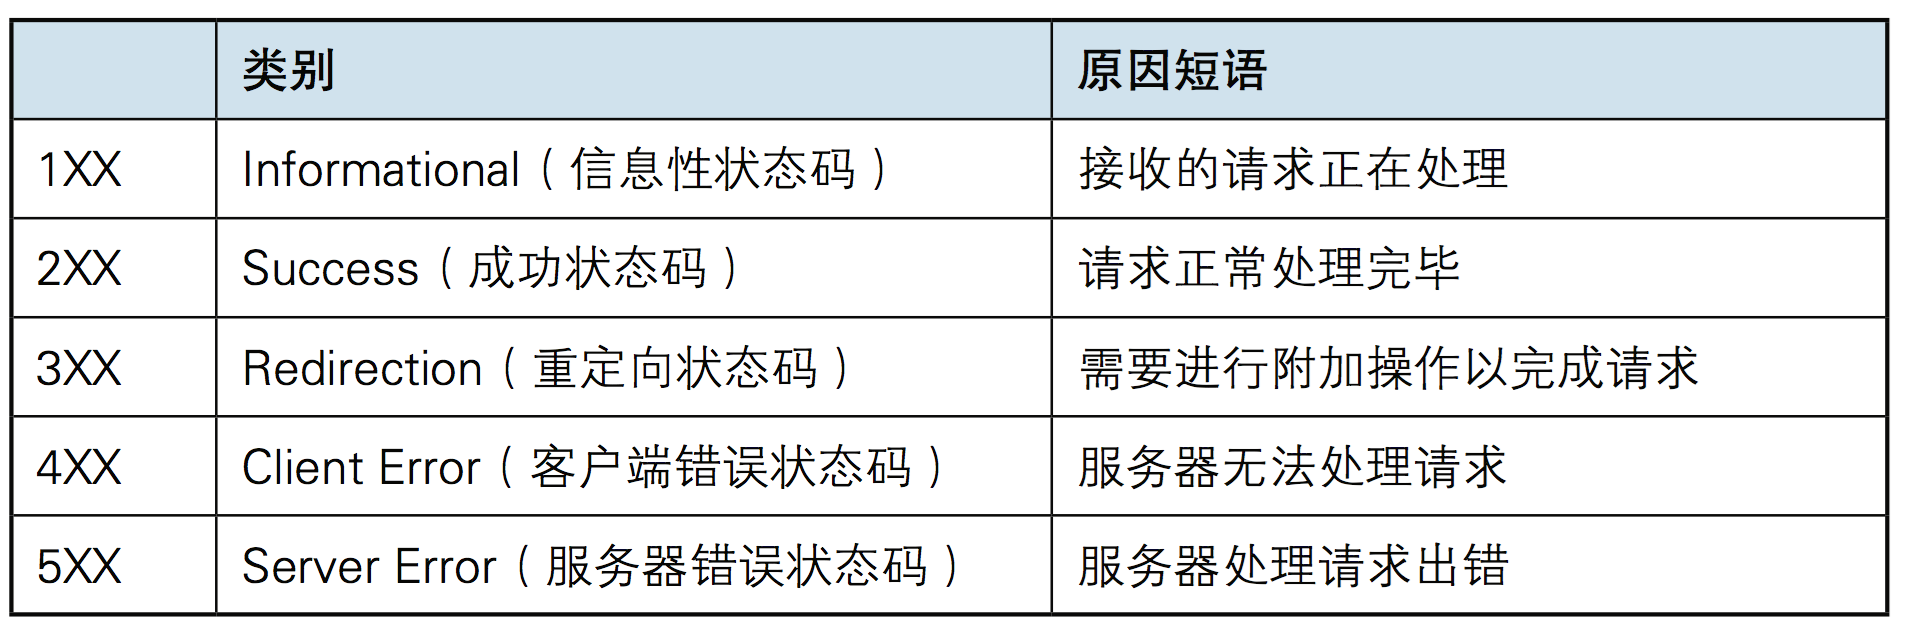
本文沿用原稿已有截图与历史示意图,图中的旧版本术语和说明没有逐项更新;协议结论以修订正文及所引用规范为准。
HTTP/1.1 的原因短语用于便于人阅读,可以为空,也不是程序判断结果的依据。客户端应根据数字状态码处理响应;HTTP/2、HTTP/3 不传输这类原因短语。RFC 9112,§4
常见状态码如下,其中核心状态语义参考 RFC 9110,§15,428、429 参考 RFC 6585。301、302 在自动重定向时允许历史上常见的 POST 转 GET 行为;307、308 则明确要求保留请求方法,不能把它们都概括成 GET 重定向。
HTTP状态码列表:
| 状态码 | 状态码英文名称 | 中文描述 |
|---|---|---|
| 100 | Continue | 继续。客户端应继续其请求 |
| 101 | Switching Protocols | 切换到 Upgrade 协商的协议,并非只能升级到“更高级”的 HTTP 版本 |
| 200 | OK | 请求成功。一般用于GET与POST请求 |
| 201 | Created | 已创建。成功请求并创建了新的资源 |
| 202 | Accepted | 已接受。已经接受请求,但未处理完成 |
| 203 | Non-Authoritative Information | 请求成功,但响应内容被转换代理相对于源服务器的 200 响应作了修改;与认证或授权无关 |
| 204 | No Content | 无内容。服务器成功处理,但未返回内容。在未更新网页的情况下,可确保浏览器继续显示当前文档 |
| 205 | Reset Content | 重置内容。服务器处理成功,用户终端(例如:浏览器)应重置文档视图。可通过此返回码清除浏览器的表单域 |
| 206 | Partial Content | 部分内容。服务器成功处理了部分GET请求 |
| 300 | Multiple Choices | 多种选择。请求的资源可包括多个位置,相应可返回一个资源特征与地址的列表用于用户终端(例如:浏览器)选择 |
| 301 | Moved Permanently | 永久移动。请求的资源已被永久的移动到新URI,返回信息会包括新的URI,浏览器会自动定向到新URI。今后任何新的请求都应使用新的URI代替 |
| 302 | Found | 临时移动。与301类似。但资源只是临时被移动。客户端应继续使用原有URI |
| 303 | See Other | 通过 Location 指向其他资源,通常以 GET 或 HEAD 获取该资源 |
| 304 | Not Modified | 条件 GET 或 HEAD 验证通过,可以按缓存规则复用已有表示;响应不含内容 |
| 305 | Use Proxy | 已废弃,不应作为新系统的代理协商机制 |
| 306 | Unused | 已经被废弃的HTTP状态码 |
| 307 | Temporary Redirect | 临时重定向;自动重定向时不得改变请求方法 |
| 308 | Permanent Redirect | 永久重定向;自动重定向时不得改变请求方法 |
| 400 | Bad Request | 客户端请求的语法错误,服务器无法理解 |
| 401 | Unauthorized | 请求要求用户的身份认证 |
| 402 | Payment Required | 保留,将来使用 |
| 403 | Forbidden | 服务器理解请求客户端的请求,但是拒绝执行此请求 |
| 404 | Not Found | 服务器无法根据客户端的请求找到资源(网页)。通过此代码,网站设计人员可设置”您所请求的资源无法找到”的个性页面 |
| 405 | Method Not Allowed | 客户端请求中的方法被禁止 |
| 406 | Not Acceptable | 服务器无法根据客户端请求的内容特性完成请求 |
| 407 | Proxy Authentication Required | 请求要求代理的身份认证,与401类似,但请求者应当使用代理进行授权 |
| 408 | Request Time-out | 服务器等待客户端发送的请求时间过长,超时 |
| 409 | Conflict | 请求与目标资源当前状态冲突,不限于 PUT |
| 410 | Gone | 客户端请求的资源已经不存在。410不同于404,如果资源以前有现在被永久删除了可使用410代码,网站设计人员可通过301代码指定资源的新位置 |
| 411 | Length Required | 服务器无法处理客户端发送的不带Content-Length的请求信息 |
| 412 | Precondition Failed | 客户端请求信息的先决条件错误 |
| 413 | Content Too Large | 请求内容过大;暂时性限制时可以提供 Retry-After |
| 414 | URI Too Long | 请求目标 URI 过长 |
| 415 | Unsupported Media Type | 服务器无法处理请求附带的媒体格式 |
| 416 | Range Not Satisfiable | 请求范围不可满足 |
| 417 | Expectation Failed(预期失败) | 服务器无法满足请求头中 Expect 字段指定的预期行为。 |
| 418 | Unused | 历史源于愚人节协议;当前 HTTP 语义规范将其保留为未使用状态码 |
| 422 | Unprocessable Content | 内容类型及语法可理解,但包含无法处理的指令 |
| 428 | Precondition Required | 服务器要求请求带有前置条件 |
| 429 | Too Many Requests | 请求过多,可以提供 Retry-After |
| 500 | Internal Server Error | 服务器内部错误,无法完成请求 |
| 501 | Not Implemented | 服务器不支持请求的功能,无法完成请求 |
| 502 | Bad Gateway | 作为网关或者代理工作的服务器尝试执行请求时,从远程服务器接收到了一个无效的响应 |
| 503 | Service Unavailable | 由于超载或系统维护,服务器暂时的无法处理客户端的请求。延时的长度可包含在服务器的Retry-After头信息中 |
| 504 | Gateway Time-out | 充当网关或代理的服务器,未及时从远端服务器获取请求 |
| 505 | HTTP Version not supported | 服务器不支持请求的HTTP协议的版本,无法完成处理 |
URL
所谓的网址,就是 URL,统一资源定位符,就是标记资源在互联网上的位置,它不仅是浏览器加载资源的地址,也是 HTTP 请求的目的地。
URL 是一种结构化的字符串,用来标识并定位资源。同一资源可能具有多个 URL,同一 URL 的表示也可能随时间变化,不能把它理解成数据库中的唯一键。
- 告诉 HTTP 客户端(如浏览器):从哪个服务器获取资源,以及获取哪个资源。
- 包含资源的访问方式(协议)、服务器地址(主机)、资源路径(路径)、参数(查询字符串)等关键信息。
例如
1 | https://www.example.com:8080/api/users?id=123&page=1#section1 |
这个 URL 表示:通过 HTTPS
协议,访问www.example.com服务器的 8080
端口,获取/api/users路径下的资源,并传递id=123和page=1两个参数,片段
section1 由客户端处理;它不会进入发送给服务器的 HTTP
请求目标。前端也可以自行解释片段,例如实现 hash 路由。
URL 的结构遵循 RFC 3986 标准,可以分解为下列组成部分(并非全部必选),按顺序排列如下:
1 | [协议]://[用户信息]@[主机]:[端口]/[路径]?[查询参数]#[片段标识符] |
其中
协议就是客户端与服务端的通信协议,不止 HTTP
协议,ftp:,file:,mailto:等也经常出现。
而用户信息是用于身份验证的用户名和密码,格式是用户名:密码,现代
URL 几乎不使用此部分,已被 HTTP
的Authorization请求头替代。
主机就是指定资源所在服务器的域名或IP 地址,若使用域名,需通过 DNS 解析为 IP 地址。
端口就是指定服务器上的服务端口号,区分同一主机上的不同服务。
路径标识服务端命名空间中的资源,不一定对应服务器文件系统中的目录或文件。
查询参数就是向服务器传递额外参数,以 ?
引入。Web API 常约定参数用 & 分隔、以
key=value 表达,但 URI
规范并未要求所有查询字符串必须采用键值对。
片段标识符是用于定位资源内部的特定部分,以#开头,后面跟片段名称,例如
HTML 的锚点定位。片段标识符不会进入 HTTP
请求目标,由客户端处理,若资源是 API 接口,片段通常无效。
URI 的保留字符可以按语法直接承担分隔作用,例如 ?
引入查询、#
引入片段。只有在需要把它们作为特定组成部分中的普通数据、且可能产生语义歧义时,才需要进行百分号编码;不能把完整
URL 的分隔符全部编码。
- 保留字符:
: / ? # [ ] @ ! $ & ' ( ) * + , ; =。 - 非保留字符:字母、数字和
- . _ ~,可以直接使用。 - 百分号编码:
%XX表示一个八位字节,而不是笼统的“字符 ASCII 码”。中文通常先转为 UTF-8 字节再逐字节编码,例如“你好”为%E4%BD%A0%E5%A5%BD。 - 空格:通常编码为
%20。+代表空格是application/x-www-form-urlencoded等表单编码的约定,不是所有 URI 组成部分的通用规则。
参考:RFC 3986,§2。
JavaScript
中可使用encodeURIComponent()编码查询参数,解码使用decodeURIComponent()
HTTP消息结构
HTTP 消息分为请求和响应。下面介绍 HTTP/1.1 的文本消息语法:起始行、头字段、空行,以及可选消息体。HTTP/2、HTTP/3 使用帧承载消息,不能直接套用文本报文结构。RFC 9112,§2
文中的报文示例若包含 # 注释或
[二进制数据],属于教学示意;这些注释、占位符不是实际报文字节。消息长度示例按实际消息体字节数计算,不能把字符数或注释计入长度。
1 | POST /api/users HTTP/1.1 # 请求行 |
HTTP请求格式
客户端发送一个 HTTP 请求到服务器的请求消息,包括以下格式:请求行(request line)、请求头部(header)、空行和请求数据四个部分
下图给出了请求报文的一般格式
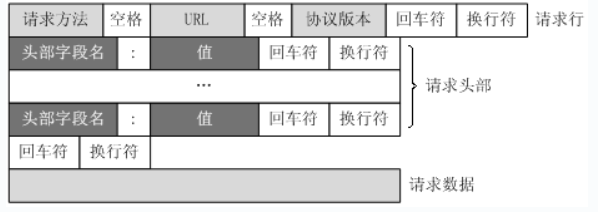
来看我往 osu 浏览器发送了一个下载的请求
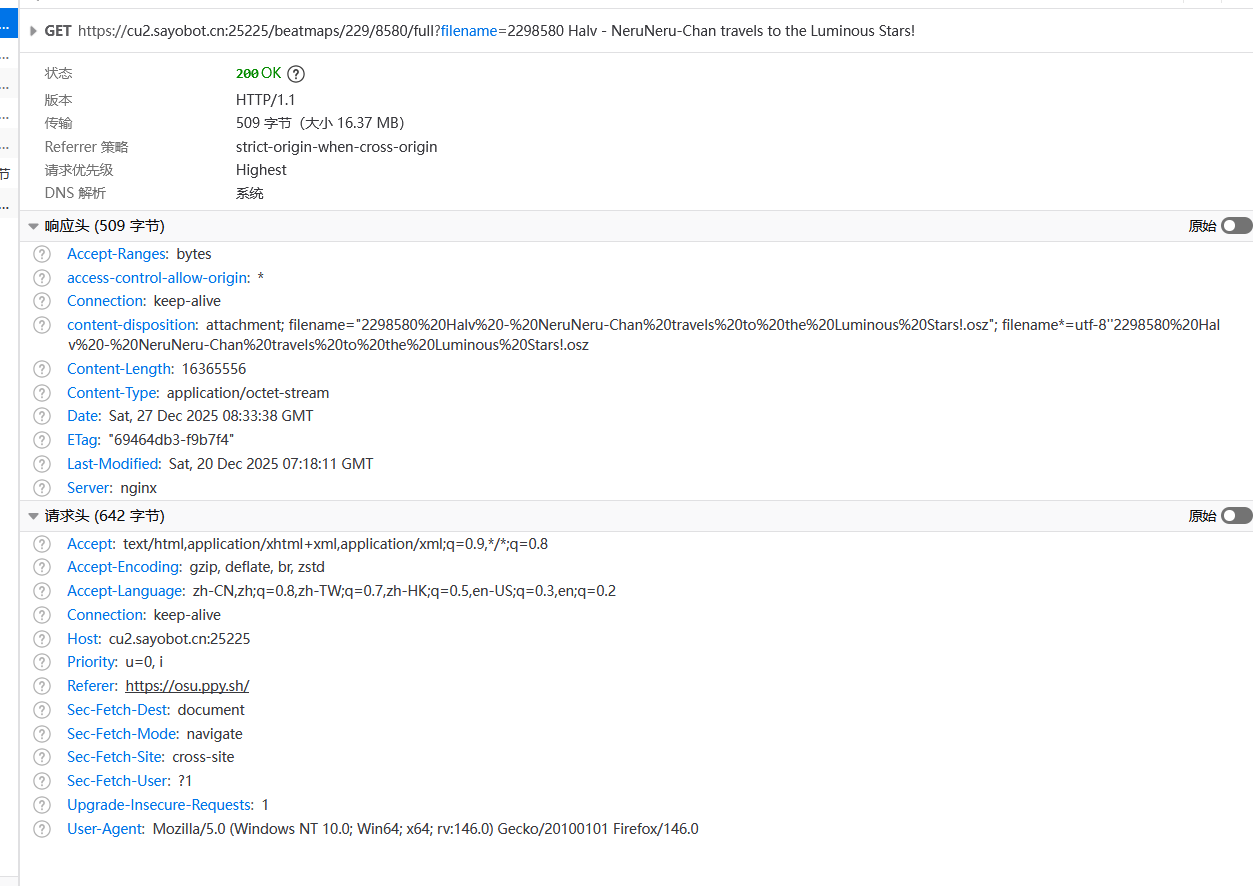
其中,请求行非常显眼而且清晰,请求行是 HTTP 请求的第一行,也是最关键的一行,必须存在,格式为
1 | 请求方法 + 空格 + 请求目标 + 空格 + HTTP版本 + 回车换行 |
直接访问源服务器时,请求目标通常采用 origin-form,即以 /
开头的路径和可选查询字符串。但它还有其他形式:代理请求可以使用完整
URI,CONNECT 使用主机和端口,服务器级 OPTIONS 可以使用
*。所以“必须以 / 开头”只适用于通常的
origin-form。RFC
9112,§3.2
例如GET /api/users?page=1&size=10 HTTP/1.1,POST /api/users HTTP/1.1等都是请求行
上述的请求头就是这样的
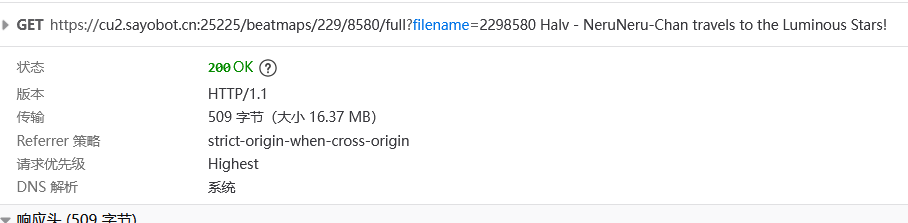
请求头是请求行之后、空行之前的多行文本,每一行都是一个 “键值对”,作用是向服务器传递元信息,如请求的主机、数据格式、认证信息等,格式为:
1 | 头字段名: 头字段值 + 回车换行(\r\n) |
- HTTP/1.1 头字段名大小写不敏感,
Host与host等价;HTTP/2、HTTP/3 中传输的字段名必须小写 - 字段名与冒号之间不允许有空白;冒号后的空白是可选的,惯例写作一个空格。HTTP/1.1
中字段行以
\r\n结束 - 旧资料常按“通用头、请求头、实体头”分组;现代规范更强调每个字段的具体语义,例如表示元数据、内容协商、认证及条件请求。
- HTTP/1.1 请求必须包含 Host,通常携带 URI 中的主机和可选端口。其他字段是否必须,取决于方法、消息内容、协议语义及接口契约,不能一概认为均可省略。
那么,常用的请求头如下
| 头字段名 | 作用 | 示例 |
|---|---|---|
| User-Agent | 标识客户端类型(浏览器 / 手机 / 爬虫),服务器可据此返回适配内容 | User-Agent: Mozilla/5.0 (Windows NT 10.0; Chrome/120.0.0.0) |
| Content-Type | 声明消息内容的媒体类型,是否需要取决于具体请求 | Content-Type: application/json(JSON 格式)Content-Type: application/x-www-form-urlencoded(表单格式)Content-Type: multipart/form-data(文件上传) |
| Content-Length | 声明请求体的字节长度(服务器据此判断请求体是否完整) | Content-Length: 27(表示请求体有 27 个字节) |
| Authorization | 传递认证信息(如 Token、账号密码) | Authorization: Bearer eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9… |
| Accept | 声明客户端能接受的响应格式(如 JSON/XML/HTML) | Accept: application/json, text/html |
| Cookie | 传递客户端的 Cookie 信息(维持会话) | Cookie: sessionid=123456; username=zhangsan |
| Connection | 声明连接类型(keep-alive 表示长连接,close 表示短连接) | Connection: keep-alive |
下属是一个完整的请求头示例
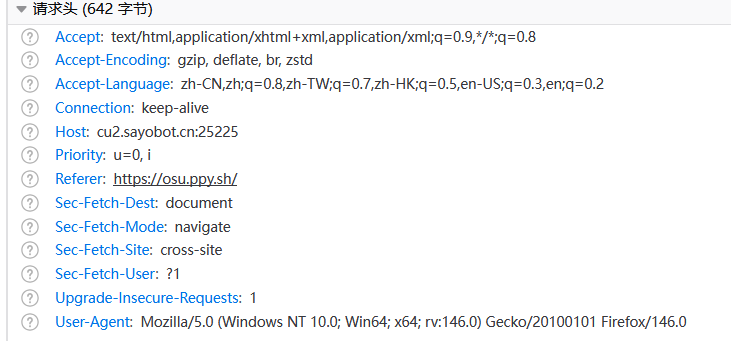
空行是单个回车换行(),作用是告诉服务器:请求头已经结束,接下来是请求体(如果有的话),而且空行必须存在,即使没有请求体,注意空行不能有任何字符(包括空格、制表符),否则服务器会把后续内容当成请求头解析,导致错误;
请求体是可选部分。GET、HEAD、DELETE 的请求内容没有通用定义的语义,客户端不应依赖它来改变目标资源或请求含义;公开 API 通常避免发送这类请求体。
- 请求体格式由
Content-Type声明。HTTP/1.1 请求体边界通常通过Content-Length或Transfer-Encoding: chunked确定,不能认为必须始终有 Content-Length。 - 请求体是纯文本 / 二进制数据,如 JSON 字符串、表单数据、文件二进制,这是 HTTP 协议可视化的重要因素
常见请求体格式
1 | # 请求头声明格式 |
1 | # 请求头声明格式 |
1 | # 请求头声明格式(boundary是分隔符,随机生成) |
HTTP响应格式
HTTP 响应向客户端传递处理结果。下面仍以 HTTP/1.1 为例,起始行与头字段采用文本格式,消息体可以是二进制,所以 HTTP 响应也由四个部分组成,分别是:状态行、消息报头、空行和响应正文。例如
1 | 200 OK # 状态行 |
状态行是 HTTP 响应的第一行,也是最关键的一行,必须存在,格式为:
1 | HTTP版本 + 空格 + 状态码 + 空格 + 状态描述 + 回车换行(\r\n) |
HTTP 版本就是要声明一下使用的 HTTP
协议版本,状态码由状态行返回,状态描述就是对状态码的解释,回车换行还是\r\n
响应头是状态行之后、空行之前的多行文本,每一行都是一个 “键值对”,作用是向客户端传递元信息(如响应的内容格式、长度、缓存策略、认证信息等),格式和请求头一样:
1 | 头字段名: 头字段值 + 回车换行(\r\n) |
- HTTP/1.1 头字段名大小写不敏感,不要求首字母大写
- 字段名与冒号之间不能有空白;冒号后允许可选空白,惯例使用一个空格;HTTP/1.1
字段行以
\r\n结束。 - 响应可以包含多个头字段,但实现会设置总长度及字段数限制;字段含义需要按各自规范解释。Content-Type 描述内容类型,Content-Length 参与消息长度处理,两者不能混用。
那么常用的响应头如下
| 头字段名 | 作用 | 示例 |
|---|---|---|
| Date | 声明响应的发送时间(通常为 GMT 格式) | Date: Mon, 10 Jul 2023 12:00:00 GMT |
| Content-Type | 声明响应体的格式(服务器据此告诉客户端如何解析数据) | Content-Type: application/json(JSON 格式)Content-Type: text/html(HTML 格式)Content-Type: image/jpeg(图片格式) |
| Content-Length | 声明响应体的字节长度(服务器据此告诉客户端需要接收多少数据) | Content-Length: 120(表示响应体有 120 个字节) |
| Content-Encoding | 声明响应体的压缩格式(如 gzip、br) | Content-Encoding: gzip(表示响应体已用 gzip 压缩) |
| Cache-Control | 声明客户端的缓存策略(控制浏览器是否缓存响应体) | Cache-Control: max-age=31536000(缓存 1 年)Cache-Control: no-cache(可存储,复用前必须成功验证) |
| Expires | 声明响应体的过期时间(与 Cache-Control 类似,优先级低于 Cache-Control) | Expires: Mon, 10 Jul 2024 12:00:00 GMT |
| Location | 标识重定向目标,也可在 201 响应中标识新建资源 | Location: https://www.example.com |
| Set-Cookie | 向客户端设置 Cookie 信息(维持会话,如 sessionid) | Set-Cookie: sessionid=123456; Path=/ |
| WWW-Authenticate | 声明认证方式(仅 401 状态码使用,如 Basic Auth) | WWW-Authenticate: Basic realm=“example.com” |
| Server | 声明服务器软件(如 Nginx、Apache、Tomcat) | Server: Nginx/1.21.6 |
| X-Frame-Options | 声明是否允许在 frame/iframe 中嵌入页面(防止点击劫持) | X-Frame-Options: DENY(禁止嵌入) |
| Content-Security-Policy | 限制允许加载或执行的内容来源,是浏览器内容安全策略的一部分 | Content-Security-Policy: default-src ‘self’ |
例如,我加载 osu 的主页图
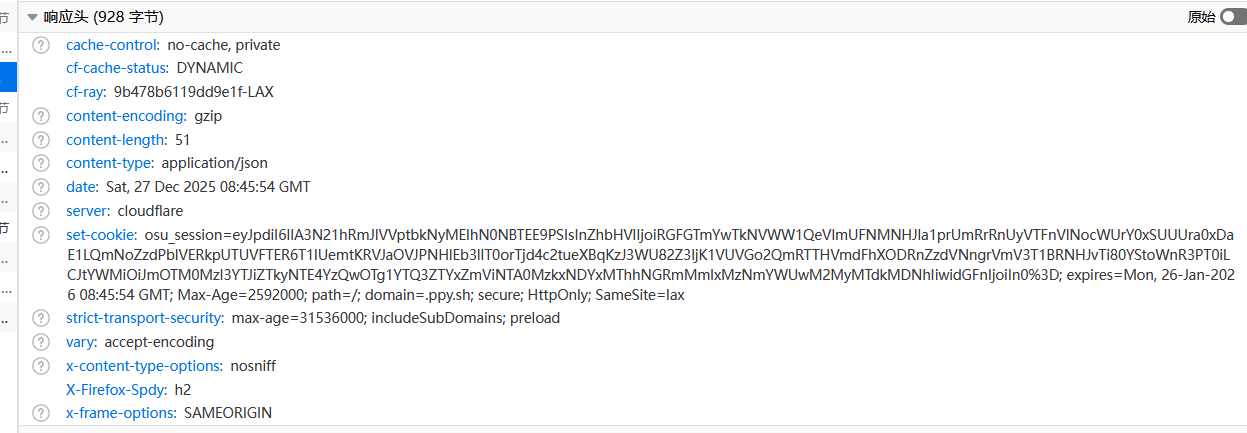
空行是单个回车换行(),作用是告诉客户端:“响应头已经结束,接下来是响应体(如果有的话)”。
- 一样,空行必须存在,即使没有响应体,而且空行不能有任何字符
响应体是可选部分,仅当服务器需要向客户端传递数据时存在(如成功返回资源、错误返回错误信息),204 No Content、304 Not Modified 响应以及 HEAD 响应不包含消息体;1xx 响应也不包含消息体。
- 响应内容格式由
Content-Type声明;HTTP/1.1 响应消息体边界还可能由分块编码或连接关闭确定,并非所有响应都有 Content-Length。 - 响应体是纯文本 / 二进制数据,请求体响应体可读几乎是HTTP可读的核心
常见响应体格式示例
1 | # 响应头声明格式 |
1 | # 响应头声明格式 |
1 | # 响应头声明格式 |
掌握消息结构后,可以使用 curl、浏览器开发者工具或受控的本地服务观察 HTTP 请求与响应。
消息体边界与分块编码
Content-Length
表示字节数,不是字符数,也不是整个报文的长度。中文和压缩内容尤其需要按实际发送的字节计算,不能把示例数字直接复制到真实请求中。
HTTP/1.1 的 Transfer-Encoding: chunked
通过多个块传输消息体:每块给出十六进制长度,最后用零长度块结束;它用于消息分帧,与
gzip
这样的内容压缩不同。某些响应也可以由关闭连接标记结束,但这种方式不能继续复用该连接。
发送方不得同时发送 Transfer-Encoding 和
Content-Length。代理与源服务器若对消息边界解释不同,可能产生请求走私风险;接收方需按规范处理异常长度及冲突字段。RFC
9112,§6、§7.1、§11.2
HTTP/2、HTTP/3 通过帧和流结束机制确定消息边界,不使用 HTTP/1.1 的 chunked 传输编码。
HTTP content-type
Content-Type,如图字面含义,就是内容的类型,一般是指网页中存在的Content-Type,用于定义网络文件的类型和网页的编码,决定浏览器将以什么形式、什么编码读取这个文件,明确告诉服务器如何解析请求体或客户端如何解析响应体
Content-Type
的核心功能是声明数据的媒体类型(MIME Type),至于什么是
MIME 类型,下面说
在请求中(Request)
- 作用:告诉服务器 我发送的请求体数据是什么格式,服务器据此解析数据。
- 位置:位于请求头中,描述消息内容时通常应提供,例如 POST、PUT、PATCH 的内容;具体要求取决于方法和接口契约。

在响应中(Response)
- 作用:告诉客户端 “我返回的响应体数据是什么格式”,客户端据此解析数据。
- 位置:位于响应头中,通常用于描述响应内容;HEAD 等无响应内容的消息也可以携带对应表示的元数据。
Content-Type 的分类与常见类型
Text 文本类型
声明数据为纯文本格式,可直接阅读
类型 说明 示例场景 text/plain纯文本(无格式,如 TXT 文件) 发送普通文本 text/htmlHTML 格式 服务器返回 HTML 页面 text/xmlXML 格式 旧版 API 接口 text/cssCSS 格式 服务器返回 CSS 样式文件 text/javascriptJavaScript 格式 服务器返回 JS 脚本文件 text/markdownMarkdown 格式 文档展示 Application 应用类型
声明数据为 应用程序专用格式,通常是结构化数据
类型 说明 示例场景 application/jsonJSON 格式(最常用,API 接口首选) RESTful API 返回 JSON 数据 application/xmlXML 格式(用于数据交换,如 SOAP、RSS) 旧版企业级 API application/x-www-form-urlencodedURL 编码格式(键值对拼接,如 key1=value1&key2=value2)网页表单提交(默认格式) application/json-patch+jsonJSON Patch 格式(用于部分更新 JSON 资源) 增量更新 API application/octet-stream二进制流格式(通用二进制数据,无特定格式) 文件上传(需结合 filename)application/pdfPDF 格式 下载 PDF 文件 application/zipZIP 格式 下载压缩包 Multipart 多部分类型
声明数据由多个部分组成,如表单中的文本字段 + 文件上传,需通过
boundary(分隔符)分割不同部分。类型 说明 示例场景 multipart/form-data表单数据格式(支持文本字段和文件上传) 网页文件上传(如头像上传) multipart/mixed混合格式(包含多个不同类型的部分,如文本 + 图片) 邮件附件(文本 + 文件) multipart/related关联格式(部分之间有引用关系,如 HTML + 图片) 富文本邮件(HTML + 附件) Image 图片类型,Video 视频类型,Audio 音频类型
不多说了
Content-Type
除了主类型和子类型,还可以包含参数(键值对),用于补充说明数据的细节。常见参数如下。注意,文件名
filename 是 Content-Disposition 的参数,不是
Content-Type 的参数。
| 参数名 | 作用 | 示例 |
|---|---|---|
charset |
声明数据的字符编码(如 UTF-8、GBK) | Content-Type: text/html; charset=UTF-8 |
boundary |
声明多部分数据的分隔符(仅multipart类型需要) |
Content-Type: multipart/form-data; boundary=----WebKitFormBoundary7MA4YWxkTrZu0gW |
type |
在 multipart/related 中描述根部分的媒体类型 | Content-Type: multipart/related; boundary=example; type="text/html" |
MIME 类型
MIME (Multipurpose Internet Mail Extensions) 是描述消息内容类型的标准,用来表示文档、文件或字节流的性质和格式。
MIME 消息能包含文本、图像、音频、视频以及其他应用程序专用的数据。
浏览器通常使用 MIME 类型,而不是文件扩展名,因为文件扩展名不够可靠,来确定如何处理URL,因此 Web 服务器在响应头中添加正确的 MIME 类型非常重要。如果配置不正确,浏览器可能会无法解析文件内容,网站将无法正常工作,并且下载的文件也会被错误处理。
JSON 应使用 application/json,不是
text/json。不同媒体类型支持的参数由对应规范定义;网络交换中的
JSON 应使用 UTF-8,RFC 8259 并未为 application/json 定义
charset 参数。RFC
8259,§8.1、§11
文件上传中,文件名属于该部分的 Content-Disposition;详见
RFC
7578,§4.2。
MIME 类型通用结构:
1 | type/subtype |
参数的含义由对应媒体类型定义;例如 multipart/related 的 type 参数见 RFC 2387,§3.1。
MIME 的组成结构非常简单,由类型与子类型两个字符串中间用
/分隔而组成,不允许有空格。
type
表示可以被分多个子类的独立类别,subtype
表示细分后的每个类型。
MIME类型对大小写不敏感,但是传统写法都是小写。
两种主要的 MIME 类型在默认类型中扮演了重要的角色:
text/plain表示文本文件的默认值。application/octet-stream表示所有其他情况的默认值。
常见的 MIME 类型如下:
HTTPS
还记得 HTTP 协议有一个重要特征就是 HTTP 是简约的,也就是可读的,因为 HTTP 最初设计时数据是明文在网络上传输的,也就是任何人只要拦截了网络,就可以不费吹灰之力获取到HTTP请求/响应内容,从而非法获取信息。
HTTPS 协议是 HyperText Transfer Protocol Secure(超文本传输安全协议)的缩写,是一种通过计算机网络进行安全通信的传输协议。它相比 HTTP 更加安全,因为 未经 TLS 等保护的 HTTP 通信缺少传输机密性和完整性保护,可能会被窃听或篡改,它解决了 HTTP 的三大安全问题:
- 窃听:数据在传输过程中被第三方拦截并查看内容(如监听网络流量)。
- 篡改:数据在传输过程中被第三方修改(如修改网页内容、注入恶意代码)。
- 伪造:第三方伪装成服务器或客户端,与对方建立虚假连接。
HTTPS 通过 TLS 保护 HTTP 通信,为数据传输提供了加密和身份验证。HTTPS 经由 HTTP 进行通信,但利用 SSL/TLS 来加密数据包,HTTPS 开发的主要目的,是提供对网站服务器的身份认证,保护交换资料的隐私与完整性。
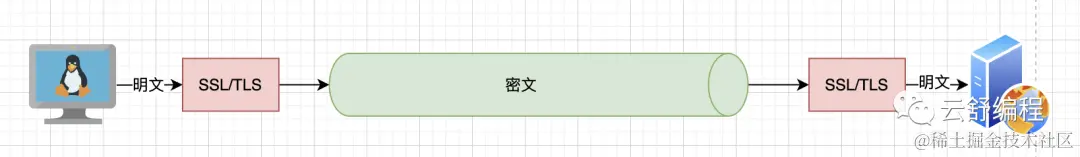
可以看到,HTTPS 的主要作用是在不安全的网络上创建一个安全信道,并可在使用适当的加密包和服务器证书可被验证且可被信任时,对窃听和中间人攻击提供合理的防护。
HTTP 的 URL 是由 http:// 起始与默认使用端口 80,而 HTTPS 的 URL 则是由 https:// 起始与默认使用端口443。
那么,HTTPS 怎样建立安全通信?现代部署使用 TLS,SSL 是历史协议名称。下面以完整的、基于证书认证和 (EC)DHE 密钥协商的 TLS 1.3 握手为例;会话恢复、PSK 和 0-RTT 有不同流程。
- 客户端发送 ClientHello。 提供支持的 TLS 版本、密码套件、密钥协商组和密钥份额等。TLS 1.3 密码套件描述记录保护算法与相关哈希,不再把 RSA 密钥交换等机制绑定进套件名称。
- 服务器发送 ServerHello。 选择双方支持的参数,并给出自己的密钥份额。双方据密钥协商结果派生握手流量密钥;不是客户端生成完整会话密钥后用证书公钥直接发送。
- 服务器发送证书及握手证明。 后续握手消息受到加密保护;CertificateVerify 的签名证明服务器掌握相应私钥,Finished 验证握手完整性。
- 客户端验证服务器。 验证证书链、信任锚、有效期和访问主机名等,并验证握手签名及 Finished。证书可以经过中间 CA,不能简化为始终由根 CA 直接签发。
- 双方完成握手并交换应用数据。 派生应用流量密钥,使用对称的认证加密保护 HTTP 数据。
这套机制把密钥协商、身份认证和数据加密分开处理。TLS 1.3 已移除静态 RSA 密钥传输;把“客户端用服务器公钥加密随机数/会话密钥,服务端解密”作为现代 TLS 的通用流程是不准确的。公钥签名也不能笼统地解释为“私钥加密”。RFC 8446,§1.2、§2、§4
HTTPS 通常认证服务器;只有采用客户端证书等机制时,才涉及相应的客户端 TLS 身份认证。用户登录和业务授权仍由应用处理。HTTPS 保护传输中的 HTTP 数据,但不保证终端、日志、数据库或业务权限本身安全。
本文保留的前面两幅示意图用于观察 HTTP 与安全传输的分层及默认端口,具体握手过程以上述限定场景和 TLS 规范为准。
HTTP2一些值得注意的特点
二进制分帧
HTTP/2 最核心的底层优化是引入了二进制分帧层,它将所有传输的内容(请求头、请求体、响应头、响应体)都拆分为更小的帧(Frame),每个帧包含类型、标志、流 ID、长度等元数据。
所以说,HTTP2 从 HTTP1 的文本协议,变成了二进制协议
那么解析方式也从逐行解析变成了按帧解析,二进制帧让消息边界和流的处理方式更明确,便于多路复用。具体解析效率和延迟仍受实现、负载及网络条件影响,不能仅凭二进制格式就推导出必然更快。
多路复用
HTTP/2 可以在同一连接上交错传输多个流的消息;HTTP/1.1 也可以使用多个连接并发,因此这里比较的是同一连接内的消息组织。
HTTP/2 的多路复用是基于 流(Stream)的,每个流是一个独立的双向字节流。流的创建和管理由 HTTP/2 的分帧层处理。
这样可以减少延迟,提高效率,提高网络吞吐量。它缓解了 HTTP/1.1 同一连接上响应必须按请求顺序发送所造成的应用层队头阻塞;但 HTTP/2 基于 TCP,TCP 丢包造成的传输层队头阻塞仍可能影响多个流。
什么是队头阻塞
HTTP/1.1 若使用流水线,可以在前一个响应完成前发送后续请求,但响应必须按请求顺序返回;不使用流水线时,客户端通常等待响应后再在该连接上发起下一个请求。例如:
- 客户端发送请求 1(请求一个大图片)。
- 服务器开始处理请求 1,但由于图片较大,响应需要一段时间。
- 客户端发送请求 2(请求一个小 CSS 文件)。
- 由于请求 1 的响应未完成,请求 2 被阻塞,直到请求 1 的响应完成。
这种情况下,请求 2 必须等待请求 1 完成,即使请求 2 的数据量很小,这会导致整体性能下降。
HTTP/2 通过为每个请求 / 响应分配一个唯一的流 ID(Stream ID),不同流的帧可以在同一个 TCP 连接上并行传输。
- 客户端发送请求 1(流 ID=1)。
- 客户端发送请求 2(流 ID=3;客户端发起的流使用奇数 ID)。
- 服务器处理请求 1 和请求 2,可以交错发送两个响应的帧。
- 客户端根据流 ID 将响应 1 和响应 2 分配给对应的请求。
这样,请求 2 的帧不必等待请求 1 的整个响应结束。不过,TCP 丢包、连接级流量控制或服务端调度仍可能阻塞传输。HTTP/3 使用 QUIC 独立流,降低跨流的丢包阻塞,但同一流内部仍要求有序交付。RFC 9113,§5、RFC 9114,§2
头部压缩
HTTP/2 使用 HPACK 算法对 HTTP 头部进行压缩,减少了头部传输的数据量,从而减少了网络延迟。
HPACK 使用静态表、动态表及字面量编码,字符串还可以采用 Huffman 编码。适合索引的字段可以用索引表示;敏感字段也可以选择不加入动态表。动态表按连接中的方向维护,是有状态的压缩机制,不能跨连接直接复用。RFC 7541
HTTP/2 的头部压缩是在分帧层实现的,每个请求和响应的头部都会被压缩后传输。
服务器推送
HTTP/2 支持服务器推送,允许服务器在客户端请求之前推送资源,以提高性能。
服务器推送是指服务器在响应一个请求时,主动推送客户端可能需要的其他资源(如图片、CSS、JS 等)。
推送在资源确实需要且未被缓存时可能减少等待;如果推送了已有缓存或不需要的资源,也可能浪费带宽并降低性能。
服务器使用 PUSH_PROMISE
帧声明准备推送的请求,再通过推送流发送相应响应。它是可选机制,客户端可以禁用,并不等同于业务消息推送或
WebSocket。RFC
9113,§8.4
部署时还要检查客户端支持。Chrome 已从 106 版本起默认禁用 HTTP/2 Server Push,因此不能把它作为现代浏览器性能优化的默认前提。Chrome 官方说明
连接复用
HTTP/1.1 默认采用持久连接;HTTP/2 进一步允许同一连接承载多个并发流。流结束不意味着连接必须关闭,连接关闭也不由某一个流结束直接决定。连接级关闭可使用 GOAWAY 等机制,服务端仍可设置空闲超时。RFC 9113,§5、§6.8
HTTP/2 与 HTTPS
HTTP/2 协议可以运行于 TLS 加密连接,也支持满足规范要求的明文 TCP 场景。因此,“二进制分帧依赖 TLS,所以 HTTP/2 必须 HTTPS”并不成立。
主流浏览器的 HTTP/2 部署通常要求 TLS,并通过 ALPN 协商协议。需要区分协议允许的形式与特定客户端的实现政策。HTTP/2 使用 TLS 时还有明确的版本及配置要求,不能描述成“支持 TLS 的所有扩展”。RFC 9113,§3、§9.2
兼容性
HTTP/2 可以与 HTTP/1.1 共存,服务器可以同时支持 HTTP/1.1 和 HTTP/2。如果客户端不支持 HTTP/2,服务器可以回退到 HTTP/1.1。
HTTP/3:基于 QUIC 的 HTTP
前面介绍了 HTTP/2 的二进制分帧与多路复用。那么,既然多个请求已经可以共用一个连接,HTTP/3 还要解决什么问题?
关键在于:HTTP/2 把多个流放进同一个 TCP 字节流,但 TCP 不知道哪些字节属于哪个 HTTP 流。只要前面出现缺口,后续已经到达的字节仍需要等待。HTTP/3 因此采用 QUIC,让传输层本身理解多个独立的流。
HTTP/3 是 HTTP 语义到 QUIC 的映射。 方法、状态码、资源标识和内容协商等语义继续沿用,变化主要发生在连接建立、消息编码和底层传输。HTTP/3 的正式规范为 2022 年发布的 RFC 9114。RFC 9114,§1—§2
HTTP/3、QUIC 与 UDP 的关系
先区分三个概念:
| 名称 | 所处职责 | 主要作用 |
|---|---|---|
| HTTP/3 | 应用层协议 | 将 HTTP 消息编码为帧,并映射到 QUIC 流 |
| QUIC | 安全的多路复用传输协议 | 提供可靠流、流量控制、丢包恢复、拥塞控制及连接管理 |
| UDP | 底层数据报传输 | 承载 QUIC 数据包,本身不提供可靠、有序交付 |
所以,“HTTP/3 使用 UDP”不能理解为“HTTP 不再保证可靠传输”。对于普通 HTTP 请求和响应,可靠性与每条流内部的有序交付由 QUIC 提供。
QUIC 的标准传输机制主要见 RFC 9000,安全机制见 RFC 9001,丢包检测与拥塞控制见 RFC 9002。本文围绕这些规范所定义的机制解释,不把早期 Google QUIC 与 IETF QUIC 混为一谈;HTTP/3 的版本号也不是 QUIC 的版本号。

图 1:本文绘制的协议分层示意。左侧展示常见的 HTTP/2 over TLS over TCP;右侧将 TLS 握手与密钥派生画在 QUIC 内部,表示二者协作,而不是独立的 TLS 记录层叠放在 UDP 上。
QUIC 使用 TLS 1.3 握手完成身份认证和密钥协商,利用派生密钥保护 QUIC 数据包;它不采用“把 TLS 应用数据记录原样传进 QUIC”的方式。RFC 9001,§3
还需要区分不同密钥阶段:QUIC Initial 包的保护密钥可以由公开信息推导,不能把它当成保密信道;后续握手与应用数据使用相应阶段的密钥保护。网络观察者也仍能看到部分网络和传输元数据。因此,“HTTP/3 使用加密”不等于握手开始后所有信息都不可观察。RFC 9001,§5.2
实际访问时,URL 仍然可以是
https://api.example.com/orders/123,不需要变成
http3://...。同一个 HTTPS 服务可以同时提供
HTTP/1.1、HTTP/2、HTTP/3。
QUIC 怎样提供可靠传输
QUIC 的流(Stream)是有序字节序列,可以是单向或双向。一条连接能够承载多个流,而每条流分别维护自己的数据偏移与交付顺序。
用一个简化例子说明:
- 发送方把流 A 的一段字节放入 QUIC
STREAM帧,携带流 ID、偏移等信息。 - 一个或多个 QUIC 帧被装入 QUIC 数据包,再由 UDP 数据报承载。
- 接收方按流 ID 分配数据,按偏移重组同一流的字节,并通过 QUIC ACK 确认数据包的接收情况。
- 发送方根据确认、计时器和丢包检测机制判断哪些信息需要重新发送。
这里需要区分包号(Packet Number)与流偏移(Stream Offset):包号在对应的包号空间内标识某次发送的包,偏移标识某条流中的字节位置。丢失的流数据可以被重新装入使用新包号的数据包,而不是原封不动地用旧包号“重发同一个包”。RFC 9000,§12.3、§13
QUIC 还会进行拥塞控制和发送节奏控制,并不是因为使用 UDP 就可以无限发送。可靠性、网络公平性和性能优化,仍然需要传输协议的机制来实现。RFC 9002
多路复用与队头阻塞
HTTP/2 为什么仍然会被 TCP 丢包阻塞
假设一个 TCP 连接承载两个 HTTP/2 流:流 A 返回大图片,流 B 返回小文件。它们的帧在发送时交错进入同一 TCP 字节流。
如果携带流 A 部分数据的 TCP 段丢失,后续携带流 B 数据的段即使已经到达,通常也不能越过缺失的字节被交给上层协议。TCP 提供的是一条有序字节流,它不会按 HTTP/2 流分别交付。
HTTP/2 解决了 HTTP/1.1 同一连接中响应必须按请求顺序返回的限制,但没有消除 TCP 层面的队头阻塞。
QUIC 把交付顺序限定在每条流内部
对于 HTTP/3,若丢失的数据只属于流 A,而流 B 所需的数据已经到达、相关依赖也满足,则流 B 可以继续交付,不必等待 A 补齐缺口。

图 2:本文绘制的丢包交付示意。A1、A2、A3 表示流 A 的连续数据片段,B1、B2 表示流 B 的片段。为突出顺序依赖,图中假设丢失包只携带 A2,且不存在额外的压缩或业务依赖。
但这里不能写成“HTTP/3 完全没有队头阻塞”:
- 同一流内部仍然有序。 A2 未到达时,A3 不能越过它按有序流交付。
- 一个丢失包可以包含多个流的数据。 此时这些流都可能受到影响,流与包不是一一对应关系。
- 流共享网络路径和连接资源。 拥塞控制、连接级流量控制及发送调度,仍可能影响多个请求。
- 上层依赖仍然存在。 QPACK 动态表、应用处理顺序或数据库锁,都可能形成等待。
准确的说法是:QUIC 避免了 TCP 单一有序字节流造成的跨流交付阻塞,但不承诺所有请求在任何条件下都完全互不影响。RFC 9000,§2、§4、RFC 9114,§1.1
连接建立、TLS 1.3 与 0-RTT
首次连接通常是 1-RTT
RTT 是 Round-Trip Time,表示消息往返一次所需的时间。QUIC 将传输参数协商与 TLS 握手结合,在没有额外协商、丢包或地址验证阻碍的常见完整握手中,客户端收到服务端首轮握手消息后,就可以发送受 1-RTT 密钥保护的 HTTP 请求。
这减少了在 TCP 建连之后再单独执行 TLS 握手所需的串行等待。但“1-RTT 建连”不是“页面一定在一个 RTT 内加载完成”:DNS、端点发现、证书处理、服务端计算以及响应传输仍需时间。RFC 9001,§2.1

图 3:本文绘制的简化时序。左侧客户端等到服务端握手消息返回后发送请求;右侧利用先前会话信息提前发送 0-RTT 请求。图中省略 ACK、HTTP/3 控制流及密钥阶段细节,箭头不是数据包数量或实际时延的精确比例。
服务器还需要防止源地址伪造造成的放大攻击。在客户端地址尚未验证时,服务器发送的字节总量不得超过从该地址接收字节总量的三倍;服务器也可以使用 Retry 要求客户端证明能够接收数据。Retry、较大的证书链、丢包等情况可能增加等待,不能假设每次握手都严格具有相同开销。RFC 9000,§8.1
0-RTT 需要已有会话信息
在后续连接中,如果客户端拥有可用于恢复的会话信息,服务端允许早期数据,并且相关参数满足要求,客户端可以在发送 ClientHello 时一并发送 HTTP 请求数据,无需先等待本次服务端握手响应。
这里的“零往返”是指发送早期应用数据前不增加一次握手等待,不表示没有握手、没有加密,也不表示响应瞬间返回。首次访问没有相应恢复信息时,不能直接依靠 0-RTT;服务端还可以拒绝早期数据,客户端随后按协议重新发送。RFC 9001,§4.6
早期数据存在重放风险
0-RTT 数据可能被攻击者重放。因此,不能只因为请求使用加密连接,就把扣款、下单或不可重复的操作直接放入早期数据。
请求方法是否安全、具体资源是否允许重放、业务幂等机制和服务端防重放能力,都需要纳入判断。“HTTP 方法幂等”也不能单独代替整个业务的重放风险评估。
服务端认为某个请求不适合在早期数据中执行时,可以返回:
1 | 425 Too Early |
这是 HTTP 状态码,表示服务端不愿承担该请求可能被重放的风险;客户端重试时应在握手完成后发送,而不是再次放进早期数据。RFC 8470,§3—§5
这与“服务端繁忙所以稍后重试”不同,也不等同于
429 Too Many Requests。
HTTP/3 怎样组织请求与响应
一个普通请求对应一条客户端发起的双向流
对于普通请求,客户端在一条双向 QUIC 流的发送方向发送请求,服务器在同一条流的反方向返回响应。多个请求使用不同的请求流并发交互。
QUIC 流 ID 的编码与 HTTP/2 不同。HTTP/3 的客户端双向请求流 ID 可以是
0、4、8……,不能直接套用 HTTP/2
的客户端奇数流 ID 规则。RFC
9114,§6.1
请求流之外,还有控制流及按需建立的 QPACK 编码器、解码器流等单向流,分别承担连接设置和压缩状态同步等职责。每个端点必须建立一条控制流,并在其首个帧发送 SETTINGS;这类关键流不能像普通请求流一样随意关闭。不能认为 HTTP/3 连接里的每条流都是一个业务请求。RFC 9114,§6.2.1
HTTP/3 帧与 QUIC 帧不是同一层
HTTP/3 仍使用 HEADERS、DATA
等帧组织消息。简单请求或最终响应的结构可以概括为:
1 | HEADERS → DATA(可有多个,也可没有)→ 尾部 HEADERS(可选) |
其通用帧结构包含类型、长度和对应负载;这些字节进入 QUIC 流之后,由
QUIC STREAM 帧传输,再装入 QUIC 数据包。
也就是说:
1 | HTTP 消息 |
这里是逻辑上的承载关系,不要求帧、包与数据报一一对应。一个 HTTP/3 帧可以跨越多个 QUIC 数据包;一个 QUIC 数据包也可以携带多个传输帧。RFC 9114,§4.1、§7.1
与 HTTP/2 的固定帧头不同,HTTP/3 帧使用 QUIC 可变长度整数编码类型和长度,而且不需要在每个 HTTP/3 帧头里再携带流 ID,因为所在 QUIC 流已经提供这项上下文。
伪头字段表达 HTTP 控制信息
下面展示一个请求解码后的字段集合,只是逻辑示意,不是可以直接发送的文本报文:
1 | :method: GET |
响应的状态则可以由 :status: 200
表达。字段名在编码前必须转换为小写,头字段通过 QPACK 编码进入 HEADERS
帧;HTTP/3 不存在 GET /... HTTP/3
这样的线上文本请求行。
HTTP/3 不使用 Connection: keep-alive 或 HTTP/1.1 的
Transfer-Encoding: chunked。流的结束标记由 QUIC
提供,但仍可发送 content-length
表示内容长度;如果提供,其值必须与相应 DATA
帧中的内容总长度一致,HEAD、304 等特殊响应还需按 HTTP 语义理解。RFC
9114,§4.1.2—§4.3
取消请求与关闭连接
客户端不再需要某个响应时,可以利用 QUIC 的流重置、停止发送等机制取消相应流上的交互,而不必关闭整个连接。正常结束一条请求流,同样不等于结束连接。
连接准备停止接受新请求时,HTTP/3 使用 GOAWAY 等机制协调关闭。不过,取消传输不保证业务操作已经回滚:POST 可能已经被服务器执行,仍然需要前文所述的业务幂等及结果查询机制。RFC 9114,§4.1.1、§5.2
HTTP/3 还定义了可选的服务器推送,采用推送 ID、PUSH_PROMISE 和单向推送流等机制;它需要客户端允许,不等同于持续的业务消息推送,也不能把 HTTP/2 推送能力原样套用。RFC 9114,§4.6
QPACK:为什么不直接沿用 HPACK
HTTP/2 的 HPACK 利用静态表和动态表压缩字段,依赖连接中确定的编码顺序。QUIC 不保证不同流之间的到达顺序,如果直接沿用这种假设,某个流的字段就可能依赖另一个流上尚未到达的动态表更新。
HTTP/3 因此采用 QPACK。它仍使用静态表、动态表和字面量表示等机制,但把动态表更新与字段段编码分开,通过专门的流和确认机制管理依赖。RFC 9204,§1—§2

图 4:本文绘制的 QPACK 解码示意,假设端点已允许动态表且配置允许这种潜在阻塞。字段段 A 引用了尚未到达的动态表条目,因此等待;字段段 B 只使用静态表或字面量,没有这项动态表依赖。图中的 A、B 是示例名称,不表示协议定义的特殊流。
QPACK
并不保证“绝不阻塞”。如果字段段引用尚未接收到的动态表条目,就需要等待对应更新。解码器通过
SETTINGS_QPACK_BLOCKED_STREAMS
限制允许阻塞的流数;编码器也可以选择只引用已确认的动态表条目,或者使用静态表、字面量,以降低这类等待风险。
因此,QPACK 的设计提供的是压缩效率与阻塞风险之间的控制空间。不引用尚未到达的动态条目可以避免该依赖,但可能增大字段数据量;字段更大也会消耗网络和流量控制额度。RFC 9204,§2.1.2、§2.2.1
流量控制、拥塞控制与优先级
这三个概念解决的问题不同:
| 机制 | 主要保护或协调的对象 | 举例 |
|---|---|---|
| 流量控制(Flow Control) | 接收方的缓冲与处理能力 | 接收方限制某条流及整个连接可新增发送的数据量 |
| 拥塞控制(Congestion Control) | 网络路径的承载能力 | 发送方依据丢包、确认及 RTT 调整发送窗口和节奏 |
| 优先级(Priority) | 多个请求之间的资源调度 | 希望关键 CSS 比非关键图片更早得到发送机会 |
QUIC 既有流级,也有连接级流量控制。某条流耗尽自己的额度,不必直接阻止其他仍有额度的流;但连接总额度不足时,其他流也可能无法继续发送新数据。
拥塞控制则关注网络路径,即使每条流独立重组,也仍共享可用网络容量。增加更多流,不会凭空增加带宽。RFC 9000,§4、RFC 9002,§7
HTTP/3 也不能直接套用 HTTP/2 的依赖树优先级方案。RFC 9218
定义了可扩展优先级机制,例如表示紧急程度的 urgency
和可增量处理的 incremental
参数;这些属于调度提示,不保证服务端严格按某种顺序发送,也不能覆盖应用自身的处理依赖。RFC 9218
连接迁移与 Connection ID
传统 TCP 连接通常由源 IP、源端口、目标 IP、目标端口标识。如果设备从 Wi-Fi 切换到移动网络,客户端地址发生变化,已有 TCP 连接通常无法按原来的标识继续工作。
QUIC 使用 Connection ID(连接标识)辅助识别连接,把连接身份与当前 IP、端口解耦。在协议、端点及网络允许时,客户端可以切换路径,并通过路径验证继续使用原连接。
例如:
1 | 同一条 QUIC 连接 |
Connection ID
不是“永远不变的一串编号”。端点可以为同一连接提供并轮换多个连接
ID,以满足路由和隐私需求。新路径也需要验证,例如使用
PATH_CHALLENGE 和
PATH_RESPONSE,不能只看到一个连接 ID 就无条件信任来源。RFC
9000,§5.1、§8.2、§9
还要明确其边界:端点可以禁用主动迁移,零长度连接 ID 等配置也会限制能力;迁移后拥塞与 RTT 状态需要按新路径情况调整。连接迁移不等于任意断网都能无损恢复,也不等于 QUIC 默认同时利用多条路径聚合带宽。
客户端如何发现 HTTP/3
支持 HTTP/3 不会改变资源的 HTTPS URL,但客户端需要知道哪里可以建立 QUIC 连接。
通过 Alt-Svc 宣告替代服务
服务器可以在已有的 HTTP/1.1 或 HTTP/2 响应中提供:
1 | Alt-Svc: h3=":443"; ma=86400 |
这里,h3 表示 HTTP/3,:443 表示同一主机的
UDP 443 端点,ma 表示替代服务信息的缓存有效期。本例的 86400
秒是部署选择,不是 HTTP/3 固定要求。
Alt-Svc 的有效期也不是响应资源的缓存时间,更不等于一次 HTTP 重定向。客户端仍然访问原来的源站身份,替代服务必须通过相应的权威性和证书验证。RFC 7838,§2—§3、RFC 9114,§3.1.1
通过 DNS 或已有配置发现
支持相应机制的客户端还可以读取 DNS HTTPS 资源记录中的服务参数,例如
alpn
宣告的应用协议。已有配置或缓存也可以帮助确定端点,因此不应写成“必须先访问一次
HTTP/2 才能使用 HTTP/3”。RFC
9460,§7.1、§9
建立 QUIC 连接时,TLS 握手中的 ALPN 用于协商应用协议。h3
是 HTTP/3 的应用协议标识;QUIC 版本协商与 ALPN
各有职责,不能把它们看成同一套版本选择机制。
UDP 不可用时的回退
部分网络会阻断或限制 UDP。客户端若无法建立 HTTP/3 连接,应具备尝试基于 TCP 的 HTTP/2 或 HTTP/1.1 的能力;是否并行尝试、何时回退,取决于客户端实现。
这不是“把同一个 UDP 连接切换成 TCP”,而是建立另一条连接。UDP 失败也不代表源站业务一定不可用。RFC 9114,§3.2
部署与调试时需要注意什么
如果一个服务使用 https://example.com,常见部署会同时开放
TCP 443 与 UDP 443。两者属于不同的传输协议端点;只配置 TCP 443 并不能让
QUIC 请求到达服务。
部署时需要检查 QUIC 终止节点、UDP 防火墙规则、负载均衡和连接 ID 路由、证书、协议宣告以及回退行为。HTTP/3 可以只部署在客户端到 CDN 或网关这一段,网关到源站继续使用 HTTP/2 或 HTTP/1.1,并不要求所有链路同时升级。
curl 的 HTTP/3 支持取决于它的构建选项,可以先查看:
1 | curl --version |
确认功能列表含有 HTTP3 后,再对支持 HTTP/3
的测试端点使用:
1 | curl --http3-only -I https://example.com/ |
这里的域名只是示例,应替换为实际支持 HTTP/3
的测试服务。--http3-only 用于仅尝试
HTTP/3;--http3 允许按 curl 的策略尝试其他 HTTP
版本。某次请求成功,不代表它最终使用了 HTTP/3,仍需查看实际协商结果。curl 官方 HTTP/3 文档
浏览器开发者工具中的协议列可以帮助观察实际使用的 HTTP 版本。性能分析还应结合握手耗时、丢包、RTT、回退次数和服务端处理时间;只看某个头字段或看到 UDP 流量,并不足以证明整个请求路径及性能收益。
HTTP/3 会比 HTTP/2 更快吗
HTTP/3 为高 RTT、存在丢包、需要并发传输或发生网络切换的场景提供了改进机制,但它不承诺所有环境都更快。
具体效果还会受到 UDP 可达性、拥塞控制实现、端点 CPU 开销、系统网络栈优化、连接复用率、资源数量和应用处理时间影响。例如,已经建立且无丢包的 HTTP/2 连接可能具有很好的性能;若主要瓶颈在数据库,改变传输协议也不会消除数据库等待。
因此,严肃的性能结论需要说明网络、客户端、服务端和负载条件,并分别比较冷连接、复用连接及有丢包场景。这些是根据前述机制作出的工程分析,不能替代实际测量。
| 对比项 | HTTP/1.1 | HTTP/2 | HTTP/3 |
|---|---|---|---|
| 消息组织 | 文本起始行、头字段和消息体 | 二进制帧 | HTTP/3 二进制帧映射到 QUIC 流 |
| 常见底层传输 | TCP | TCP | QUIC over UDP |
| 同一连接内的交互 | 流水线响应需要按请求顺序返回 | 多个 HTTP/2 流 | 多个 QUIC 请求流 |
| 丢包后的交付顺序 | 同一 TCP 字节流有序交付 | 仍受同一 TCP 字节流影响 | 各流内部有序;独立流不必等待别的流补齐字节 |
| 字段压缩 | 无 HTTP/2 式内建字段压缩 | HPACK | QPACK |
| 安全机制 | HTTPS 使用 TLS | 常见部署为 TLS over TCP | QUIC 集成 TLS 握手与包保护 |
| 网络地址变化 | 通常需要重建 TCP 连接 | 通常需要重建 TCP 连接 | 条件满足时可迁移已有连接 |
最后还要把传输与业务分开:HTTP/3 不会改变 GET、POST 的方法语义,也不会自动解决认证、缓存策略、业务幂等和数据库事务问题。前面讨论的 HTTP 语义和后面的 RESTful API 设计原则仍然适用。
本节参考资料
| 类别 | 资料 | 主要内容 |
|---|---|---|
| HTTP/3 标准 | RFC 9114 | HTTP 语义映射、帧、流、端点发现 |
| QUIC 传输标准 | RFC 9000 | 可靠流、流量控制、连接 ID、路径验证 |
| QUIC 安全标准 | RFC 9001 | TLS 集成、密钥阶段与早期数据 |
| QUIC 恢复标准 | RFC 9002 | 丢包检测、拥塞控制 |
| 字段压缩标准 | RFC 9204 | QPACK 与压缩依赖 |
| 早期数据标准 | RFC 8470 | 重放风险及 425 状态码 |
| 服务发现标准 | RFC 7838、RFC 9460 | Alt-Svc、DNS HTTPS 记录 |
| 调度标准 | RFC 9218 | HTTP 可扩展优先级 |
| 官方工具文档 | curl HTTP/3 | 功能支持、测试及回退行为 |
RESTful API
RESTful API 是按照 REST 架构风格设计的接口。在 Web 场景中,它通常通过 HTTP 交换资源的表示,并利用 HTTP 方法、状态码和头字段表达交互语义。
前面介绍了 HTTP 请求方法、状态码、URL 和消息结构。那么,实际开发接口时,应该怎样把这些机制组织起来,让客户端、服务器以及中间的代理能够一致地理解请求?这就是本文接着讨论 RESTful API 的原因。
REST 与 HTTP 的关系
REST 是 Representational State Transfer 的缩写,通常译为“表述性状态转移”或“表现层状态转移”。Roy Fielding 在 2000 年的博士论文中系统描述了这种架构风格。Fielding 论文,第 5 章
理解这部分时,先区分三个层次:
| 层次 | 解决的问题 | 示例 |
|---|---|---|
| HTTP | 请求、响应及其语义如何表达 | GET、201、Content-Type |
| REST | 分布式系统的组件应遵循哪些交互约束 | 无状态、缓存、统一接口 |
| 具体 API 契约 | 某个业务接口有哪些资源、字段和规则 | /orders/123、订单状态、金额格式 |
所以,HTTP 为 Web API 提供了协议机制,REST 约束这些机制怎样组织,而 API 契约补充业务含义。REST 本身不是一个通信协议,也没有规定必须使用 JSON。
例如,POST /getUser 可以是一个合法的 HTTP
接口,但它主要表达“调用 getUser 这个操作”。GET /users/123
则表达“读取用户 123 这个资源的表示”。二者体现了不同的接口组织方式。
不过,仅凭一个 URL 的写法,还不能判断整个系统是否满足 REST 的约束。
资源、URI 与资源表示
REST 中的资源(Resource)是接口对外暴露的概念。例如用户、订单、文章、订单集合,甚至一次导出任务,都可以被建模为资源。
资源标识符用来指向这个概念;资源表示(Representation)则是某个时刻对它的描述。客户端在请求和响应中交换表示,而不是直接访问服务器的内部对象。
例如:
1 | GET /orders/123 |
1 | 200 OK |
这里,订单 123 是资源,/orders/123
是资源标识的一部分,响应中的 JSON 是它的一种表示。金额 199
的单位必须由接口契约明确,例如本例约定为人民币分,不能让客户端自行猜测。
订单状态改变之后,URI 可以保持不变,表示中的 status
则发生变化。同一资源也可以提供多种表示,例如 JSON 与 HTML。
这还意味着:资源不必对应一张数据库表,返回的表示也不必等于数据库的一行记录。 一个订单表示可以聚合订单项、配送进度和可执行操作;底层数据怎样存储,应由服务端实现决定。Google AIP-121:资源导向设计
Content-Type 与 Accept
这两个头字段容易混淆:
Content-Type说明这条消息中发送的内容是什么格式。Accept说明客户端希望收到哪些响应格式。
例如,客户端发送 JSON,同时希望收到 JSON:
1 | POST /orders |
服务器不支持请求内容的媒体类型时,可以返回
415 Unsupported Media Type。如果按内容协商无法提供客户端可接受的响应格式,可以返回
406 Not Acceptable;是否严格拒绝或采用默认表示,需要明确接口策略。RFC
9110,§12、§15.5
REST 的架构约束
Fielding 的论文列出了六类约束,其中按需代码是可选的。下面概括各自作用,详细定义以论文为准。Fielding 论文,§5.1
| 约束 | 含义 |
|---|---|
| 客户端—服务器(Client–Server) | 分离客户端交互职责与服务器的数据、业务职责 |
| 无状态(Stateless) | 每次请求包含理解它所需的信息,不依赖服务端保存的客户端会话上下文 |
| 缓存(Cache) | 响应应能被判断为可缓存或不可缓存,使等价请求可以按规则复用响应 |
| 统一接口(Uniform Interface) | 资源标识、表示、消息语义以及状态转移采用一致的交互机制 |
| 分层系统(Layered System) | 组件只面向直接交互的一层,允许引入代理、网关和缓存等中间层 |
| 按需代码(Code-on-Demand,可选) | 服务端可以通过下发可执行代码扩展客户端能力 |
例如,一次订单查询可能经过浏览器缓存、API 网关、反向代理,最终到达订单服务。客户端只需要面对约定的接口,不必知道内部有多少服务。
无状态到底是什么意思
假设客户端先发送“选中订单 123”,之后再发送“取消当前订单”。如果第二个请求不携带订单标识,只能依赖服务器记住“这个客户端刚才选中了什么”,就存在客户端会话上下文依赖。
更明确的设计是直接请求创建订单 123 的取消申请,并在请求中携带认证信息及必要参数。服务器能够从这次请求和已有业务资源中理解操作。
因此,需要区分:
- 资源状态:订单内容、库存、用户资料等,可以保存在服务器。
- 客户端会话上下文:客户端当前选中了什么、进行到哪一步等,不应成为解释下一条请求的隐含前提。
HTTP 协议本身无状态,并不自动保证应用符合 REST 的无状态约束。应用仍然可以通过 Cookie 和服务端 Session 建立有状态会话。
同样,换成 Token 或 JWT,也不能单凭认证方式就认定 API 无状态。判断重点是请求是否仍依赖隐含的服务端会话上下文,而不是数据库是否存在、认证令牌叫什么名字。服务器维护账号、权限和业务数据,本身不等于保存客户端的交互会话。
统一接口与 HATEOAS
统一接口不只是“统一返回 JSON”,也不只是“所有响应都有 code、message、data”。它包含资源标识、通过表示操作资源、消息自描述,以及通过超媒体驱动应用状态转移这四方面。
HATEOAS(Hypermedia As The Engine Of Application State)强调:客户端根据响应中提供的链接和操作控制,发现下一步可执行的交互。Fielding 本人在文章中专门强调了这个要求。Fielding:REST APIs must be hypertext-driven
例如,订单表示可以包含当前允许的操作:
1 | { |
客户端理解 cancel
控制之后,可以使用服务端提供的地址提交取消申请。如果订单已经发货,服务端可能不再提供该控制,而提供其他符合业务规则的操作。
注意,上面的 links、actions
是为了说明机制而自定义的结构,不是 JSON 或 HTTP
自带的标准字段。实际设计需要约定媒体类型或表示规范,明确链接关系、操作含义和输入结构;客户端仍需预先理解这些语义。也不能认为只要在
JSON 中添加几个 URL,就完整实现了 HATEOAS。
很多工程中被称为“RESTful API”的接口,只实现了资源路径与 HTTP 方法映射,仍依赖客户端硬编码业务流程。描述这类接口时,应说明实际采用了哪些 REST 原则,不能把“JSON + HTTP + CRUD”直接等同于完整的 REST。
URI 如何围绕资源组织
下面是常见的资源路径:
1 | /users 用户集合 |
使用名词、集合名称采用复数、保持一致的命名方式,是便于理解和维护的工程惯例,不是 HTTP 协议规定的 URI 语法要求,也不是判断 REST 的充分条件。微软:Web API 设计最佳实践
设计时还应明确几个问题:
- 资源地址应尽量稳定。 避免把内部类名、数据库表名或框架实现暴露为接口契约。
- 嵌套表达真实关系。
/orders/123/items表达订单与订单项关系;没有必要把所有关联层层拼进 URL。 - 筛选、排序通常使用查询参数。 例如
/orders?status=pending&sort=-createdAt&limit=20。这些参数名和语法由 API 定义,不是 REST 的统一标准。 - 查询字符串也参与资源标识。
/orders?status=pending表达筛选后的结果,不能认为只有路径才影响资源和缓存。 - 敏感凭据不应放进 URL。 URL 可能进入浏览器历史、代理日志或监控系统。
业务动作不一定能简单映射成字段修改。例如取消订单涉及库存、付款和业务审批,可以把“取消申请”建模为资源:
1 | POST /orders/123/cancellations |
如果这个领域确实更适合显式操作,也可以设计操作型接口,并如实描述其交互方式。资源建模应服务于业务契约,不能为了让路径看起来符合某种形式而隐藏业务规则。
HTTP 方法如何映射到资源操作
下面以订单 API 为例。这里是常见设计,并不意味着每个资源都必须支持所有方法。
| 请求 | 示例语义 | 常见成功响应 |
|---|---|---|
GET /orders |
获取订单集合的表示 | 200 OK |
GET /orders/123 |
获取订单 123 的表示 | 200 OK |
POST /orders |
提交创建订单请求,由服务端分配标识 | 201 Created |
PUT /orders/123 |
在该 URI 创建或替换客户端可管理的资源状态 | 创建时 201;替换时 200 或
204 |
PATCH /orders/123 |
应用补丁文档描述的修改 | 200 或 204 |
DELETE /orders/123 |
删除该 URI 与当前功能的关联 | 200、204;异步执行可为
202 |
这张表的重点是方法语义。使用某个 HTTP
方法,服务端实现就应遵守它的语义。例如,不能通过
GET /orders/123/delete
执行删除,因为浏览器预取、爬虫或其他自动化工具可能触发 GET。
POST 的含义比“新增”更宽泛:它要求目标资源按自身语义处理提交内容。PUT 的目标 URI 则由客户端指定。DELETE 也不保证数据库记录被物理清除,归档、软删除等实现细节由业务定义。RFC 9110,§9.3
安全与幂等
安全(Safe)是指客户端请求的语义本质上是只读的,不要求改变资源状态;服务器记录访问日志等附带行为不使 GET 变成不安全方法。这里的“安全”不是“具有加密或权限保护”。
幂等(Idempotent)是指多次相同请求对服务器产生的预期效果,与执行一次相同。它不要求响应状态码和响应体每次都一样。RFC 9110,§9.2
例如,对同一订单连续发送 DELETE,第一次返回
204,第二次返回
404,仍可以满足幂等性:订单都处于已删除状态。GET
两次之间订单可能被其他客户端更新,返回内容不同,也不破坏 GET
的幂等语义。
| 方法 | 安全 | 协议层是否保证幂等语义 |
|---|---|---|
| GET、HEAD、OPTIONS、TRACE | 是 | 是 |
| PUT、DELETE | 否 | 是 |
| POST | 否 | 否;具体操作可以另行提供幂等保证 |
| PATCH | 否 | 否;取决于补丁语义及实现 |
PATCH 中,“把邮箱设为某值”可以实现幂等;“向列表末尾追加一个元素”重复执行却可能产生多个元素。PATCH 也不是“资源不存在就一定创建”,是否允许创建取决于补丁格式和服务端能力。RFC 5789,§2
PUT 与 PATCH 的更新边界
PUT 表达创建或替换资源状态,PATCH 表达应用一组修改指令。这里的“完整状态”应由资源表示契约定义,不能理解成客户端必须提交数据库中的全部字段。服务端管理的 ID、创建时间等,可以是只读字段。
例如,对支持 JSON Merge Patch 的订单接口修改备注:
1 | PATCH /orders/123 |
application/merge-patch+json
中,未出现的对象成员保持不变,成员值为 null
表示删除该成员,数组则整体替换。因此它不适合直接表达所有需要保留显式
null 的业务结构。RFC 7396:JSON Merge
Patch
另一种标准格式是 JSON Patch:
1 | [ |
对应媒体类型为
application/json-patch+json。它以操作序列表达修改,包含
add、remove、replace、move、copy、test;其中向数组末尾追加元素的操作,重复执行可能不幂等。RFC 6902:JSON
Patch
因此,使用普通 application/json
加上一部分字段时,必须在接口文档中说明补丁规则,不能让客户端自行假设“缺失”“null”“空字符串”的含义。服务器还应按
PATCH 规范原子地应用整份补丁,避免失败后留下部分修改。RFC
5789,§2
状态码与错误响应
状态码表达 HTTP 层面的处理结果,响应体补充业务信息。服务端应根据真实处理结果选择状态码,方便客户端、网关和监控使用标准语义。
例如创建订单成功:
1 | 201 Created |
Location
指向新建资源,响应体可以同时返回它的表示。它并非仅用于重定向。RFC
9110,§10.2.2、§15.3.2
API 中几个需要明确区分的结果如下:
| 状态码 | 典型用途 |
|---|---|
202 Accepted |
已接受请求,处理尚未完成;不保证最终成功 |
204 No Content |
操作成功,没有响应内容;不能再附带 JSON |
400 Bad Request |
请求存在语法、结构等客户端错误 |
401 Unauthorized |
缺少有效认证凭据;响应必须包含适用的 WWW-Authenticate
挑战 |
403 Forbidden |
服务器理解请求,但拒绝执行;权限不足是常见原因 |
404 Not Found |
未找到目标资源,或服务端不愿披露它的存在 |
405 Method Not Allowed |
目标资源不支持该方法;必须返回 Allow |
409 Conflict |
操作与资源当前状态冲突,例如订单已发货而不允许取消 |
412 Precondition Failed |
If-Match 等请求前置条件不成立 |
415 Unsupported Media Type |
请求内容的媒体类型或相关编码不受支持 |
422 Unprocessable Content |
内容类型和语法可理解,但包含无法处理的指令 |
429 Too Many Requests |
请求过多,可以用 Retry-After 告知等待时间 |
503 Service Unavailable |
服务暂时不可用,例如过载或维护 |
这里沿用 HTTP 状态码语义;422
用于哪类业务校验、400 的具体边界等,还要在 API
契约中保持一致。RFC
9110,§15、RFC
6585,§4
使用 Problem Details 描述错误
错误响应可以采用 RFC 9457 Problem Details,JSON
媒体类型为
application/problem+json。例如取消已发货的订单:
1 | 409 Conflict |
type 标识问题类型,title
是该类型的简短说明,detail
解释本次问题,instance
可标识本次发生的问题。status
如果提供,应与实际响应状态码一致。客户端应依据问题类型和约定的扩展字段处理错误,不要解析面向人的自然语言描述。RFC
9457,§3
这些字段并不是必须全部出现。Problem Details 也不应包含堆栈、数据库语句或凭据;错误内容需要帮助调用方处理问题,而不是泄露内部实现。
如果接口实际拒绝了创建订单,却始终返回 200 并只在 JSON
中写一个错误码,HTTP
客户端和监控只能看到成功状态,容易误判。业务错误字段应补充 HTTP
状态,而不是普遍替代它。
缓存、条件请求与并发更新
缓存是 HTTP API 的一部分
GET 响应是否可复用,不能只看它是不是 JSON,还要结合状态码、缓存头和请求上下文判断。
| 响应中的 Cache-Control 指令 | 含义 |
|---|---|
max-age=60 |
设定 60 秒新鲜度期限;复用仍需考虑响应已有年龄等因素 |
private |
共享缓存不能存储;允许私有缓存按其他规则处理 |
no-cache |
可以存储,但未经服务端成功验证不能复用 |
no-store |
缓存不得存储该请求、响应;并不保证此前副本已被清除 |
例如,公开产品目录可以设置适当的新鲜度;个人账单需要严格区分用户并制定缓存策略,敏感响应可使用
no-store。不要把“带 Token”当成安全缓存隔离的自动保证。RFC
9111,§3、§5.2
当同一 URI 按 Accept 选择 JSON 或 HTML 时,可以使用
Vary: Accept
告知缓存,响应选择依赖该请求字段。Vary
解决表示选择问题,不能替代访问控制。
用 ETag 验证缓存
服务器可以为表示生成一个不透明的验证标识:
1 | 200 OK |
客户端再次读取时携带:
1 | GET /orders/123 |
当验证条件满足时,服务器可以返回
304 Not Modified,不再发送响应内容;客户端按缓存规则更新元数据并复用已有表示。ETag
不要求必须是内容哈希或数据库版本号,其生成方式由服务端决定。RFC
9110,§8.8.3、§13.1.2
用 If-Match 避免丢失更新
假设两个客户端都读取到版本 7,先后提交修改。若没有并发控制,后提交的修改可能覆盖先前结果。
接口可以要求更新时携带读取到的强 ETag:
1 | PATCH /orders/123 |
服务器应原子地检查版本并执行修改。如果资源已经变化,通常返回
412,由客户端重新读取并处理冲突。需要强调,先检查版本、再无条件写入仍可能存在竞争,服务端必须把检查与更新结合起来。
If-Match 使用强比较,W/"..." 形式的弱 ETag
不能用来匹配这类更新条件。要求条件请求但客户端未提供时,可返回
428 Precondition Required。RFC
9110,§13.1.1、RFC
6585,§3
重试、分页与异步任务
请求超时不代表操作没有发生
客户端提交创建订单请求后超时,可能是服务端尚未处理,也可能是订单已经创建而响应未送达。因此,直接重复 POST 可能生成两个订单。
对这类操作,可以在 API 契约中约定业务幂等键,例如
Idempotency-Key。服务端需要将键与调用方、操作范围、请求参数和处理结果关联,并在并发重试时保证只产生一次相应的业务效果。Stripe:幂等请求官方文档
幂等键的有效期、同键不同参数的处理方式、进行中请求的响应,都需要明确。这是具体 API 提供的机制,不能由某个头字段名称推导出所有接口都有相同保证。
重试策略还应限制次数,并采用退避;当响应提供 Retry-After
时,应结合它决定重试时机。认证失败、输入校验失败等问题通常需要先修正请求,不能靠不断重试解决。
集合接口应考虑分页
订单集合可能持续增长,直接返回所有订单会扩大数据库、网络和客户端处理开销。接口设计时应提前定义分页,例如:
1 | GET /orders?status=pending&limit=20&cursor=opaque-token |
响应可以包含本页数据和下一页链接。limit、cursor
是本例约定,实际 API 可以使用其他命名。
使用游标分页时,需要稳定排序,例如 createdAt 与唯一 ID
的组合;游标应被客户端视为不透明值,也不能代替认证和授权。Google AIP-158:分页
偏移分页便于按页跳转,但并发新增、删除可能造成遗漏或重复;游标分页也不自动提供一致性快照。如果要求跨页结果固定,还需约定快照或版本机制。这些属于集合查询契约,应根据数据规模和业务一致性要求设计。
耗时操作可以建模为任务资源
导出大量订单时,可以先接受任务,再让客户端查询任务状态:
1 | 202 Accepted |
客户端随后读取 /jobs/job-900,获取
queued、running、succeeded 或
failed 等状态,成功后再使用结果链接下载文件。这些状态名和
statusUrl 字段由本例契约定义。
这里,202
只表示请求已接受;最终完成情况通过任务资源表达。任务的可见性、过期时间、失败详情及取消规则,也应在设计时明确。
认证、授权与 CORS
对外提供 HTTP API 时,应使用 HTTPS 保护传输,并分别考虑认证与授权:
- 认证(Authentication):调用方是谁、凭据是否有效。
- 授权(Authorization):调用方能否对这个资源执行该操作。
例如,用户已经登录,不代表可以通过修改 /orders/123 中的
ID 访问其他人的订单。服务端需要进行资源级权限检查;使用 UUID
只能降低猜测便利性,不能替代授权。OWASP
API1:2023:对象级授权缺陷
CORS(跨源资源共享)则是浏览器环境中的访问机制。部分跨源请求在正式发送前会触发 OPTIONS 预检,浏览器据服务端响应判断是否允许后续请求和读取响应。
它与认证、授权不同,不能阻止非浏览器客户端直接请求接口;也不能把“预检通过”理解为“调用方有业务权限”。使用 Cookie 等自动携带凭据的方式时,还需考虑 CSRF 防护,不能仅依赖 CORS。WHATWG Fetch Standard:CORS protocol
API 契约与版本演进
接口除了路径,还需要定义字段类型、必填条件、缺失值与
null
的差别、金额单位、时间格式、分页规则、错误类型和权限边界。
OpenAPI 可以描述 HTTP API 的路径、操作、参数、请求和响应结构、安全方案等,便于生成文档和工具;但拥有一份 OpenAPI 文档,并不证明接口满足 REST 的架构约束。OpenAPI 官方规范
接口演进时,应评估已有客户端的行为。例如删除字段、修改字段类型、改变金额单位,通常会破坏兼容;新增字段也要考虑严格校验的客户端,新增枚举值则可能影响穷举处理。
/v1/orders、版本请求头或媒体类型版本,都是可选择的契约策略,REST
没有要求统一使用某一种。项目应明确兼容性规则、废弃通知和迁移期限,不应仅添加版本号而忽略字段与行为的变化。微软:API
版本管理
本节参考资料
下面区分架构定义、协议标准与工程指南。工程指南中的具体命名或设计偏好,应结合项目取舍,不能直接当成 REST 或 HTTP 的强制要求。
| 类别 | 资料 | 阅读重点 |
|---|---|---|
| 架构原始文献 | Fielding 博士论文第 5 章 | REST 的约束、资源与表示 |
| 作者技术文章 | REST APIs must be hypertext-driven | 超媒体与应用状态转移 |
| 协议标准 | RFC 9110、RFC 9111 | HTTP 语义、条件请求与缓存 |
| 协议标准 | RFC 5789、RFC 7396、RFC 6902 | PATCH 与两种 JSON 补丁格式 |
| 协议标准 | RFC 9457、RFC 6585 | 结构化错误、428 与 429 |
| 官方工程指南 | 微软 Web API 设计、Google AIP-121、AIP-158 | 资源建模、分页和接口演进 |
| 官方实现文档 | Stripe 幂等请求 | POST 重试的业务幂等机制 |
| 安全资料与规范 | OWASP API Security、Fetch Standard | 资源授权与 CORS 边界 |
| 接口描述规范 | OpenAPI Specification | HTTP API 契约描述 |