大模型基础
大模型 API 调用的完整链路是什么?如何衡量一次大模型 API 的性能?
大模型 API 调用的是从业务应用发起请求,经由 API 网关、推理调度、模型推理,再将生成结果返回业务应用的完整分布式调用过程
请求预处理与 Prompt 组装
通常不能直接把用户输入原样发送给模型,而是要完成一系列预处理。第一部分是业务预处理。包括用户身份认证、请求参数校验、用户权限判断、敏感信息处理,以及确定本次请求使用哪个模型。第二部分是上下文组装。
几个常见参数:
参数 作用 model指定调用的模型 messages传递角色消息和上下文 temperature调整生成时的采样随机性,具体支持情况依模型而定 top_p核采样策略,控制参与采样的候选 Token 概率质量范围 max_tokens限制输出 Token 数量,实际字段名因 API 不同而异 stream是否请求流式返回 tools声明模型可以请求使用的工具 请求序列化
请求完成组装之后,会将请求序列化成模型服务商要求的格式,通过 HTTP 客户端发起调用。通常经过:
1
JSON 序列化 → HTTP 请求构建 → HTTPS 连接 → 服务商 API 网关
流式传输
客户端发起请求时,通常开启流式输出。服务端通过 SSE 持续推送数据块。前端一般用
EventSource或fetch结合ReadableStream来逐块渲染 Markdown。关键细节在于:必须在代码中显式检测
data: [DONE]结束标记,否则会导致连接挂死。模型推理层
Tokenization
模型不能直接处理文本,需要先使用与模型匹配的 Tokenizer,把文本转换成 Token ID 序列
预填充阶段
Prefill 的主要任务是对输入上下文执行前向计算,得到后续生成所需的内部表示,并建立 KV Cache。
KV Cache 和 Chat Memory 有什么区别?
KV Cache Chat Memory 所属层次 模型推理层 应用编排层 保存内容 注意力计算中的 K/V 张量 用户与 AI 的对话消息 主要用途 避免重复计算 维持多轮对话上下文 常见存储位置 GPU 显存及其他分级缓存 内存、Redis、数据库等 生命周期 与推理请求及缓存策略相关 由业务会话管理策略决定 逐 Token 生成
在 Decode 阶段,模型根据当前上下文计算候选 Token 的概率分布,再根据采样策略选择下一个 Token。
整个过程会反复进行,直到生成结束标记、达到输出 Token 上限,或者触发其他终止条件。
响应处理
模型生成结果后,还需要进行 Token 解码、响应封装,并通过网络返回应用服务。一般模型服务商使用 SSE
重试、退避与超时
健壮的调用层需要包含
- 重试策略:仅对可恢复错误(限流、超时)重试;对 401/400 等参数或权限错误立即失败。
- 指数退避:等待时间随重试次数指数增长,避免在服务端压力最大时密集重试。
- 超时控制:分别设置连接超时(如 5s)和总读取超时(如 60s),防止慢响应拖垮调用方。
工具调用(Function Calling)与结果关联
当模型需要调用外部工具时,链路会延长。模型返回的不是最终文本,而是结构化的调用指令(含
tool_call_id和参数)。运行时环境执行工具后,必须将原始tool_call_id原样回填到结果消息中。如果并行调用多个工具,仅靠工具名称无法区分是“查北京天气”还是“查上海天气”的返回结果,只有 ID 能保证结果与请求的精确对应
衡量一次大模型 API 的性能通常看以下四个指标:
| 指标 | 含义 |
|---|---|
| TTFT (Time To First Token) | 从发起请求到获得首个生成 Token 的延迟 |
| TPOT (Time Per Output Token) | 输出阶段平均每个 Token 的生成耗时 |
| E2E Latency | 从请求发起到响应完整结束的耗时 |
| Throughput | 单位时间内处理的请求数或 Token 数 |
大模型是无状态的还是有状态的?大模型的状态和记忆是什么关系?
大模型本身是无状态的,从推理引擎的层面看,每一次调用都是独立的,模型不会自动保留上一次调用的任何信息。这次推理产生的中间状态(如 KV Cache)通常不会跨请求保留。
OpenAI 的文档也明确说,每次文本生成请求是独立的、无状态的,多轮对话需要开发者把历史消息重新传进去。
所以说,大模型记忆是外部系统为无状态模型外部实现的连续性
模型自己记不住任何东西。感觉有记忆,是因为应用层把历史对话、过往事实等存到外部,下次调用时再把这些内容拼进 prompt 一起发给模型。模型读到这些文本,表现得像是记得,但它内部并没有一个持续存在的记忆体。
记忆是应用层或编排层的职责,状态是推理引擎内部的事。模型本身既不保存记忆,也不跨调用保留状态,所有连续性都是外部系统在每次调用时临时组装出来的。
流式是如何改善用户体验的?SSE、WebSocket、HTTP Chunked 在流式输出场景下怎么选?流式输出中,如何判断 SSE 流正常结束?
流式输出带来的是打字机的逐字呈现效果。用户在第一秒就能看到模型开始回答,心理等待感知从“不知道要等多久”转变为“它在认真回答我”。
同时,用户可以在生成过程中提前判断方向是否正确,如果发现答非所问,可以主动中断,不必等完整结果出来再重来。对于长文本生成、代码补全等场景,这种即时反馈的价值尤为明显。
在大模型 API 流式输出场景下,SSE 是标准选择
- SSE 是单向的,服务器向客户端推送,大模型调用恰好符合这个模式。而且
SSE 基于标准 HTTP,实现简单,浏览器有
EventSource原生支持,还自带断线重连机制 - WebSocket 支持全双工双向通信。如果你的场景需要在模型生成过程中,客户端持续向服务器发送控制指令,WebSocket 才有必要。因为 WebSocket 复杂度很高
- HTTP Chunked 是 HTTP/1.1 的分块传输编码,属于更底层的传输机制,本身不定义事件格式。SSE 在传输层可以基于 Chunked 来实现,但是裸着用需要处理各种内容,非常麻烦。
因为连接关闭可能是正常完成,也可能是半截断开。正确的做法是识别上游在流末尾发送的结束信号,一般内容为
data: [DONE]。如果你自己解析 SSE
原始字节流,就必须显式检查这一行。
为什么大模型调用必须做幂等?大模型调用如何做幂等?和普通业务做幂等有什么区别?
大模型调用必须做幂等,根本原因在于它的失败模式是模糊的,而重试又是绕不开的常态。
普通 HTTP 请求超时,你大概率知道请求没成功;但大模型调用超时,你面对的是一个薛定谔的结果,贸然重试问题可能会放大。
超时意味着结果未知,而不一定是失败。
因为普通接口的响应通常很短,而且异常明确,超时发生的阶段比较好判断,结果相对确定。大模型就不一样了,所以说,超时只能认为是未知,需要先查或者带着幂等键去重试
大模型调用有真实的计量成本
说白了,盲目重试扣大米
Agent 场景放大了风险
当大模型通过 Function Calling 去执行写操作时,重试的后果就会带着调用工具的副作用
大模型做幂等思路和普通业务一致:用一个稳定的幂等键,把同一次逻辑调用的多次尝试折叠成一次。但大模型场景下,键的选取和传递方式有特殊考量。
幂等键必须从业务意图派生,且在整个重试链路中保持不变。正确的做法是在决策阶段就生成一个与
这次要做的事
绑定的键,写入持久化状态,后续所有重试都复用同一个键。例如在 Agent
中,可以用 run_id + call_id 或 tool_call_id
组合,因为模型生成的 tool_call_id
在检查点恢复后不会改变。
然后,服务端在同一个事务里 执行操作 + 记录这个键,用数据库唯一索引,这些内容和常规业务的幂等是相同的。
对于纯模型调用,还要区分上游是否支持幂等。如果上游 API 本身支持幂等请求头,那就优先使用这个
和普通业务做幂等的区别,主要集中在故障边界和副作用形态上。
- 普通业务的幂等,通常有一个清晰的执行边界。对于普通业务,幂等键的作用主要是防传输层重复投递,逻辑相对单纯。
- 大模型调用的幂等,面对的是一个不确定的黑盒。你只能靠外部的幂等键和状态记录来推断。因此,大模型场景的幂等设计往往需要三态状态机(成功 / 失败 / 未知)和先查后重试的流程
大模型限流为什么不能只按 QPS 做?模型网关通常要承担哪些能力?
大模型限流不能只按 QPS 做,主要是因为不同请求的资源消耗差异非常大,QPS 不能准确反映模型服务的实际负载。
传统 HTTP 接口一次调用消耗的资源基本是固定的,所以说 QPS 能够直观反映系统压力。但大模型的请求受到输入 Token 数、输出 Token 数、上下文长度、模型规格以及推理时间等因素的共同影响,就不固定。
比如同样是 1 QPS,一个请求可能只有 100 个输入 Token、生成 50 个输出 Token;另一个请求可能有 2 万个输入 Token、生成 4000 个输出 Token。两者虽然请求数量相同,但对计算资源、显存、推理时间和 API 成本的消耗可能相差很大。
所以,主流模型供应商的限流机制都同时包含请求维度和 Token 维度。一般情况下,语言模型 API 应该同时限制两者,通常需要采用多维限流策略
- RPM/QPS,限制单位时间的请求次数
- TPM,限制单位时间内的 Token 使用量,控制模型负载和调用额度;
- 并发限制,控制同时进行的模型请求数量
- Cost Budget,费用限制,控制实际 API 成本
Token 数量在请求前不知道,应该怎么限流?
很明显,输入 Token 通常可以预估,但实际生成多少输出 Token,只有模型完成生成后才能准确知道。所以大模型网关一般采用,请求前预估与预占额度,请求执行后根据实际用量结算,然后释放多余额度。
对于大模型网关本身,除了传统 API Gateway 的统一认证、路由、限流、负载均衡和监控能力,还需要提供模型路由和多模型统一适配、Token 计量、成本统计、流式响应转发、重试与熔断、模型降级、以及多租户隔离等能力。
| 对比维度 | Spring Cloud Gateway | AI Gateway |
|---|---|---|
| 核心职责 | HTTP 服务流量治理 | 模型调用统一接入及治理 |
| 限流依据 | QPS、IP、用户等 | RPM、TPM、并发、预算等 |
| 路由依据 | Path、Header、服务实例 | 模型、Provider、能力、成本等 |
| 请求处理 | 通用 HTTP 转发、过滤 | 模型协议适配和 Token 预估 |
| 响应处理 | 通用 HTTP 响应处理 | SSE、模型用量解析、错误规范化 |
| 成本控制 | 通常不涉及请求级模型计费 | Token 成本与用户预算管理 |
| 监控指标 | QPS、RT、错误率 | 额外关注 TTFT、TPOT、Token、Cost |
如果是 Agent 系统,还需要考虑 Tool Calling 产生的多轮模型调用的相关内容,因此,大模型网关的核心是根据请求的实际资源消耗、推理容量和业务预算实施多维度流量治理。
Token 是什么?为什么中文、英文、代码消耗的 Token 不一样?Token 和上下文为什么决定成本与效果?
Token 是大模型处理自然语言的基本单位,模型并不直接认识文字,它需要先把输入文本交给分词器,切分成一个个 Token,再把这些 Token 映射为数字编号和向量,才能进行计算。
中文、英文、代码消耗的 Token 不同,是因为分词器的词表覆盖偏好不同。词表大的模型,能把更多常见字符组合收进单个 Token;词表对某种语言覆盖稀疏,该语言的文本就会被拆得更碎,消耗更多 Token。
例如,中文 vs 英文,在 cl100k_base 词表下,一段 219 字的中文叙述需要 291 个 Token,而一段 379 字符的英文叙述只需 73 个 Token;换算下来,中文平均每个 Token 只覆盖约 1.16 个字符,英文则覆盖约 5.19 个字符。
代码的 Token 消耗取决于语言和写法。例如,JSON 中
{、"、: 这类符号往往各自成
Token,所以同样篇幅的 JSON 比纯文本更贵。
Token 是计价的唯一尺子。
- 每次请求都包含看不见的 System Prompt、历史对话上下文,思考产生的 Token,都会被计价。对话轮次越多,历史上下文越长,单次请求的 Token 消耗就越高,就越贵。
上下文窗口是模型单次能 看见 的信息上限,而这个上限按 Token 计量。
Temperature、Top-P、Top-K 分别控制什么?模型在相同参数下输出不一致是为什么?为什么 Temperature 设置为 0,模型输出仍然可能不完全一致?
这三个采样参数共同控制模型选词时的随机性
- Temperature(温度) 控制的是概率分布的形状。低温会让高概率词的优势被放大,模型更倾向于选择最可能的词;高温会压平分布,让原本概率较低的词也有机会被选中,从而增加多样性。当 Temperature 趋近于 0 时,模型退化为近似贪心解码,每一步都倾向于选概率最高的 token。
- Top-K 是一个固定数量的候选池。它只保留概率最高的 K 个 token,其余的直接排除。K=1 就等同于贪心解码;K=40(常见默认值)意味着每次从概率最高的 40 个词里选。它的局限在于一刀切,不管这 K 个词的概率加起来占了多少,候选池大小是固定的
- Top-P(核采样) 是一个动态数量的候选池。它从概率最高的词开始累加,直到累计概率达到 P 值为止,只在这个集合里采样。比如 P=0.9,如果前 3 个词的累计概率就到了 0.9,候选池就只有 3 个词;如果前 20 个词才凑够 0.9,候选池就有 20 个。Top-P 比 Top-K 更灵活,因为它会根据每次预测的概率分布自适应调整候选范围。
实际调用时,这些参数通常按一定顺序生效,先由 Top-K 圈定一个固定大小的候选集,再由 Top-P 在这个集合内进一步按累计概率裁剪,最后用 Temperature 调整后的概率分布进行采样。
模型本来就是在做随机采样,同一个提示词每次走不同的选词路径都是概率性的,输出自然不同。
Temperature=0 只意味着在给定概率分布下选择最高概率的 token,是贪心解码,不能保证每次计算出的概率分布本身完全相同。
浮点数加法的顺序不固定。 大模型推理涉及海量矩阵乘法,GPU 多线程并行计算时,加法执行的顺序每次可能不同。浮点加法不满足严格的结合律,
(A+B)+C和A+(B+C)的结果在低位可能有细微差异。绝大多数时候这点误差不影响结果,但当两个候选 token 的概率极其接近时,一个比特的差异就可能改变最终选择,进而通过自回归生成放大到整段文本。
上下文窗口是什么?上下文窗口越大,效果一定越好吗?长上下文场景下怎么缓解?什么是 Lost in the Middle 问题?上下文窗口和注意力机制的关系是什么?
上下文窗口指模型一次调用能处理的最大 Token 数量,它的本质是单次推理的工作内存
它不是持久记忆。一次对话结束后,窗口里的内容不会自动保留到下一次。
上下文窗口扩大在工程上带来了可能性,但效果存在天花板。
- 注意力资源的稀释。 窗口里塞入的信息越多,每个 token 能分到的注意力权重理论上越稀薄。
- 训练层面的隐性代价:机制上的解释是,当训练上下文中总是充斥着相关信息时,模型会倾向于依赖上下文来降低损失,而不是理解知识,导致模型在推理时更依赖外部上下文,一旦上下文缺失或具有误导性,鲁棒性就会下降。
- 成本上升。 Transformer 的计算复杂度随序列长度呈平方级增长。长上下文不仅推理更慢,费用也更高。
长上下文场景下怎么缓解
- 既然注意力存在位置偏置,那么,把最重要的信息放在模型最关注的位置,开头或结尾。工程上常用三明治结构:任务指令和核心问题放在最前面,支撑材料放中间,最后再重复一次问题或生成指令。
- 压缩中间内容。让核心内容有机会落在高注意力区域
- 检索与长上下文混合使用。
Lost in the Middle 指的是,当关键信息位于长上下文的中间位置时,模型检索和利用该信息的能力显著下降。
归因于注意力机制的位置偏置。放在开头或结尾的信息更容易被模型找到,而埋在中间的内容容易被忽略。
上下文窗口决定了模型能看到多少,注意力决定了模型实际在看哪里。
注意力机制决定了,窗口内每个 token 并不是被平等对待的。模型通过注意力权重来分配关注度,而位置信息会系统性地影响这些权重。
这也解释了为什么“扩大窗口”不能简单等同于“提升长上下文能力”。
大模型为什么会产生幻觉?常见缓解方案有哪些?
因为大模型是概率生成的,概率生成不等于事实验证
根据前面的 Token 序列,预测下一个 Token 的条件概率,模型是在进行条件概率建模,而不是对每一个生成的事实都执行独立的真实性验证。
然后,大模型通过预训练获得大量知识,但这些知识并不是实时更新且完全准确的,也会导致幻觉
而且,训练和对齐机制的影响,会导致模型可能不知道某个问题的正确答案,但依然给出确定性的回复。这种幻觉与训练有关。
即使提供了正确上下文,仍然可能产生幻觉,因为上下文过长、信息干扰、复杂推理错误等原因
常见的幻觉缓解方案
- 在 Prompt 层面,约束模型的回答行为,适当降低
temperature,减少采样随机性。 - 通过 RAG,为模型提供外部知识依据,先检索,再生成
- 通过工具调用,将事实查询交给确定性系统,而不是依赖模型直接生成。
- 可以在生成结果后进行事实校验
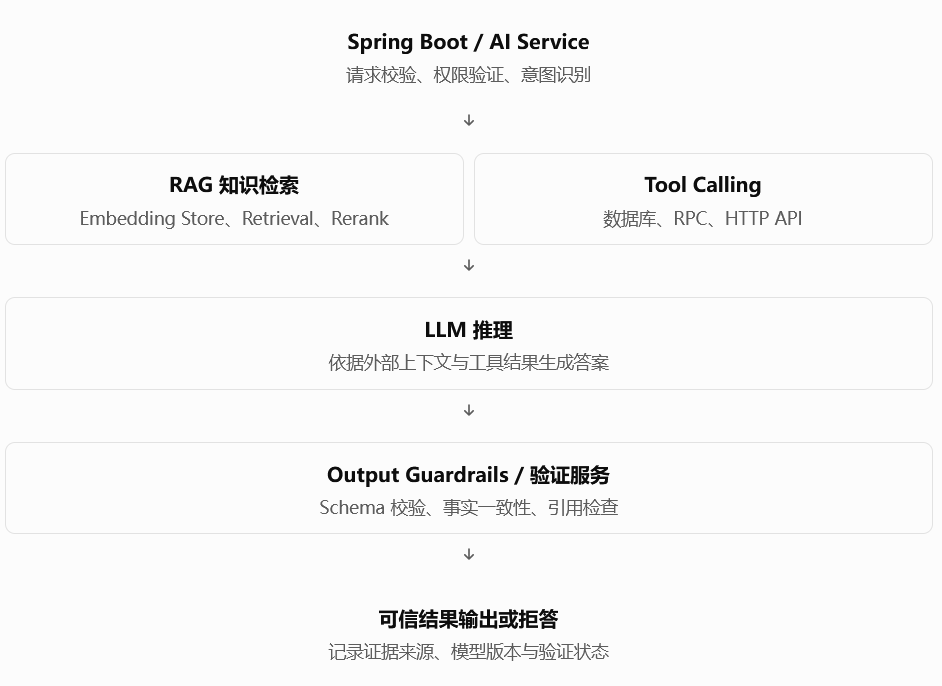
- 关于证据验证,在模型完成回答后,将答案拆分成若干事实性断言,再检查每个断言是否能够被检索资料或工具结果支持。如果发现证据不足,可以尝试补充检索、重新生成;如果仍无法验证,就返回不确定结果
AI Agent 基础
JSON Mode 和 结构化输出 有什么区别?为什么只写“请返回 JSON”不可靠?JSON Schema 在大模型应用里解决什么问题?
Function Calling 的完整链路是什么?Function Calling 和 MCP 有什么区别?MCP Tool 和普通 HTTP API 有什么关系?
Function Calling 解决模型如何表达工具调用意图的问题,是模型的能力,而 MCP 解决外部工具如何标准化暴露、发现和调用的问题,是工具集成协议
- Function Calling:大模型如何决定调用工具,以及工具调用如何完成闭环。是模型与应用之间的工具调用机制
- MCP(Model Context Protocol):AI 应用如何按照统一协议发现和使用外部工具、资源。
- 普通 HTTP API:MCP Tool 如何与第三方集成。是具体业务能力的一种实现和访问方式。
Function Calling,也称 Tool Calling,是大模型调用外部工具的一种机制。
完整流程
- 首先由应用程序向模型发送用户问题,以及工具的名称、描述和 JSON Schema 参数定义。
- 模型根据用户意图和工具定义,判断是否需要调用工具。如果需要,它通常不会直接执行代码,而是返回一个结构化的 Tool Call,包含工具名称、调用参数及调用标识。
- 应用程序收到 Tool Call 后,根据工具名称找到对应执行器,进行参数校验、权限检查,并执行 Java 方法、数据库查询或者 HTTP API 调用。
- 工具执行完成后,应用将执行结果与对应的 Tool Call ID 关联,再次提交给模型。模型根据工具结果继续推理,生成最终回答;
- 如果任务尚未完成,还可能继续发起工具调用,形成多轮循环。
而 MCP 作为协议
- MCP 定义了 Host、Client、Server 的协作架构,采用 JSON-RPC 消息格式。MCP Tool 可以封装已有的 REST API,也可以直接进行调用和操作。其内部业务实现可以保持不变,只需要通过 MCP Server 对外暴露标准化的工具定义与调用入口。
Function Calling 让 LLM 能够提出工具调用请求,MCP 让外部工具能够被标准化接入和复用,而底层原有的 HTTP API、RPC 和 Java Service 仍然负责真正的业务执行。
在 Java + LangChain4j 项目中,对于普通本地工具,可以使用
2
3
4
public OrderStatus queryOrder(String orderId) {
return orderService.queryStatus(orderId);
}如果要接入独立的 MCP Server,可以采用 LangChain4j 的
McpToolProvider:
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
StreamableHttpMcpTransport.builder()
.url("https://example.com/mcp")
.build();
McpClient mcpClient =
DefaultMcpClient.builder()
.transport(transport)
.build();
McpToolProvider toolProvider =
McpToolProvider.builder()
.mcpClients(mcpClient)
.build();
Assistant assistant =
AiServices.builder(Assistant.class)
.chatModel(chatModel)
.toolProvider(toolProvider)
.build();这样就不需要在 Agent 中为每个 MCP Tool 单独编写一个本地
@Tool代理方法。
模型并行调用了两个工具,返回顺序错乱,你怎么保证结果不错位?
如果让你设计一个多模型统一接入层(网关),需要考虑哪些模块?
RAG 基础
长上下文窗口和 RAG?二者分别适合什么场景?
长上下文窗口适合 需要完整视野 的任务。
当任务要求模型理解文档的整体结构、跨段落推理、或保持叙事连贯性时,把完整材料放进窗口是更自然的选择。
例如,在基于维基百科的问答基准上,长上下文通常优于 RAG,因为模型能看到原始顺序和完整段落,不会因分块而丢失上下文。
如果只有少量文档、查询频率不高,且需要模型做深度综合而非精确检索,长上下文的工程链路更短、效果更直接。
RAG 适合知识库远大于窗口或需要精确命中的场景。RAG 的核心价值在于把检索范围,从窗口内扩展到任意规模的知识库,它天然适合,知识库持续更新的场景,用户查询需要精确匹配的场景,数据量远超任何模型窗口的场景,或者缓解大模型幻觉上。RAG 的代价是依赖检索质量。
最后,决策如下
- 任务类型:需要全局综合、叙事理解、跨文档推理的任务,长上下文占优。需要从海量语料中精确定位、且答案集中在少数片段的任务,RAG 更合适。
- 工程可行性:RAG 的数据量远超模型上下文窗口
实际上,这两个经常组合使用,一般是用 RAG 做粗筛,用长上下文做精读
RAG 为什么必须分检索和生成两段?能简要说说 RAG 的工作流程吗?
RAG 先检索外部知识,再让大模型基于检索结果生成答案。
- 检索阶段:知识从哪里来
- 生成阶段:如何利用知识回答问题
首先,在离线阶段,对原始文档进行解析、分块、Embedding 向量化,并建立向量索引。
用户提问时,在在线阶段对问题进行向量化,通过向量检索或者混合检索召回相关文档,再利用 Reranker 对结果重新排序,筛选出最相关的上下文。
最后,将检索结果与用户问题共同组装成 Prompt,交给大模型生成答案,并根据需要进行引用校验和结果验证。
RAG 分离线建立知识库和在线进行检索增强生成,这样两步
flowchart TD
    subgraph A["离线阶段:知识库构建"]
        A1["原始文档"] --> A2["解析、清洗"]
        A2 --> A3["文本分块 Chunking"]
        A3 --> A4["Embedding 向量化"]
        A4 --> A5["向量数据库 / 检索索引"]
    end
    subgraph B["在线阶段:检索增强生成"]
        B1["用户问题"] --> B2["Query 向量化"]
        B2 --> B3["相似度检索 / 混合检索"]
        B3 --> B4["Rerank 重排序"]
        B4 --> B5["Prompt 组装"]
        B5 --> B6["LLM 生成答案"]
        B6 --> B7["结果验证与返回"]
    end
A5 -.-> B3- 为什么不直接把整个知识库交给大模型
- 知识库规模可能远超模型上下文窗口
- 大量无关内容会增加 Token 成本和推理延迟,还可能干扰模型对重要信息的理解
- 检索和生成必须是两个独立的 API 调用吗
- 检索和生成只是逻辑职责上的划分,不一定需要两个独立服务或两个 HTTP 请求。