Redis 数据库本身的数据结构
Redis 的键值对中的 key 就是字符串对象,而 value 就是指Redis的数据类型,可以是String,也可以是List、Hash、Set、 Zset 的数据类型。
Redis 底层使用了一个 全局哈希表 保存所有键值对,哈希表的最大好处就是 O(1) 的时间复杂度快速查找到键值对。
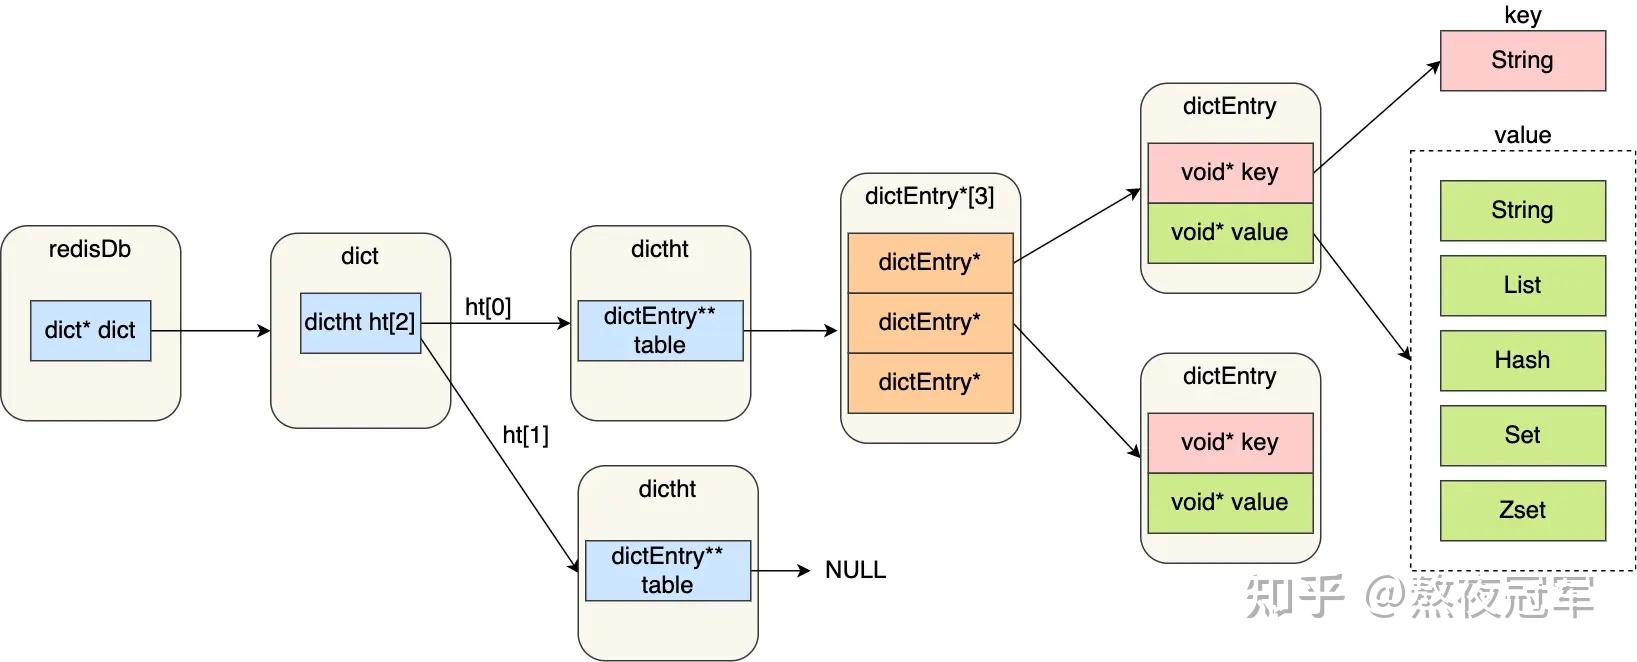
这个全局哈希表不是孤立存在的,而是嵌套在多层 C 结构体中:
1 | redisServer(服务器) |
redisServer,
redisServer是 Redis 服务器的顶层结构,里面有一个指向redisDb数组的指针,dbnum默认是 16,也就是我们熟知的SELECT 0~15那 16 个数据库。每个数据库相互隔离,但结构相同。redisDb 结构,表示 Redis 单个数据库的结构,每个
redisDb里存放一个指向dict结构的指针,这个dict就是该数据库的全局哈希表,保存了这个库里所有的键值对。dict 结构,哈希表的管理结构,结构体里存放了 2 个哈希表,正常情况下都是用
ht[0],ht[1]只有在 rehash 的时候才用;rehashidx记录 rehash 的进度,-1表示当前没有进行 rehash。1
2
3
4struct dict {
dictht ht[2]; // 两个哈希表,一个开始为空,rehash迁移时使用
long rehashidx; /* rehashing not in progress if rehashidx == -1 */
};为什么要两个哈希表? 因为 Redis 的 rehash 是渐进式的。当哈希表需要扩容时,不是一次性把所有元素搬完,那样会阻塞,而是大约是这样的:
- 给
ht[1]分配更大的空间; - 每次对哈希表的操作,顺便把
ht[0]中rehashidx位置的一个桶迁移到ht[1]; - 迁移期间,查找会同时查两个表;
- 全部迁移完后,交换两个表,
rehashidx置为 -1。
- 给
ditctht 结构,表示哈希表本体的结构,结构里存放了哈希表数组,数组中的每个元素都是指向一个哈希表节点结构(dictEntry)的指针;
1
2
3
4
5
6typedef struct dictht {
dictEntry **table; // 哈希表节点数组
unsigned long size; // 哈希表大小
unsigned long sizemask; // 大小掩码,总是等于 size-1,用于计算索引
unsigned long used; // 已存节点数,used / size 就是负载因子,用于判断是否需要扩容
} dictht;dictEntry 结构,表示哈希表节点的结构,也就是真正存 key-value 的地方,结构里存放了
void* key和void* value指针, key 指向的是一个 SDS 字符串(也就是键名),而 value 指向的是 redisObject,也就是 Redis 的几种数据类型。1
2
3
4
5
6
7
8
9
10
11struct dictEntry {
void *key; // key,指向一个 SDS 字符串
union {
void *val;
uint64_t u64;
int64_t s64;
double d;
} v; // value,一个 union,value 可以是指针,也可以直接存整数/浮点数
struct dictEntry *next; // 下一个节点的指针
void *metadata[];
};这里能够体现,哈希冲突用链地址法解决,多个 key 哈希到同一个桶时,用链表串起来。
redisObject 结构,
dictEntry里的void *value指向的就是 Redis 对象(键名 key 在全局哈希表里直接存成 SDS,不经过 redisObject)。Redis 用 C 实现,没有 Java 的Map<String,Object>,所以用redisObject结构统一表示每个对象1
2
3
4
5
6
7typedef struct redisObject {
unsigned type: 4; // 对象类型
unsigned encoding: 4; // 对象所使用的编码,大概就是标识底层用了哪种数据结构
unsigned lru: 24; // LRU 时间,或 LFU 的计数与访问时间
int refcount; // 引用计数
void *ptr; // 指向底层实现数据结构
} robj;早期版本的 redisObject 里还有一个
storage字段,用来标记对象在内存里还是被换出到磁盘,那个虚拟内存机制在 Redis 2.4 之后就被移除了。现在的结构体就是type、encoding、lru、refcount、ptr五个字段,前三个位域合起来占 32 位,其中lru占 24 位、type和encoding各占 4 位,整个头部在 64 位系统上是 16 字节。正是
encoding字段,让同一种 type 可以有不同底层实现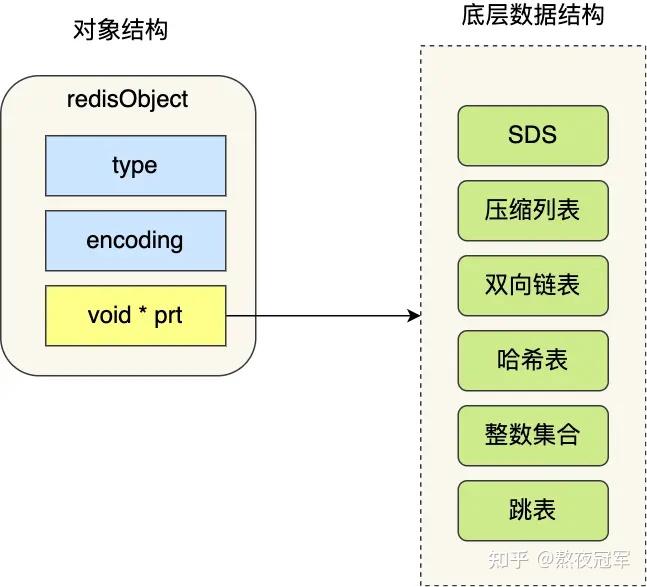
基本数据类型
Redis支持五种数据类型:string(字符串),hash(哈希),list(列表),set(无序集合)及 Zset(有序集合)。
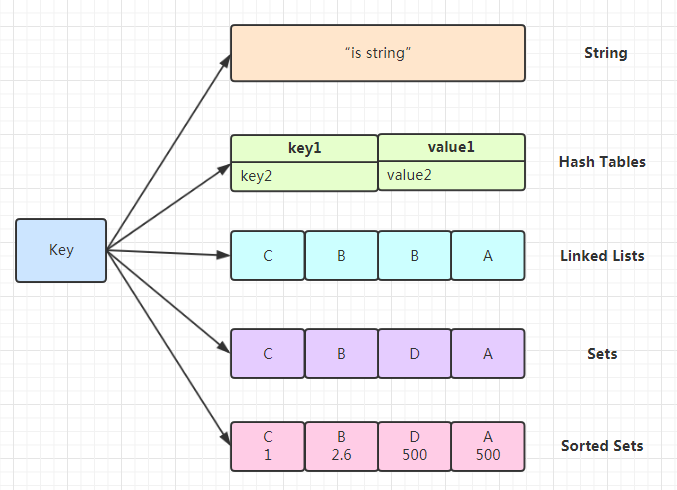
字符串 String
SDS
SDS,Simple Dynamic String,简单动态字符串,Redis 字符串的底层数据结构都用这个
Redis 的 String 字符串类型底层并不是直接使用 C 语言的原生字符串,而是自己实现了一个叫 SDS 的结构.
自己这么实现肯定是 Redis 认为C语言的原生实现有问题。确实,会遇到三个问题
O(n) 获取长度
C 字符串以
\0结尾,strlen必须从头遍历到\0才能数出长度,复杂度 O(n)。对一个高频操作长度、频繁追加的数据库来说,这个开销不可接受。只能保存文本,不能存二进制
同样因为
\0是结束符,字符串中间一旦出现\0,就会被误认为结尾。这意味着 C 字符串无法保存图片、音频、视频等二进制数据,而二进制里\0太常见了。而 Redis 需要能存任意字节。缓冲区溢出问题
C 字符串不记录自身缓冲区大小,
strcat假定目标已分配足够空间。一旦假定不成立,就会溢出,可能导致程序崩溃。
SDS 的结构体核心字段如下
| 字段 | 含义 | 解决的问题 |
|---|---|---|
len |
记录字符串长度 | 获取长度 O(1),直接返回 len
即可,不用遍历 |
alloc |
分配给字符数组的空间长度 | 修改时用 alloc - len
算出剩余空间,不够就自动扩容,杜绝缓冲区溢出 |
flags |
标识 SDS 类型 | 共 5
种:sdshdr5、sdshdr8、sdshdr16、sdshdr32、sdshdr64,按字符串大小选不同头,省内存 |
buf[] |
实际保存数据的字符数组 | 用二进制方式处理,既能存文本也能存二进制数据 |
SDS 名字里的”动态”,核心就是指动态扩容。
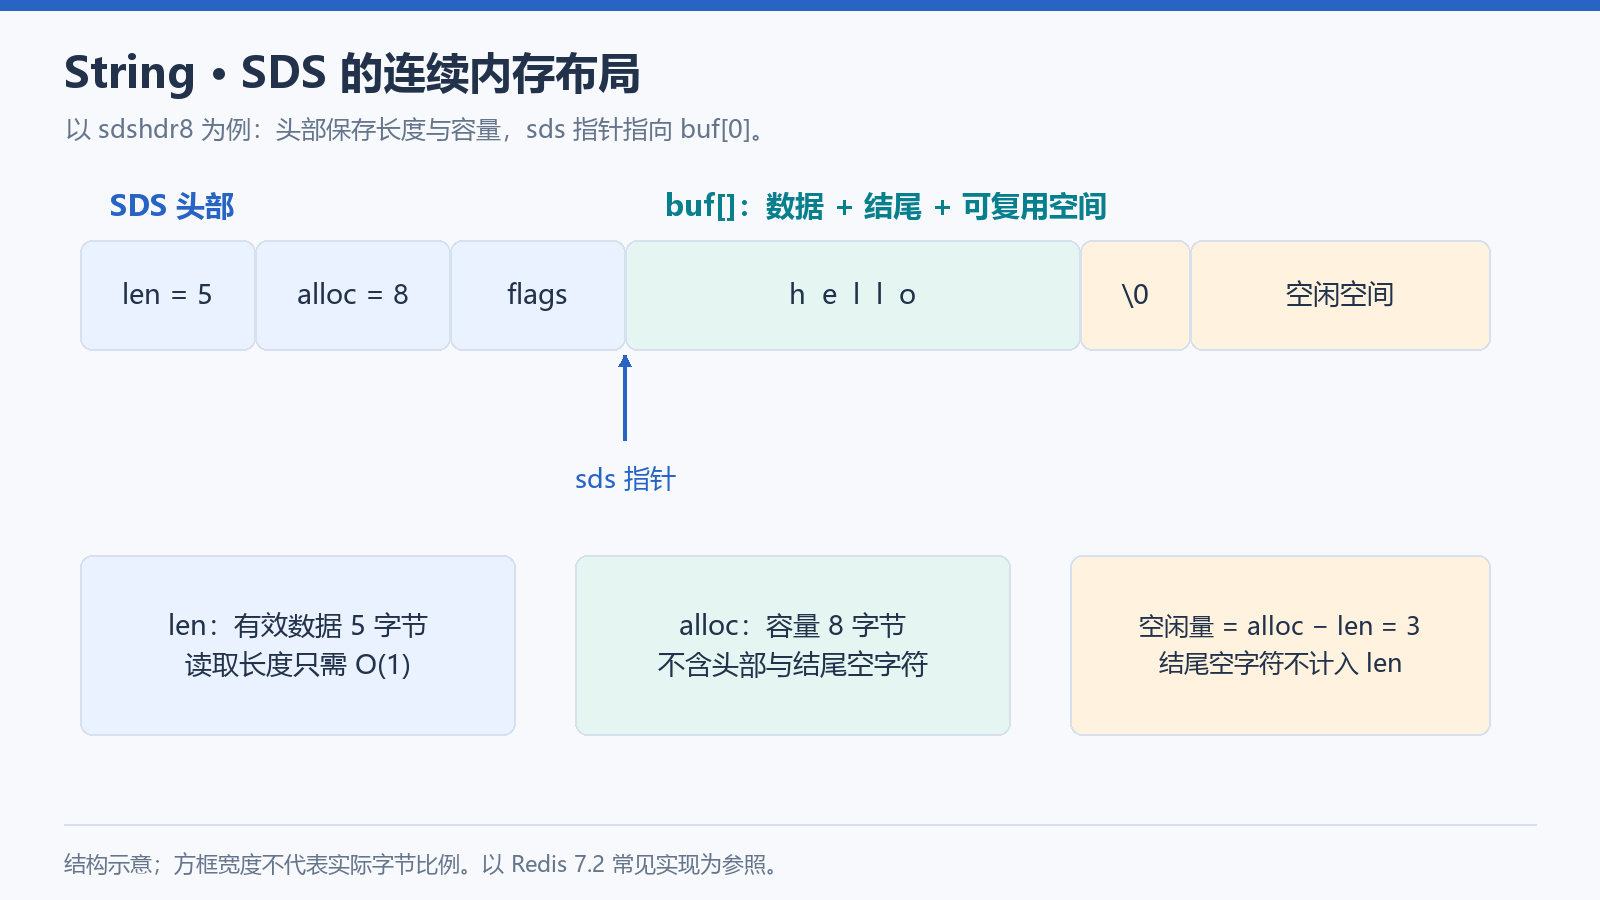
SDS 连续内存布局示意:len 记录有效长度,alloc 记录可用容量,sds 指向数据区。
1 | hisds hi_sdsMakeRoomFor(hisds s, size_t addlen) |
扩容规则总结为两条:
- 所需长度 < 1MB:按 2 倍 newlen 翻倍扩容。
- 所需长度 ≥ 1MB:扩容为 newlen + 1MB。超过 1MB 只加 1MB
SDS 的空间回收
SDS
在缩短时不急着释放内存。sdstrim、sdsrange、sdstolower
这类操作只改 len,alloc
保持不变,腾出来的空间原样留着,后续 APPEND
可以直接复用,避免频繁 realloc。
真正要回收时,Redis 调用 sdsRemoveFreeSpace 或
sdsResize,把 alloc 调整到接近
len 的大小,必要时用 realloc 缩容。Redis 7 的
sdsResize 还多了一个 would_regrow
参数,如果调用方预计这块空间很快又会被用起来,可以告诉函数不要缩得太狠,省掉一次缩了又扩的往返。
这种惰性释放的代价是内存占用可能在一段时间内高于实际数据量。一个被写大、之后又被截短的长字符串,RSS
不会立刻下降;再加上 jemalloc
本身就不一定把释放的页还给操作系统,所以排查内存问题时,MEMORY USAGE
看到的是对象自身占用,RSS 看到的是分配器的高水位,两者不是一回事。
一个 Redis String 键值对的结构是:
1 | dictEntry(全局哈希表中的节点) |
- 全局哈希表的 key 永远是 String 对象,所以 key 底层就是 SDS。
- value 如果是 String
类型,
redisObject.type = OBJ_STRING,ptr指向一个 SDS。 encoding字段会标识具体编码(如int、embstr、raw),字符串数据在 SDS 的buf[]里。
所以 SDS 是 Redis 中最基础、最底层的字符串载体,键名靠它、String 值靠它、其他类型的很多元数据也靠它。
String 的三种编码
SDS 只是底层字符数组,到了对象层,Redis
还会根据字符串内容再选一次更省内存的编码。redisObject.encoding
对 String
类型有三种取值:int、embstr、raw,用
OBJECT ENCODING key 可以直接看到当前是哪种。
int:当 value 是一个能用long表示的整数,并且长度不超过 20 个字符时,Redis 直接把数值存进redisObject.ptr这个 8 字节指针本身,不再分配 SDS。指针被当成整数用,这是最省内存的编码,所以SET k 123存进去的是整数而不是字符串。INCR、DECR在这类对象上直接做数值运算,如果加完超出long的范围会直接报溢出错误,而不是自动转成字符串。另外 Redis 启动时会预创建 0 到 9999 这一万个整数对象(OBJ_SHARED_INTEGERS),返回这些小整数时直接复用共享对象,把引用计数加一即可,连分配都省了。embstr:当字符串长度小于等于 44 字节时使用。它的特点是redisObject和 SDS 一次性分配在同一块连续内存里。算一下大小:redisObject在 64 位系统上是 16 字节,sdshdr8头部 3 字节,字符串内容 44 字节,末尾\01 字节,合计 64 字节,正好落在 jemalloc 的 64 字节尺寸类上。一次分配、一次释放,没有两次内存分配的开销,也提高了缓存局部性。代价是 embstr 被设计成只读,任何原地修改命令(APPEND、SETRANGE、INCRBYFLOAT)都会先把它转成raw再改。raw:长度大于 44 字节,或者由 embstr、int 修改而来。redisObject和 SDS 分开两次分配,ptr指向一个独立的 SDS,长度可变、可追加。
编码的选择发生在 tryObjectEncoding
里,顺序是先看能不能转成整数,再看长度是否适合 embstr,都不行就用
raw。有三种情况值得注意:
SET、SETNX这类整体赋值的命令会对新值重新做一次编码选择,所以同一个 key 的编码可以随着新值变化,比如先存一个长字符串(raw),再存一个短数字(int)。- 原地修改类的命令不会让编码变得更省。
APPEND一个 int 编码的对象,会先把它转成 raw;embstr 被修改后也只会变成 raw。之后即使再把内容改回很短的字符串,也不会退回 int 或 embstr。 INCR、DECR在 int 编码上是纯内存的数值运算,在 embstr 和 raw 上则要先把字符串解析成 long,所以计数器场景下从一开始就用整数赋值,能让后续自增更省 CPU。
对客户端来说这三种编码没有区别,GET
永远返回字符串,OBJECT ENCODING
只是把底层实现暴露出来方便排查内存问题。一个 20 位的数字字符串,如果能被
long 装下,它显示的就是
int,但取出来仍然是一串数字字符。
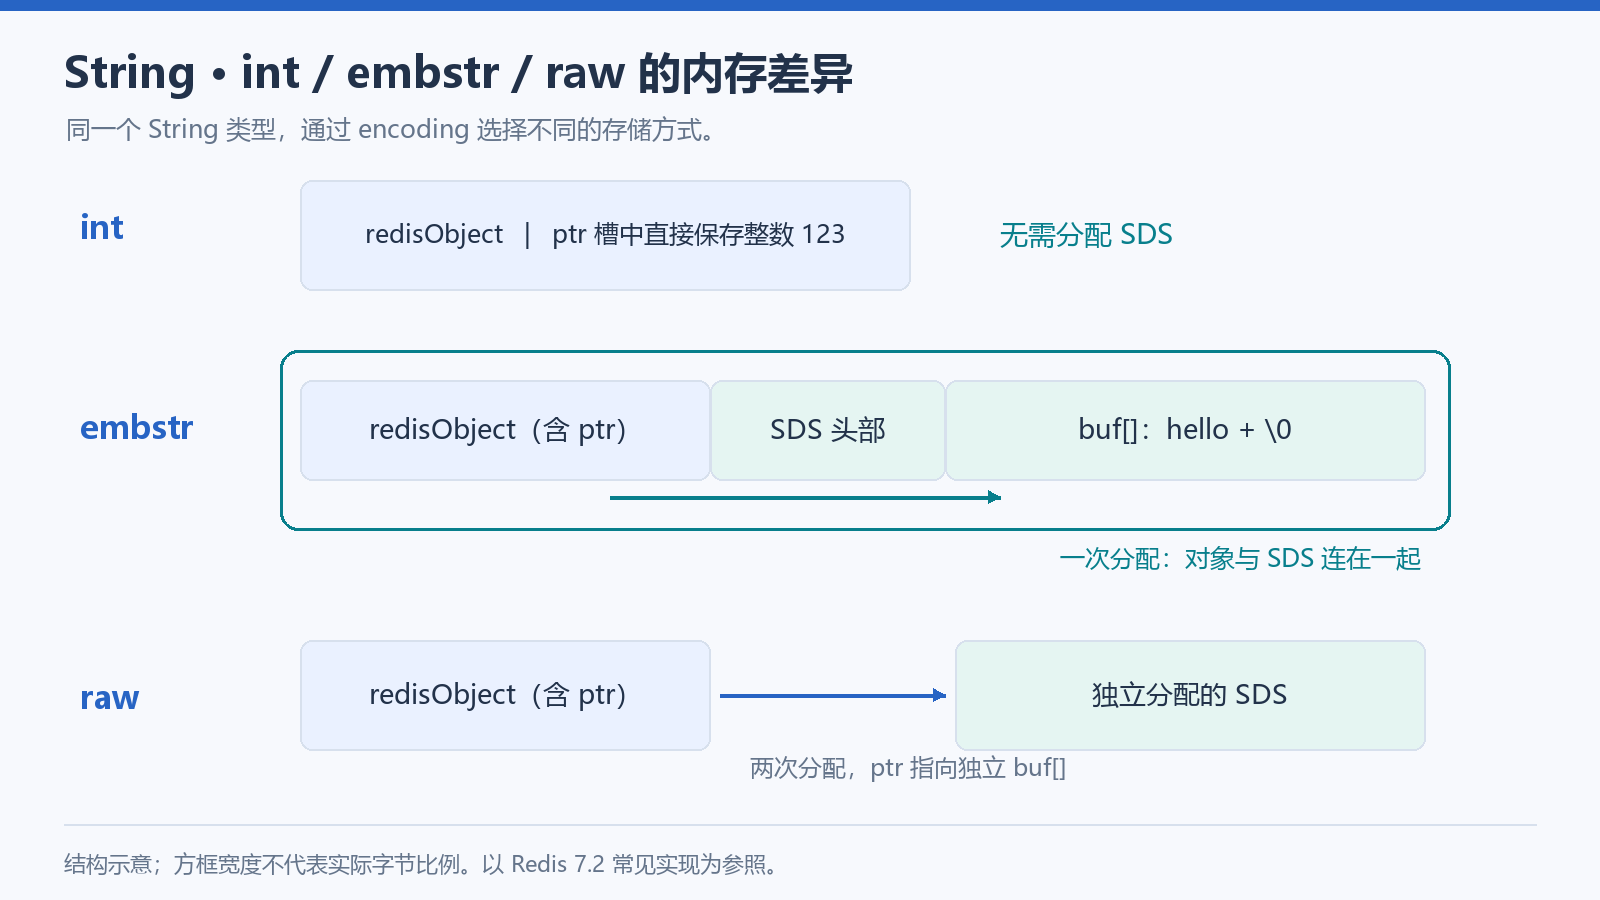
三种编码的差异主要在整数是否直接存储,以及 redisObject 与 SDS 是否在同一块内存中。
哈希 Hash
Hash 是一个 String 类型的 field 和 value 的映射表,一个 key 对应多个
field,一个 field 对应一个 value;value 只能是字符串,这就类似于
Map<String, String>:外层 key 是 Redis
的键,内层是一组 field→value 的键值对。
因此,Hash 和 String 都能存字符串,Hash 的三个优势是这样
- 批量获取高效:需要批量取值时,一个
HMGET命令就能拿到多个 field,而 String 要多次GET。 - 节省内存空间:小 Hash 用紧凑的
listpack编码,field 和 value 交替存放在同一块连续内存里,没有哈希表的桶数组和节点指针开销,比把同一组数据拆成多个 String 键保存省得多。 - 支持单字段操作:
HSET、HINCRBY、HDEL只改其中一个 field,不用像 String 那样把整个 value 读出来改完再写回去。对计数器、购物车这类需要频繁局部更新的数据,Hash 既省网络往返,也避免了并发写覆盖整个 value 的问题。
但 Hash 也有明确的不适用场景
- field 不能单独设置过期时间(Redis 7.4
之前):过期只能对 key 设置,一旦过期,该 key 下所有 field
一起过期。String 可以设置独立过期时间。从 Redis 7.4 开始提供了
HEXPIRE、HPEXPIRE、HEXPIREAT、HPERSIST、HTTL这组命令,field 也能单独设置过期时间,所以这一条在 7.4 之后已经不再成立。 - 数据量分布问题:value 非常大时,无法分布到多个节点,因为 Redis Cluster 按 key 分片
- 没有 bit 操作:String 支持
SETBIT/GETBIT等位操作,Hash 不支持。
具体来说 Hash 的存储是两层而且双结构的
- 外层哈希(Redis 全局 KV 的实现)只用 hashtable;
- 内层哈希(即 Hash 类型的 value 本身)底层是两种结构:
- 小数据量时用紧凑的
listpack(Redis 7.0 之前是ziplist) - 数据量变大或元素过长时,自动转换为标准的哈希表
hashtable来保证查询效率。
- 小数据量时用紧凑的
这种切换由两个配置项控制,默认阈值如下:
hash-max-listpack-entries:默认 512。控制 field-value 对的最大数量。hash-max-listpack-value:默认 64。控制单个 field 或 value 的最大字节长度。
必须同时满足上述两个最大数量,否则会转换为 hashtable
编码,而且是单向转换
当 Hash 很小时,listpack 是一块连续的内存,把 field 和
value 紧挨着依次存放。它没有指针开销,因此查找特定 field
需要从头遍历。
listpack 里的 Hash
listpack 编码的 Hash 布局非常直接,所有 field 和 value
按插入顺序一个接一个排成一条:
1 | [field1][value1][field2][value2] ... |
每个 field 或 value 都是一个独立的 listpack
entry。listpack 中每个 entry 的结构大致是:
1 | [ encoding | data | backlen ] |
encoding:标识数据类型(整数/字符串)和长度。data:实际数据。backlen:当前 entry 自身总长度,放在尾部,用于从后向前遍历。
查找某个 field 时,从头部开始逐个 entry 比较 field
名,命中后再取它后面那个 entry 作为 value。所以
HGET、HSET 在 listpack 编码下是
O(N),之所以还能接受,是因为 N 被限制在 512
以内,而且所有数据都挤在连续内存里,CPU
缓存命中率很高,小数据量下实测往往比走哈希表还快。
Redis 官方文档里专门建议用 Hash 来存小对象,甚至在纯 key-value 场景下,官方示例把 key 的最后两位拆成 field 名,把一百个 String 键合并成一个 Hash,靠的就是这个编码特性。
listpack 编码有两个明确的转换出口:
- field 或 value 的长度超过
hash-max-listpack-value(默认 64 字节),写入时直接触发全量转换,整个 Hash 变成hashtable。 - field 的数量超过
hash-max-listpack-entries(默认 512),插入后比较计数器,超了就转换。
转换是单向的。一旦变成 hashtable,就算之后把 field
删到只剩一个,也不会退回
listpack。原因是转换本身要遍历重建整个结构,如果允许双向转换,删了又加、加了又删的场景就会反复重建,开销不可控。
Redis 7.4 起 Hash 支持 field 级过期,HEXPIRE
系列命令(以及 HTTL、HPERSIST
等)就是为此加的。小 Hash 第一次给某个 field 设置 TTL 时,会从
listpack 转成 listpackex 编码,底层仍然是
listpack,只是每个 field 后面多追加一个 TTL entry,变成
field、value、ttl 三个一组,并额外维护一份按 TTL
排序的索引;只有规模超过 hash-max-listpack-entries 的 Hash
才走 hashtable。
ziplist
它是 Redis 7.0 之前 List、Hash、ZSet 共用的紧凑编码。
ziplist
是一个经过特殊编码的双向链表,但它不存储前后节点指针,而是存储上一个节点长度和当前节点长度,典型的时间换空间
ziplist 由连续内存块组成,其头部有几个关键字段:
zlbytes:整个 ziplist 占用的字节数;zltail:尾部节点距起始地址的偏移量(便于 O(1) 定位尾节点);zllen:节点数量;zlend:结束标记,固定0xFF。
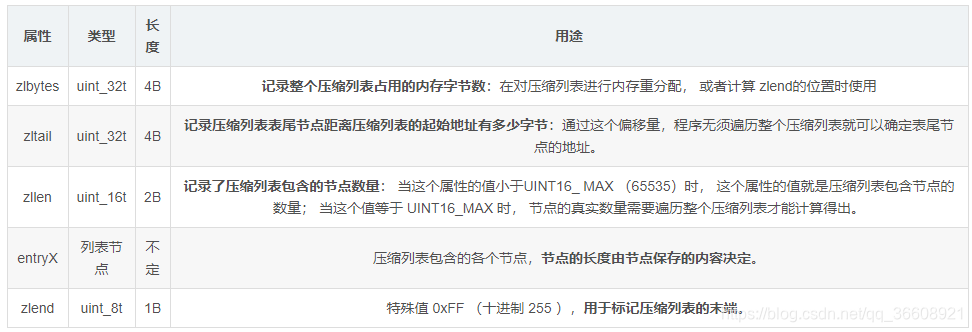
后面紧跟着一个个 zlentry,每个 zlentry
可以存一个整数或一个字符串,在 Hash 中,它成对出现,一个 entry 存
field,下一个 entry 存 value,交替排列,从而记录每一组 KV
数据。zlentry 的核心字段
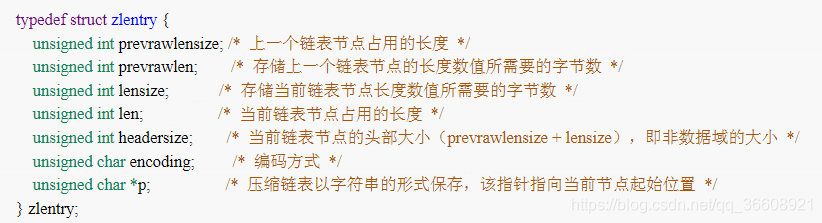
其中对于zlentry的encoding编码方式,在hash类型中实现时主要有:
编码 含义 长度上限 ZIP_STR_06B(0<<6)长度 ≤ 63 字节 63 字节 ZIP_STR_14B(1<<6)长度 ≤ 16383 字节 16383 字节 ZIP_STR_32B(2<<6)长度 ≤ 4294967295 字节 约 4 GB 这样设计能够按数据大小选不同位宽的编码,小数据用小编码,省内存,这正是 ziplist中 压缩的来源
哈希表 hashtable
先明确一点,dict 在 Redis
里被复用了很多次。全局键空间是一张 dict,过期字典 expires
是一张 dict,Hash 类型转成 hashtable 编码之后内部还是一张
dict,Set 的 hashtable 编码、ZSet 里 member 到 score
的索引,用的同样是 dict。这些场景共用同一套实现,差别只在于
dictType
1 | typedef struct dictType { |
这意味着全局哈希表里的 key 存的是一个 SDS,value 存的是一个
redisObject 指针。
再往下看几个关键点:
- 桶数组
table的长度永远是 2 的幂,计算索引不用取模,直接hash & sizemask,sizemask就是 size 减 1。把取模换成按位与,是哈希表实现里最常见的优化。 - 哈希冲突用链地址法,新节点直接插到链表头部,
dictEntry.next指向旧的头节点。这样插入是 O(1),不需要遍历到链表尾部。 - 查找分两步:先算哈希值定位到桶,再沿着链表用
keyCompare逐个比较。平均 O(1),最坏情况下所有 key 都落到同一个桶,退化成 O(N)。
1 | // Redis 7.0 之后的 dict 结构,省略了条件编译和调试字段 |
一张 dict 的复杂度可以这样总结:
| 操作 | 平均复杂度 | 最坏复杂度 |
|---|---|---|
| 查找 | O(1) | O(N) |
| 插入 | O(1) | O(N) |
| 删除 | O(1) | O(N) |
| 全量遍历(如 KEYS、HGETALL) | O(N) | O(N) |
最坏复杂度出现在所有 key 都冲突到同一个桶的极端情况。正常情况哈希函数足够均匀、负载因子被控制在 1 附近,链表很短,所以均摊下来就是 O(1)。
哈希函数,哈希算法
哈希表能不能做到 O(1),很大程度上取决于哈希函数。
一个合格的哈希函数要做三件事:把任意长度的 key 映射成一个整数、让结果尽量均匀地散布到所有桶里、计算速度还要足够快。
Redis 对哈希函数的选择经历过一次重要变化。
早期 Redis 用的是 MurmurHash2,这是 Austin Appleby 设计的一种非加密哈希,速度快、雪崩效应好。但非加密哈希有一个致命问题:算法是公开的,只要种子固定,攻击者就可以刻意构造大量哈希值相同或者落到同一个桶的 key,让哈希表退化成链表。一次请求本来是 O(1),被攻击后变成 O(N),服务端 CPU 被打满,这就是哈希碰撞攻击(Hash Flooding),2011 年针对各种语言哈希表的那轮攻击就是这么干的。
Redis 4.0 开始改用 SipHash,具体是 SipHash-1-2 变体。SipHash 是一种带密钥的伪随机函数,密钥在 Redis 启动时从系统随机源生成并保存在进程内,攻击者不知道密钥,就无法提前构造出必然碰撞的 key。这样一来,即使攻击者能控制 key 的内容,算出来的哈希值对他来说也是不可预测的,没法定向把 key 聚到某个桶里。
SipHash 的内部结构可以简单理解为:
- 用 128 位密钥和几个固定常量初始化 4 个 64 位状态变量
v0、v1、v2、v3。 - 把输入按 8 字节一块切开,每块和状态变量异或,再做若干轮 SipRound(加法、异或、循环移位组合),把消息混进状态。
- 最后一块带上消息总长度,做终结轮,输出 64 位结果。
不同场景下 Redis 用的哈希函数并不完全一样:
- 普通字符串 key 用
dictSdsHash,内部调用siphash,比较时区分大小写。 - 命令表用
dictSdsCaseHash,内部调用siphash_nocase,比较时不区分大小写,因为 Redis 命令名本身大小写不敏感。 - 用
redisObject做 key 的地方用dictObjHash,比如blocking_keys、watched_keys、pubsub_channels,实际上是取出对象里的 SDS 再算哈希;ZSet 的字典用 SDS 做 key,走的是dictSdsHash。 - 整数 key 有专门的整数哈希函数,不做字符串转换,直接对整数做混合。
这里要和 Redis Cluster 的键分布区分开。Cluster 把整个键空间分成 16384 个槽,用 CRC16 算 key 的槽位再对 16384 取模;单机 dict 用 SipHash 算桶位置。前者解决的是 key 该放到哪个节点,后者解决的是 key 该放到哪张表的哪个桶,两者目的不同,不能混为一谈。
哈希函数的输出是 64 位无符号整数,落到桶里时不会直接对 size
取模,而是 hash & (size - 1)。这要求 size 必须是 2
的幂,所以 dict 扩容时分配的大小都是 2 的幂,_dictNextPower
负责找到第一个大于等于目标值的 2 的幂。
rehash
Redis 的字典底层是哈希表。键值对不断增多或减少时,哈希表的 拥挤程度 会变化。为了让哈希表保存的键值对数量维持在一个合理范围内,当太多或太少时,就要对哈希表大小进行扩展或收缩。这个调整过程就叫 rehash。
需不需要调整是根据负载因子判断的,即已使用节点数 / 哈希表大小
1 | load_factor = ht[0].used / ht[0].size |
负载因子太大,哈希冲突多、链变长、查询变慢,说明需要扩展。负载因子太小,空间浪费,需要收缩
哈希表扩展,例如对 ht[0] 进行扩展
- 为
ht[1]分配空间,大小为第一个大于等于ht[0].used * 2的 2 的幂; - 把
ht[0]上的键值对 rehash 到ht[1],重新计算哈希值和索引,重新插入,插一个删一个 - 全部迁移完后,释放
ht[0],把ht[1]设为ht[0],再在ht[1]上新建一个空表,为下次 rehash 做准备。
触发条件有两个
- 常规扩容:
used >= size(负载因子 ≥ 1)且dict_can_resize为真; - 强制扩容:负载因子 >
dict_force_resize_ratio(默认 5),无视dict_can_resize直接扩容。
1 | if (d->ht[0].size == 0) return dictExpand(d, DICT_HT_INITIAL_SIZE); // 初始大小4 |
dict_can_resize这个开关的作用是:当有子进程在做 RDB 持久化或 AOF 重写时,会暂时禁止常规扩容,避免触发大量内存写时复制(COW);但如果负载因子已经超过 5,冲突太严重,就强制扩容,不再等。
哈希表也会收缩。收缩同样是给 ht[1] 分配空间,大小为
max(ht[0].used, DICT_HT_INITIAL_SIZE),然后做和扩展一样的迁移和重新计算的处理。DICT_HT_INITIAL_SIZE
是初始大小4,保证收缩后不会小于这个值
渐进式 rehash
扩展或收缩时,要把 ht[0] 所有键值对搬到
ht[1]。如果键值对非常多,一次性完成计算压力很大,所以 Redis
采用渐进式 rehash,把迁移分摊到多次操作中。
还是上面的例子,分四步
分配
ht[1],让字典同时持有ht[0]和ht[1]。rehashidx = 0,正式开始,表示从ht[0]下标 0 开始迁移。rehashidx = -1则表示没有在 rehash。rehash 期间,每次对字典执行增、删、改、查,除了执行指定操作,还会把
ht[0].table中下标为rehashidx位置上的所有键值对迁移到ht[1],完成后rehashidx自增。这里还涉及一个稀疏表的处理细节,一路遍历很久都是空桶,函数会阻塞太久。所以引入
empty_visits,初始值为n*10。跳过空桶,但最多跳 empty_visits 个,下次再继续。当
ht[0].used == 0,说明全部迁移完,释放ht[0],ht[0] = ht[1],重置ht[1]为空,rehashidx = -1,标记 rehash 结束。
渐进式 rehash 期间,字典同时存在两张表,操作规则是:
- 查找(GET 类):先查
ht[0],查不到再查ht[1],保证不漏; - 新增(SET 类):直接插入
ht[1],不再往ht[0]写。这样保证ht[0]只减不增,迁移一定能收敛到used == 0; - 删除/修改:两张表都要找,找到就处理。
这个规则是渐进式 rehash 能正确工作的保证,也是面试常考点。
rehash 里还有几个细节值得展开。
- 每次命令操作默认只推进一个桶,而不是一个键值对。
- 除了命令操作,
serverCron里的incrementallyRehash也会主动帮忙,每次最多执行 1 毫秒,每一轮迁移 100 个桶,这样即使没有客户端请求,rehash 也能在后台慢慢走完。 - 渐进式 rehash 把迁移成本摊到每次操作上,单次延迟可控,但 rehash
期间内存里同时存在两张表,峰值内存比稳态高出一截,扩容前要留出余量。另外
rehash 期间新写入都进
ht[1],ht[0]只减不增,rehashidx只会往前走,所以迁移一定能结束,不会出现两张表来回倒的情况。
列表 List
Redis 的 List 类型底层结构经历了一次重要的演进,从早期在
ziplist 和 linkedlist 之间按条件切换,到 Redis
3.2 引入 quicklist 作为统一实现,再到
Redis 7.0 将 quicklist 的节点内容从 ziplist
升级为 listpack。
为什么最后还是需要 quicklist
- 双向链表的问题:每个节点都要额外存储两个指针(
prev/next),这其实是一个很大的开销。而且链表节点在内存中是分散的,容易产生碎片。 - 纯 ziplist
的问题:虽然是一块连续内存,非常紧凑,但一旦数据量变大,任何插入或删除都可能触发整块内存的重新分(
realloc)和大批数据拷贝,代价很高。
quicklist 的思路是把大 List
切分成多个小的紧凑列表块,再用双向链表把这些块串起来。这样既保留了链表在两端插入删除的灵活性,又利用紧凑列表提升了单块内部的内存利用率,同时把内存重分配的影响限制在单个小块内,而不是整个大
List。
quicklist
Redis 中的 List 类型与 Java 中的 LinkedList
类似,因此,quicklist
的本质是一个双向链表,按插入顺序排序,你可以添加一个元素到头部(左边)或尾部(右边)。所以既可以支持正向检索和也可以支持反向检索。
特征也与LinkedList类似:有序,可重复,插入和删除快,查询速度一般
quicklist
的本质是一个双向链表,但它的每个节点不再只存一个元素,而是包装了一个紧凑列表(ziplist
或
listpack),里面可以存放多个元素。也就是说,quicklist
把大 List
切成多个小块,每块是一个紧凑列表,再用双向链表把这些块串起来。
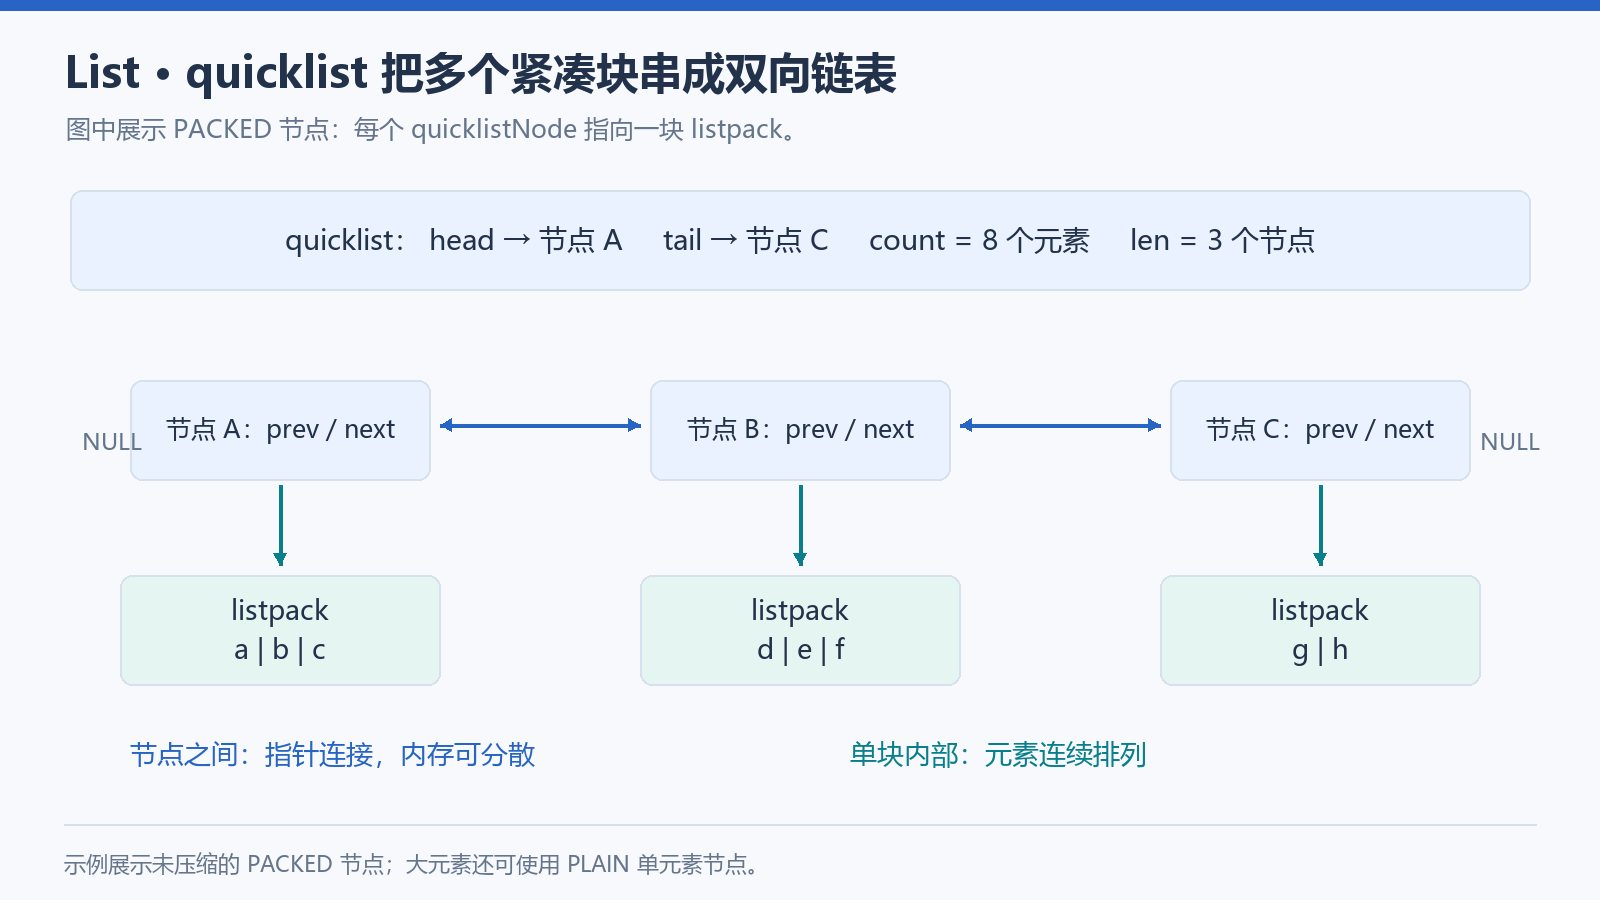
quicklist 的 count 统计元素总数,len 统计链表节点数;图中 3 个节点共保存 8 个元素。
它主要包含这些字段:
head/tail:指向头、尾节点,保证两端操作 O(1)。count:所有节点中元素的总数。len:quicklist节点的数量。fill:控制单个节点内紧凑列表的大小(由list-max-listpack-size配置)。compress:控制中间节点的压缩深度(由list-compress-depth配置),用于进一步节省内存。
每个链表节点 quicklistNode
则持有指向前后节点的指针,以及一个指向实际紧凑列表的指针(zl
),并记录了该列表的元素个数,是否被压缩等信息。
quicklistNode 里装的已经是
listpack。listpack
是一块连续的内存,里面按顺序紧挨着存放多个元素,没有指针开销,因此非常省内存。
它之所以取代 ziplist,ziplist
的每个节点记录了“前一个节点的长度”(prevlen),当前一个节点变长时,它的
prevlen
字段会膨胀,进而导致下一个节点也变长,触发连锁反应,引发大量内存重分配。
listpack中,每个节点只记录自己的总长度,并且放在节点尾部。这样任何一个节点的长度变化,只影响它自己
listpack 中每个 entry 的结构大致是:
1 | [ encoding | data | backlen ] |
encoding:标识数据类型(整数/字符串)和长度。data:实际数据。backlen:当前 entry 自身总长度,放在尾部,用于从后向前遍历。
整个 listpack
的头部还有总字节数、元素个数等元信息,结尾有一个 0xFF
结束标记。
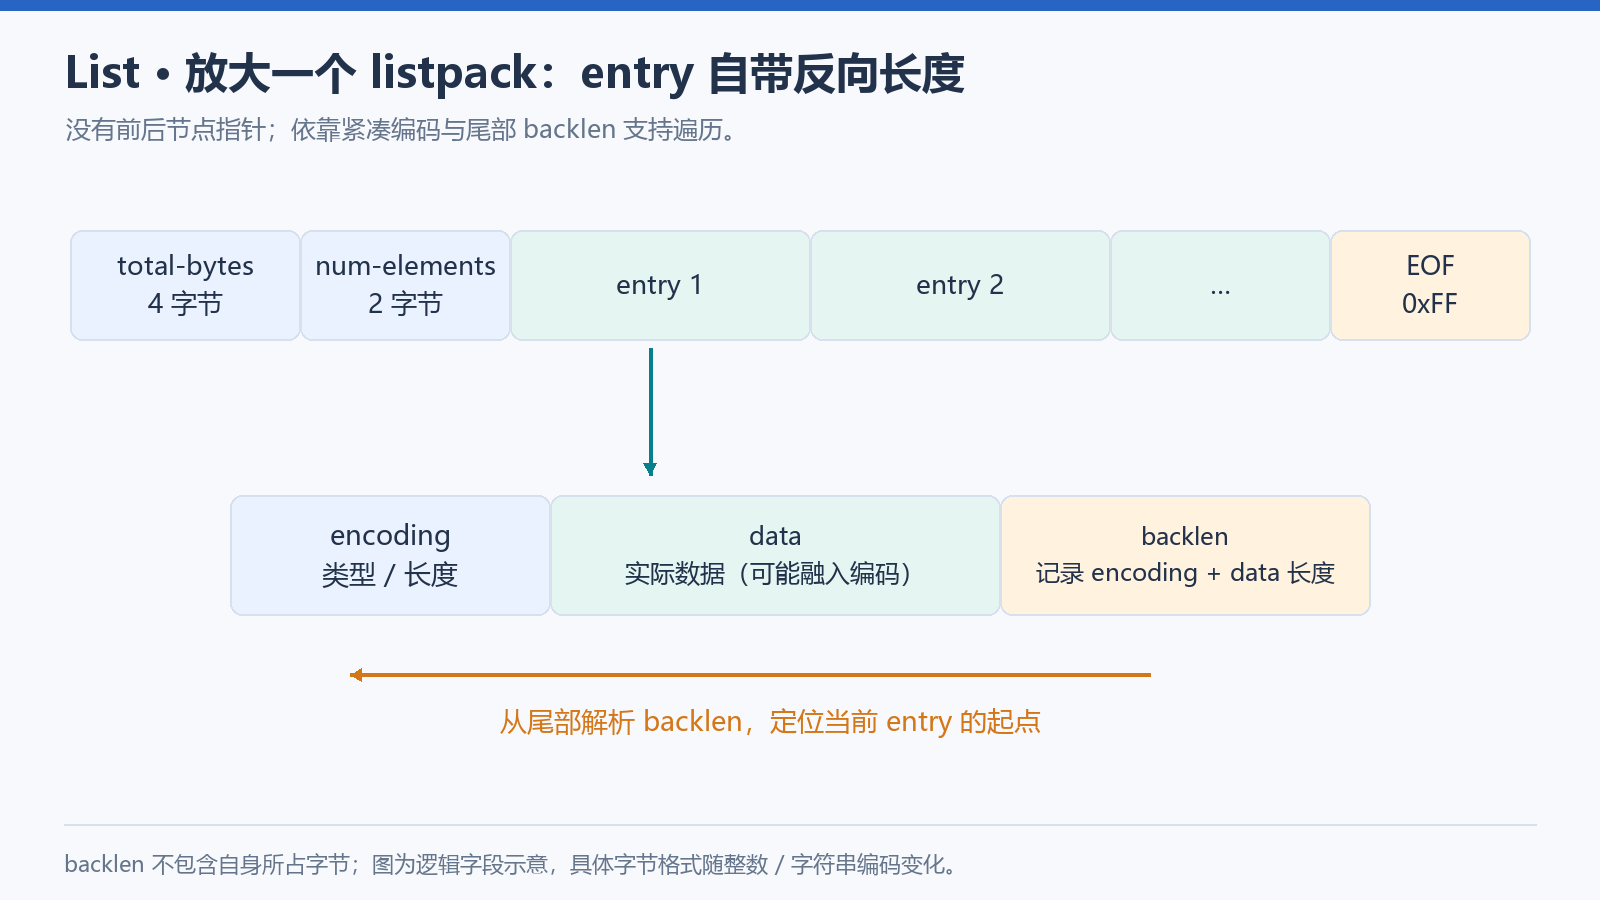
放大 listpack entry:严格来说,backlen 保存 encoding 与 data 的字节长度,不包含 backlen 自身;反向遍历据此定位 entry 起点。
配置项list-max-listpack-size 决定了单个
quicklist 节点里能装多少东西
- 负数(按字节数限制):表示单个节点内 listpack
的最大字节数。官方推荐
-2(8 KB)或-1(4 KB),此时性能表现通常最好。 - 正数(按元素个数限制):表示单个节点内最多能存多少个元素。
集合 Set
Set 是 Redis
中无序、成员唯一的字符串集合。逻辑上每个成员都是字符串,但底层为了省内存可能把成员存成整数或紧凑的字节序列,具体由
redisObject.encoding 决定。
Redis 7.2 之前,Set 只有 intset 和
hashtable 两种编码,7.2
一节多出两条新配置项:set-max-listpack-entries 默认
128,set-max-listpack-value 默认 64;也就是说从 7.2
起,小规模的非整数集合有了第三种编码 listpack。
初始编码不是等元素变多才决定的,而是在创建 key 时按第一批成员先猜一个:
1 | robj *setTypeCreate(sds value, size_t size_hint) { |
第一,size_hint 是本次 SADD
携带的成员数,一次性塞入大量成员会直接跳过紧凑编码。第二,首个成员能否转成整数影响初始方向:整数值先建
intset,非整数先建
listpack。之后成员类型和规模再变化,才按后面的规则做单向转换。
intset
intset 是专门为全整数集合设计的连续内存结构:
1 | typedef struct intset { |
头部固定 8 字节,contents 不保存类型,元素宽度完全由
encoding 决定。三个编码常量在源码里就是
sizeof:
1 | /* 每个元素占用的字节数,取值 2 4 8 */ |
intset 最重要的约束是 contents
必须按值升序且不重复。所有查找都走 intsetSearch
的二分,先和首尾比较,落在中间就折半,复杂度
O(logN),找不到时同时把可插入位置写回
pos。插入和删除靠 intsetMoveTail 做
memmove,所以是 O(N)。也就是说
intset 查找便宜、修改偏贵
升级机制是 intset
的核心。当新整数太大、原来的宽度装不下时,就把所有元素一起换成更宽的存储格式,并在搬运过程中保持升序。
因为触发升级,意味着新值已经超出了当前编码的整个取值范围。以当前使用
int16_t 为例:
- 新值为
40000:它大于32767,自然大于集合里所有旧元素,只能放最后。 - 新值为
-40000:它小于-32768,自然小于集合里所有旧元素,只能放最前。
所以升级时不需要二分查找,也不需要检查重复:旧集合里根本不可能存在这个超出范围的新值。
1 | static intset *intsetUpgradeAndAdd(intset *is, int64_t value) { |
关键是先改 encoding
并把数组扩到新宽度,然后从后往前搬,这样写入覆盖了旧位置,那个位置上的旧值也已经被读取、搬走了。另外,intsetResize
只是扩充内存空间,不会自动把每个旧整数转换成新宽度
intset 只有升级,没有降级。删除元素只做
zrealloc 缩容,不会改变
encoding。代价是曾经出现过的最大值会永久抬高整个集合的元素宽度。
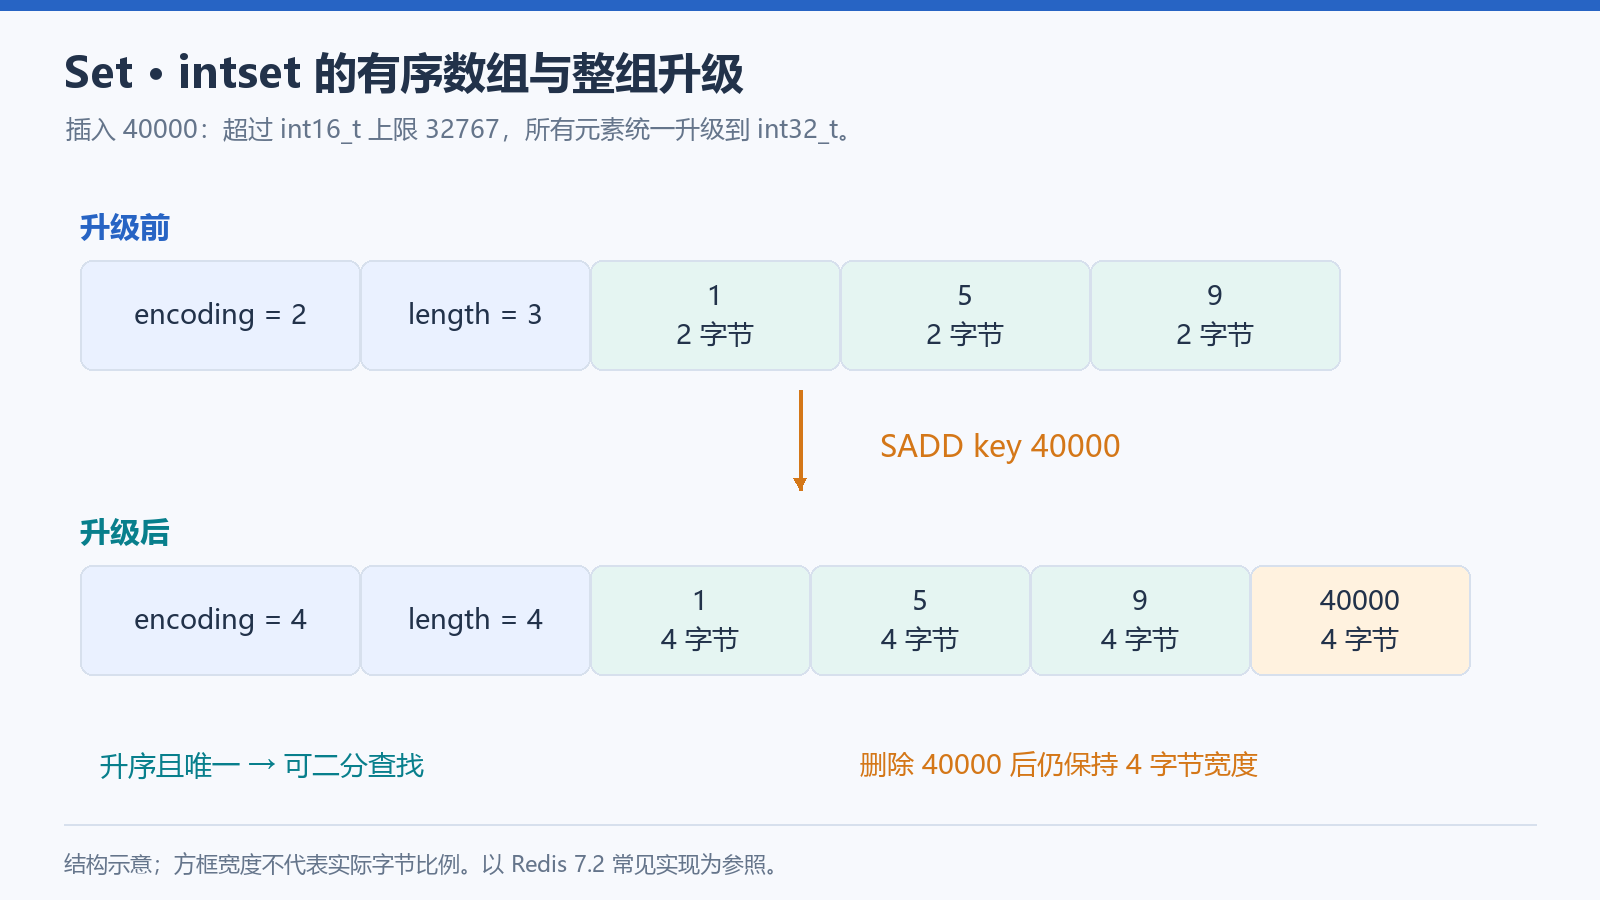
插入 40000 时,旧成员也统一扩成 4 字节,数组保持升序;删除大整数不会自动降级。
hashtable 编码的 Set
hashtable 编码的 Set 本质就是一张 value
为空的字典。转换时创建 setDictType 的 dict,把每个成员作为
key 插入,value 传 NULL:
1 | dict *d = dictCreate(&setDictType); |
因此集合成员的去重完全复用字典的 key 去重。没错和 HashSet 的底层数据结构是 HashMap 一样。。。
所以说,Set 和 Hash 在底层是同一个家族。hashtable 编码的
Hash 是 field 到 value 的字典,hashtable 编码的 Set 是
member 到 NULL 的字典,可以把 Set 看成 value 恒为空的
Hash。listpack 编码的差别在布局:Set 里每个 entry
就是一个成员,Hash 里 field 和 value 两个 entry
交替出现,所以同样字节数下 Set 能装的成员更多。intset 是
Set 独有的优化,Hash 没有纯整数编码。
两者的阈值独立配置:Hash 是
hash-max-listpack-entries 512 和
hash-max-listpack-value 64,Set 是
set-max-intset-entries 512、set-max-listpack-entries 128、set-max-listpack-value 64。也就是说
Set 的 listpack 门槛比 Hash 更低,非整数 Set 超过 128
个成员就进入 hashtable。
三种编码的对比
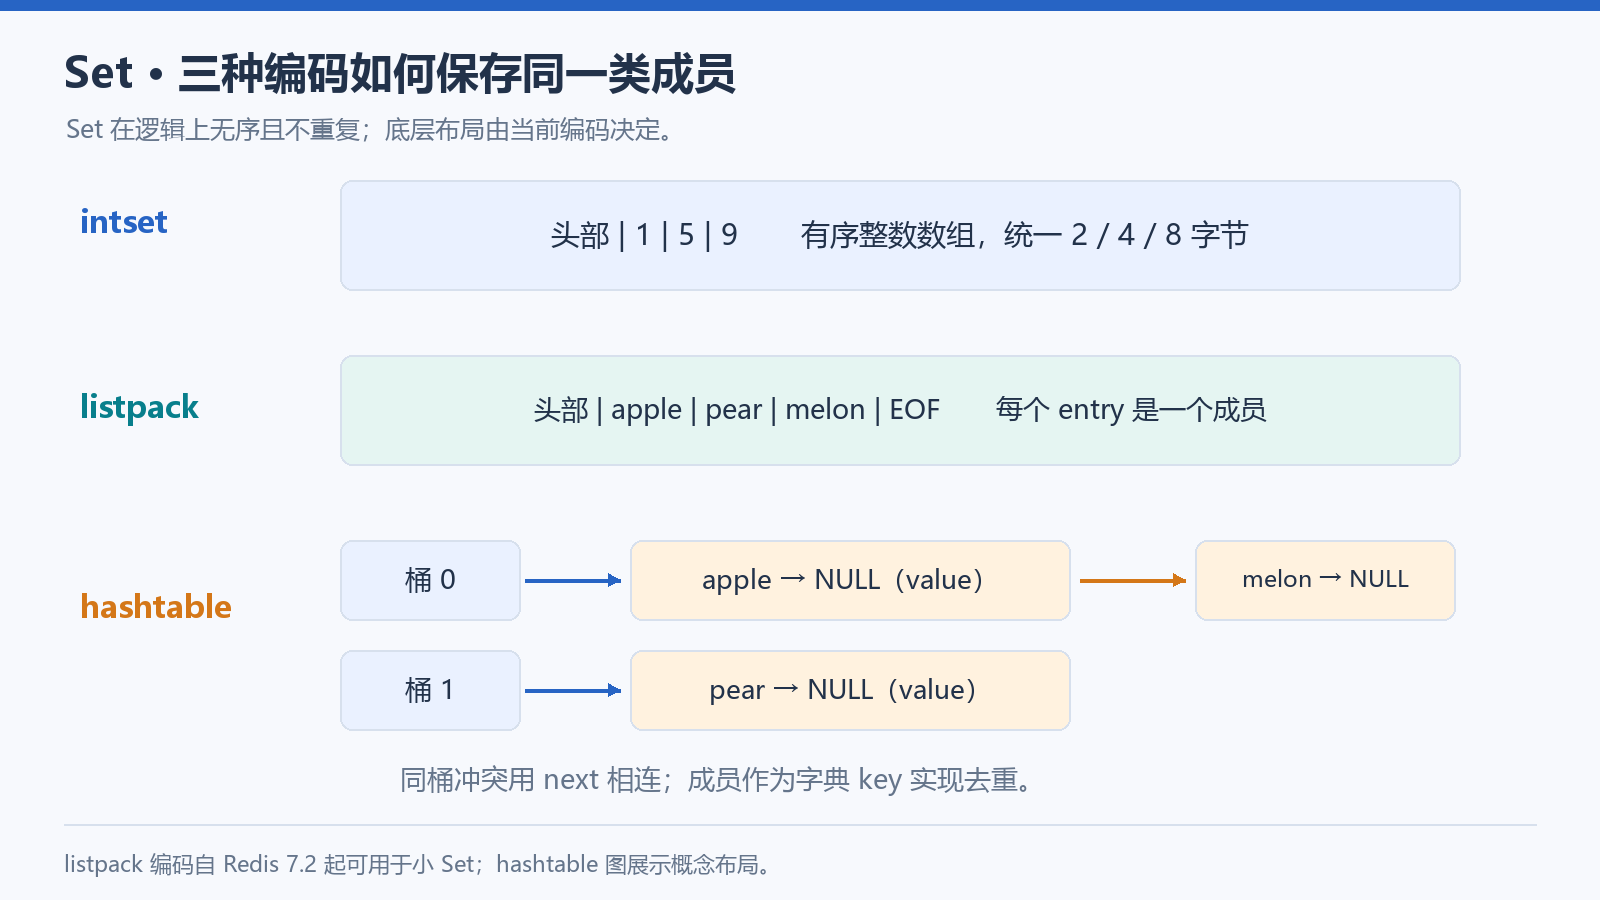
三种布局分别是有序整数数组、紧凑成员序列和成员到 NULL 的字典;物理布局不改变 Set 在逻辑上的无序语义。
| 维度 | intset | listpack | hashtable |
|---|---|---|---|
| 底层结构 | 有序整数数组 | 连续字节块 | value 为 NULL 的 dict |
| 成员类型 | 仅 64 位有符号整数 | 任意字符串或整数 | 任意字符串 |
| 是否有序 | 是,按值升序 | 否,按追加顺序 | 否,按桶顺序 |
| SISMEMBER | O(logN) 二分 | O(N) 线性扫描 | O(1) 平均 |
| SADD 与 SREM | O(N) 搬移 | O(N) 搬移 | O(1) 平均 |
| 内存开销 | 8 字节头加 N 乘 2 或 4 或 8 字节 | 每成员数据加编码字节加 1 到 5 字节 backlen | 每成员约 24 字节 dictEntry 加桶数组加 sds |
| 进入条件 | 全整数且不超过 512 个 | 非整数且不超过 128 个、单成员不超过 64 字节 | 超过前两者阈值 |
| 典型场景 | 数字 ID 去重、标签集合 | 小规模短字符串集合 | 大规模读写、成员长度不一 |
有序集合 ZSet
有序集合 ZSet 在 Redis 中的存在
有序集合,正如其名它是一个可以保证有序且元素唯一的集合,所以它经常用于排行榜等需要进行统计排列的场景。
它是一个可排序的 set 集合,在 Set 的基础上增加了一个权重参数 score,使得集合中的元素能够按 score 进行有序排列。
- 可排序。根据score值排序,如果多个元素score相同 则会按照字典进行排序
- 元素不重复,member必须唯一。注意:集合成员是唯一的,但评分可以重复
- 查询速度快,还可以根据member查询分数
Redis 是内存数据库,内存资源很宝贵。而跳表是一种很复杂的数据结构。如果不管数据多少,都用复杂的结构,小数据量时会浪费大量内存;但如果只用简单的结构,数据量一大,性能又会严重下降。
因此,ZSet 被设计成两种结构。
- 小数据量时的
listpack(Redis 7.0 之前是ziplist) - 大数据量后的
skiplist
必须同时满足两个条件,ZSet 才会用紧凑列表编码存储:
- 元素个数不超过 128 个(由
zset-max-listpack-entries控制,Redis 7.0 之前叫zset-max-ziplist-entries)。 - 每个元素的成员长度不超过 64 字节(由
zset-max-listpack-value控制,Redis 7.0 之前叫zset-max-ziplist-value)。
它像一块连续的内存,把每个元素的成员和分值挨个紧挨着存放。因为不用维护复杂的指针,所以在数据少时非常节省内存。
它的查找是线性的(O(N)),插入或删除元素可能需要挪动后面的数据。但在元素很少时,这点开销几乎可以忽略不计。
所以说,只要元素数量超过 128,或者任意一个元素的长度超过 64 字节,就会触发转换。
skiplist 编码的 ZSet
其实是一个组合结构,同时包含跳表和字典。字典负责实现 O(1)
复杂度的单点查询,不用去遍历跳表。跳表负责维护顺序和范围查询。它通过给有序链表加
多层索引 来加速查找,使得按分数范围查找或按排名查询的平均时间复杂度降到
O(logN)
跳表在范围查询上更有优势。它的最底层本身就是一条完整的有序链表,找到起点后顺序往后读即可,对 CPU 缓存更友好;而平衡树做范围查询需要中序遍历,指针跳来跳去,效率相对较低。
ZSet 的 listpack 编码和 Set 的 listpack
实现基本一致,成员和分数交替存放,N 个元素对应 2N 个
entry。
跳表的数据结构
ZSet 与 Java 中的 TreeSet 有些类似,但底层数据结构却差别很大。ZSet 中的每一个元素都带有一个 score 属性,可以基于 score 属性对元素排序。
那么,针对于listpack和ziplist,前面都进行了详细的讲解。首先。ZSet
的listpack和ziplist实现和 Set
的是基本上一致的。
那么。跳表跳表,到底还是链表,跳表要解决什么问题,要从从有序链表说起
假设你有一个有序链表,按 score 从小到大排好:
1 | head → [1] → [3] → [5] → [7] → [9] → [11] → [13] → [15] → NULL |
查找一个值,只能从头挨个走,O(N)。插入,先找到位置 O(N),再改指针 O(1),总体 O(N)。范围查询:找到起点后顺序读,定位起点是 O(N)。
很明显,有序链表的问题是,它只有一条路,没有”捷径”。不管找什么,都得从头一步步走。跳表的思路是,在链表上面加几层索引,让查找能跳着走。
还是那条有序链表,我们抽一些节点出来,组成上一层:
1 | 第 2 层: head ─────────────────────────→ [9] ─────────→ NULL |
- 第 0 层是完整的有序链表,包含所有节点;
- 第 1 层是第 0 层的子集,只保留部分节点;
- 第 2 层又是第 1 层的子集。
每一层的节点都有一个 forward
指针指向本层下一个节点,还有一个 down
指针指向下一层的同一个节点(Redis 里不存
down,后面讲)。
那么查找 9 的过程就变成这样了:
- 从最高层(第 2 层)head 出发,
forward指向 9,比较:9 ≤ 9,命中。 - 如果找 11:第 2 层 head 的 forward 是 9,9 < 11,走到 9;9 的 forward 是 NULL,不能再走,下降到第 1 层。
- 第 1 层从 9 出发,forward 是 13,13 > 11,不能走,下降到第 0 层。
- 第 0 层从 9 出发,forward 是 11,命中。
每一层都跳过了一些节点,层数越高跳得越远。查找时能往右就往右,不能往右就下降,这样走的路程远小于从头到尾。这就是跳表名字的由来,用多层索引跳过大量节点。
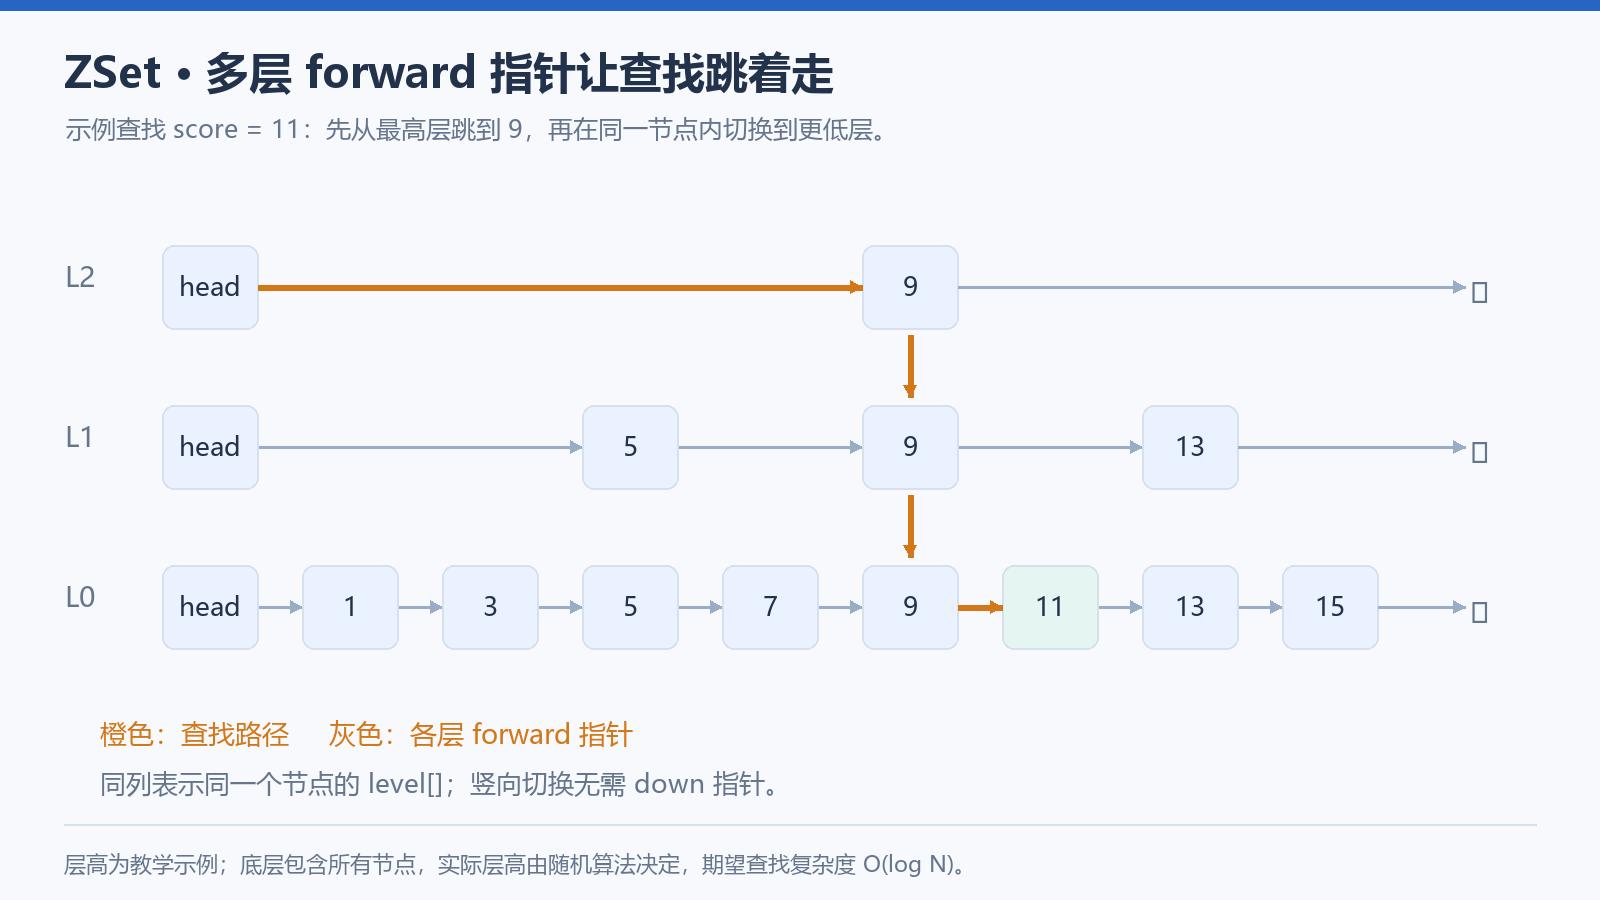
橙色箭头展示定位 11 的路径;竖向箭头表示访问同一节点更低层的 level[],并非额外的 down 指针。
那么,层高如何固定呢?如果每层都严格 每隔一个抽一个,那就是一棵平衡树,插入删除时要维护严格的层级关系,很复杂。跳表的选择是,每个节点的层高随机决定。
- 新插入一个节点时,先定它的层高,第 1 层一定有,然后以概率
p(Redis 取 1/4)继续往上加一层,直到失败或达到最大层数。 - 期望层高是
1/(1-p),Redis 的 p=1/4,所以平均层高约 1.33。
随机化保证了期望上每层节点数大约是下一层的 p
倍,形成类似”金字塔”的结构。查找的期望复杂度是 O(logN),最坏
O(N),那就是退化。这样,随机化在复杂度很不错的情况下,进行了最简单的实现,插入删除不需要旋转、变色、分裂合并,只改指针即可,实现极简。
跳表整体结构如下
1 | zskiplist |
- header 是哑节点,不存实际数据,固定 32
层,作为所有层查找的起点。它的
level[]数组长度固定 32,所以仅这个头节点就占24 + 32×16 = 536字节(64 位下)。 - tail 指向第 0 层最后一个节点,配合
backward支持从尾往头遍历。 - length 是节点总数,
ZREVRANK用它算反向排名。 - level 是当前实际最高层数,插入时如果新节点层高超过它,就更新它。
Redis中,一个跳表节点(zskiplistNode)包含:
| 字段 | 作用 |
|---|---|
ele(sds) |
成员字符串 |
score(double) |
分值,排序依据 |
backward(指针) |
指向前一个节点,只在第 0 层有,支持逆序 |
level[](数组) |
每一层的信息,每个元素含 forward(本层下一个节点)和
span(跨度) |
level[] 数组的长度就是这个节点的层高。比如层高 3
的节点,level[0]、level[1]、level[2]
分别对应它在第 0、1、2 层的 forward 和
span。forward
是本层的”下一个节点”指针。span是本层”下一个节点”离我有多远
span 它记录当前节点到本层下一个节点之间,跨过了多少个第
0 层节点。这是 Redis 跳表比教科书跳表多出来的字段,专门用来算排名。
举个具体例子,第 0 层顺序是 [1] [3] [5] [7] [9]:
- 节点
[1]在第 1 层的forward指向[5]; - 它的
span是 2,因为从[1]到[5]跨过了[3],走了 2 步(1→3→5)。
所以沿查找路径把每步的 span 加起来,就得到排名。
最后,backward 只在第 0
层有,每个节点只多一个指针,是逆序查询的支撑,逆序查询只需要第
0 层就够了,所以只在第零层有。
Redis 为什么选跳表:
| 维度 | 跳表 | 红黑树 |
|---|---|---|
| 实现复杂度 | 插入删除只改指针,zslInsert + zslDelete
一百多行 |
旋转、变色,复杂易错 |
| 范围查询 | 第 0 层就是完整有序链表,定位起点后顺序读,对 CPU 缓存友好 | 中序遍历,指针跳来跳去 |
| 排名支持 | span 天然支持 O(logN) 排名 |
要在每个节点维护子树大小,旋转时同步更新 |
| 内存可调 | 改 p 就能在时间/空间之间移动 |
节点结构固定 |
| 最坏情况 | 期望 O(logN),最坏 O(N),概率极低 | 最坏也保证 O(logN) |
B+ 树为什么不选,B+ 树为磁盘页设计,节点大、分裂合并复杂;Redis 纯内存,页式布局优势用不上,复杂度却是实打实的。
用概率上的最坏换实现上的简单,是Redis的一贯风格
在跳表中进行操作
查找是能右则右,不能右则下
以查找 score=11 为例
1 | 从 header 的最高层 level-1 开始: |
为什么这样能找到? 因为每一层都是有序的,往右走一定不会错过目标;不能往右说明目标在当前位置和 forward 之间,只能下降一层去更细的层找。
插入需要维护 update[] 和 span
update[i]:第 i 层中,插入位置的前一个节点rank[i]:从 header 出发,到update[i]为止,跨过的第 0 层节点数。update[i].span:update[i]到它本层下一个节点的跨度。
分三步:
假设第 0 层是这样的有序链表,header → (1) → (3) → (5) → (7) →
(9),现在要在 score=6 的位置插入新节点
x
查找插入位置,记录每层的前驱
用上面的查找逻辑走一遍,把每一层”最后一个小于目标”的节点记到
update[i]数组里。同时记录rank[i],就是从 header 到update[i]跨过的节点数。假设当前最高层是第 2 层,查找 score=6 的过程:
层 走到哪 update[i] rank[i] 第 2 层 header 的 forward 是 (5),5 < 6,走到 (5);(5) 的 forward 是 NULL,下降 (5)3 第 1 层 从 (5) 出发,forward 是 (7),7 > 6,不能走,下降 (5)3 第 0 层 从 (5) 出发,forward 是 (7),7 > 6,不能走 (5)3 所以:
update[0] = update[1] = update[2] = (5)rank[0] = rank[1] = rank[2] = 3(header→(1)→(3)→(5),跨过 3 个节点)
插入点在第 0 层就是
(5)和(7)之间,rank[0] = 3表示 x 插入后排名是 4。因为它前面有 3 个节点。随机定层高
假设随机出来 h = 2。
h ≤ level(2),不用开新层。逐层插入,调整 span
对每一层
i,从 0 到 h-1- 新节点
x的forward指向update[i].forward; update[i].forward指向x;- 逐层调整
rank[]
- 新节点
删除就是插入的对称操作。
改分是,能不动就不动,zslUpdateScore 的逻辑
- 先定位节点;
- 如果新分数仍然落在前驱和后继之间(位置不变),直接改
score; - 否则,删除旧节点,按新分数重新插入。重插时复用原来的
sds
所以说,span 的真正价值是做到了 O(logN)
排名。普通跳表没有 span,求排名只能从头遍历 O(N)
zslGetRank 沿查找路径把跨过的 span
累加:
1 | rank = 0 |
ZSet 同时维护字典和跳表
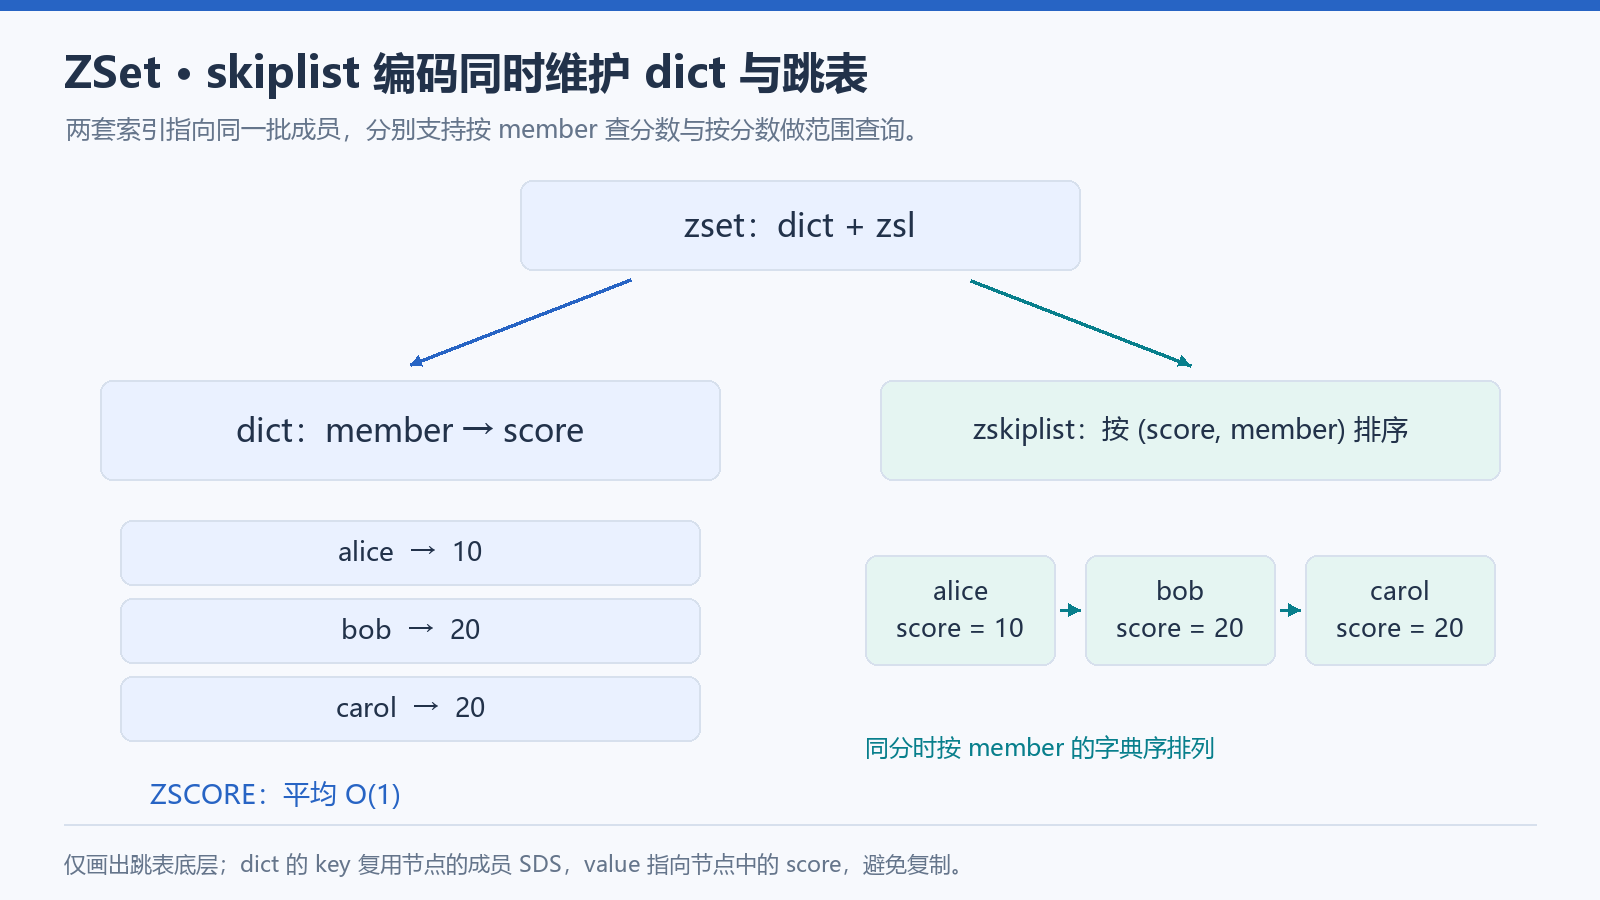
skiplist 编码包含 dict 和 zskiplist 两套索引:前者按 member 查 score,后者维护顺序,两者共享成员数据。
上面我们也发现,如果一直用跳表,那么 ZSet 虽然实现了 O(logN) 排名,但是排行榜也是出现了问题
| 结构 | 负责 | 复杂度 |
|---|---|---|
dict |
member → score 的点查;ZSCORE、ZADD 的
NX/XX 判断、ZINCRBY 存在性检查 |
平均 O(1) |
zskiplist |
按 score + ele
有序;ZRANGE、ZRANGEBYSCORE、ZRANK、ZREVRANGE |
O(logN) 定位 + O(M) 读取 |
为什么不能只用一个?
- 只用跳表:
ZSCORE从 O(1) 退化成 O(logN); - 只用字典:范围查询和排名没有可用的顺序结构。
两个结构共享同一份成员字符串,字典的 value 直接指向跳表节点的
score
字段。所以多出来的只是指针和节点开销,不是两份数据
所以说,删除顺序有讲究,先 dictUnlink 再删跳表节点。因为
sds 只在 zslFreeNode 里释放一次,字典的
dictType 不设置 key 释放函数,避免重复释放。
而上面说的,listpack 编码的 ZSet 是跳表的低成本替代,用于ZSet在很小的时候使用
特殊数据类型
位图 Bitmap
Bitmap 在 Redis
里并不是一个独立的数据类型,TYPE 返回的仍然是
string,OBJECT ENCODING 返回
raw。真正的存储就是 String 值里的一段 SDS
字节数组,所谓位图,只是把这串字节按位来使用。SETBIT、GETBIT、BITCOUNT、BITPOS、BITOP、BITFIELD
这些命令全部作用于 String 对象,没有新的 redisObject
类型,也没有新的编码。
这样设计的好处是 Bitmap 天然继承了 String 的过期时间、RDB 与 AOF 持久化、主从复制和 Cluster 按 key 分片,不必再为它单独实现一套对象生命周期。代价是位运算必须自己处理字符串长度、扩容和边界。
位序:offset 如何映射到字节内的一位
Bitmap 的 offset 从 0 开始,按字符串从左到右编号,第 0
位是第一个字节的最高位。源码里就两行换算:
1 | // setbitCommand 中的定位逻辑 |
由此可以推出几个直观结果:
- 同样置 1,
SETBIT k 0 1得到0x80,SETBIT k 1 1得到0x40,SETBIT k 7 1得到0x01,SETBIT k 8 1得到第二个字节的0x80; offset每增加 8,字节下标加 1,字节内的位置回到最高位,所以同一位图里相邻的整数 ID 是紧密排列的;- 反过来,一个 N 字节的字符串能表示 8N 个位,可用 offset 的上限是 8N 减 1。
BITFIELD 使用完全相同的约定。源码注释里的例子是:从
offset 等于 7 开始写入 5 位无符号数 23(二进制
10111),结果是第一个字节为
00000001、第二个字节为 01110000,即
0x01 0x70。当位段刚好按字节对齐时,这个顺序等价于大端序。
这个约定与很多语言里 BitSet 的 LSB-first 实现相反,跨语言读写前必须先统一位序。
offset 上限与单 key 的 512MB 内存上限
SETBIT 和 GETBIT 的 offset 不是任意大。7.2
源码的检查逻辑是:
1 | // getBitOffsetFromArgument:把 offset 限制在字符串最大长度内 |
判断的是字节下标,而不是位下标。proto-max-bulk-len
默认是 512mb,所以:
- 单 key 最多 512MB,即 536,870,912 字节,也就是 4,294,967,296 个 bit;
- offset 最大值为 4,294,967,295,即 2 的 32 次方减 1;
- offset 等于 4,294,967,296 时字节下标越界,直接报错。
版本方面,6.2 与 7.0 的这个表达式完全相同,7.0 只是在前面多了
mustObeyClient 例外:来自主库复制的命令和 AOF
载入不受该检查约束,保证从库能原样接收主库写入的大 offset。unstable
分支同样如此,所以 7.0 之后没有放开该上限。严格说上限随
proto-max-bulk-len 变化,不是写死的常量,但默认配置下就是
4GB 位。
这是 Bitmap 最容易被低估的成本:内存上限由 offset 决定,而不是由实际存了多少个 1 决定。一个孤立的 offset 就能把 key 撑到 512MB。
首次大 offset 的自动扩容与空洞补 0
首次对不存在的 key 执行 SETBIT,Redis
会直接分配够长的字符串;对已存在的
key,则先做写时复制检查,再扩容。关键两步在
lookupStringForBitCommand 里:
1 | // 新 key:按目标长度分配,sdsnewlen 传 NULL 会整串清零 |
sdsgrowzero 内部调用 sdsMakeRoomFor
申请空间,然后对新增区间 memset 为
0,所以首尾之间的空洞一定是 0,GETBIT 读到空洞也是
0。扩容沿用 SDS 的两条规则:
- 目标长度小于 1MB 时按 2 倍申请;
- 目标长度大于 1MB 时在目标长度上再加 1MB 预留。
也就是说,一个已有 key 被 SETBIT
撑到接近上限时,实际可能申请约
513MB,并且要在单线程里完成大块内存清零。这是典型的延迟毛刺来源,也会让
MEMORY USAGE 略大于 512MB。生产上应限制业务 offset
的范围,不要把不可信的用户输入直接当 offset。
基数统计 HyperLogLog
精确去重必须记住每一个出现过的元素,Set 的内存与基数成正比。1 亿个用户 ID 需要数 GB 内存,但如果业务问题只是今天有多少独立用户访问过,数 GB 换来的精确值就显得很浪费。这类统计允许千分之几的误差,用误差换固定内存,就是 HyperLogLog 的定位。
HLL 在 Redis 里同样不是独立类型:TYPE 返回
string,OBJECT ENCODING 返回
raw,PFADD、PFCOUNT、PFMERGE
只是把一段特殊格式的字节串当作 HLL 来操作。
概率原理
一次伯努利试验是反复抛硬币直到出现正面,记下抛掷次数 k。抛 k 次才首次出现正面的概率是 2 的负 k 次方,所以 k 越大越罕见;如果做了 n 次试验,观测到的最大 k 大约在 log2(n) 附近。反过来,看到最大 k,就能估计 n 约等于 2 的 k 次方。
HLL 用哈希代替抛硬币:元素哈希成 64 位随机数,从某个位置开始数连续 0 的个数再加 1,就得到一个 k。只用一个 k 估计 n,方差大得没法用,于是把哈希空间分成 m 个桶,每个桶只记录本桶出现过的最大 k,再对 m 个桶的值做调和平均:
- 桶的值越大,说明该桶见过越多次试验;
- 用 2 的负 M 次方做平均,天然抑制个别异常大的 k 把结果拉偏;
- 估计公式为 n 约等于
alpha乘 m 的平方,再除以各桶 2 的负 M 次方之和。
标准误差与桶数的平方根成反比,公式是 1.04 除以根号 m。Redis 取 m 等于 16384,即 2 的 14 次方,误差为 1.04 除以 128,约等于 0.008125,也就是 0.81%。m 每增大 4 倍,误差减半,内存也翻 4 倍,16384 是 12KB 内存与 0.81% 误差之间的折中。
小基数时大量桶还是 0,直接用上面的公式会偏低,需要按 0
桶比例做线性计数修正;大基数时寄存器接近饱和,需要另一套修正。Redis 5.0
起改用 Otmar Ertl 的改进估计器(论文 arXiv:1702.01284),源码里对应
hllSigma 和 hllTau 两个函数,最终形式是 E 等于
round(HLL_ALPHA_INF 乘 m 的平方除以 z),其中
HLL_ALPHA_INF 等于 0.5 除以 ln2,约等于
0.7213475204444817。4.x 版本用的还是最初的 Flajolet 公式,这是不同 Redis
版本结果会有细微差异的原因之一。
需要强调:0.81% 是标准误差,不是误差上界。单次结果大约 95% 落在正负 1.6% 以内,99% 落在正负 2.1% 以内;基数越大,绝对误差越大。
Redis 的存储形态
HLL 的值由 16 字节头部加寄存器数组组成,头部结构如下:
1 | struct hllhdr { |
card 缓存最近一次算出的基数,最高位为 1
表示缓存已失效。寄存器数组有两种编码:
- dense:每个寄存器 6 bit,16384 个寄存器共 98,304 bit,即 12,288 字节,加上 16 字节头部是 12,304 字节,通常笼统说 12KB;
- sparse:用行程编码只记录非零寄存器,适合基数很小的场景。
dense 的 6 bit 寄存器从第一个字节的最低位开始紧挨着排,允许跨字节。第 0 个寄存器占第一个字节的低 6 位;第 1 个寄存器占第一个字节的高 2 位加第二个字节的低 4 位,以此类推。读取一个寄存器等价于:
1 | // 设第 regnum 个寄存器在比特流中的起点是 regnum 乘以 6(伪代码) |
6 bit 能表示 0 到 63,但哈希只提供 50 位用来数零,所以寄存器实际最大是 51。
sparse 用三种 opcode 做行程编码:
| opcode | 位模式 | 字节数 | 编码内容 |
|---|---|---|---|
ZERO |
00xxxxxx |
1 | 连续 1 到 64 个值为 0 的寄存器,长度等于 6 位值加 1 |
XZERO |
01xxxxxx yyyyyyyy |
2 | 连续 1 到 16384 个值为 0 的寄存器,长度等于 14 位值加 1 |
VAL |
1vvvvvxx |
1 | 寄存器值 1 到 32,连续重复 1 到 4 次 |
一个空 HLL 就是 16 字节头加一个覆盖全部 16384 个寄存器的
XZERO,共 18 字节。源码注释里给了一组平均值:基数 100 时约
267 字节,基数 1000 时约 1882 字节,基数 2000 时约 3480 字节,并注明
dense 的 12304 字节要到基数大约 2000 到 3000 之后才更划算。默认的 3000
字节阈值对应的正是这个拐点,超过之后 sparse
多花的解析时间已经不值得它省下的那点内存。
sparse 的代价是更新和读取都要顺序解析 opcode,比 dense
慢,所以只在小基数时保留。转换阈值由配置项
hll-sparse-max-bytes 控制,默认 3000
字节。触发转换有两个条件:
- 某个寄存器需要被设置成大于 32 的值,
VAL编码装不下; - 更新后字符串长度超过
hll-sparse-max-bytes。
转换由 hllSparseToDense 一次性完成,重写成 12304 字节的
dense 表示,之后不可逆。源码注释说得很直接:基数大约到 2000 到 3000
之后,sparse 多花的时间已经不值得它省下的那点内存。
HyperLogLog 的使用
- 不能删除单个元素,没有
PFREMOVE,只能重建; - 不能判断某个元素是否存在,
PFADD的返回值不是存在性判断; - 不能取回或枚举元素,只能得到基数;
- 不能求交、差、对称差的精确结果,多 key 只能求并集基数;
- 不能把 HLL 当普通字符串局部修改。用
GET与SET整体搬迁是允许的,但用APPEND、SETRANGE或位命令去改会破坏结构,后续PFADD、PFCOUNT会报INVALIDOBJ或WRONGTYPE类错误; - 多 key 的
PFCOUNT在 Cluster 下要求所有 key 落在同一个 slot,通常靠 hash tag 保证。
应用场景与工程注意事项
- UV 统计:按天、渠道、版本各建一个 HLL,需要周、月数据时用
PFMERGE合并,避免从原始数据重算; - 内存要按 key 数量规划:每个 dense HLL 约 12KB,100 万个 key 就是 12GB 量级;小基数 key 用 sparse 能显著省内存;
- 高频
PFADD的 key,card缓存会频繁失效,单 keyPFCOUNT会退化成每次扫 16384 个寄存器,必要时把结果缓存在业务侧;
地理空间 GEO
GEO 底层用的其实就是 Zset,根据经纬度编码后的值作为 Zset 元素的 score
GEO 涉及到 将二维的经纬度转成一维的 geohash 编码 这样的一个过程
Redis 采用了业界广泛使用的 GeoHash 编码方法,这个方法的基本原理就是“二分区间,区间编码”。
通过将经度和纬度分别放在奇数位和偶数位,可以使得 geohash 编码前缀越接近的点,在地理空间上也越接近;但反过来不严格成立,Z-order 曲线在格子边界处会跳变,所以范围查询要查中心格加邻域格,不能只查一个前缀。
前面四段讲的是结论,这里往源码层再拆一层。GEOADD
拆开看就是一次 ZADD:member
是地点名,score 是经纬度编码出的 52
位整数。TYPE 返回的永远是 zset,删除地点用
ZREM,官方文档也明确说没有 GEODEL 命令;GEO
不是新类型,只是 ZSet 上的一层封装。
GEO 只是 ZSet 上的一层封装
geoaddCommand解析完经纬度后调用geohashEncodeWGS84,再用geohashAlign52Bits左移成 52 位整数,最后把参数重写成带NX、XX、CH选项的ZADD交给zaddCommand。- 走
ZADD让 GEO 免费获得 zset 的排序、范围查询、持久化、复制、Cluster 按 key 分片和过期能力。 - 代价是约束只在命令层:
ZADD能写任意 score 破坏 geohash 不变量,ZRANGEBYSCORE也能把 geohash 当普通分数查。
1 | /* geo.c: GEOADD 最终转成 ZADD */ |
经纬度各取 26 位
- 经度范围是 -180 到 180,纬度范围是 -85.05112878 到
85.05112878,定义在
geohash.h的GEO_LONG_MIN、GEO_LONG_MAX、GEO_LAT_MIN、GEO_LAT_MAX,注释说明这组限制来自 EPSG:900913、EPSG:3785、OSGEO:41001。 - 纬度不取正负 90 度,是 Web Mercator 投影的结果。Mercator 的 y 坐标与
ln(tan(π/4 + φ/2)) 成正比,纬度越接近 90 度,y
越快趋向无穷;投影成正方形时 y 正好在 85.05112878 度处与 x
的最大值对齐。Redis
沿用这组边界,所以极点附近无法索引,
GEOADD会直接报错。 - 两个方向各取 26 位,
geohash.h里GEO_STEP_MAX定义为 26,注释写明 26 的两倍等于 52 位;2 的 26 次方是 67108864,两个方向都被切成这么多个格子。 - 取 52 位而不是 64 位,是为了让 score 能被 double 精确表示。IEEE 754 双精度有 52 位显式尾数,加上隐含的最高位 1,可以精确表示小于 2 的 53 次方的整数;52 位整数在这个范围内,写成 double 不会有舍入,所以 zset 按 score 排序严格等价于按 geohash 整数排序。
交错成 52 位
- 编码分三步:经纬度各自归一化到 0 到 1,乘以 2 的 26 次方取整,得到两个 26 位整数,最后交错成一个 52 位整数。
interleave64的注释说明 x 的位放在偶数位、y 的位放在奇数位,而geohashEncode的调用是interleave64(lat_offset, long_offset),所以纬度在偶数位、经度在奇数位。- 这种编码叫 Z-order 曲线,也叫 Morton 码。每多读两位(一位纬度、一位经度),地图就被四等分一次,等价于四叉树下一层;前缀 2k 位就是第 k 层的一个格子。
- 为什么不是简单拼接:把经度放高 26 位、纬度放低 26 位,纬度在排序里几乎不起作用,同一个纬度带会被拆成大量不连续区间;交错让两个坐标同时参与每一层细分,查询框只需要少数几个连续区间。
- 前缀相邻不等于空间严格相邻,这一点决定了查询方式:不能只查中心前缀,必须把中心格和邻格一起取出来再逐个算真实距离,后面 GEOSEARCH 的 9 格邻域就是为此设计的。
1 | /* geohash.c: 归一化后按位交错 */ |
0.6 米精度的来历
- 赤道周长约 40075 千米,经度方向被 2 的 26 次方等分,每格宽度约为 40075000 除以 67108864,也就是 0.597 米。常说的 GEO 最小精度约 0.5 到 0.6 米,指的就是这个最长边。
- 纬度方向范围只有约 170.1 度,同样被 2 的 26 次方等分,格子高度约 0.28 米,所以格子在地表是一个扁矩形。
GEOPOS返回的不是原始坐标,而是把 score 反解成格子边界后取中心点,同一格子里的多个点会得到完全相同的坐标,误差量级是格子尺寸的一半。精度无法再往上提:52 位已经是 double 精确表示整数能力的上限附近,Redis 也没有更高精度的选项。
精度边界与限制
- 只支持 WGS-84 经纬度,距离用球面 Haversine 计算,官方文档说最坏误差约 0.5%;纬度被限制在正负 85.05112878 度以内,极点附近无法写入。
- 同一格子内的点无法区分,
GEOPOS会返回格子中心;需要厘米级定位不能用 GEO。 - 范围查询必须查邻域格子,只查中心前缀会漏点;半径很小时只查中心一个格子则是正确且高效的行为。
- 可以用
ZADD绕过命令层写坏 score,也可以用ZREM删除地点,数据完整性完全依赖命令层。
复用了 ZSet 的设计取舍
- 范围查询天然匹配:按区域找点就是按 score 区间取一段连续元素,skiplist 支持先定位再顺序遍历;距离排序只能在候选集取回后于内存里做,但定位阶段已经把候选集缩到很小。
- 内存和工程成本都可接受:没有额外的空间索引,每个成员就是 zset 的一个元素,小集合用 listpack,大集合用 skiplist 加 dict;持久化、复制、Cluster 分片、过期等 key 级能力全部自动继承。
- 局限也明确:整张索引是一个 key,Cluster 里只能落在一个 slot,超大索引无法水平拆分;也不支持多边形、轨迹、路网等复杂查询。
Pub/Sub
发布订阅是 Redis 里最轻的通信方式:发布者只知道频道名,订阅者只表达对频道或模式串的兴趣,两边不需要互相知道对方。它极简、极快、天然支持一对多广播;代价是消息不落地、不确认、不重投,官方文档把它定义为 at-most-once 投递。
三种订阅方式
SUBSCRIBE channel [channel ...]:精确订阅一个或多个频道,配套UNSUBSCRIBE。PSUBSCRIBE pattern [pattern ...]:按 glob 模式订阅,配套PUNSUBSCRIBE。SSUBSCRIBE shardchannel [shardchannel ...]:分片频道订阅,7.0 起支持,配套SPUBLISH和SUNSUBSCRIBE。
| 方式 | 命令 | 匹配方式 | 路由 | 起始版本 |
|---|---|---|---|---|
| 频道 | SUBSCRIBE |
精确匹配 | 全节点广播 | 2.0 |
| 模式 | PSUBSCRIBE |
glob 通配 | 全节点广播 | 2.0 |
| 分片频道 | SSUBSCRIBE |
精确匹配 | 按 slot 保留在分片内 | 7.0 |
- Pub/Sub 与数据库无关,db 10 上发布的消息,db 1 上的订阅者也能收到。
- RESP2
下客户端进入订阅状态后只能执行少数命令,比如订阅、退订、
PING、QUIT、RESET;RESP3 则允许在订阅状态下执行任意命令。 - 一个客户端同时订阅频道和模式时可能收到重复消息:命中频道收一条
message,命中模式再收一条pmessage。
服务端与客户端结构
服务端有两张核心字典,7.0 之后又多了第三张,键都是频道名或模式串,值都是订阅该键的客户端链表。
1 | /* server.h: 服务器级 Pub/Sub 字段 */ |
模式串的存储结构改过几次,按版本拆开看:
| 版本 | 服务端 pubsub_patterns |
客户端 pubsub_patterns |
|---|---|---|
| 6.0 之前 | pubsubPattern 链表 |
链表 |
| 6.0 | 旧链表保留,另加 pubsub_patterns_dict 字典 |
链表 |
| 6.2 | 删除旧链表,pubsub_patterns 变为字典 |
链表 |
| 7.0 | 字典,新增 pubsubshard_channels |
链表 |
| 7.2 | 字典 | 改为字典 |
- 6.0
引入字典是为了发布时不必遍历链表逐条比对,而是按模式串直接聚合客户端,旧链表在
6.0 还保留,6.2 才删除;客户端侧的链表到 7.2 才改成字典,7.0 及以前仍用
listSearchKey和listAddNodeTail维护。 - 7.x 用
pubsubtype把普通频道和分片频道统一成一套代码,shard区分两者;客户端用CLIENT_PUBSUB标志表示订阅状态,订阅计数 7.0 起把分片频道单独计算。
订阅与退订时两张表怎么维护
- 订阅频道:先在客户端字典
dictAdd频道,成功说明之前没订阅过;再在服务端字典里找频道,没有就新建客户端链表挂上去,最后把客户端追加到链表尾部,整体 O(1) 均摊。 - 退订频道:从客户端字典删除,再从服务端链表里摘掉该客户端;链表空了就把整个频道从服务端字典删掉,避免长期积累空频道。
- 模式订阅流程相同,只是服务端字典的键是模式串;分片频道在 Cluster
下还多一层
slotToChannel映射,订阅时登记到对应 slot,最后一个订阅者退订时移除。
PUBLISH 的执行流程
- 先查
server.pubsub_channels,命中频道后拿到客户端链表,逐个把消息写进输出缓冲区,字典 O(1) 查找加 O(N) 投递,N 是订阅该频道的客户端数。 - 再遍历
server.pubsub_patterns的所有模式串,用 glob 匹配频道名,命中就把pmessage投给该模式下的所有客户端。这一步是 O(P),P 是所有客户端订阅的模式总数,与频道订阅数无关,所以模式订阅越多,每次发布越慢。 - 总复杂度 O(N + M),N 是订阅该频道的客户端数,M 是所有客户端订阅的模式总数。单机返回的接收者计数是收到消息的客户端数;Cluster 里只统计发布节点本地的客户端数。
- 分片频道走另一条路径:
pubsubPublishMessage的 sharded 参数为真时只查pubsubshard_channels,投递完直接返回,跳过全部模式匹配。 - 投递写的是输出缓冲区,不是直接写
socket。客户端读得慢时缓冲区会涨,超过
client-output-buffer-limit pubsub的默认硬上限 32 MB,或者在 8 MB 软上限上持续 60 秒,连接就会被断开,消息直接丢失。
可靠性与集群行为
- Pub/Sub 是 fire and forget:消息发出后不保存、不重发,客户端断线、处理失败、网络抖动都会永久丢失,没有 ack、消费组和堆积;慢消费者还会被输出缓冲区断开,需要可靠投递时只能用 Stream 或业务层补偿。
- 普通 Pub/Sub 在 Cluster 里是全节点广播:客户端可以连任意节点订阅,也可以向任意节点发布,集群总线会把消息转发给所有节点,消息量随节点数放大。
- 7.0 的分片频道按频道名做 CRC16 取模 16384 定位 slot,订阅和发布都要发到该 slot 所属的分片,客户端可以连主节点或其从节点订阅,消息只在分片的主从之间传播。
- keyspace notification 也走 Pub/Sub:
notifyKeyspaceEvent会向两个特殊频道发布消息,频道名分别是__keyspace@<db>__:<key>和__keyevent@<db>__:<event>,最后都调用pubsubPublishMessage;notify-keyspace-events默认为空即关闭,开启后同样不持久化、无确认。
Pub/Sub 与 Stream 的对比
| 维度 | Pub/Sub | Stream |
|---|---|---|
| 持久化 | 无 | RDB/AOF,可长期保留 |
| 投递语义 | at-most-once | 可 at-most-once 或 at-least-once |
| 消费组 | 无 | 有,streamCG |
| 确认机制 | 无 | XACK,PEL 记录未确认消息 |
| 堆积 | 不堆积,慢客户端丢消息 | 可堆积,XTRIM 控制上限 |
| 历史回溯 | 不能 | XRANGE 按 ID 或时间回溯 |
| 阻塞读 | SUBSCRIBE 常驻 |
XREAD BLOCK |
| 多消费者 | 广播,每个订阅者一份 | 无组广播,有组组内分摊 |
| 集群 | 全节点广播,分片频道按 slot | 单 key 单节点,业务自己分片 |
| 适用场景 | 通知、广播、在线状态 | 队列、事件溯源、轻量流 |
流Streams
Stream 是 Redis 5.0 引入的追加日志型结构,官方文档称之为 append-only log,同时支持范围查询和消费组。
Stream、Pub/Sub、Kafka 对比
| 维度 | Pub/Sub | Stream | Kafka |
|---|---|---|---|
| 存储 | 无 | 内存为主,RDB/AOF | 磁盘日志 |
| 投递语义 | at-most-once | 可 at-most-once 或 at-least-once | 至少一次 |
| 消费组 | 无 | 有 | 有 |
| 回溯 | 无 | 按 ID 或时间 | 按 offset |
| 堆积 | 不堆积 | 受内存限制 | 磁盘容量大 |
| 分区 | 广播或按 slot | 单 key 单节点 | 多分区 |
| 延迟 | 极低 | 低 | 中等 |
| 运维成本 | 低 | 低 | 高 |
| 典型场景 | 通知、广播 | 队列、事件溯源、轻量流 | 大数据管道 |
底层编码总览
把前面各节的内容压缩成一张表,方便横向对比。
| 类型 | Redis 7.2 起的编码 | 底层结构 | 默认阈值 | 关键复杂度 |
|---|---|---|---|---|
| String | int、embstr、raw |
整数直接存在指针里;短字符串和 redisObject 共用一次分配;长字符串用独立 SDS | 整数要求能用 long 表示且不超过 20 字符,embstr 不超过 44 字节 | 读取 O(1),追加均摊 O(1) |
| Hash | listpack、listpackex(7.4
起)、hashtable |
连续内存里 field 和 value 交替排列,或 value 为 NULL 的 dict | 512 个 field,单值 64 字节 | listpack 查找 O(N),hashtable O(1) |
| List | quicklist |
双向链表,每个节点挂一个 listpack | 单节点大小由 list-max-listpack-size 控制 |
两端插入删除 O(1),按下标访问 O(N) |
| Set | intset、listpack、hashtable |
有序整数数组、连续内存、value 为 NULL 的 dict | intset 512 个,listpack 128 个且单成员 64 字节 | intset O(logN),listpack O(N),hashtable O(1) |
| ZSet | listpack、skiplist |
连续内存里 member 和 score 交替,或 dict 加跳表 | 128 个元素,成员 64 字节 | listpack O(N),skiplist O(logN) |
| Bitmap | 无独立编码,就是 String 的 raw |
SDS 字节数组按位使用 | offset 上限 2 的 32 次方减 1,单 key 最大 512MB | SETBIT 与 GETBIT O(1),BITCOUNT O(N) |
| HyperLogLog | 无独立编码,就是 String 的 raw |
16 字节 hllhdr 加 16384 个 6 bit 寄存器 | dense 固定 12304 字节,sparse 超过 3000 字节转 dense | PFADD O(1),PFCOUNT 单 key 约 O(16384) |
| GEO | 就是 ZSet | member 是地点名,score 是 52 位 geohash 整数 | 复用 zset 的阈值 | GEOADD O(logN),GEOSEARCH O(N + logM) |
| Stream | rax 加 listpack | 16 字节大端 ID 为键的基数树,节点里是打包的消息 | 单节点 4096 字节或 100 条 | XADD O(1),XRANGE O(logN + M) |
- 所有节省内存的编码都有一个共同前提,元素数量少且单个元素小。紧凑结构靠遍历换空间,一旦数据量上来,遍历成本就会压过节省下来的内存,所以编码一定会向哈希表或跳表迁移。
- 编码转换是单向的。listpack 转 hashtable、intset 转 hashtable、listpack 转 skiplist,转过去之后都不会自动转回来,只有整体重建的命令才有可能重新选择紧凑编码,比如 ZUNIONSTORE 生成的新结果集就允许再转回 listpack。
- 阈值全部是配置项,可以按业务数据特征调整,但调大之后单次转换的耗时和延迟尖刺会同步变大,需要在内存和稳定性之间做取舍。
- 特殊类型里,Bitmap 和 HyperLogLog 都没有自己的 type 和 encoding,它们只是把 String 当作字节容器,GEO 则完全寄生在 ZSet 上。所谓高级数据类型,多数是命令层对基础结构的封装,理解这一点,比记住每个命令的语义更重要。