前言
单机部署时,给一个查询接口加上 Redis 就够用了:查不到就读库,读完写回缓存,更新时删掉缓存。同样的代码拆成多个实例之后,事情开始变形,本地锁挡不住另一个进程,删掉的缓存可能被一个更早发出的读请求写回来,Redis 一旦变慢又会把压力成倍转给数据库。
这篇文章沿着”一次读请求”和”一次配置更新”两条主线,把一个可以实际运行的项目完整拆开,讲清楚缓存的每个设计决定在解决什么问题、付出了什么代价、边界在哪里。
核心结论
- 缓存是可重建的副本:数据的角色决定故障策略;配置查询可以降级,安全状态必须回查事实源。
- 读链路四道关卡:缓存命中 → 布隆三态 → 租约重建与二次检查 → 发布校验。
- 三类问题三种防御:空值与布隆挡穿透,同键锁挡击穿,抖动、熔断与回源上限挡雪崩。
- 旧快照用代际协议关闭:“读前取号、发布验号”,失效时原子地推进代际并删除缓存。
- 失效可靠性交给 Outbox:至少一次执行,副作用必须可重复。
实验边界
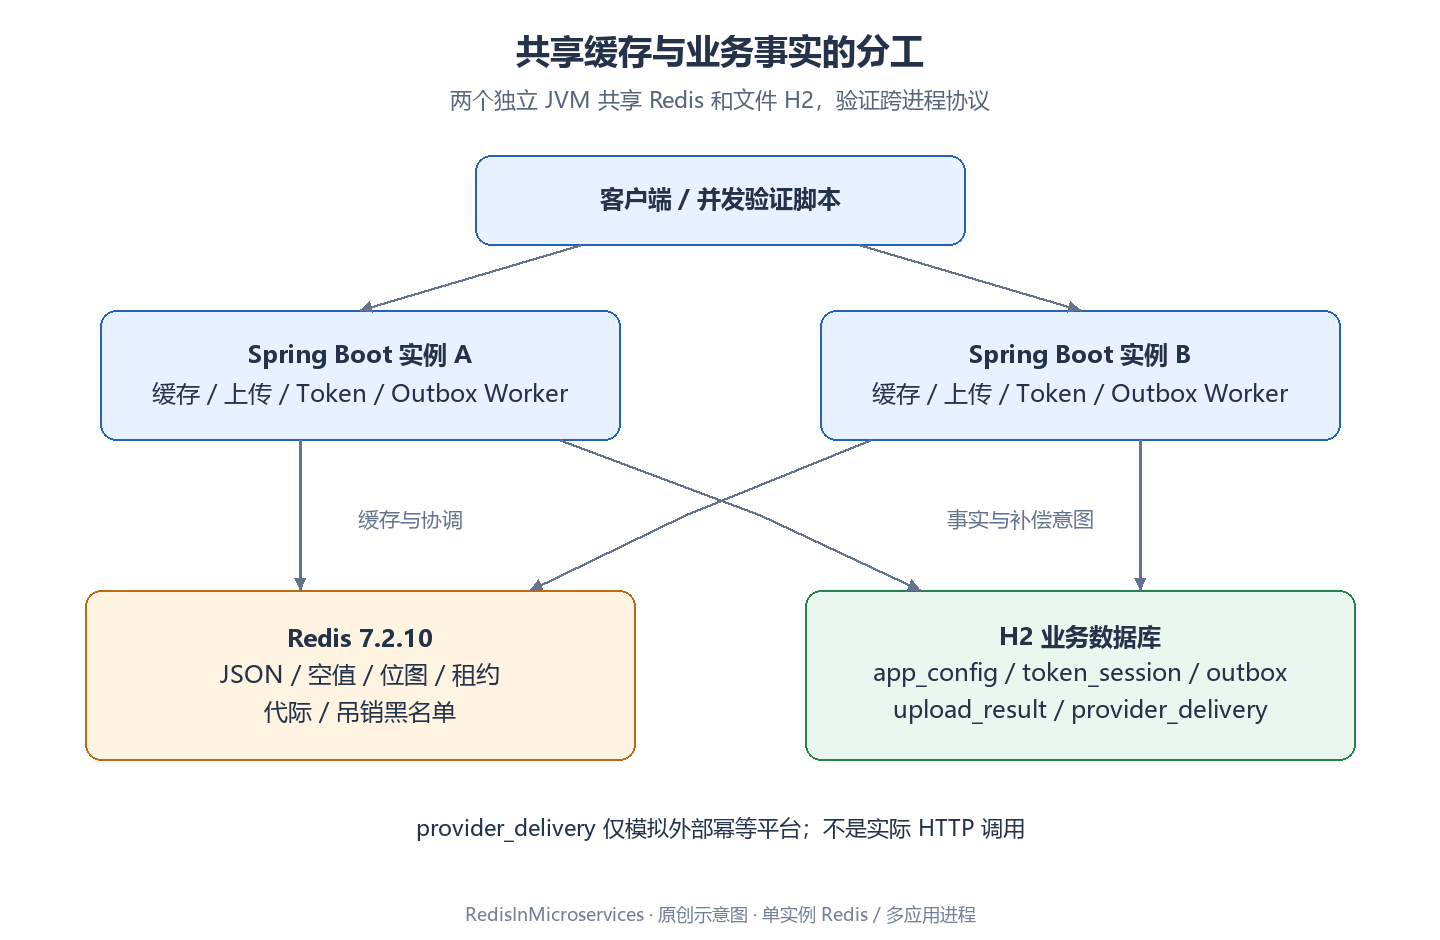
- 同一个 Spring Boot 应用启动两个 JVM,共享一个 Redis 实例和一份 H2 文件数据库,用来观察真正的跨进程竞争;
- 外部平台调用用同一库中的
provider_delivery表模拟,项目不发起真实 HTTP 请求; - 没有网关、注册中心、JWT 验签与完整权限系统,相关位置会明确说明哪些是协议、哪些是生产实现。
项目规模不大,但它让”共享状态出了问题会怎样”变得可观察、可复现,这正是学习缓存一致性最缺的东西。
缓存替我们承担了什么
从一条配置查询说起
系统里的业务对象是”某个租户下的应用配置”。demo
租户有一个编号为 1001
的应用,名称是”微信授权应用”;school 租户也可以有一个
1001,名称是”校边店应用”。两条记录编号相同、业务身份不同,因此一个对象的完整标识是
(tenant, appId)。这一点会一直影响到键的设计(3.1 节)。
查询接口是:
1 | GET /api/tenants/{tenant}/apps/{id} |
如果每次调用都直接查数据库,功能完全正确,代价是数据库承担了全部重复读:同一个热门应用,被不同租户下的不同用户反复打开,被多个实例的请求线程同时查询。把查询结果放进 Redis 之后,这些实例共享同一份副本,命中时只发生一次网络往返,数据库的压力从”请求量”降到”未命中量”。
缓存的本质是一份可重建的副本
在写任何代码之前,先回答两个问题,它们决定了后面所有的策略:
- 这份数据能不能从事实源重新得到? 能重建,缓存失效就可以降级到数据库;不能重建,它就不该只放在 Redis 里。
- 事实源与副本之间允许多大的偏差? 这决定了失效协议要做到多强:秒级可接受,和”必须读到刚刚写入的值”,是完全不同的两套设计。
按这个标准,可以把系统中的数据分成几类:
| 数据角色 | 例子 | 事实源 | 丢失或不可用时的策略 |
|---|---|---|---|
| 业务缓存 | 应用配置 JSON | app_config 表 |
回源查询数据库,重建副本 |
| 协调元数据 | 布隆位图、失效代际、重建锁 | 数据库目录 + 构建流程 | 收紧语义:过滤器未就绪就不拦截;代际用持久化保护 |
| 安全状态 | Token 吊销黑名单 | token_session 表 |
保守处理:未命中黑名单仍然查库,查不到就拒绝 |
| 补偿任务 | Outbox 事件 | redis_outbox 表 |
数据库保留意图,Worker 恢复后继续执行 |
这张表解释了一个常见困惑:为什么缓存挂掉时配置查询可以继续服务,授权检查却返回 503。前者手里有可重建的副本,最坏结果是变慢;后者如果在”不知道是否被吊销”时放行,就是把安全判断交给了一次网络失败。故障策略应当由数据的角色决定。
微服务把线程问题变成了协议问题
单个 JVM 里,synchronized 能解决同步问题;两个 JVM
之间,实例 A 持有的锁对实例 B
没有任何约束。更麻烦的是,多个实例共享的不只是数据,还有一整套约定:
- 键怎么写(命名空间、业务身份、格式版本);
- 值怎么序列化(JSON 结构、空值标记);
- 失败怎么表达(哪些异常可以降级,哪些必须上抛);
- 失效怎么传递(谁负责推进代际,谁负责重试)。
这些约定构成了缓存的协议,才能在微服务环境下正确的传播。协议不统一时,代码看起来都在读写 Redis,实际却在各说各的:A 写入的 JSON 版本,B 解析不了;A 认为已经失效的键,B 还在往里回填。后文的每一个设计,租约、代际、三态布隆、Outbox 等,本质上都是在补全这份协议。
拆成多个服务之后,这份协议还要跨团队维护,键的命名、格式版本、失效语义要写进文档与测试,成为团队共享的约定
一条读请求的全链路
一次缓存未命中的读请求,会依次经过下面这些阶段:
| 阶段 | 动作 | 关键实现 | 这一层失败时 |
|---|---|---|---|
| 0 入口校验 | 校验租户格式与 ID 范围 | KeySpace.tenant |
400,不触达任何存储 |
| 1 读缓存 | GET 缓存键 |
经 CacheRedis 熔断包装 |
熔断打开 → 降级到有限回源 |
| 2 命中判定 | 校验值里的租户与 ID | decode |
内容不一致或格式坏 → 按”缓存不可用”处理 |
| 3 布隆过滤 | 三态查询:明确不存在 / 可能存在 / 不知道 | bloom-check.lua 原子执行 |
只有”明确不存在”才返回 404 |
| 4 抢重建锁 | SET NX PX 3000 |
RedisLease |
抢不到 → 短暂等待后重读缓存 |
| 5 二次检查 | 拿到锁后再读一次缓存 | 复用别人的结果 | 读到值就直接返回,不再查库 |
| 6 回源 | 查数据库 | 信号量限制并发(默认 8) | 并发已满 → 503 |
| 7 发布 | 校验锁所有者与代际后写缓存 | cache-publish.lua |
校验失败 → 不写缓存,仍返回查到的结果 |
| 8 释放锁 | 比较所有者后删除 | unlock.lua |
失败只记指标,不覆盖已完成的业务结果 |
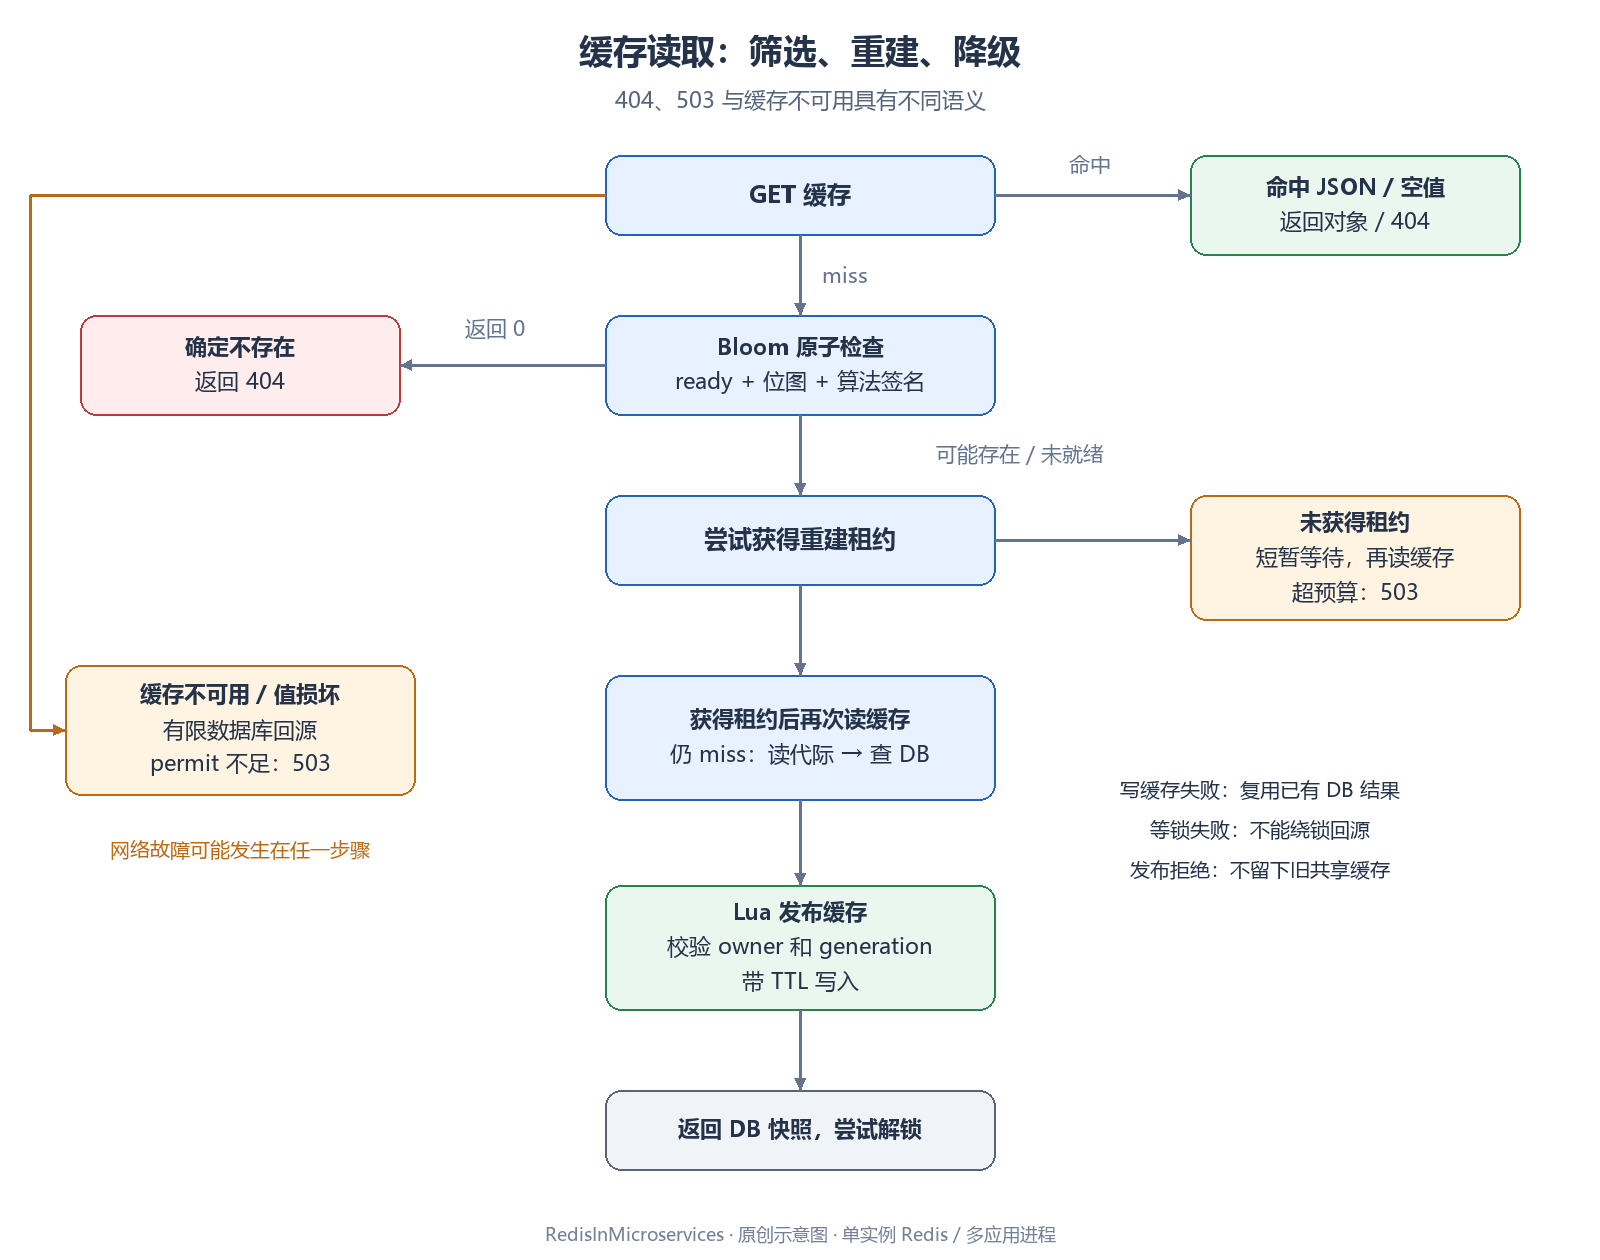
这条链路有三条设计原则:
每一层只承担一种失败语义。
缓存层回答”副本能不能用”,布隆层回答”对象是否可能存在”,数据库层回答”事实是什么”。把它们混在一起,降级策略就没法写。
每层失效时,先算下一层会收到多少请求。
缓存失效可能是几倍流量,布隆失效再加一批,锁失效再放大一批。设计时要回答的核心问题是:这一层倒下时,数据库能接住多少。
保护要落在真正的资源端。
锁在 Redis,并发保护在数据库入口的信号量;缓存可以被删掉,数据库约束和接口的幂等记录才是最后一道防线。
整条链路的关键参数如下,后文会逐一解释它们的来由:
| 参数 | 默认值 | 回答的问题 |
|---|---|---|
| 正缓存 TTL | 60 秒 + 0~15 秒抖动 | 副本最多可以陈旧多久 |
| 空值缓存 TTL | 5 秒 | 不存在的结果缓存多久,兼顾新建对象可见性 |
| 重建锁租期 | 3000 毫秒 | 孤儿锁最多存活多久 |
| 等待重建预算 | 600 毫秒 | 没抢到锁的请求愿意等多久 |
| 熔断冷却 | 2000 毫秒 | 已知 Redis 故障时,多久允许探测一次 |
| 回源并发 | 8(每实例) | 每个实例最多同时打几个数据库查询 |
| 数据库连接池 | 12,获取超时 1 秒 | 数据库侧的连接容量与等待上限 |
缓存协议的基础:Key、序列化与 TTL
Key 是跨服务协议
多个实例共享缓存,首先要统一的是键。示例项目把键集中放在
KeySpace 中,业务代码不直接拼接字符串:
1 | public String app(String tenant, long id) { |
这段短短的方法集合里藏着四个协议决定:
- 第一,命名空间隔离环境。
rims:local这样的前缀区分开发、测试、生产,也区分集成测试各自的数据。测试用随机 namespace 创建和清理自己的键,不需要FLUSHALL,既不会互相污染,也不会误删别人的数据。 - 第二,大括号把相关键归到一组。
单实例部署时它只是可读性;一旦上 Redis Cluster,
{...}内的内容决定哈希槽,缓存的键、代际键、锁键会落在同一个槽里,Lua 脚本对这些键的原子操作才能成立。把相关键放进同一个大括号是有意为之。布隆位图和吊销黑名单也采用同样的分组方式,第六章的四键激活脚本因此可以在同一槽内原子执行。 - 第三,
cache:v1是格式版本。 缓存内容的结构会演进:加字段、改序列化方式。发布新版本时,新旧实例可能同时在线,旧实例写入的 JSON 新实例未必能读。用版本后缀把两代格式隔开,升级时启用新键、让旧键自然过期,比”上线后祈祷所有实例同时更新”可靠得多。 - 第四,键里必须包含租户。 业务身份是
(tenant, appId),遗漏租户是最常见的越权与串数据来源。租户字段还要经过形状校验:它最后会拼进键,特殊字符可能破坏键结构,长度也不该无边界增长。
需要明确的是,租户正则只校验字符串形状,不证明调用者有权访问这个租户。真实系统从认证上下文解析租户,并在服务端检查权限;把这个实验接口暴露到公网之前,这是必须补的一层。
序列化:JSON 与一个专门的空值标记
缓存值使用 Jackson 写成 JSON。选 JSON
的理由很实际:redis-cli 里直接能看懂,跨语言可用,不依赖
Java 原生序列化。代价是体积略大、解析有开销,但是是赚的。
读到 JSON 之后,代码还会检查一件事:
1 | AppView view = json.readValue(raw, AppView.class); |
这次检查防的是”键对了、内容不对”的情况,键被错误覆盖、旧格式残留、别的系统写入了同名键,都会让一次命中变成错误结果,这就是事故。
比 JSON 更值得注意的是空值的表示。Redis 的 GET
对不存在的键返回
nil,对存在但内容为空的键返回空值——如果直接把 Java 的
null 写进去,这两种情况就分不开了:
nil表示没查过,应该走回源;- 明确的空值标记表示查过了,数据库里确实没有,应该直接返回 404。
所以项目用一个不可能与正常 JSON 冲突的哨兵值
~null:v1:
1 | private static final String NULL = "~null:v1"; |
这层区分是空值缓存能起作用的前提:不存在的 ID 第一次查库后写入空值标记,之后 5 秒内的重复请求都在缓存层被挡住,不再打数据库。攻击者不断换新的不存在 ID 时,空值缓存帮不上忙,那就轮到布隆过滤器(第六章)。
TTL 与抖动
正缓存的存活时间是一个区间:
1 | public long positiveTtl() { |
正缓存随机落在 60~75 秒,空值缓存固定 5 秒。抖动解决的是 同一时刻批量重建:如果所有键的 TTL 都是整 60 秒,一次发布、一次重启、一次批量刷新可能让大量键在同一秒到期,流量会从缓存层整体位移到数据库层。随机化把到期时间摊开,峰值就被削平了。
空值缓存则要短:太长会让”新建的对象”迟迟不可见,太短又挡不住重复的无效查询。5 秒是一个工程折中值。
关于 TTL,最重要的认识是它的职责边界:
- TTL 从写入缓存的时刻起算,与数据库提交时刻无关。读请求在数据库更新前拿到的旧快照,写回缓存后仍然会获得完整的 60~75 秒寿命。这正是第八章要解决的”旧快照回填”。
- TTL 是陈旧度上限和内存回收策略,并不承担一致性承诺:更新后能多快看到新值,取决于失效链路的延迟(第九章的 Outbox),与 TTL 的大小无关。
- TTL 也不负责容量。即使每个键只活一分钟,一分钟内创建数百万个不同的键,一样能把内存打满。容量要按”键数量 × 平均大小 + 元数据 + 布隆位图 + 无 TTL 的代际键”来估算。
后面几章会看到,缓存设计的难点几乎都集中在 写 这一侧,因为你redis读只需要快而且本身非常快,写就需要保证正确。
穿透、击穿、雪崩:三种失效形态
这三个名词经常被并列背诵,实际对应三种完全不同的失效形态,防御手段也不可互换:
| 问题 | 触发条件 | 现象 | 本质 | 主要防御 | 剩余风险 |
|---|---|---|---|---|---|
| 缓存穿透 | 查询的数据在缓存和数据库里都不存在 | 每次请求都穿过缓存打到数据库 | 缓存没有可命中的内容 | 参数校验、空值缓存、布隆过滤器、限流 | 攻击者不断更换不存在的 ID |
| 缓存击穿 | 一个极热门的键到期或尚未构建 | 大量请求同时 miss,一起回源 | 单个对象的并发重建 | 同键重建锁、二次检查、逻辑过期 | 锁租期短于慢查询、等待超时后的 503 |
| 缓存雪崩 | 大量键同时失效,或 Redis 整体不可用 | 请求成片进入数据库,系统级过载 | 容量边界被突破 | TTL 抖动、熔断、回源并发上限 | 数据库自身容量不足 |
三者的区别可以用一句话概括:穿透是”查不到”,击穿是”一起查”,雪崩是”全都来查”。
穿透:不存在的对象
一个不存在的 ID,缓存里没有,数据库里也没有。如果不做处理,每次请求都会先查一次缓存(miss),再查一次数据库(空),两次 I/O 全部浪费。它可能来自攻击扫描,也可能来自客户端 bug、过期链接、或者刚被删除的对象——不一定是恶意流量。
针对两种不同的形态,用两种手段:
- 同一个 ID
被反复查询,用空值缓存。第一次查库确认不存在后,把
~null:v1写进缓存,5 秒内所有重复请求直接在缓存层得到 404。这是 3.2 节那个哨兵值真正的用途。 - 大量不同的 ID 被查询,空值缓存只能挡住每个 ID
的第一次,挡不住 每次都要查一个
的流量。更前置的筛选是参数校验(
id > 0,格式合法)和布隆过滤器,布隆能做确定不存在,直接拒绝,连数据库都不碰。
空值缓存会推迟新建对象的可见时间。对象在 5 秒内被创建出来,缓存里还留着它不存在的记录,读请求会继续收到 404。这 5 秒是防御无效查询的代价,业务如果无法接受,就要缩短空值 TTL,或者在新对象写入时主动删除对应的空值标记。
击穿:一个热点键到期
设想一个被高频访问的配置项,TTL 到期的那一瞬间,所有并发请求同时看到一个空的缓存。如果没有协调,它们会同时查数据库、同时写缓存,数据库在几毫秒内收到几十上百个相同查询。
解决思路是同一时刻只允许一个请求重建同一个键,其余请求等它建好之后复用结果。落到实现上就是一把按对象粒度的 Redis 锁:
- 抢到锁的请求回源查询、发布缓存、释放锁;
- 没抢到的请求短暂等待(15~35 毫秒),然后重新读缓存;
- 等待超过预算(600 毫秒)仍然拿不到结果,返回 503,让调用方稍后重试。
锁必须放在 Redis。原因在前面已经说过:synchronized
只约束当前
JVM,两个实例会各自回源一次。击穿的本质是跨进程的并发重建,防御也必须在跨进程层面生效。
剩下的风险来自时间:数据库查询如果持续慢于锁租期(3000 毫秒),锁会提前过期,第二个重建者进入;等待预算耗尽后,用户拿到的是 503;旧数据没有作为降级结果返回。这两种情况属于”用确定性换可用性”的取舍,后文还会展开
雪崩:大面积失效与整体故障
雪崩有两种成因,严重程度差别很大。
第一种:大量键同时到期。 比如一次批量刷新让所有键在同一秒写入,60 秒后它们又同时到期。TTL 抖动(3.3 节)把到期时间摊开,可以显著削平这个峰值,但无法彻底消除——极度不均匀的访问分布下,仍可能有一批热点键同时过期。
第二种:Redis 整体不可用。 这时的处境完全不同,缓存读不到,布隆过滤器读不到,重建锁也拿不到,前面所有的 精细防御 同时失效。请求只能走数据库,而数据库的容量是按”正常情况下的回源量”设计的。
看一个具体的量级。假设接口每秒 2000 个请求,Redis 超时 300 毫秒:
- 每个请求在缓存层阻塞 0.3 秒;
- 按 Little 定律,稳定状态下同时在途的请求约为 2000 × 0.3 = 600 个;
- 而 Tomcat 的最大线程数是 64。
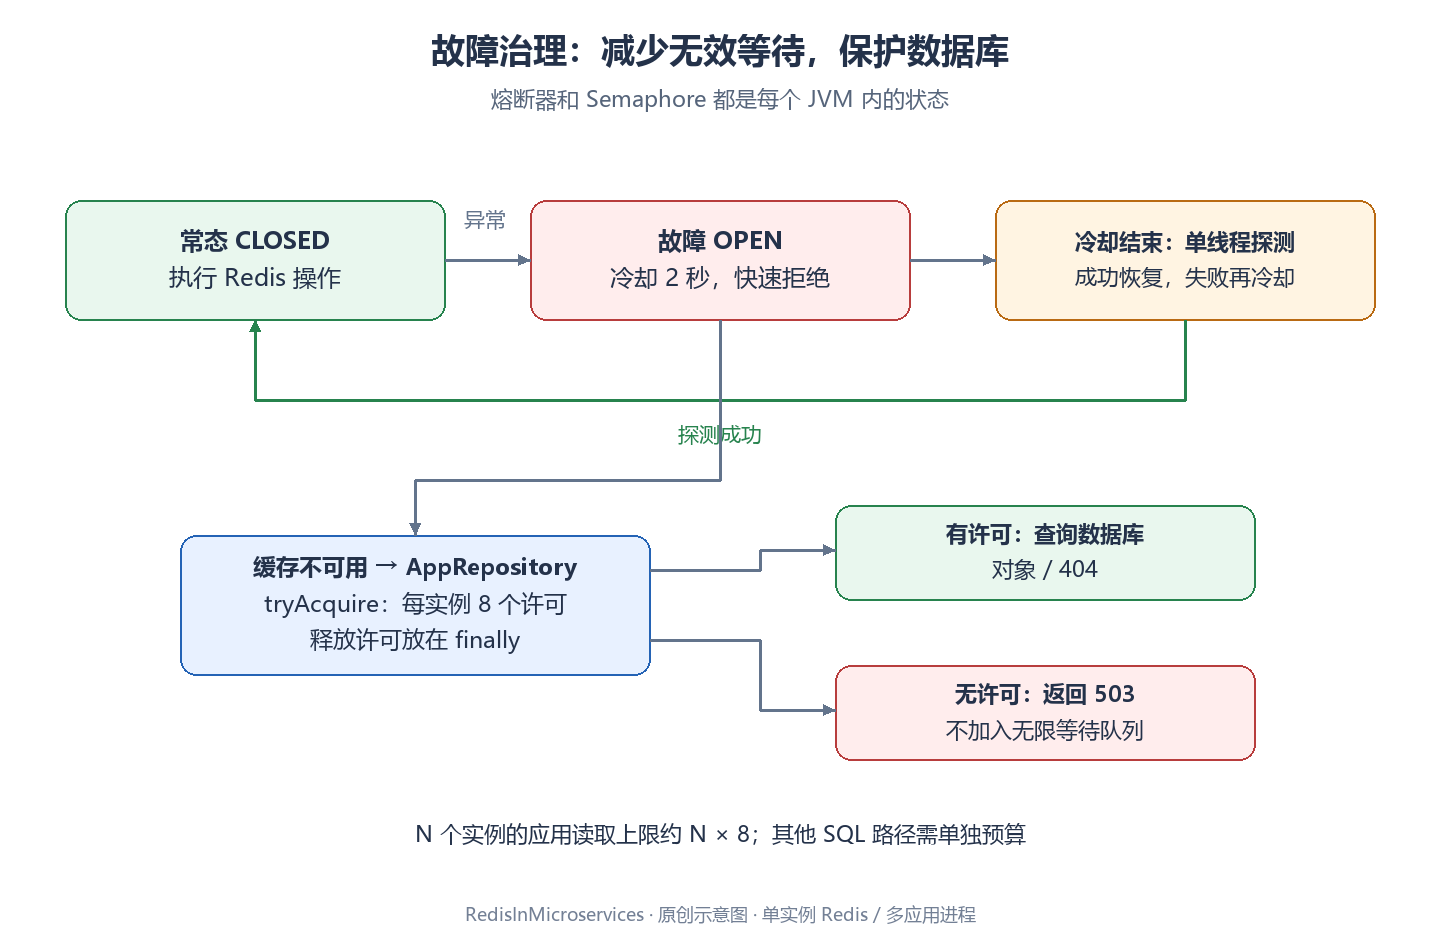
线程池会被瞬时占满,后续请求排队,排队又进一步拉长响应时间。短超时减少了一次伤害,但挡不住持续故障。所以还需要第二层,熔断。已知 Redis 故障期间,新请求直接快速失败,不再逐次消耗 300 毫秒去重新发现同一个事实
熔断之后,流量转向数据库,还必须限制回源并发:示例用每个实例 8 个许可的信号量。两个实例就是 16 个并发查询,超出部分的请求立刻得到 503。用 503 换数据库不被打垮,是设计内的行为。
三类问题会叠加
把上面的防御放进一次真实故障里看。执行
CLIENT PAUSE 5000 ALL 让 Redis 停顿 5 秒,然后发起 48
个缓存查询:
- 前几个请求在 Redis 调用上超时,熔断器打开(冷却 2000 毫秒);
- 冷却期内的请求快速失败,降级到数据库;
- 布隆查询同样包在缓存熔断包装里,Redis 不可用时直接抛
CacheUnavailable,整条缓存链路降级,请求全部回源; - 信号量只放行 8 个并发,其余立刻 503;
- 结果:16 个成功(200),32 个被拒绝(503)。
这个结果说明,缓存能降级,降级有容量上限。设计时要能回答两个问题,这一层失效后,下一层收到多少请求;下一层最多能接住多少。
读链路的四道关卡
这一章展开代码。读链路有四道关卡,每一道都只回答一个问题。
解决缓存不可用
1 | public AppView get(String tenant, long id) { |
注意 catch 的只有 CacheUnavailable
一种异常。这个选择本身就是在表达设计意图:
| 异常类型 | 含义 | 外层的处理 |
|---|---|---|
CacheUnavailable |
可重建的副本暂时没有提供有效服务 | 降级到有限回源 |
BusinessException |
业务结论:404 不存在、503 重建超时、409 版本冲突 | 按业务语义返回,不降级 |
DataAccessException |
数据库等存储操作失败 | 由对应层转换成 503,不递归查询 |
| 其他运行时异常 | 编程错误或未预期状态 | 交给统一异常处理,暴露出来 |
如果把这里写成
catch (Exception e) { return load(...) },会出现三种连锁反应:等待重建超时的请求会绕过锁直接查库;404
被当成缓存 miss
反复回源;数据库已经失败时还会再查一次。异常分类就是降级策略的边界。
先读缓存,再问布隆
1 | String cache = keys.cache(tenant, id); |
这个顺序有两个理由:
- 正常的热点请求只需要一次
GET就返回,不必为每个请求计算七个哈希、执行一次 Lua; - 命中空值标记时也能直接返回 404,既不走布隆,也不抢锁。
布隆过滤器保护的是 miss 路径。它的职责边界很清楚:
- 缓存记录具体内容,或者记录”查过一次,不存在”;
- 布隆记录目录的成员信息,只回答”这个 ID 有没有可能存在于集合中”。
所以布隆说”可能存在”(1)时,仍然要查缓存或数据库;说”确定不存在”(0)时,才可以作为
404
的依据。它不提供对象名称、版本,也不能代替数据库确认。第六章会解释为什么它必须用三态返回。
拿到锁之后,为什么还要二次检查
为聚焦主流程,下面的代码省略了指标计数与异常包装,完整实现见
AppCacheService。
1 | long deadline = System.nanoTime() + settings.getLockWaitMs() * 1_000_000; |
代码里还有一个容易忽略的顺序:对象不存在时,先把空值标记发布进缓存,再抛 404。如果先抛异常,发布代码不会执行,负缓存就永远建不起来,不存在的 ID 每次都会回源。
二次检查的价值用一个时间线就能看清。A 和 B 同时看到缓存为空:
| 时刻 | 实例 A | 实例 B |
|---|---|---|
| t0 | 看到 miss,尝试抢锁,成功 | 看到 miss,尝试抢锁,失败 |
| t1 | 查数据库,拿到结果 | 等待 20 毫秒,重读缓存(仍空) |
| t2 | 写入缓存,释放锁 | 再次抢锁,成功 |
| t3 | — | 二次检查命中缓存,直接返回 |
如果没有 t3 的二次检查,B 虽然遵守了”同一时刻只有一个重建者”的规则,却会再查一次数据库——互斥约束住了并发,但没有让 B 复用 A 已经完成的工作。二次检查把互斥变成了协作,把重复回源从”并发一次”降为”串行一次”。
等待循环里还有几个细节:
- 使用
System.nanoTime()测量经过时间,系统校时不会改变等待间隔; do...while至少执行一次,所以把等待预算配成 0 不代表完全不尝试抢锁;- 每轮都要付一次 Redis 往返和一次随机
pause,600 毫秒是循环的总预算,单次端到端耗时会略有出入;需要严格 deadline 时,要在每个下游调用前重新计算剩余时间; - 等待超时返回 503。绕过锁去查库会让几十个等待者同时回源,前面的互斥就白做了。
写缓存失败不该触发第二次查库
拿到数据库结果之后,写缓存这一步也可能失败。把上面的
publish(owner, expected, view)
展开,就是下面这段;expected 与 view
来自上文:
1 | String payload = view == null ? NULL : json.writeValueAsString(view); |
这个位置的判断值得学习:异常应该在拥有足够上下文的最窄位置处理。结果已经来自事实源,写缓存只是顺便让下一次更快,而失败不影响本次正确性。如果让异常冒到最外层
get(),它会被当成缓存不可用,于是再 load()
一次,这样同一个请求查两次数据库,而这次查询毫无收益。
发布脚本的两个校验条件(锁所有者、失效代际)留到后面讲,那里才是它真正的用武之地。
空值、坏数据与 corrupt
这一部分处理,缓存里的值本身有问题,的情况:空值标记、格式损坏、身份不一致。
1 | private AppView decode(String raw, String tenant, long id) { |
空值判断必须放在 JSON
解析之外:~null:v1 本身不是合法 JSON,放进
try
里会被当成格式错误,然后触发一次无意义的数据库查询,把一个正常的负缓存命中变成降级。
坏值(解析失败、身份不一致)转换成
CacheUnavailable,避免直接抛
500:数据质量问题和存储可用性问题都应该让请求自己处理,至少这次请求能拿到正确结果。代价是坏值不会被立即清除,在
TTL 到期之前,后续请求会持续走降级。所以 corrupt
指标持续增长时必须当成故障处理,接口返回 200 说明不了缓存是健康的。
一个值得做的改进是 比较后再删除:读取时发现坏值,用一个 Lua 脚本判断”当前值仍然等于刚才读到的坏值”才删除,避免把别的实例刚写入的新值误删。要注意,检查与修改必须放在同一个 Redis 原子步骤里,否则检查时的依据在修改时可能已经失效。
布隆过滤器
空值缓存只能挡住 同一个不存在 ID 的重复查询。要挡住 每次换一个不存在 ID 的流量,需要一个快速的能回答 这个 ID 有没有可能存在 的结构,此时采用布隆过滤器。
原理
布隆过滤器由一个长度为 m 的位数组和 k
个哈希函数组成:
- 加入元素时,计算
k个哈希下标,把它们全部置为 1; - 查询元素时,重新计算同样的下标:只要有一个位置是 0,这个元素就一定没有被加入过;如果全部是 1,它可能存在——因为这些位也可能是别的元素设置成 1 的。
示例把 k 个哈希实现为”同一个 SHA-256 +
不同盐值”,效果等价于 k 个相互独立的哈希函数,6.3
节会看到具体写法。
由此得到两个性质:
- 存在误判(false positive):不存在的元素可能被判为”可能存在”。后果只是多查一次数据库,不会返回错误数据。
- 没有假阴性(false negative):只要位图完整、算法一致、成员全部加入过,存在的元素不可能被判为”不存在”。
给定预期元素数量 n 和目标误判率
p,常用公式是:
1 | m = ceil(-n × ln(p) / (ln(2)²)) # 位数组长度 |
哈希也是共享协议
1 | public static List<String> offsets(String tenant, long id) { |
这段代码里,每一个看起来不起眼的选择都是协议的一部分:
- 租户参与哈希。不同租户使用相同的数字 ID 时,哈希结果完全不同,不会把别人的 ID 误判为存在。
- 拼接格式固定。
i:tenant:id的分隔符、编码(UTF-8)、字节序都会影响结果,任何一个实例改了写法,就会和别人的位图对不上。 - 用
floorMod处理负数。Math.abs(Long.MIN_VALUE)仍然是负数,会算出非法下标。 i参与输入,用同一个 SHA-256 生成k组确定性哈希,省去实现七种不同哈希函数的麻烦——简单、可复现、跨语言可移植。
七个哈希意味着每次 miss 都要算七次
SHA-256。目录很大时,可以评估双重哈希(用两个哈希派生 k
个下标)、批量流水线计算等优化。但优化必须配一套固定的测试向量,保证升级前后对同一个
ID 得到相同下标,否则一次性能优化就会让新旧位图无法共用。
算法、容量、哈希次数最终被写成一个签名(SIGNATURE),随位图一起发布到 ready 键。查询时先比对签名,签名不一致就返回不知道。这让算法升级变成了一次显式的重建动作,避免新实例拿旧位图给出错误答案。
发布生命周期
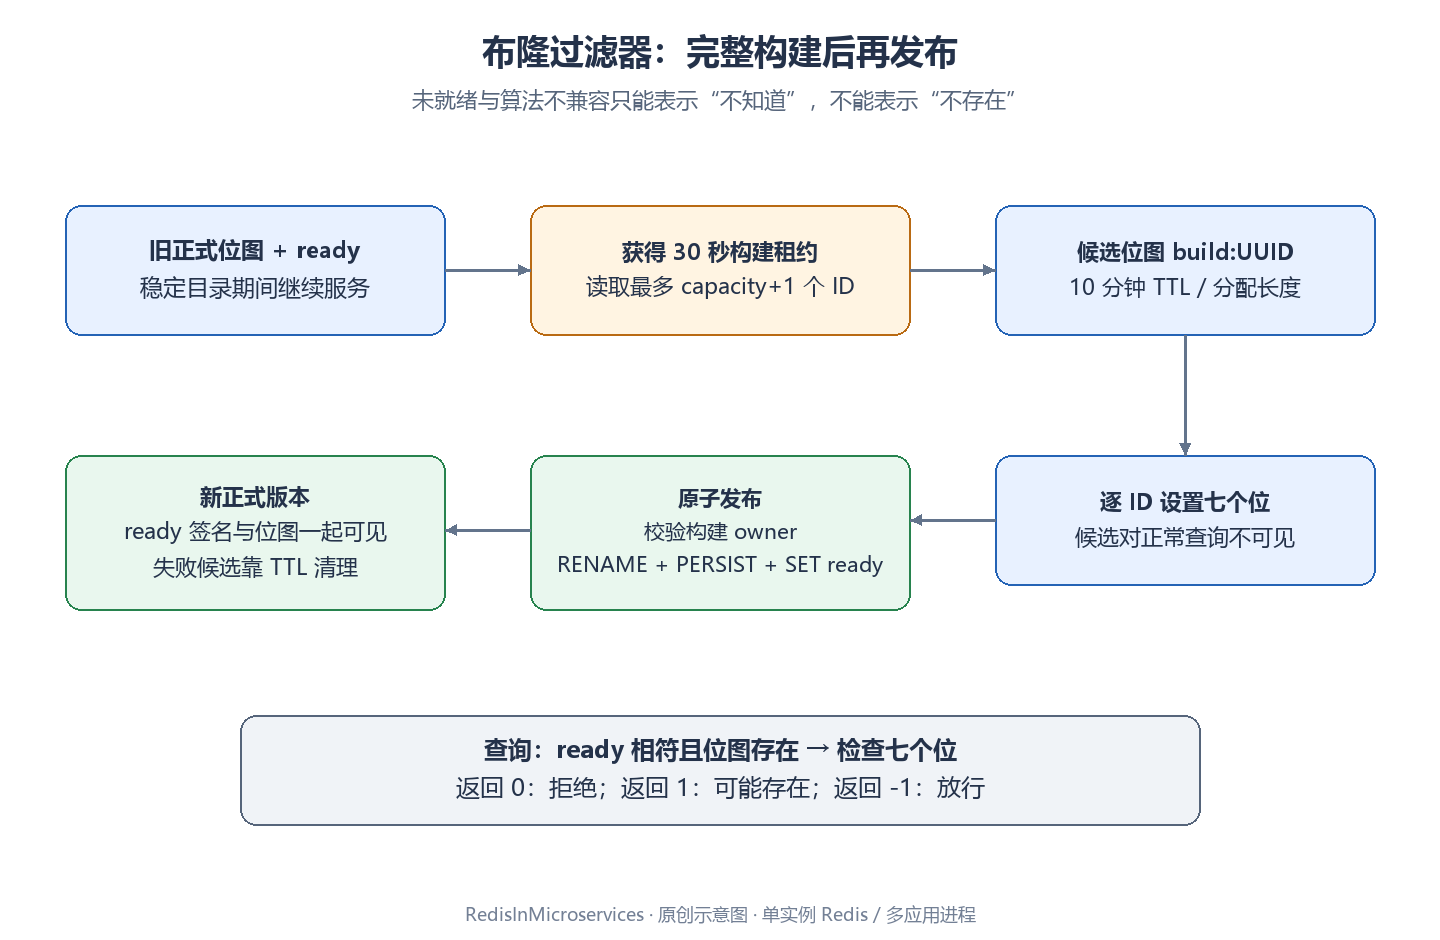
最直接的更新方式是清空位图再逐个加入 ID。这个写法有一个致命窗口:重建过程中到来的查询会把”还没构建到”误读成”不存在”,于是存在的对象被返回 404。加锁解决不了问题——查询请求不会去获取构建锁。
正确做法是先构建候选位图,完整之后原子替换(代码省略了指标计数与异常包装,完整实现见
AppBloomFilter):
1 | String base = keys.bloom(tenant); |
发布脚本把”校验构建者身份、替换位图、写入签名”放在同一个原子步骤里:
1 | if redis.call('GET', KEYS[4]) ~= ARGV[1] then return 0 end |
这里有两个不同的时间,用途完全不同:
- 候选键 10 分钟 TTL:构建失败留下的半成品会被自动清理;
- 构建锁 30 秒租期:构建者崩溃后,孤儿锁最多存活 30 秒。
构建慢到锁过期时,旧构建者已经失去发布资格(bloom-activate.lua
会拒绝它),候选位图最终自动过期,系统回到”没有 ready
签名”的未就绪状态,查询放行到数据库。这个降级方向是安全的:宁可多查数据库,也不能用半成品位图拒绝真实对象。
逐 ID 执行脚本意味着构建要走很多次网络往返。容量只有一万时这没问题;目录更大,构建耗时会超过租期,需要分批流水线、进度记录,以及”租约过期后拒绝发布”的保护。把所有 ID 塞进一个巨大的 Lua 脚本并不可取——长脚本会长时间占用 Redis 的执行线程,影响其他所有业务请求。
6.5 三态查询:区分”不存在”和”不知道”
1 | -- bloom-check.lua |
返回值有三种含义,Java 端只对 0 做拦截:
| 返回 | 含义 | Java 行为 |
|---|---|---|
0 |
位图完整、签名匹配,且至少一位为 0 | 确定不存在,直接 404 |
1 |
所有位都是 1 | 可能存在,继续走缓存重建链路 |
-1 |
位图缺失、签名不匹配或尚未构建 | 不知道,放行到数据库(仍受并发上限保护) |
-1
这个设计是整章最重要的工程点。它承认了一个事实:过滤器不可用时,“没有证据说不存在”和”确定不存在”必须分开表达。如果把
-1 也当成
0,一次重启、一次重建、一次签名升级,都会让真实存在的对象被大面积误判成
404。
顺带指出一个实现细节:脚本校验的是 ready
签名与位图键是否存在,并不检查位图字符串的实际长度。长度等于
BITS 由构建流程保证;如果位图被意外截断而 ready
签名还在,查询脚本不会发现,仍可能产生假阴性。这也是为什么”未就绪”的判定只能信脚本返回的
-1,不能靠”键存在”推断过滤器可用。
三态同时让监控变得可解释。lab.bloom.result 用
reject、maybe、unready、build_failure
四个结果标签分别计数:unready
持续增长,说明过滤器没有正常工作,无效请求正在进入重建链路,应该去检查位图、签名和构建状态;接口成功率不足以说明问题。
启动时 ApplicationRunner 会为已有租户触发一次构建,Redis
的 DataAccessException
被记录为构建失败,应用继续启动——过滤器没有就绪,业务可以退化为”多查数据库”。容量超限抛出的
IllegalStateException
不走这条捕获,会让启动直接失败:容量规划错误属于必须尽快暴露的问题,和临时网络故障不该共用同一种处理方式。
6.6 最重要的边界:目录必须是一份稳定的快照
前面所有机制的共同前提是:成员集合基本稳定、只更新属性。 示例项目只开放了修改应用名称,没有开放新增和删除应用的接口,因此构建快照的成员集合是稳定的。把这个实现搬到动态目录之前,先要回答新增和删除分别会发生什么。
如果把这个实现搬到动态目录上,会出现两类假阴性:
新增对象时,数据库已经提交,但新 ID 还没有加入过滤器,查询会得到”确定不存在”,返回 404。即使立刻重建,也还有一个窗口:快照读取完成之后、发布之前新增的成员,会被这次发布遗漏。
删除对象时,七个位由多个元素共享,直接清零会把仍然存在的元素一起打成假阴性。普通布隆过滤器的处理方式是容忍已删除成员继续产生误判,等下一次重建时回收;需要频繁删除时,才考虑计数布隆等支持删除的结构,代价是内存、误判率和维护复杂度都会上升。
动态目录要安全使用布隆,必须额外设计可见性协议,例如:
- 新增对象在数据库提交之前,确保过滤器成员已经准备好,失败则让过滤器转为未就绪;
- 重建快照期间收集增量,发布前补齐;
- 维护新旧两个世代,规定查询时如何选择。
每种方案都有自己的事务边界;“新增时补一次
SETBIT”覆盖不了这些窗口。布隆过滤器始终是减轻压力的辅助结构,事实查询和容量保护不能被它替代。
分布式锁
原子加锁:SET key owner NX PX lease
1 | public String acquire(String key, long leaseMs) { |
锁必须用一条命令完成”不存在才创建”和”设置过期时间”两件事。如果先
SETNX 再单独
EXPIRE,客户端可能在两条命令之间退出,留下一把没有 TTL
的永久锁。SET NX PX 把这两个语义合并成原子操作。
所有者标识用 UUID,而且每次尝试都重新生成。
- 用线程 ID 不够,不同 JVM 的线程 ID 可以相同,A 进程的线程 7 和 B 进程的线程 7 会撞在一起;
- 只用实例 ID 不够,同一实例的两个任务先后竞争同一把锁时,无法区分”前任”和”后任”。
UUID 的作用是确认锁的归属,不承担任务排序和资源端版本号。这两件事需要不同的机制
解锁:必须比较所有者
1 | -- unlock.lua:检查与删除不能拆成两条客户端命令。 |
如果不比较所有者,会发生这样的事:
| 时刻 | 实例 A | 实例 B |
|---|---|---|
| t0 | 获得锁,租期 3 秒 | — |
| t1 | 发生长时间 GC / 线程暂停,超过 3 秒 | — |
| t2 | 锁到期自动释放 | 获得同名锁,开始工作 |
| t3 | 恢复执行,直接 DEL |
锁被 A 删掉,互斥失效 |
即使把逻辑改成”先 GET 判断所有者,再
DEL“,两步之间仍可能发生”锁到期 + B 抢到锁”,A 的
DEL 还是删错了对象。比较和删除必须在同一个 Lua
脚本里完成,这是”检查与修改原子化”的又一个例子。
解锁脚本保证的是”不误删”,它并不负责让 A 停下来。Redis 不会因为键过期就中断 A 的 Java 线程,A 的数据库查询、HTTP 调用、文件处理都会继续执行。固定租约的本质是”给持有者一段有效时间”,超出这段时间之后,互斥承诺就失效了;这时要靠资源端的保护兜底。
租期、等待预算与续期
示例中缓存重建和上传锁的默认租期都是 3000 毫秒,但两者配套的等待策略不同:
| 场景 | 租期 | 拿不到锁时 | 设计意图 |
|---|---|---|---|
| 缓存重建 | 3000 ms | 等待最多 600 ms,期间重读缓存 | 大概率很快能复用别人的结果 |
| 上传 | 3000 ms | 立即返回 423 | 明确告诉调用方”这个应用正在发布” |
租期回答的是”孤儿锁最多存活多久”,等待预算回答的是”没抢到锁的请求愿意等多久”,两者没有必然关系。
租期的选择要看数据库查询的尾延迟。如果 p99 查询时间是 2.5 秒,3 秒租期在正常路径上勉强够用,但一次 GC 或一次磁盘抖动就可能让重建者丢锁、第二个重建者进入。延长租期能减少这种丢锁,代价是进程崩溃后锁要更久才释放。
续期(watchdog)能提高长任务的存活率,但引入了新的复杂度:续期线程自己也可能被暂停,续期失败后要能安全退出,所有者变化后不能继续续期。成熟组件(如 Redisson)处理了这些细节,但使用成熟锁组件不等于获得了”恰好一次”的业务语义,资源端的幂等和版本约束仍然必须存在。示例项目没有实现续期、可重入、公平排队和阻塞唤醒,它是一把教学用的”有限租约锁”。
锁过期
锁过期、旧执行者继续运行,这是分布式系统里无法完全消除的事实。真正保护业务的是资源端对旧执行者的拒绝:
| 资源 | 资源端保护 | 效果 |
|---|---|---|
| 缓存写入 | 发布 Lua 脚本校验 owner 与代际 | 失去租约的旧重建者无法覆盖新缓存(第八章) |
| 数据库更新 | WHERE version = ? 条件更新、唯一约束 |
旧版本写入影响 0 行,返回 409 |
| 外部平台调用 | 平台幂等键 + 内容校验 | 同一业务操作重复提交返回同一结果 |
| 严格顺序场景 | 递增的 fencing token,由资源端校验 | 旧令牌的执行被资源端明确拒绝 |
fencing token 的要点:令牌必须由下游资源校验。只让 Redis 生成一个递增数字、记录在请求里,而数据库或存储端不看这个数字,安全效果为零。示例项目采用的是”缓存发布校验 + 业务幂等”这条路,没有实现完整的 fencing
旧快照回填与失效代际
前面几章解决的是”读得快”和”读不到时怎么办”。真正让缓存设计变难的是写:数据库更新之后,缓存怎样才能保证不再返回旧值。这一章是全文的核心。
一个不需要任何故障的竞态
考虑下面这个顺序,全程没有任何命令失败、没有网络抖动、没有进程崩溃:
| 时刻 | 读请求 R | 写请求 W | 数据库 / Redis |
|---|---|---|---|
| t0 | GET 缓存,miss |
— | 缓存为空 |
| t1 | 查数据库,得到版本 1 | — | DB = v1 |
| t2 | — | 更新数据库为版本 2 | DB = v2 |
| t3 | — | 删除缓存 | 缓存为空 |
| t4 | 把版本 1 写回缓存 | — | 缓存 = v1,TTL 60~75 秒 |
删除动作执行成功了,缓存却在新版本之后重新变成了旧值。这就是旧快照回填:读请求在数据库更新之前取到旧数据,在失效动作之后才把旧数据发布出去。
这个问题与 先删缓存还是先更新数据库 的顺序无关。把顺序换过来,只是把窗口从回填覆盖删除变成删除之后读到旧库再回填。只要读和写是两个独立操作,就存在交错。缩短 TTL 只是缩短窗口:从最长 75 秒变成最长 5 秒,旧值依然会回来。
加锁和版本号为什么都不够
最直觉的补救是让重建也走锁。问题是:失效动作通常不参与重建锁。W 只做一次数据库更新和一次缓存删除,它没有理由去抢重建锁;就算让它抢,W 也得等 R 释放锁——那等于把数据库更新阻塞在一次可能很慢的查询后面。
还有一种想法是给缓存值带上数据库版本,读取时比较版本号。但缓存里只有值,没有”当前最新版本”的参照物;要拿到参照物,就得再查一次数据库——缓存的意义消失了一半。
要让这条竞态消失,需要一个所有参与者都认可的顺序标尺,并且让”发布”这个动作在写入之前能验证标尺没有变过。示例项目用的标尺是失效代际(generation)。
代际协议:读前取号,发布时验号
代际是每个对象一个的计数器,只在失效时递增。规则只有两条:
- 重建者:查数据库之前读取当前代际,作为”取号”;发布缓存时,要求代际仍然等于这个号,并且自己仍然持有重建锁;
- 失效者:在同一个原子步骤里,把代际加一,并删除缓存。
发布脚本把两个校验条件写在一起:
1 | -- cache-publish.lua |
为什么这样就安全?把之前描述的错误序补上代际,看两种可能:
| 情况 | 时序 | 结果 |
|---|---|---|
| 失效发生在发布之前 | R 取号 gen=5 → W 失效(gen=6,删缓存)→ R 发布(期望 5) | 代际不匹配,发布被拒绝 |
| 失效发生在发布之后 | R 发布 v1(gen=5)→ W 失效(gen=6,删缓存) | 刚发布的 v1 被删除,下次读取重建 v2 |
也就是说:任何一次失效之后,都不会再有更旧的快照被写回。 这是代际协议真正承诺的东西。它不承诺更新后立刻能读到新值,数据库提交与失效执行之间还有 Outbox 的延迟,那段时间里的读请求仍然可能拿到旧值。
区分这两件事,是理解这个方案的关键:
- 失效之前:旧值可能被读到,这是最终一致性的固有窗口;
- 失效之后:旧值不会再回来,这是代际协议关闭的竞态。
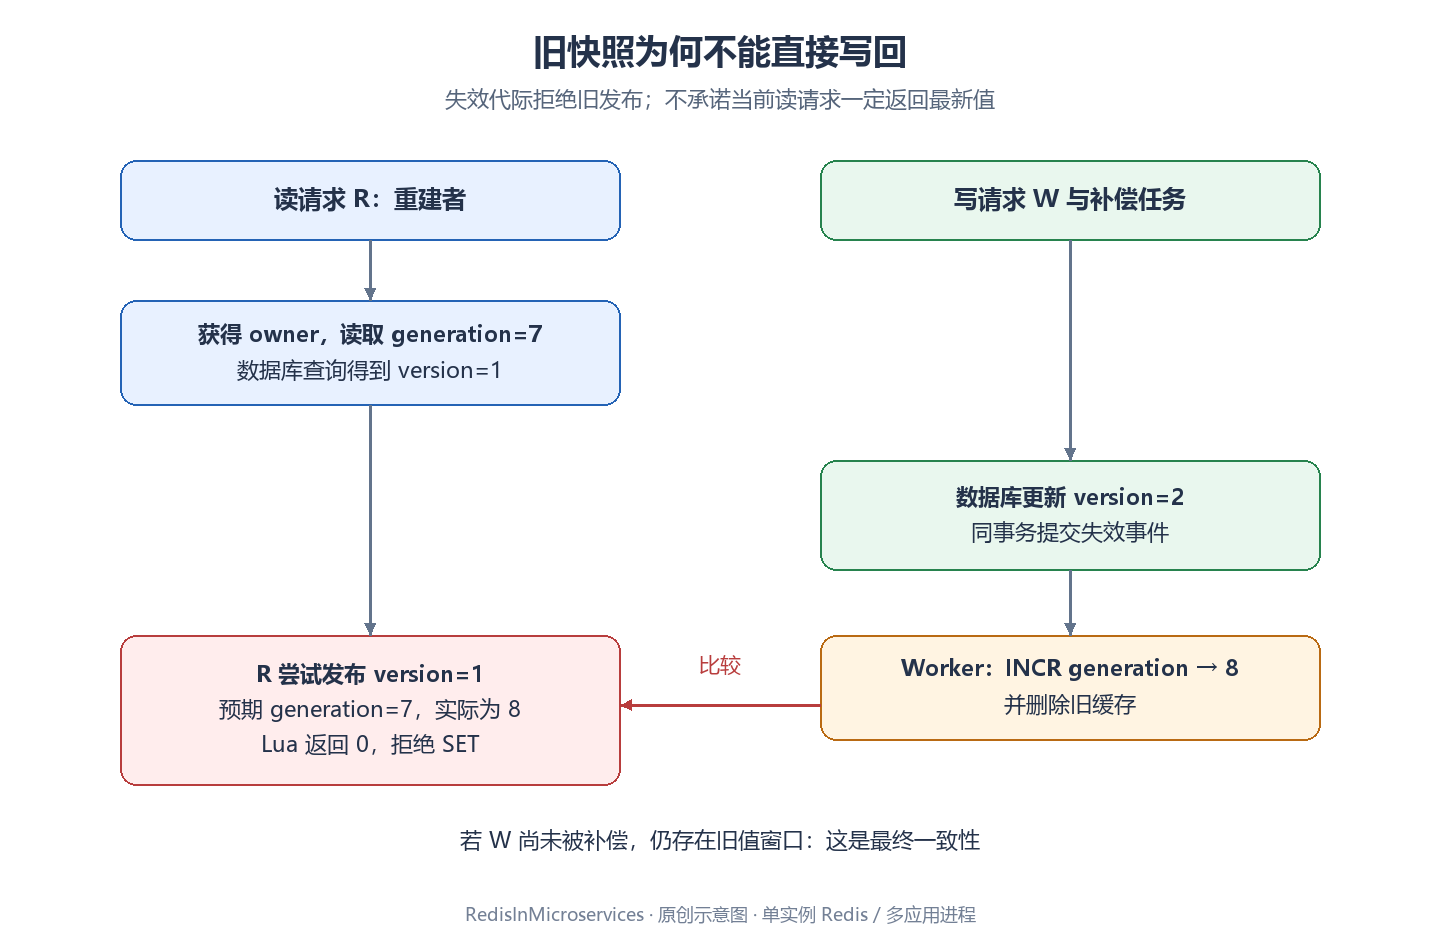
发布被拒绝时,Java 代码记 publish_rejected
指标,但仍然把本次查到的数据库结果返回给调用者。这个结果对本次请求是真实的(它来自事实源),只是不适合作为共享缓存。两个决定要分开:
- 不把不合格结果留成共享缓存,脚本负责;
- 本次请求返回什么,业务负责,通常返回刚查到的值。
如果业务要求,读请求必须观察到某次已确认的写入,那需要的是版本门槛、直接读事实源或更强的读一致性协议
三个标识
系统里同时存在三个容易混淆的标识,混用会制造非常隐蔽的 bug:
| 标识 | 解决什么问题 | 谁维护 | 生命周期 | 能否出现在业务响应里 |
|---|---|---|---|---|
数据库 version |
写写冲突(乐观并发控制) | 业务更新事务 | 随业务记录持久化 | 可以,客户端用它提交更新 |
缓存 generation |
拒绝”失效之前取号、失效之后发布”的旧快照 | 失效脚本 + 发布脚本 | 键存在期间持续递增,无 TTL | 不可以,它是缓存协议内部状态 |
锁 owner |
区分同一把锁的前任与后任 | 每次抢锁生成 | 只活到锁释放或租期结束 | 不可以 |
常见错误包括:把数据库 version 当作锁的 owner(版本相同的两个请求会互相误解锁)、把 generation 当作业务版本返回给前端(它只反映缓存失效次数,不反映对象内容)、用锁 owner 判断对象是否过期。一个字段只承担一种协议职责,这是分布式系统里最值得坚持的纪律之一。
失效需要推进代际与删除缓存必须一起做
1 | -- cache-invalidate.lua |
两个动作缺一不可:
- 只删除缓存、不推进代际:8.1 的竞态原样保留——R 取号 gen=5,W 删缓存,R 发布时 gen 仍是 5,校验通过,旧值照样回来;
- 只推进代际、不删除缓存:旧值继续被命中,直到 TTL 到期。代际只能让”新的发布”被拒绝,不能让”已经在缓存里的值”消失。
重复执行失效会让代际多加几次、把刚建好的缓存再删一次。它不算严格幂等,但业务效果可以重复:旧数据不会因为重试而重新生效,只是多付一次失效与重建的成本。第九章的 Outbox 恰好需要这种”可重复执行”的语义。
代际的生命周期与它自己的故障
代际键有一个反直觉的设计:没有
TTL。如果给代际设置过期时间,它可能在缓存还活着的时候先消失,读请求从”不存在”得到默认值
"0",发布校验就会在错误的基准上进行。
代价是每个发生过失效的对象都会留下一个持久键。规模上去之后,这些元数据的数量与内存需要纳入容量规划,并跟随对象生命周期清理(例如对象彻底删除时一起清理),不能简单地”给它配一个比缓存更短的 TTL”。
更隐蔽的风险是代际键丢失。考虑这个顺序:
- 读者 R 取号,读到默认值
"0"(此时代际键还不存在); - W 失效:
INCR创建代际键为 1,删除缓存; - 代际键因为淘汰、误删或实例恢复而消失;
- R 发布,期望
"0",脚本读到”不存在”按"0"处理,校验通过——旧快照在失效之后被发布。
这是典型的 ABA 问题。示例项目用 noeviction
和持久化来降低概率(第十四章),但丢失仍可能发生。扩展方向是把数据库版本纳入发布条件,或者使用可持久恢复的世代标识,并明确”恢复期间是否暂停缓存发布”。这类看起来不起眼的元数据,往往承载着协议正确性的前提。
数据库侧的写写冲突:乐观锁
代际解决的是”缓存与数据库之间”的竞态;同一对象被两个请求同时修改,是另一个问题:
1 | public void update(String tenant, long id, String name, long expectedVersion) { |
客户端先读到版本 1,提交时带上
expectedVersion=1。如果另一个请求已经把它更新成了版本
2,这条 UPDATE 影响 0 行,返回
409,后到的修改不会静默覆盖先到的修改。
这段代码把三件事放在了一个数据库事务里:
- 业务字段更新;
- 版本递增;
- 写入一条”待失效”的 Outbox 事件。
前两件是业务事实,第三件是”提交之后还必须做什么”的补偿意图。三者要么一起提交、要么一起回滚,这一层由数据库事务保证。但要看清事务的边界:TransactionTemplate
只覆盖同一个数据库事务管理器下的 JDBC 操作,后来在 Outbox Worker
里执行的 Redis 命令不属于这笔事务。跨 Redis
和数据库的原子提交是做不到的,能做的是”数据库提交后,补偿意图不会丢”。
接口返回 204,含义是”数据库更新与待执行的失效任务已被接受”;Redis 此刻可能还没失效。客户端看到 204 后立刻读,仍可能读到旧值——这就是 9.1 节 Outbox 要处理的窗口。
Outbox
双写为什么必然有窗口
直接写”更新数据库,再删除缓存”,有两种失败方式:
- 数据库成功、Redis 失败:缓存留在旧值上,而且没有任何机制会再去删它;
- 先删 Redis、再更新数据库,或者删除成功但回填并发进行:仍然可能出现旧值。
两个独立系统之间不存在同时提交。调整代码顺序只能改变窗口的位置,不能消除窗口。Outbox 的思路是换一个问法:不在请求路径上直接操作 Redis,而是先把”之后要做什么”作为一条数据库记录提交,再由后台任务可靠地执行。
表结构与事务边界
redis_outbox 保存事件
ID、类型、租户、业务引用、绝对到期时间、重试次数、下次执行时间和最后错误类型。事件类型目前有两种:CACHE_INVALIDATE(缓存失效)和
TOKEN_DENY(吊销黑名单补偿)。
1 | public void add(String kind, String tenant, String ref, long expiresAt) { |
add()
方法本身没有事务。它之所以可靠,是因为调用者把它放进了业务事务——业务更新和事件插入一起提交。如果某段代码脱离事务单独调用
add(),它就只是一条普通插入,失去了与业务状态绑定的保证。看代码要追调用链,不能只看到一张
Outbox 表就断言所有双写都可靠。
due() 查询用 next_at <= now 和
ORDER BY next_at LIMIT 50 取到期任务,next_at
上有索引。事件在成功之前不会删除,成功之后才删除。
至少一次执行,确认之后才删除
1 | for (var event : store.due()) { |
这里的关键顺序是:先执行副作用、拿到确认,再删除事件。反过来的话,进程在两步之间退出,事件已经消失,副作用却没有发生,缓存就永久停留在旧值。
即便如此,重复仍会发生:Redis 实际执行成功但响应超时,Worker
会保留事件并重试;响应成功但进程在 done()
之前退出,下次还会再执行一遍。所以语义是至少一次,消费逻辑必须允许重复。示例的两类事件天然可重复:
CACHE_INVALIDATE:多推进一次代际、多删一次缓存,业务效果不变,只增加一次重建;TOKEN_DENY:脚本按数据库里的绝对到期时间写PXAT,重复执行只是把同一个截止时间再写一次。
当前 Worker 没有任务认领、租约字段或
SELECT ... FOR UPDATE SKIP LOCKED,两个实例会读到同一批事件并各执行一遍。对这两类事件,重复执行的代价只是额外开销;如果以后加入”只能成功一次”的事件类型,就必须先补上认领与去重机制。
一次更新会在哪些位置中断
把故障注入到每个阶段,可以列出所有可能的中断位置:
| 中断位置 | 留下的状态 | 恢复后的结果 |
|---|---|---|
| 数据库事务提交前 | 业务更新和事件一起回滚 | 客户端重新确认业务操作 |
| 提交后、Worker 执行前 | 业务已是新值,事件待执行 | Worker 继续补偿,缓存最终失效 |
| Redis 执行后、收到确认前 | Redis 可能已生效,事件还在 | 重复执行一次,结果不变 |
| 收到确认后、删除事件前 | 副作用已生效,事件还在 | 重复处理后删除 |
| 事件删除后 | 补偿完成 | 不再处理该行 |
这张表比一句”最终一致性”具体得多。它能回答线上排障时最常问的问题:现在系统处在哪个状态,下一步该做什么。
退避、积压与死信
指数退避从 1 秒开始,翻倍增长到最多 60 秒,再加 0~249 毫秒的抖动。它的作用是在 Redis 持续故障时,避免每个 Worker 每秒反复重试同一批事件;抖动则降低多个实例同步重试的概率。退避不提供公平性,也不保证事件按业务提交顺序执行。
Worker 用 fixedDelay
调度:上一轮结束后等待配置的间隔,再开始下一轮。一批 50
条事件顺序执行,每条都要等 Redis
超时的话,一轮本身就可能花很久。吞吐规划要看批大小、单条延迟、成功率和
Worker 数量,不能只看 1 秒的调度间隔。
还有两个容易被忽略的细节:
retry()自身是数据库写操作,它也可能失败。外层定时方法捕获数据库异常并记录db_failure,事件仍留在表里,但重试时间没有更新——下一轮会立刻再试,形成更紧的重试节奏。lab.outbox.overdue.seconds读取的是最早的next_at,表示”最早的任务比计划时间晚多久”;它并不等于事件从创建起积压了多久。退避会把next_at推到未来,一个很老的事件也可能暂时显示零逾期。
当前项目没有最大重试次数、死信表、人工重放接口和成功历史归档。生产环境需要补上这些:事件创建时间、错误分类、毒性事件隔离、审计与重放。尤其是安全相关的事件(比如 Token 吊销),不能因为”重试次数太多”就删除,那会让积压指标看起来恢复,实际上安全状态没有落实。
Redis 故障时的自我保护
短超时为什么还不够
缓存客户端已经配置了 300 毫秒超时,这能避免单个请求无限等待,但对持续故障无能为力。用具体数字算一遍:接口每秒 2000 个请求,Redis 不可用,每个请求在缓存层消耗 300 毫秒。
- 每个请求占用一个处理线程 0.3 秒;
- 稳定状态下同时在途的请求数 ≈ 2000 × 0.3 = 600;
- 示例配置的 Tomcat 最大线程数是 64。
几百个并发需求压在 64 个线程上,结果是线程池耗尽、请求排队、响应时间进一步拉长,而 Redis 那边的每一次尝试都注定失败。更糟的是,这些请求在超时之后会集体转向数据库,把故障从缓存层转移到事实源。
短超时只能减少”单次伤害”,还需要一个机制让系统记住刚才已经失败过,在冷却期内直接拒绝新的尝试。这就是熔断。
一个简化熔断器的状态机
熔断器的最小实现是一个三态状态机。
1 | public <T> T call(Supplier<T> work) { |
这段几十行的代码实现了一个完整的三态状态机:
| 状态 | 判定条件 | 行为 |
|---|---|---|
| 关闭(正常) | openUntil == 0 |
所有调用直接执行 Redis 命令 |
| 打开(熔断) | now < openUntil |
快速失败,不再发 Redis 命令 |
| 半开(探测) | 冷却结束,CAS(false, true) 成功 |
只放一个线程去试探,成功则关闭熔断,失败则重新打开 |
几个设计细节:
- 冷却期内所有请求立即失败,不再各花 300 毫秒重新发现同一个事实。这就是熔断与超时的区别:超时限制单次等待,熔断共享失败信息。
- 恢复探测用 CAS 抢占资格,保证冷却结束后只有一个线程去打 Redis,避免”冷却一结束,全部请求同时涌入”。
- 恢复用
compareAndSet(until, 0),只清除自己观察到的那个失败状态,不会把一个更晚发生的失败覆盖掉。 finally里释放探测资格,探测失败时也能让下一轮继续探测。
它的边界也很清楚:只根据单次异常开关,不做滑动窗口统计;一次成功就恢复,不验证整条缓存链路;状态按实例隔离,实例 A 熔断时实例 B 仍会尝试;已经发出的调用不会被取消。生产环境可以在此基础上补充失败率窗口、慢调用阈值、半开探测次数和恢复条件。
这个最小版本解决的核心问题只有一个:让一段时间内的新请求共享已经观察到的失败。
熔断只负责快速失败,不负责成功。它只是尽快宣布”副本暂时不可用”,把请求交给受保护的数据库路径。如果数据库容量不够,仍然要拒绝部分请求。
回源并发保护
1 | public Optional<AppView> load(String tenant, long id) { |
这段代码用 8 个许可给数据库入口加了一道闸门,有三个要点:
第一,用 tryAcquire
立即拒绝,避免阻塞排队。
排队只是把压力从数据库挪到线程池,最终仍会耗尽线程。立即拒绝并返回
503,是明确、可观测的容量信号。
第二,信号量只覆盖本方法的回源读取。
它只覆盖应用配置的回源读取;布隆目录构建、Token 注册与刷新、Outbox
操作走的是别的路径,不共享这 8 个许可。上传校验应用是否存在时调用
apps.load,会共享这份容量。做容量估算时要把这些入口都算进去。
第三,要按实例总数换算数据库的全局并发。 每个 JVM 各有 8 个许可,两个实例就是 16 个并发查询,实例扩容会线性放大。数据库连接池(Hikari 最大 12、获取超时 1 秒)是另一层限制:信号量放行之后,请求还可能在连接池里继续等待。连接获取超时管的是”拿到连接”,不等于 SQL 执行超时,生产环境还需要查询超时、索引与慢 SQL 治理。
演示配置里的 db-delay-ms
用来放大并发窗口,观察限流效果,正常情况下为
0。它只服务于实验,与真实数据库的成本无关。
不同失败用不同状态码
状态码是接口契约的一部分,选择哪个码,决定了客户端应该怎么处理:
| 状态 | 含义 | 客户端建议 |
|---|---|---|
| 400 | 参数不合法 | 修正请求,不重试 |
| 401 | 会话已吊销或无效(由授权检查返回) | 重新登录或刷新凭据 |
| 404 | 对象确定不存在 | 不重试,展示空状态 |
| 409 | 版本冲突 / 同一业务版本内容不同 | 重新读取或修改请求后再提交 |
| 423 | 资源正在处理(上传锁竞争) | 延迟后重试同一个幂等请求 |
| 503 | 容量不足 / 依赖暂不可用 | 有上限、带抖动地重试,并遵守总时间预算 |
重试必须贯穿整条调用链来设计。服务端已经把回源并发限到 8,客户端如果立刻并发重试十次,等于把刚建好的闸门冲垮;网关、SDK、业务代码如果各自加一层重试,实际放大倍数会相乘。
还有一个容易混淆的指标语义:缓存里读到坏 JSON
时,请求会降级回源,但不会触发 Redis
网络熔断,因为解析发生在 Redis 调用成功返回之后。所以
degraded 计数上去了,不一定代表 Redis 宕机,要结合
corrupt、lab.redis.failure
和数据库指标一起判断原因。
缓存故障不必让实例退出
示例的 readiness 分组只包含 readinessState
和数据库,不包含 Redis。理由很直接:配置查询在 Redis
故障时可以受限降级,如果所有实例都因为共享缓存故障而从流量入口消失,反而会把原本能降级的查询变成全面不可用。
这是一个有意识的取舍:实例 ready 表示”我可以提供承诺的基本服务”,不表示”所有依赖都正常”。 上传新操作和授权检查在 Redis 故障时会返回失败,这部分能力损失应该通过业务接口和指标表达;把实例整体摘除并不能恢复这些能力。不同接口共享一个进程时,“一个总体的 UP”本来就无法描述所有能力,运维需要知道的是哪些功能降级了。
管理端口(默认 9081)只绑定本机,show-details: always
方便实验,但生产环境必须限制管理面的访问,避免暴露依赖与配置信息。鉴权和租户权限在这个实验应用里没有完整实现,本地学习可以放开,部署时必须补齐。
客户端连接
最后补充一个容易被忽略的环节:一条 Redis 命令从应用到服务端,连接是怎么被复用的。项目使用 Lettuce,Spring Data Redis 默认共享原生连接,普通操作复用同一条连接上的多个请求。由此可以澄清三个常见误解:
max-active: 8限制的是连接池里可借出的独占连接数量,不代表”普通 GET 最多 8 个并发”。连接池主要服务于需要独占连接的操作,例如部分阻塞或事务场景;- 启动后不一定立刻建立 8 条连接,池按需创建;
StringRedisTemplate的同步调用依然会让调用线程等待结果。底层 Netty 使用异步 I/O,这提升的是网络线程的效率,不改变”请求线程可能阻塞 300 毫秒”这个事实。
客户端还配置了一层主动防御:
1 |
|
自动重连负责恢复连接,REJECT_COMMANDS
让已断开的连接尽快拒绝新命令,requestQueueSize
防止应用把大量命令堆在内存里。128
是本地实验值,需要结合命令大小、并发量、断连时长和可接受的排队延迟来评估。
这些参数控制单次通信与客户端积压,业务熔断控制”是否还值得继续尝试”,两者互补。连接健康也不能只看
PING:网络正常但命令持续变慢、内存写入被拒、Lua
执行时间过长,都会影响真实请求,需要用不同的指标分别解释。容量评估要把实例数、请求线程数、客户端排队和
Redis
执行能力放在一起看,单纯调大连接池可能让更多请求同时压向同一个服务端。
上传场景:锁减少竞争,幂等保护结果
业务幂等键与锁粒度
上传的业务身份是 (tenant, appId, releaseVersion),内容用
contentHash 表示。业务约定有两条:
- 同一版本、同一内容重复提交,返回第一次的平台结果,不重复发布;
- 同一版本、不同内容提交,返回 409,不允许悄悄覆盖。
锁的粒度是应用(upload-lock 只包含
tenant 和
appId),而幂等键的粒度是版本。两者粒度不同,各有业务原因:
- 锁要表达”这个应用正在发布,别的发布先等等”,所以按应用加锁,同一应用的版本 1 和版本 2 也会竞争;
- 幂等键要表达”这个版本的成功结果可以复用”,所以必须包含版本,版本 A 的成功不能当成版本 B 的成功。
contentHash
在这个实验接口里由调用者提供,服务端只校验它是 64
位小写十六进制字符串。真正接入上传时,应由服务端读取文件字节、计算摘要,并限制文件大小与格式——只校验字符串形状,证明不了内容没有被替换。
先查结果,再加锁,再查结果
1 | Result existing = find("upload_result", tenant, appId, version); |
这个流程里有三层保护,分别处理不同的问题:
- 第一次查询:已经成功过的上传不需要抢锁。Redis 故障期间,重复的相同上传仍然可以从数据库返回结果,这是”安全路径不依赖缓存”的一个正面例子。
- 第二次查询:第一次查询到拿到锁之间,别的请求可能已经完成了上传。所以需要查一下
- 唯一约束冲突处理:租约可能在处理过程中过期,另一个执行者先写入了结果。数据库唯一约束拒绝第二次插入,代码捕获冲突后读取已有结果并校验内容。锁是正常路径的竞争优化,唯一约束才是资源的最终边界。
Token 吊销
JWT 的优势与撤销的代价
JWT 的卖点是”无状态”:签名验证通过后,服务端在一段时间内不需要查询会话状态。但用户退出、管理员封禁、账号风险处置都要求提前撤销一个尚未过期的 Token。常见的加速方案是用 Redis 维护吊销黑名单:命中就拒绝,未命中就放行。
问题恰恰出在”未命中就放行”上。黑名单是异步补偿的(数据库先记录事实,再由 Outbox 写 Redis),补偿尚未执行时,一个已被吊销的 Token 仍然会 miss;Redis 故障时,黑名单整体不可用。如果把这些情况都解释成”未吊销”,安全策略就被一次网络失败绕过了。
所以这个示例把会话数据库作为事实源,Redis 只是加速结构。
会话表:先有事实,再有缓存
会话表记录 (tenant, digest)、过期时间和
refresh_blocked。原始 jti 先经 SHA-256
转成摘要,再进入键和日志:
- 摘要避免原始 Token 标识直接出现在键名、日志和监控里;
- 摘要只做标识,不做加密,知道输入的人仍能算出相同摘要,它不替代签名验证;
- 真实系统必须先完成 JWT 验签、发行方与受众校验,再使用其中可信的 jti 和 exp。
注册采用 INSERT,遇到重复主键返回 409,避免覆盖式写入把
refresh_blocked 改回 false。这个选择防的是”重复注册同一个
jti 把已吊销的会话复活”。演示还限制有效期必须在未来 24
小时内,用来控制实验数据规模,不是通用身份系统的标准。
单位是一个隐蔽的坑:JWT 的 exp
通常是秒级时间戳,而示例的 expiresAt 明确用毫秒。对接真实
Token
时必须在输入边界做转换,并考虑时钟偏差。把秒当作毫秒会立即过期,把毫秒当作秒会得到极长的生命周期。
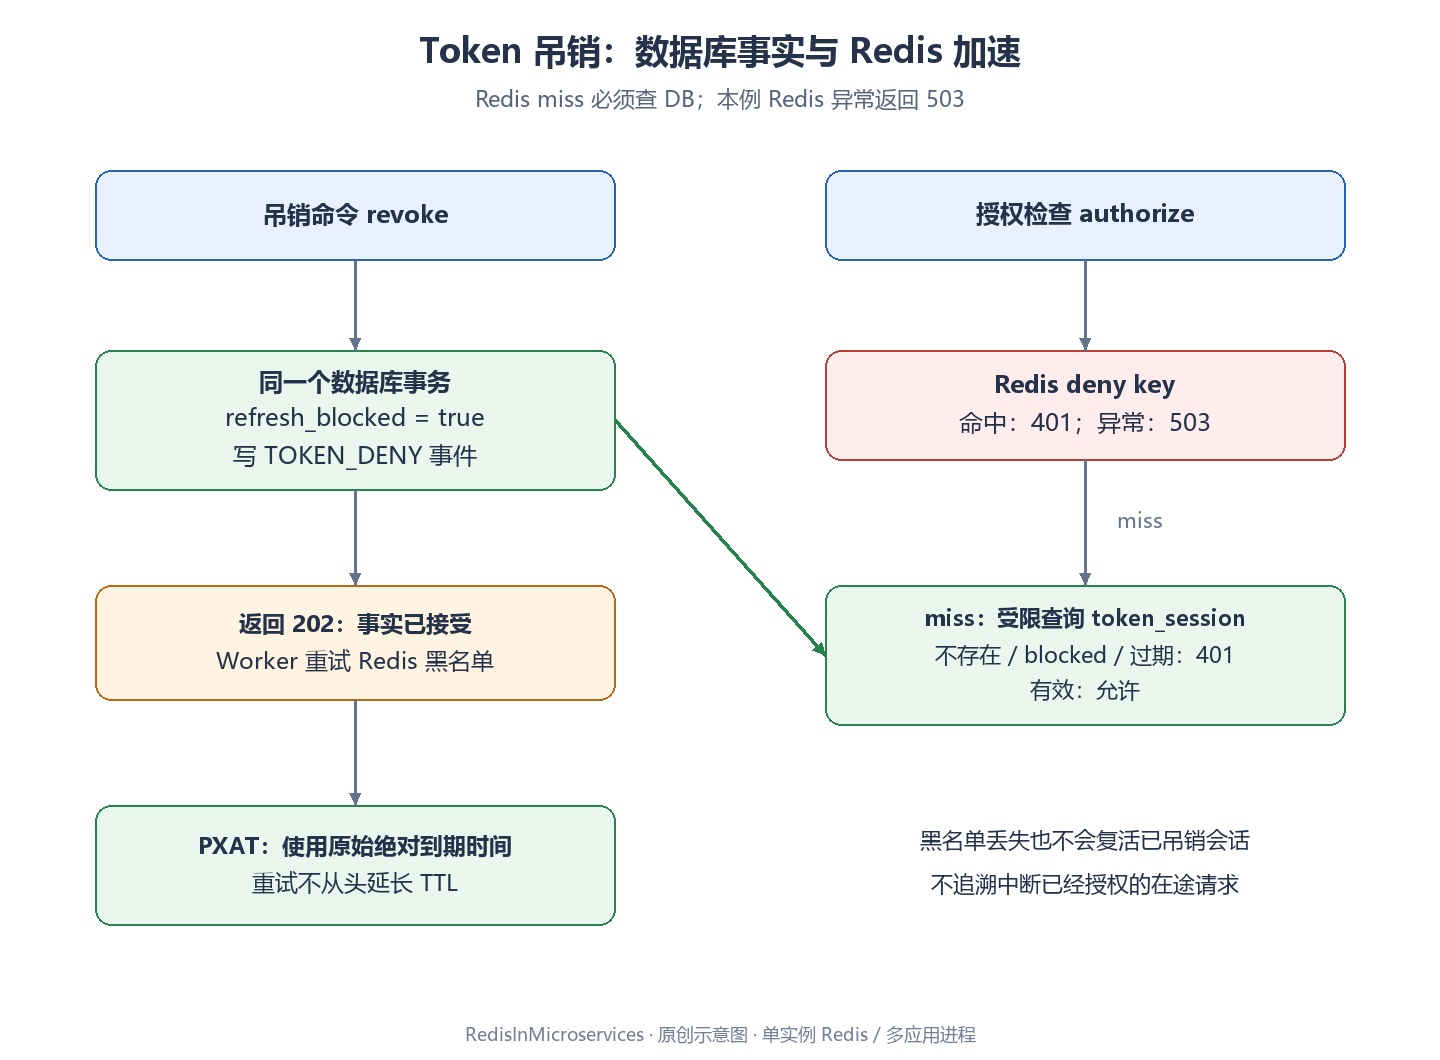
吊销:先提交事实,再异步补偿黑名单
1 | public void revoke(String tenant, String jti) { |
吊销返回 202,含义是”吊销事实与补偿任务已经被接受”;Redis 黑名单可能还没写好。此时数据库已经标记 blocked,刷新检查会拒绝;Redis 故障期间吊销依然可以提交,因为写入动作不需要同步访问 Redis。重复吊销会产生额外事件,但 blocked 不会回到 false——业务效果可重复。
授权检查:两层判断,未知不放行
1 | public void authorize(String tenant, String jti) { |
判断顺序是”先 Redis,再数据库”:命中黑名单是最快的拒绝路径;未命中时必须查数据库,因为黑名单可能还没补偿。Redis 调用异常会发生在信号量与数据库查询之前,由统一异常处理返回 503——项目选择了保守策略,不把”不知道”解释为”没吊销”。
删除黑名单键后再授权,数据库仍然会拒绝,说明安全性不依赖 Redis
键的存活。代价是正常 Token 每次未命中都要查库,授权吞吐不再是纯 Redis
吞吐;这份数据库读取由 8 个许可保护,它是 Token 服务自己的信号量,与
AppRepository
的回源许可相互独立。refreshAllowed
直接查数据库,没有经过同一个信号量,生产环境应该统一评估所有安全状态入口,不能只保护其中一个方法。
吊销也无法追回”已经通过检查、正在执行”的请求。需要更强撤销语义时,要在关键业务提交点再次检查状态,或者明确会话撤销的生效边界。如果生产数据库使用滞后的只读副本,立即拒绝的承诺也会被打折扣,这属于读一致性问题,示例没有覆盖。
绝对到期时间
1 | -- deny-extend.lua:ARGV[1] 是数据库中的绝对到期时间,单位毫秒。 |
如果每次补偿都写 PX 60000,一个原本 60 秒后过期的 Token
会在每次重试时被重新计时,生命周期被不断延长。用数据库里的绝对截止时间,5
秒后重试只剩 55 秒,10 秒后重试只剩 50 秒,截止时间不随重试漂移。
脚本的细节:
- 用 Redis 的
TIME计算当前毫秒时间,以PXAT写入绝对到期时间(SET ... PXAT从 Redis 6.2 起可用,本项目运行在 7.2 上); PTTL对不存在的键返回 -2,对没有 TTL 的键返回 -1,都小于正的剩余时间,因此会为它建立有边界的过期状态;- 已经保留更久的键不会被缩短;
- Token 已过期时直接返回 1,表示”补偿目的已不再需要”,避免产生一次
SET。Java Worker 因此可以正常删除这条事件,数据库的过期校验仍会拒绝它。
Lua 的工程化:小脚本、固定参数、明确返回
脚本对象缓存与执行机制
脚本的第一件事是交付:文件放在 classpath 的 lua/
目录,Java 侧缓存脚本对象,执行时再传入明确的参数。
1 | private static final ConcurrentHashMap<String, DefaultRedisScript<Long>> SCRIPTS |
项目把脚本文件放在 classpath 的 lua/ 目录,Java 侧缓存
DefaultRedisScript 对象,每次调用传入明确的
KEYS 和
ARGV,不为每个请求拼接不同的脚本文本。
这样做有三个好处:脚本可复用、便于审查、参数协议固定。
执行层面上,Spring Data Redis 会先按脚本摘要尝试
EVALSHA,服务端没有这份脚本时回退到 EVAL
加载再执行。由此可知,Java 侧缓存了脚本对象,不代表 Redis
永远记得这份脚本。脚本缓存只存在于服务端内存,Redis
重启后需要重新加载。脚本文件必须随应用一起交付,恢复流程不能依赖管理员手工预加载。
七个脚本,各负责一件事
项目一共七个 Lua 脚本,每一个都只承担一个很小的原子动作:
| 脚本 | 作用 | 返回协议 |
|---|---|---|
unlock.lua |
比较所有者后删除锁 | 1 删除成功,0 不是自己的锁 |
cache-publish.lua |
校验锁所有者与失效代际后写缓存 | 1 发布成功,0 被拒绝 |
cache-invalidate.lua |
推进代际并删除缓存 | 固定 1 |
bloom-add.lua |
一个元素的七个位置置位 | 固定 1 |
bloom-check.lua |
校验签名与位图后查询成员 | 0 拒绝,1 可能,-1 不知道 |
bloom-activate.lua |
校验构建者后原子替换位图 | 1 成功,0 被拒绝 |
deny-extend.lua |
按绝对到期时间写黑名单 | 固定 1 |
它们共同遵守三条工程纪律:
- 脚本要短。 脚本执行期间 Redis 的主线程被占用,长脚本会阻塞所有其他命令。数据库查询、HTTP 调用、大规模业务计算都不应该放进 Lua,脚本里也不能访问本地 Java 服务。
- 参数走
KEYS和ARGV。 键名和参数通过参数传入,脚本文本保持稳定,摘要稳定、可审查。 - 返回协议简单明确。 统一使用
Long,用0/1/-1表达结果,Java 侧对每个值有确定的处理分支。
原子边界只覆盖 Redis 内部
前面几章反复出现同一个模式:客户端先读、再判断、再修改,两步之间状态可能变化。把它们塞进同一个 Lua 脚本,检查和修改之间就不会插入其他客户端的命令:
- 解锁时”读 owner 再 DEL”;
- 发布时”读 owner、读代际、再 SET”;
- 失效时”INCR 代际、DEL 缓存”;
- 激活布隆时”校验构建者、RENAME、写签名”。
这就是 Lua 在缓存设计里的核心价值:把判断依据和修改动作绑定在同一次 Redis 执行中。
但它不等同于数据库事务:脚本执行到一半出错时,已经执行的 Redis 写操作不会自动回滚;脚本原子性也只在 Redis 内部成立,无法让数据库与 Redis 一起提交。所以脚本应该”先做完所有检查,再做少量有边界的修改”,把可能失败的逻辑放在前面,把副作用控制在很小的范围里。
持久化与内存策略
先分类,再持久化
持久化配置不能一刀切,因为不同数据丢失后的后果完全不同:
| 数据 | 丢失后的后果 | 合理的保护方式 |
|---|---|---|
| 应用配置缓存 | 性能下降,可重建 | 可以不持久化 |
| 布隆位图 | 过滤器未就绪,必须停止”确定不存在”的判断 | 可重建,重建期间降级 |
| 失效代际 | 旧快照可能被发布(8.6 节的 ABA) | 持久化 + 不淘汰 |
| Token 吊销黑名单 | 拒绝变慢,但数据库仍是事实源 | 持久化,数据库兜底 |
| 上传锁、重建锁 | 孤儿锁最多存活一个租期 | 不需要持久化 |
示例提供两份配置:redis-state.conf
作为主实验配置(包含状态元数据),redis-cache.conf
作为纯缓存对照(关闭持久化、允许淘汰)。它们是两个独立实例的模板,应用并没有配置两个连接工厂自动路由——主应用默认连接
6380 的 state 实例,所有键共享同一套策略。
还有一点,Redis 的逻辑数据库编号不能隔离持久化和内存策略。把缓存放在
DB 0、黑名单放在 DB 1,不会让两边拥有独立的 AOF 配置或
maxmemory
上限。要按数据角色使用不同策略,必须部署独立实例并分别配置客户端。
RDB、AOF 与 fsync
三种机制解决三个不同的问题:
| 机制 | 做什么 | 恢复时的代价 |
|---|---|---|
| RDB | 某个时间点的全量快照 | 两次快照之间的写入可能丢失 |
| AOF | 记录重建数据所需的写命令,恢复时重放 | 文件更大,恢复更慢,需要重写整理 |
| fsync | 控制 AOF 何时真正同步到存储介质 | 决定故障时最多丢多少写入 |
appendfsync everysec
用后台线程每秒同步一次,通常可以获得较小的丢失窗口,但它无法承诺”任何机器、任何磁盘、任何故障下都严格不超过
1 秒”。操作系统缓存、磁盘缓存和虚拟化层都会影响真实落盘时间。
主配置的关键项如下:
1 | save 900 1 |
几个容易误读的地方:
save 900 1表示”900 秒内至少有 1 次变化”才触发快照,到点但没有变化时不会拍照;- AOF 重写(rewrite)用更紧凑的表示整理日志,控制恢复成本和文件增长,它和 fsync 是两件事,不能把”正在重写”理解为”已经更持久”;
no-appendfsync-on-rewrite no表示重写期间不跳过原有的 fsync 策略;- Redis 7 的 AOF 由基础文件、增量文件和 manifest
组成,恢复和备份要按实际目录结构处理,不能只找一个旧教程里的
appendonly.aof; - AOF 的基础文件可以是 RDB
格式(
aof-use-rdb-preamble),这不代表关闭了 AOF。
排查持久化状态时,应该结合配置、数据目录和
INFO persistence 一起看,只凭文件扩展名容易猜错。
noeviction 的取舍
主配置选择
noeviction:内存达到上限后,不主动淘汰键,而是拒绝需要分配内存的写操作。这保护了代际、锁、黑名单这些”丢了会破坏协议”的元数据,代价是写操作可能失败:
- 缓存发布失败会被记录,本次请求仍返回数据库结果;
- Outbox 写 Redis 失败会重试,任务可能逐渐积压;
- 数据库里的权威状态不受影响,但任务时效性和系统性能会下降。
纯缓存对照配置则使用
allkeys-lfu,允许按访问频率近似淘汰对象。它只适合可重建的纯缓存数据;如果把这套配置直接用于代际和协调状态,元数据被淘汰可能破坏
8.6
节的前提。项目保留这份模板是为了做对照实验,不建议不加分析地整体切换。
最后把三个维度分开记住:
- 过期由键的 TTL 决定;
- 淘汰由内存压力和淘汰策略决定;
- 持久化解决进程重启后的数据恢复。
三者互相独立,需要分别配置。
常见误区与延伸设计
主线讲完,最后处理几组经常被混为一谈的概念。它们都值得单独成篇,这里只讲清边界,避免在设计时选错工具。
为什么没有直接用
@Cacheable
Spring Cache 的注解适合表达简单的读缓存、写缓存和失效规则,但本项目的读链路需要显式处理:布隆三态、跨 JVM 重建、短空值、代际发布校验、锁等待拒绝、Outbox 补偿。把这些全部藏进注解后面,异常分支和协议边界会变得不可见,也不利于逐个验证。
这并不说明注解不适合生产。更常见的做法是分层:稳定的序列化、键规范、简单查询用
Spring
Cache;需要特殊一致性协议的路径保留显式实现。使用注解时仍要理解代理调用与自调用、缓存管理器配置、空值策略,以及框架的同步加载是否真的覆盖跨进程——sync=true
解决的是单 JVM 内的并发;两个实例之间的竞争仍需另外处理。
逻辑过期与返回旧值
另一种热点防护是逻辑过期:缓存里保存一个业务过期时间,物理 TTL 设置得更长。请求发现逻辑上已过期时,先返回旧值,同时让一个受限的后台任务去刷新。它把”到期瞬间的等待和 503”换成了”短暂返回旧值”,对新闻、商品详情这类允许短暂陈旧的场景很实用。
代价同样明确:用户可能看到旧数据;后台刷新需要线程池、刷新锁、失败重试,还要定义”旧值最多能旧多久”。权限配置、风控策略这类数据不适合这个方案。示例项目选择了物理 TTL + 有限等待 + 同步重建,是因为教学目标是展示协议本身;两种方案没有绝对优劣,区别在于把不确定性放在等待上,还是放在新鲜度上。
本地缓存与多级失效
在 get 前面加一层 Caffeine 能减少 Redis
往返,但会引入一个更难处理的问题:多个 JVM
各自保留本地副本,Redis 里的失效不会自动删除它们。
广播失效消息可能丢失,本地 TTL
又会让不同实例在不同时刻看到不同值。如果要做 L1 本地 + L2 Redis +
数据库,需要重新定义:
- 本地副本的失效传播机制(消息、版本号、短 TTL);
- 命中指标的口径(本地命中会绕过 Redis 代际读取);
- 容量分配和更新窗口。
“在最前面加一个 Map”不会让原协议自动成立。本项目没有实现 Caffeine,因此文中两 JVM 的验证结果不包含本地缓存一致性。
限流、防重放、分布式锁、业务幂等
这四个概念都可能用 Redis 实现,但状态模型完全不同:
| 概念 | 控制什么 | 典型实现 | 失败时的语义 |
|---|---|---|---|
| 限流 | 一段时间内允许多少请求 | 固定/滑动窗口、令牌桶 | 超出配额直接拒绝 |
| 防重放 | 同一个可信请求是否被再次接受 | nonce + 时间窗口 + 原子消费 | 重复请求拒绝 |
| 分布式锁 | 一段时间内谁占用资源 | SET NX PX + 所有者校验 |
抢不到等待或失败 |
| 业务幂等 | 重复执行是否得到一致结果 | 业务唯一键 + 结果记录 | 返回第一次的结果 |
上传幂等没有限制”一秒内能提交多少不同版本”,回源信号量与用户级频控无关。如果业务需要限流,应按租户、接口、用户设计配额,并明确
Redis
故障时的策略;防重放需要可信签名、时间窗口和原子消费,只拿用户可随意填写的
requestId 做 SETNX,并不能解决安全问题。
参数能不能在线改
LabSettings
的字段可变,不代表运行中的组件会随之重建。最典型的是
AppRepository:信号量在构造时按
fallbackConcurrency
创建,之后修改配置字段不会改变已有的许可数量,而 Gauge
又按配置字段计算占用,可能和实际许可数对不上。测试保持参数不变,避免了这种偏差。
生产中要把参数分成三类:可以热更新的(超时、日志级别)、必须重建组件的(信号量、线程池、连接池)、必须走协议升级的(布隆容量与哈希次数)。第三类尤其危险,它们属于数据协议,修改必须伴随版本与重建,一次配置推送并不够。
用一组问题检查是否真正掌握
先不看源码回答,再回到对应章节验证。重点在于说清触发条件、执行顺序和失败后的结果,名词是次要的。
为什么空值缓存和布隆过滤器要同时存在? 空值缓存挡住”同一个不存在 ID”的重复查询,布隆挡住”大量不同不存在 ID”的流量;过滤器未就绪或误判时,仍需要负缓存和有限回源兜底。
重建锁和失效代际为什么不能互相替代? 锁约束”同一时刻谁来重建”,代际拒绝”查询期间发生过失效的旧快照”;发布时还要校验锁所有者,三者解决三个不同问题。
更新成功后立刻读取,一定是新值吗? 不一定。Outbox 是异步补偿,204/202 只表示意图已接受,提交与失效执行之间存在可见性窗口。协议是带补偿的最终一致。
为什么用 Lua 而不是”先 GET 再 SET”? 检查与修改之间不能插入其他客户端命令。脚本提供 Redis 内部的原子执行边界,但它只覆盖 Redis,出错时不会回滚已执行的写操作,也无法让数据库与 Redis 一起提交。
锁过期后,旧执行者还会继续运行吗? 会。Redis 不会中断 Java 线程。缓存靠发布脚本校验 owner 与代际,上传靠唯一约束和平台幂等,严格顺序还需要资源端校验 fencing token。
Redis 故障时,为什么缓存可以回源,授权却返回 503? 数据的业务角色不同:缓存是可重建副本,授权状态的事实源在数据库,而”黑名单未命中”在 Redis 不可用时无法解释为”未吊销”。未知状态不能放行。
Outbox 为什么不是恰好一次? Redis 执行成功与事件删除之间存在中断窗口,多个 Worker 也可能重复领取。副作用必须设计成可重复执行。
布隆理论上没有假阴性,为什么位图丢失后必须放行? “没有假阴性”依赖结构完整与算法一致;结构丢失时,用三态返回把”不知道”和”不存在”分开。
连接池配了 8,为什么普通 GET 的连接数不是 8? Lettuce 默认共享原生连接,多个命令复用同一条连接;连接池主要用于需要独占连接的场景(阻塞操作、事务)。池大小也不等于服务端执行线程数。
AOF
everysec能让 Outbox 不再必要吗? 不能。持久化解决 Redis 自身的数据保存与恢复,Outbox 解决跨系统”提交之后还要做什么”的补偿意图,两者针对不同失败窗口。pending为零能证明所有更新都强一致吗? 只能说明当前没有未删除的补偿任务,无法证明历史读窗口、已返回的旧值或未被监测的路径。这个实践适合在面试里怎么讲? 讲业务背景、自己补的实验、实际代码和本机证据;区分哪些是实习中参与的工作、哪些是后来补做的验证;不要把本地结果说成线上指标,也不要省略适用条件。
附录 A:动手复现
以下命令从项目根目录执行。Redis 使用项目专用目录和 6380 端口,不会覆盖安装目录的全局配置;端口被占用时脚本会拒绝启动。
1 | Set-Location 'D:\WorkSpace\PersonalLearn\DBLearn\RedisLearn\demo\RedisInMicroservices' |
观察读链路时,记录操作前后的计数差值,而不是只看计数是否大于零:
1 | $base = 'http://127.0.0.1:8080/api/tenants/demo' |
更新一次配置,观察 Outbox 与代际推进:
1 | $current = Invoke-RestMethod "$base/apps/1001" |
上传与 Token 实验:
1 | $hash = 'a' * 64 # 演示用声明值,不是对文件计算出的摘要 |
自动验证:
1 | # 需要 Redis 已启动 |
一个真实的排查经验:在 Windows 的 MSYS 版 redis-cli
里,{demo} 可能被 shell 展开成
demo,导致命令行查到的键和 Java
写入的键不一致。项目用包装脚本临时设置
MSYS=noglob,因此上面的命令统一走
redis-cli.ps1。查不到键不等于没有写入:先核对地址、端口、逻辑
DB、命名空间、完整键、编码与参数变换,再怀疑 TTL
和时间窗口。位图也不要当 JSON 用 GET
后分析,应该用位操作、STRLEN 和 ready 签名确认状态。
附录 B:源码索引
路径相对于 markdown/ 目录,与文章同级的
demo/RedisInMicroservices 是项目根目录。
| 内容 | 位置 |
|---|---|
| 完整配置 | application.yaml |
| 数据表与种子数据 | schema.sql |
| 参数绑定 | LabSettings |
| 键协议 | KeySpace |
| Redis 客户端配置 | RedisClientConfiguration |
| Lua 加载与执行 | Lua 与 脚本目录 |
| 查询主链路 | AppCacheService、AppView |
| 有限事实读取 | AppRepository |
| 布隆生命周期 | AppBloomFilter |
| 更新事务 | AppCommandService |
| 有限租约锁 | RedisLease |
| 熔断与异常 | CacheRedis、CacheUnavailable |
| 补偿存储与执行 | OutboxStore、OutboxWorker |
| 上传与 Token | UploadService、TokenStateService |
| HTTP 入口与异常 | AppController、StateController、ErrorHandler |
| 集成断言 | ProductionScenariosTests |
| 双 JVM 验证 | verify_http.py |
| 持久化对照 | verify-persistence.ps1 |
| 验证记录与复盘 | docs/07-验证记录与面试复盘.md |
附录 C:设计决策速查
| 问题 | 采用的方案 | 付出的代价 | 不适用的情况 |
|---|---|---|---|
| 不存在的对象被反复查询 | 空值缓存 + 布隆三态 | 新对象最多延迟一个空值 TTL 可见;需要维护目录 | 目录频繁增删 |
| 热点键到期 | 按对象的租约锁 + 二次检查 + 等待预算 | 部分请求等待后 503;租期要覆盖查询尾延迟 | 查询远慢于租期 |
| 大量键同时失效 | TTL 抖动 | 缓存寿命不完全可控 | 需要精确同时失效 |
| Redis 整体故障 | 熔断 + 回源并发上限 + 明确 503 | 部分请求失败,本地状态各自为政 | 数据库容量不足 |
| 旧快照回填 | 代际 + 锁所有者双条件发布 | 每个失效对象一个无 TTL 元数据键;代际丢失有 ABA 风险 | 需要严格实时一致的读 |
| 更新后的缓存失效 | Outbox + 至少一次重试 | 可见性延迟、补偿治理、死信处理 | 需要同步强一致 |
| 重复上传 | 应用级锁 + 版本级幂等键 + 唯一约束 | 锁竞争返回 423;平台需支持幂等 | 外部平台没有幂等能力 |
| Token 吊销 | 数据库事实源 + Redis 黑名单加速 | 正常请求每次 miss 都查库 | 极高吞吐 + 可接受风险 |
| 进程重启后的状态 | noeviction + AOF everysec |
写入可能被拒;极端故障仍有丢失窗口 | 纯缓存数据 |
附录 D:官方资料
- Redis SET:NX 与过期参数
- Redis 分布式锁模式:所有者与租约
- Redis Lua:执行边界与脚本参数
- Redis SETBIT:位图操作
- Redis EXPIRE:过期与时间
- Redis 持久化:RDB、AOF 与重写
- Redis SLOWLOG:服务端执行计时
- Spring Data Redis:驱动与连接
- Spring Data Redis:脚本执行
- Spring Framework:编程式事务
一句话总结:缓存是”用一份可重建的副本换取性能”,而这份副本靠一套协议维持正确——键与格式统一、失效可推进、旧快照可拒绝、故障可观测、结论可验证。把协议想清楚,缓存才会从”加上去的性能”变成”可控的工程”。
至此,Redis 系列,完结了