前言
我们一直在用 Netty,是一直把它当成一个整体:启动一个 ServerBootstrap,挂几个 Handler,然后发消息、收消息。用起来是这样的,但是当出现问题,什么出现回调顺序不对、消息没到业务、写出去的数据卡住这类问题,只靠 API 文档很难解释清楚,就需要我们把 Netty 拆成一个个模块来看
哦别忘了这个。
| 对象 | 它负责什么 | 阅读时最容易混淆的地方 |
|---|---|---|
ServerBootstrap / Bootstrap |
保存启动配置,组织 Channel 的创建、初始化、注册、绑定或连接 | 它们不持续执行后续每一次 Socket 读写 |
Channel |
表示网络端点,提供状态、配置、Pipeline 和异步操作入口 | 监听端口的 Channel 与客户端连接的 Channel 是不同对象 |
EventLoopGroup |
管理多个 EventLoop,为注册的 Channel 选择一个 EventLoop | 不会为每个请求重新分配线程 |
EventLoop |
执行 Channel 的 I/O 处理、普通任务和到期的定时任务 | 一般同时管理多个 Channel |
ChannelPipeline |
组织该 Channel 的 Handler,并传播事件和操作 | Pipeline 本身不是线程池 |
ChannelHandler |
处理某类事件,例如解码、业务逻辑或写出转换 | Handler 能否共享、是否会阻塞,需要单独判断 |
ChannelHandlerContext |
记录 Handler 所在位置、执行器和传播入口 | ctx.write() 与 channel.write()
的起点不同 |
ChannelFuture / ChannelPromise |
表示某次异步操作的结果;Promise 还能设置结果 | “操作完成”不等于所有后续事件都处理完 |
ByteBuf |
保存字节、读写索引和引用计数等信息 | Java 对象仍然可达,不代表其底层内存仍可使用 |
ChannelOutboundBuffer |
保存已经到达 Channel 底层写入口、尚未完全写出的消息 | 它与操作系统的 TCP 发送缓冲区不是同一块缓冲区 |
注意到,本文所说的 Unsafe,指 Channel
内部的底层操作接口,例如
register、bind、write、flush、close。它不是这里业务代码应当调用的
API,也不是 sun.misc.Unsafe。
这一篇读 Netty 4.2.17 的源码,从一条连接怎么走入手,把 Netty 运行时拆成八层:启动、EventLoop、任务与 Promise、读、写、Pipeline 传播、编解码、内存分配与关闭。每一层都从源码的入口方法开始,跟着调用链往下走
读完应该能回答下面这些问题:
| 问题 | 源码入口 | 对应实验 |
|---|---|---|
bind() 之后,端口是在哪个线程、哪一步真正绑定的 |
AbstractBootstrap#bind/doBind/initAndRegister |
StartupWalkthrough |
| accept 出来的子 Channel 是谁注册到 worker 的 | NioServerSocketChannel#doReadMessages、ServerBootstrapAcceptor#channelRead |
StartupWalkthrough |
客户端 connect() 的
DNS、超时、channelActive 顺序 |
Bootstrap#doResolveAndConnect、AbstractNioChannel#connect |
AsyncConnectDemo |
| EventLoop 一轮循环到底做了什么,任务队列和定时任务怎么排 | SingleThreadIoEventLoop#run、SingleThreadEventExecutor#runAllTasks |
EventLoopWalkthrough |
Promise 的 listener 在哪个线程执行,await
为什么会死锁 |
DefaultPromise#addListener/notifyListeners/checkDeadLock |
PromiseWalkthrough |
读事件怎么变成 channelRead,接收缓冲区怎么自适应 |
AbstractNioByteChannel#read、RecvByteBufAllocator |
ReadWriteWalkthrough |
write 和 flush 到底谁在写
Socket,水位线怎么触发 |
AbstractChannel#write/flush、ChannelOutboundBuffer |
ReadWriteWalkthrough |
Handler 是什么时候被 handlerAdded
的,为什么可能延迟 |
DefaultChannelPipeline#internalAdd、ChannelInitializer |
PipelineAddWalkthrough |
| 入站和出站为什么方向相反,tail 为什么能兜底释放 | AbstractChannelHandlerContext#findContextInbound/Outbound |
PipelineWalkthrough |
| 解码器怎么从半截字节里解出完整消息 | ByteToMessageDecoder#channelRead/callDecode |
DecoderWalkthrough |
| HTTP 解码器怎么处理请求行、头和 body | HttpObjectDecoder#decode |
HttpObjectDecoder 源码阅读 |
| 池化内存到底池化了什么,引用计数释放时发生了什么 | PoolArena#allocate、AbstractReferenceCountedByteBuf#release |
part3 的 ByteBuf 实验 + 源码 |
close() 之后为什么先 channelInactive 再
channelUnregistered |
AbstractUnsafe#close/deregister |
CloseWalkthrough |
| 4.2 和 4.1 的类名、API 到底差在哪 | NioEventLoop、NioIoHandler、Pipeline
flatten |
版本对照表 |
源码基于 Netty 4.2.17.Final。
读源码前的准备
版本与源码结构
先固定版本。Netty 4.2
做了一次比较大的模块和事件循环重构,很多旧文章里的
NioEventLoop.run、ioRatio 在 4.2
已经换了位置甚至被移除。本文以 4.2.17.Final 为准,4.1
只在对比时出现。
4.2.17 的源码按模块拆开,读启动和事件循环主要看:
transport:Bootstrap、Channel、Pipeline、EventLoop、EventLoopGroup;buffer:ByteBuf;codec-base:ByteToMessageDecoder、LengthFieldBasedFrameDecoder、String 编解码;handler:IdleStateHandler、SslHandler、WebSocket 等;codec-http:HTTP 编解码器。
六层运行时
Netty 的源码看起来庞大,也确实很庞大,真正和一次请求相关的主线可以拆成六层:
- 启动:
bind/connect→ 创建 Channel → 初始化 Pipeline → 注册 EventLoop → 绑定/连接; - 事件循环:
select等待事件 → 处理就绪 key → 跑任务队列与定时任务; - 读写:读到的字节进 Pipeline,写出的对象经 Pipeline 进
ChannelOutboundBuffer,flush 才写 Socket; - 传播:Context 双向链表、executor 切换、head/tail 兜底;
- 编解码:累积、拆帧、编码、HTTP/WebSocket/TLS 等协议 Handler;
- 资源与生命周期:Promise、ByteBuf 引用计数、内存池、close/deregister。
Pipeline 是贯穿六层的结构
类地图,几条继承关系
1 | Bootstrap / ServerBootstrap |
后文的顺序也按运行的顺序来
1 | 配置启动参数 |
启动链路
bind 不是一步完成的
ServerBootstrap.bind(...) 返回
ChannelFuture,表示这次绑定操作的结果。因为是
Future,所以说,调用返回时,操作可能仍在进行,因此不能用 方法已经返回
判断端口已经绑定成功。
ServerBootstrap.bind(port) 最终会走到
AbstractBootstrap.bind(SocketAddress):
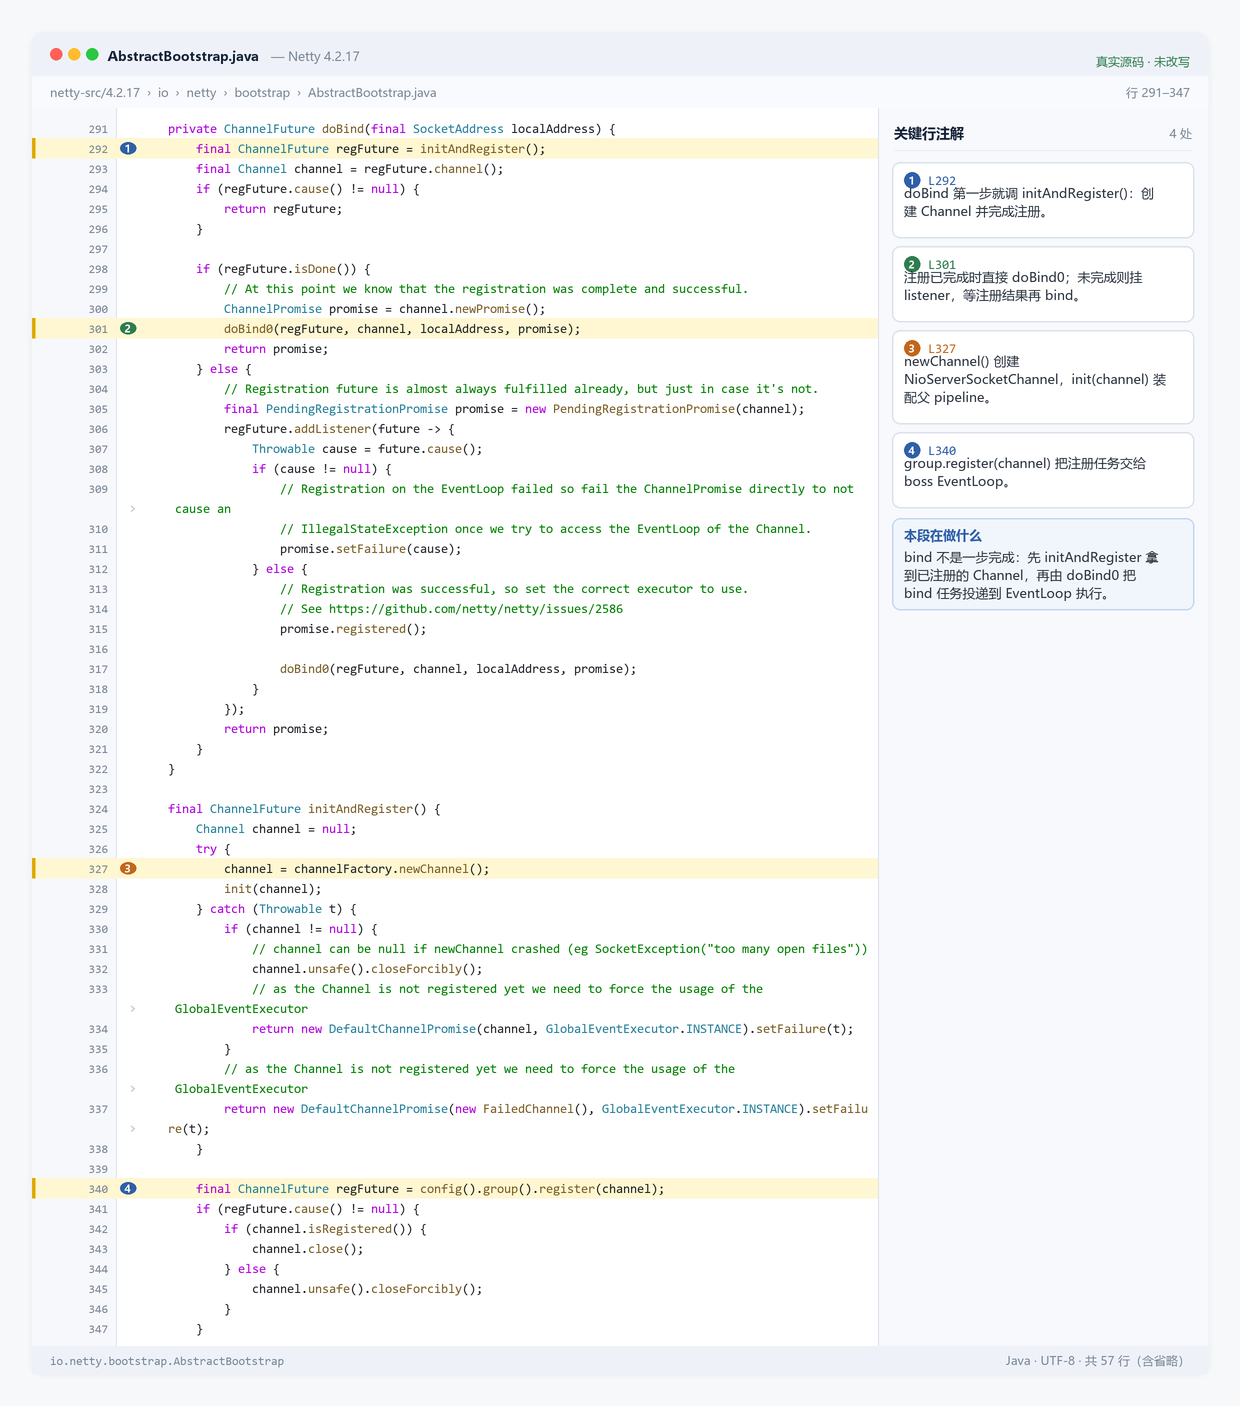
这段代码只做了两件事:initAndRegister() 创建并注册
Channel,然后 doBind0(...) 在 EventLoop 线程里执行
channel.bind(...)。
这里有一个容易忽略的顺序:initAndRegister() 返回的
regFuture 完成时,Channel 已经注册到 EventLoop,但
channelActive 还没有触发;doBind0 把
channel.bind 提交到同一个 EventLoop
的任务队列,绑定成功后才会
pipeline.fireChannelActive()。所以 注册完成 和 端口可用
是两个阶段。
initAndRegister 本身也很短:
1 | final ChannelFuture initAndRegister() { |
channelFactory.newChannel()
不是反射调无参构造那么简单。ReflectiveChannelFactory
在构造时缓存 Constructor,newChannel()
只做一次 constructor.newInstance(),失败时包装成
ChannelException。所以自定义 Channel 时,类必须是
public、有无参构造,否则启动阶段就会失败。
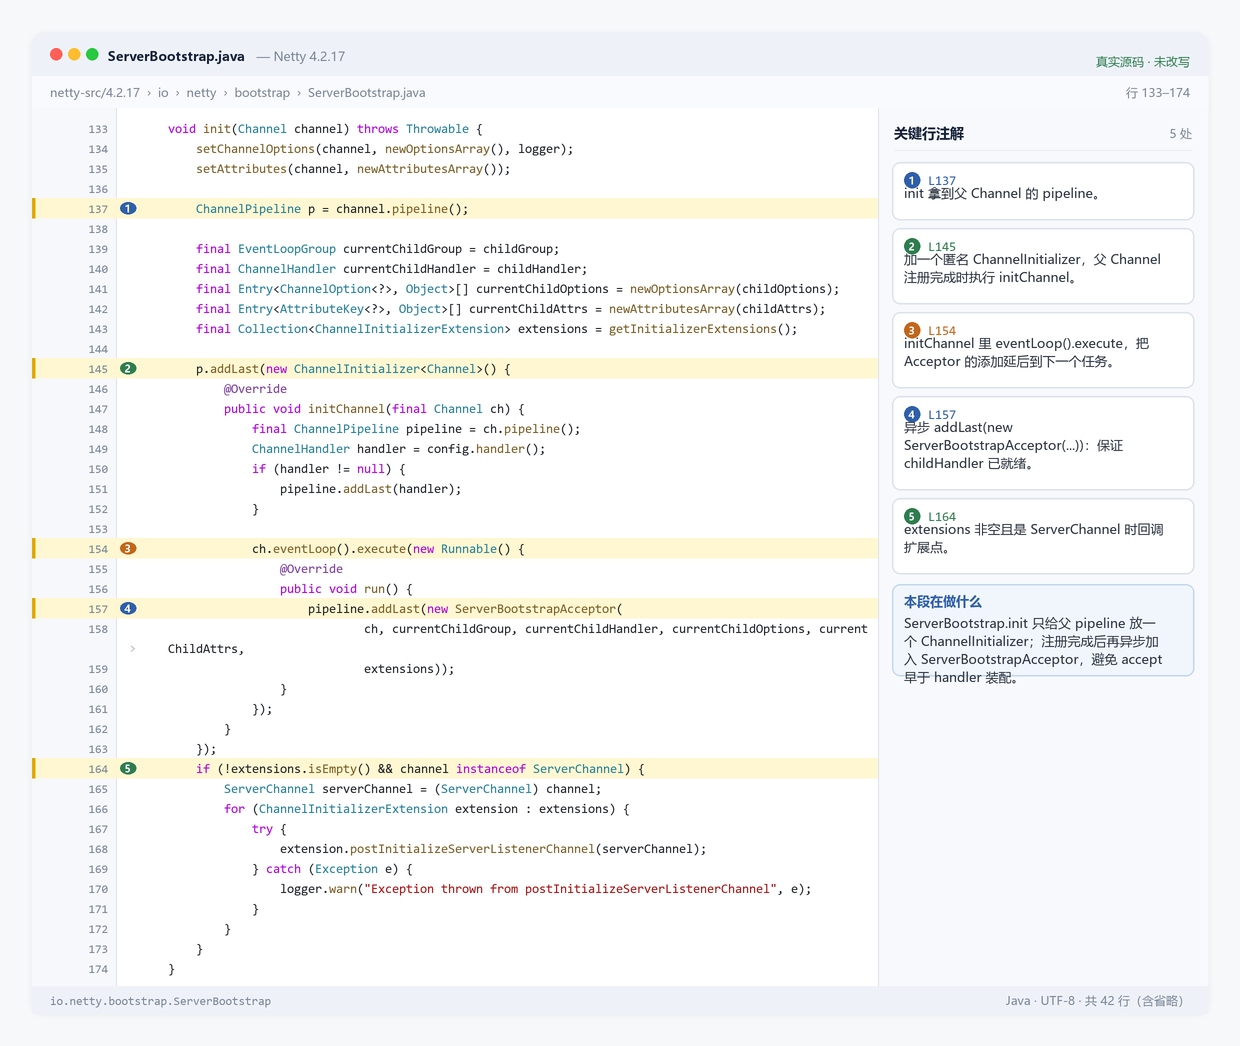
init(channel) 在 ServerBootstrap
里被覆写,负责给父 Channel 加 Handler,以及把
ServerBootstrapAcceptor 加进去:
1 | p.addLast(new ChannelInitializer<Channel>() { |
注意 acceptor 不是直接在 init 里
addLast,而是通过 ch.eventLoop().execute(...)
加进去。因为 init 可能在 main 线程执行,而 Pipeline
的修改要发生在 Channel 所属的 EventLoop 上。这个细节解释了为什么“父
Channel 的 Pipeline 里能看到 ServerBootstrapAcceptor”,但断点停在
ServerBootstrap.init 时它还不在链表里。
ChannelInitializer 什么时候执行
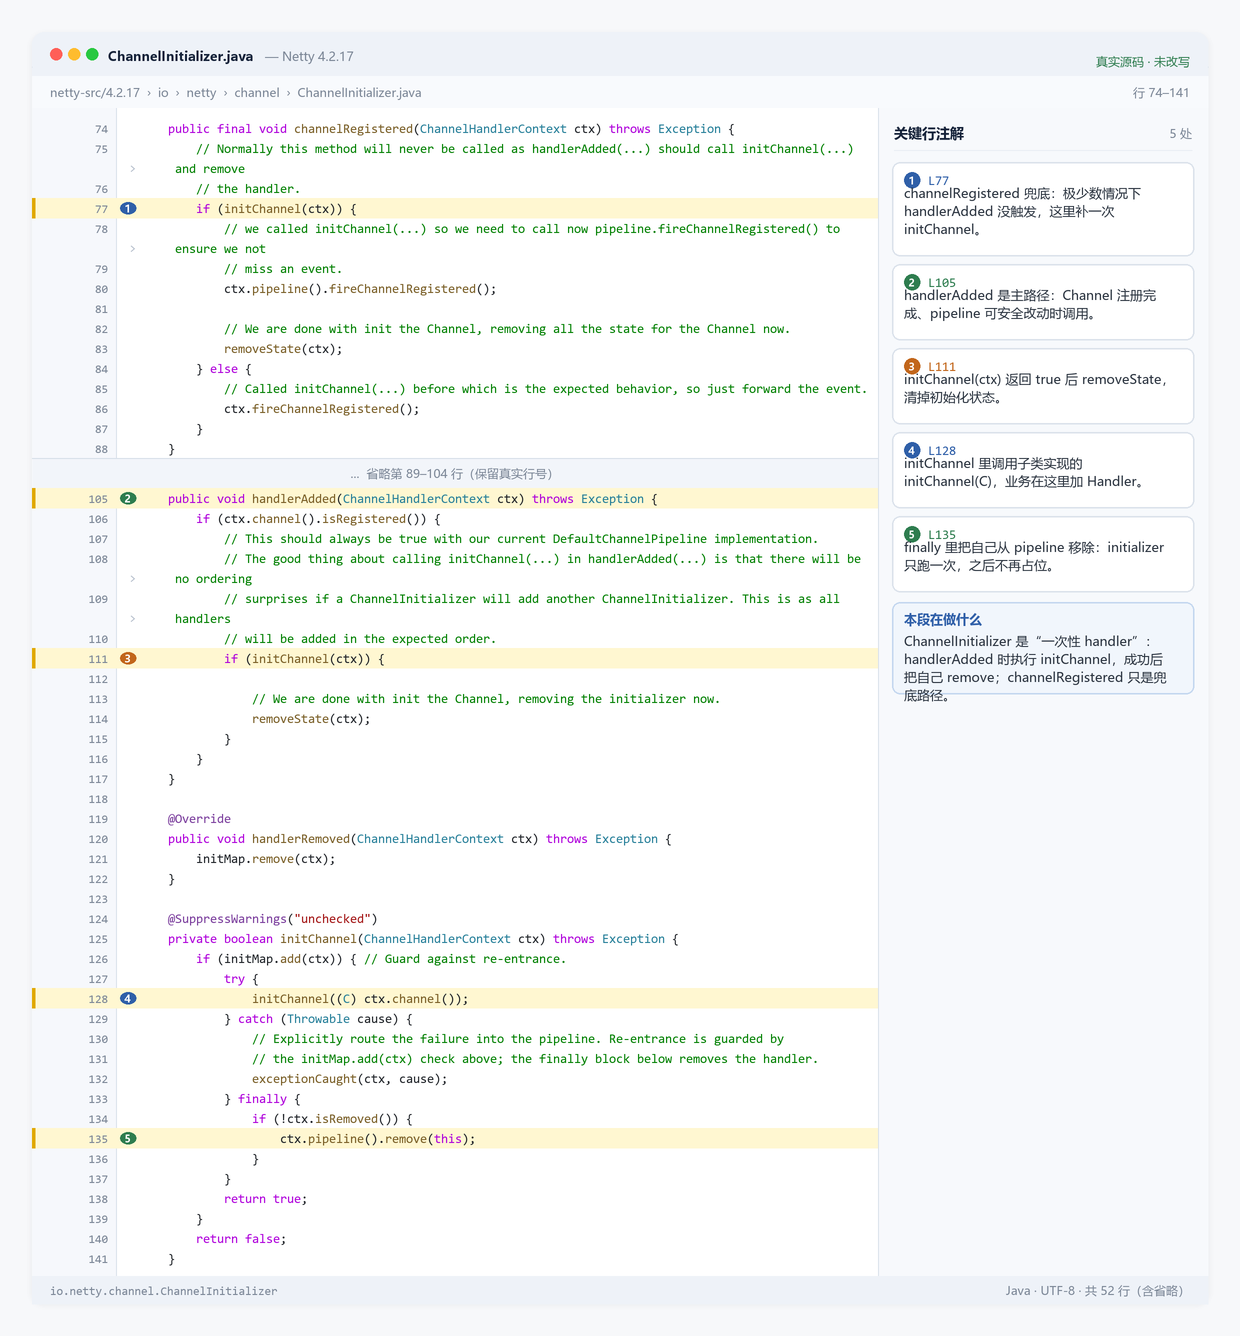
ChannelInitializer 是 Netty
里最常用的延迟装配工具。它的关键在 handlerAdded:
1 |
|
initChannel(ctx) 会调用子类实现的
initChannel(ch),然后
ctx.pipeline().remove(this) 把自己移除。
ChannelInitializer只在 Channel 已经注册后执行initChannel;如果 Channel 还没注册,handlerAdded不会立刻装配,而是等注册完成后由invokeHandlerAddedIfNeeded()补发。initChannel里加的 Handler 会在handlerAdded期间被加入链表,但它们的handlerAdded可能被延迟到当前回调结束后执行;不要假设addLast返回后新 Handler 的handlerAdded已经跑完。
PipelineAddWalkthrough 会把这段顺序打印出来:initializer
的 handlerAdded、initChannel、initializer
被移除、业务 Handler 的 handlerAdded。
注册
注册主要是 register0 里的三段顺序
group.register(channel) 最终会调用
AbstractChannel.AbstractUnsafe.register。如果当前线程不是
EventLoop 线程,它把 register0 提交到 EventLoop:
1 | if (eventLoop.inEventLoop()) { |
register0 的逻辑可以分成两段:先把 JDK Channel 注册到
Selector(doRegister),注册成功后,在监听器里依次补发
handlerAdded、fireChannelRegistered,再根据
isActive() 决定是否 fireChannelActive()。
这三步的顺序解释了上一篇文章里的现象:handlerAdded 早于
channelRegistered,channelRegistered 早于
channelActive。不是 Netty 随意定的,而是
register0 里写死的顺序。
register0 的代码可以简化成:
1 | private void register0(ChannelPromise promise) { |
真正的 doRegister
是抽象的,AbstractNioChannel 把它实现成“把 JDK Channel
注册到 Selector,并把 this 作为
attachment”。所以注册完成之后,SelectionKey.attachment()
拿到的就是 Netty 的 Channel 对象,后续 processSelectedKeys
才能把 ready ops 分发回 Channel。
doBind0 与 channelActive
AbstractChannel.bind 先记录
wasActive = isActive(),再调用
doBind(localAddress)。对
NioServerSocketChannel 来说,doBind
只有一行:
1 |
|
真正的 ServerSocketChannel.bind 由 JDK 完成,Netty
只负责把 backlog 传进去。
绑定动作不是在 main 线程直接执行的。doBind0 把
channel.bind 提交到 EventLoop:
1 | private static void doBind0(final ChannelFuture regFuture, final Channel channel, |
channel.bind 是出站事件,从 Pipeline 的 tail
出发,经过所有出站 Handler,最后到达 head:
1 | // DefaultChannelPipeline.HeadContext |
unsafe.bind 才调用
doBind。这条链路也解释了为什么在 bind
之前添加的 Pipeline Handler 能收到 bind
事件,而之后添加的收不到。
绑定成功后,AbstractChannel.bind
判断“绑定前不活跃、绑定后活跃”,就通过 invokeLater 触发
pipeline.fireChannelActive()。父 Channel 的
channelActive 由此而来。
客户端连接:DNS、非阻塞 connect 与超时
服务端先 bind,客户端则是
Bootstrap.connect。它比 bind
多两层:地址解析和连接超时。
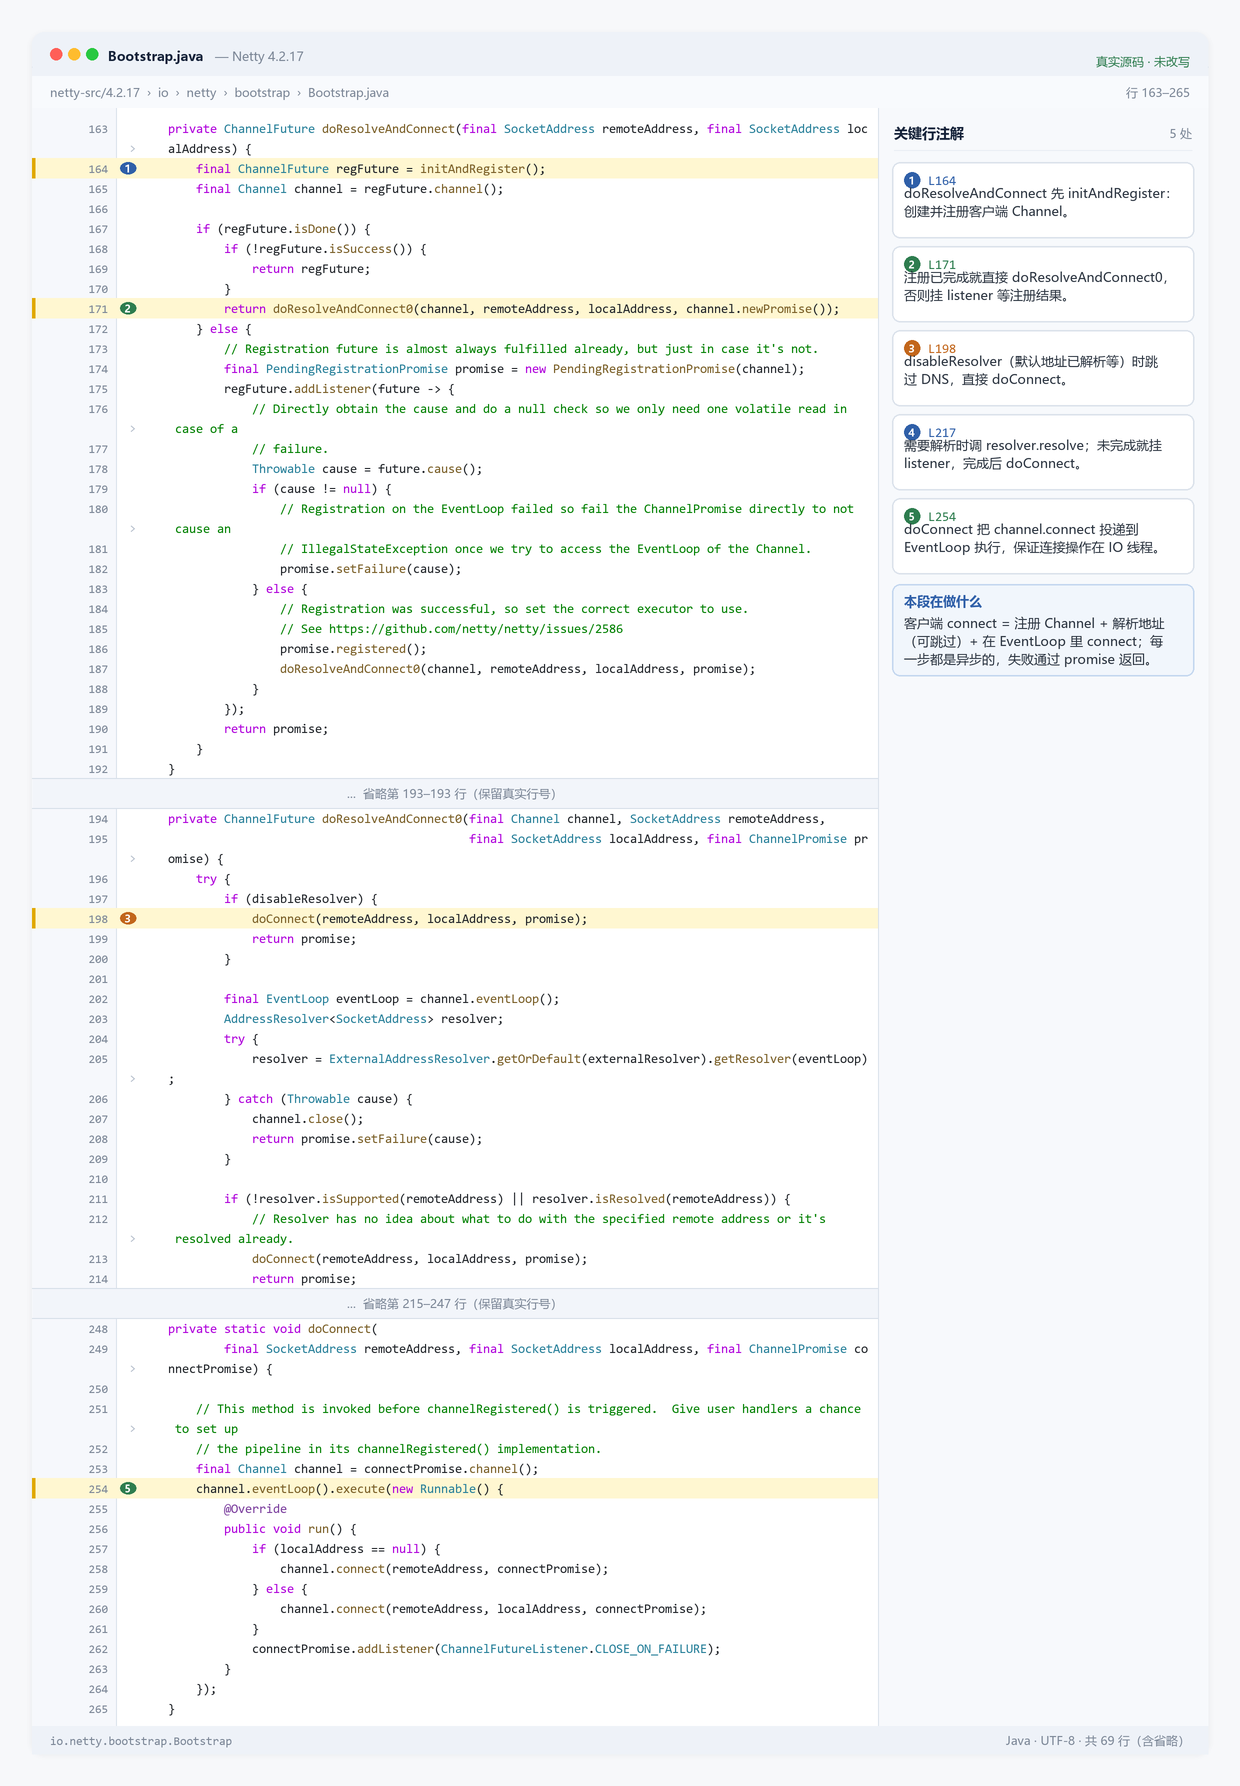
Bootstrap.doResolveAndConnect 先
initAndRegister(),再解析地址:
1 | private ChannelFuture doResolveAndConnect(final SocketAddress remoteAddress, final SocketAddress localAddress) { |
doResolveAndConnect0 里,如果地址已经解析(比如
InetSocketAddress),直接
doConnect;如果是域名,交给
AddressResolver,解析完成后再
doConnect。这就是“连接超时不包括 DNS
解析”的源码依据:CONNECT_TIMEOUT_MILLIS 是在
AbstractNioChannel.connect 里才启动的,DNS
阶段还没有这个计时器。
真正的连接在
AbstractNioChannel.AbstractNioUnsafe.connect:
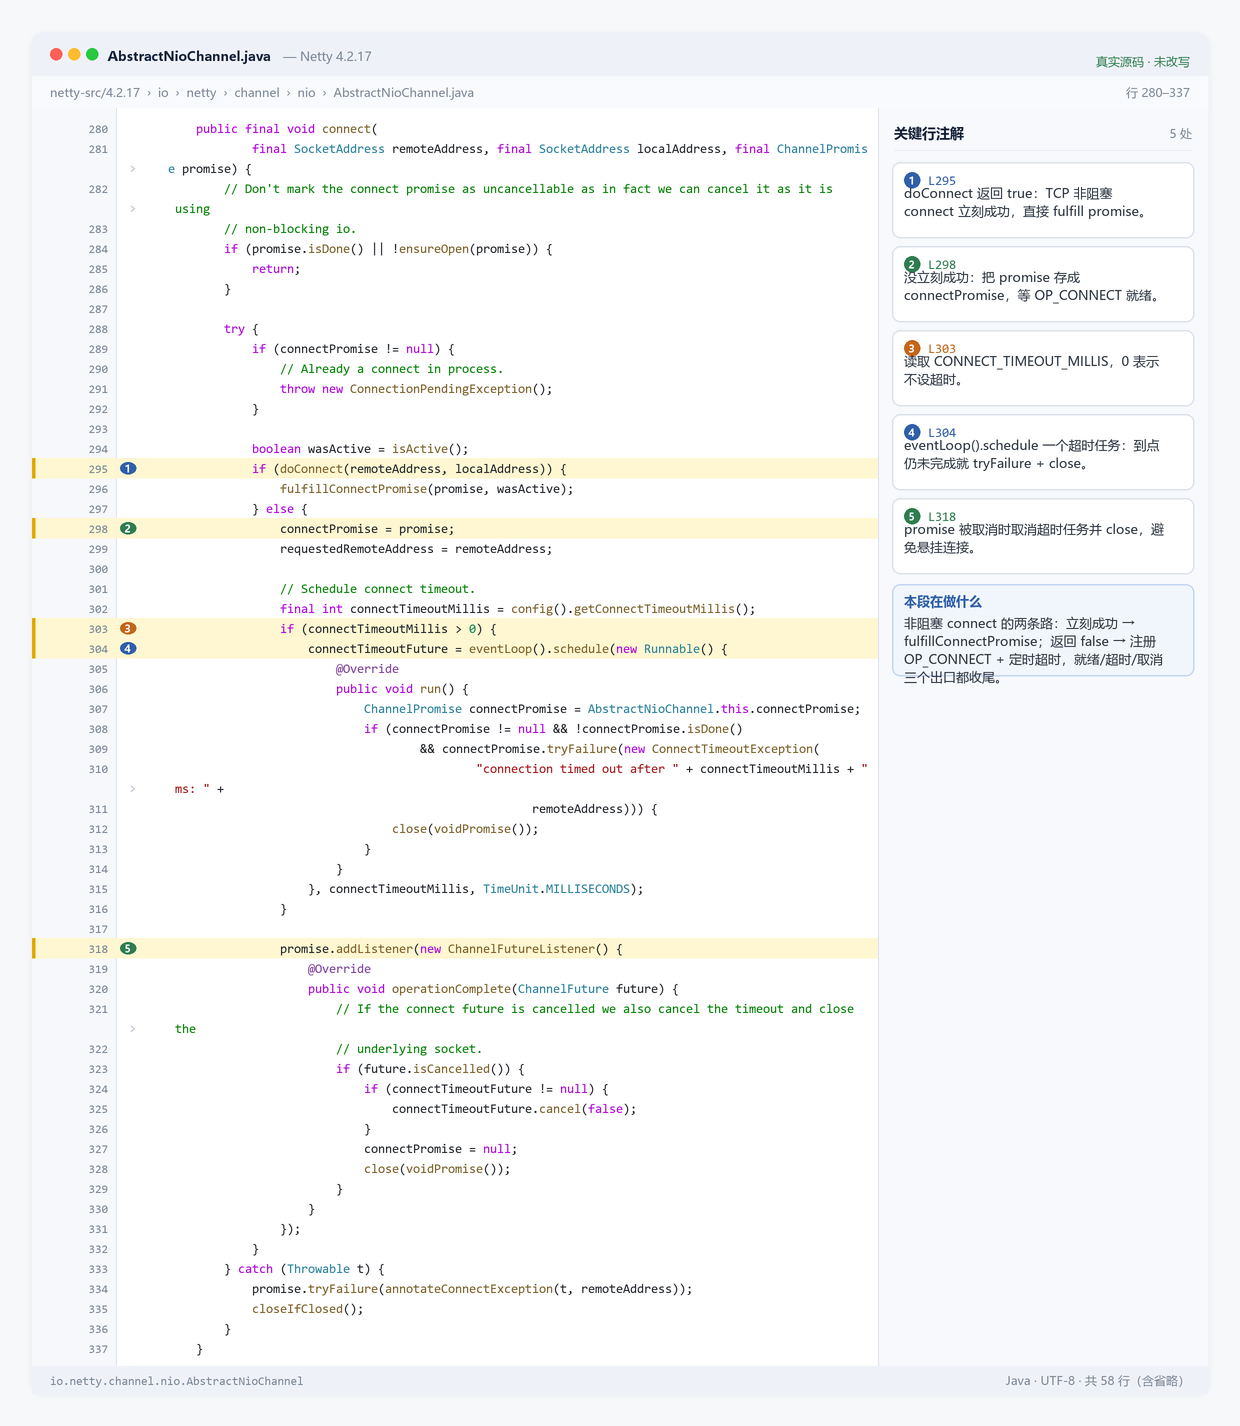
1 | boolean wasActive = isActive(); |
doConnect 返回 false 表示连接还在进行中(非阻塞 Socket
返回 EINPROGRESS),这时才注册 OP_CONNECT
并启动超时任务。连接完成后,finishConnect()
会取消超时任务,再 fulfillConnectPromise。
fulfillConnectPromise 的顺序很关键:
1 | boolean active = isActive(); |
也就是说,connect().sync() 返回时,promise 已经成功,但
channelActive 可能才刚开始执行。这和很多人“sync 返回时
channelActive
一定跑完了”的直觉相反。正确做法不是依赖这个顺序,而是把“连接成功后要做什么”放在
channelActive 或 connect 的 listener
里,并且清楚它可能在同一个 EventLoop 线程上同步执行。
AsyncConnectDemo
的真实日志能对照这个过程:connect().sync() 成功、listener
在 nioEventLoopGroup-4-1 线程执行、连接未监听端口失败得到
AnnotatedConnectException。
accept:从 Selector 到 ServerBootstrapAcceptor
端口绑定后,boss EventLoop 开始监听 OP_ACCEPT。就绪时
NioIoHandler 会分发到
NioMessageUnsafe.read:
1 | do { |
doReadMessages 在 NioServerSocketChannel
里:
1 | SocketChannel ch = SocketUtils.accept(javaChannel()); |
子 Channel 并不是在这里注册的。它作为 channelRead
的消息,从父 Channel 的 Pipeline 走到
ServerBootstrapAcceptor:
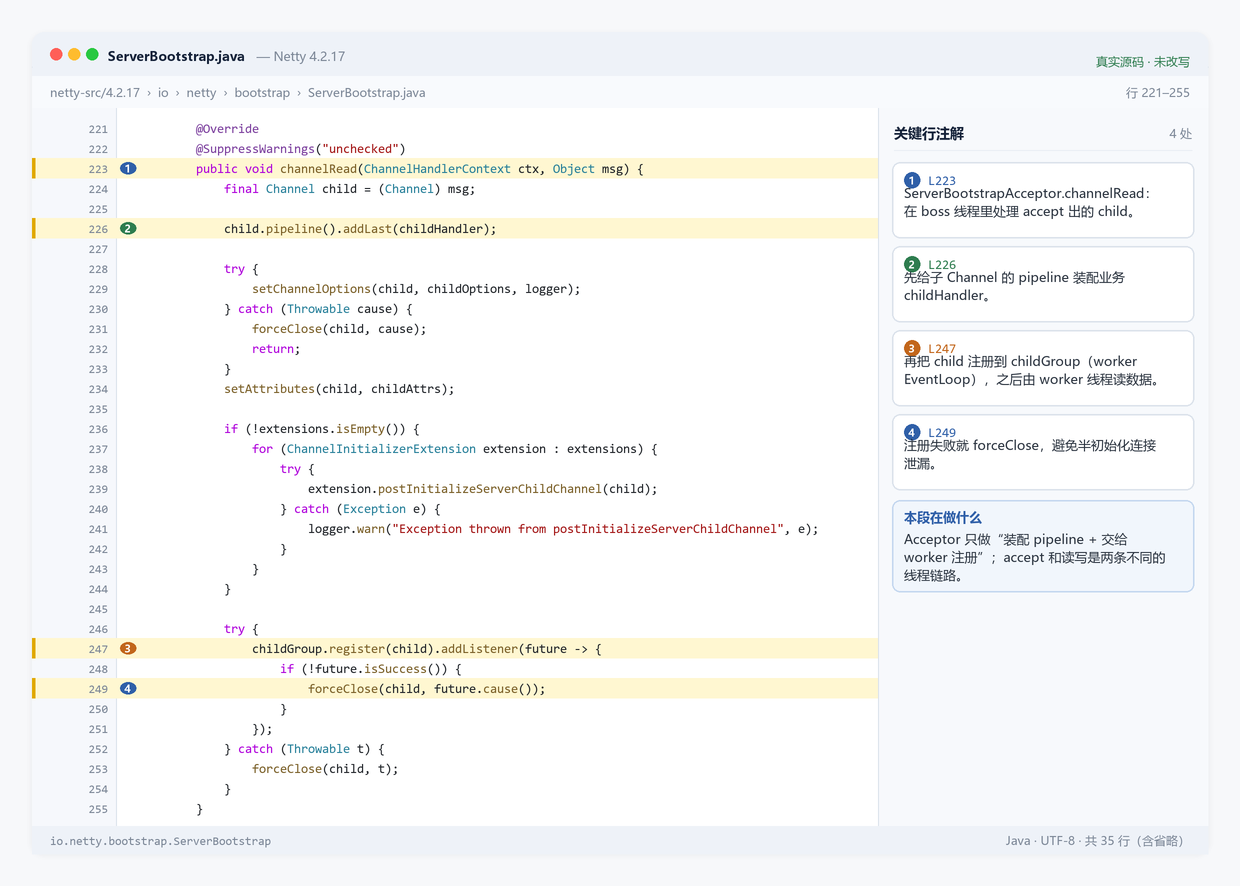
ServerBootstrapAcceptor.channelRead 做四件事:
child.pipeline().addLast(childHandler),把childHandler装进子 Channel 的 Pipeline;setChannelOptions/setAttributes,应用childOption/childAttr;childGroup.register(child),把子 Channel 注册到 worker EventLoop;- 注册失败则
forceClose。
所以“子 Channel 由谁注册”这个问题的答案是:由
ServerBootstrapAcceptor 在父 Channel 的 Pipeline
里注册,注册目标是 childGroup。boss 只负责 accept 和把子
Channel 交出去,worker 负责后续所有事件。
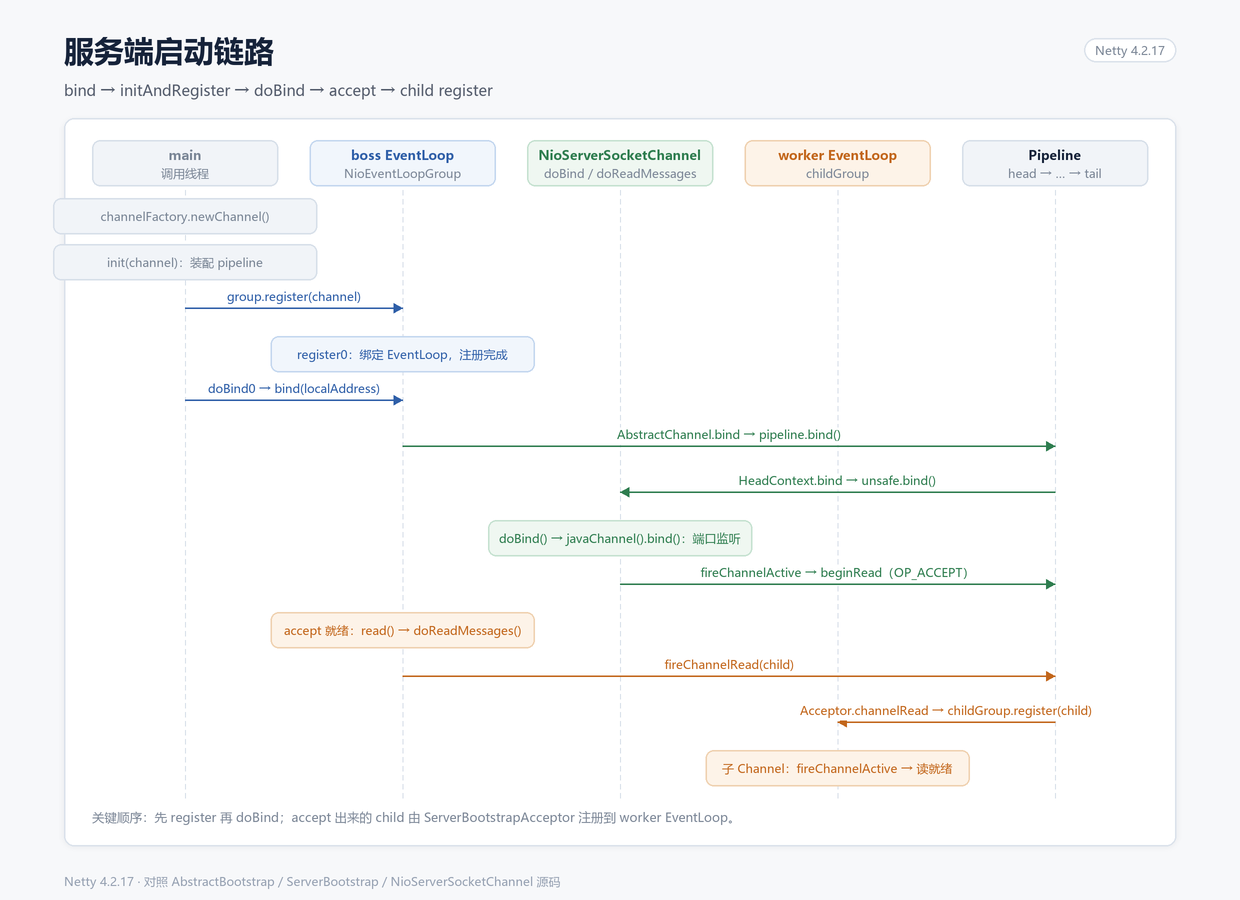
StartupWalkthrough 把这条链路对应的类名、Pipeline
名称、线程名打印出来:
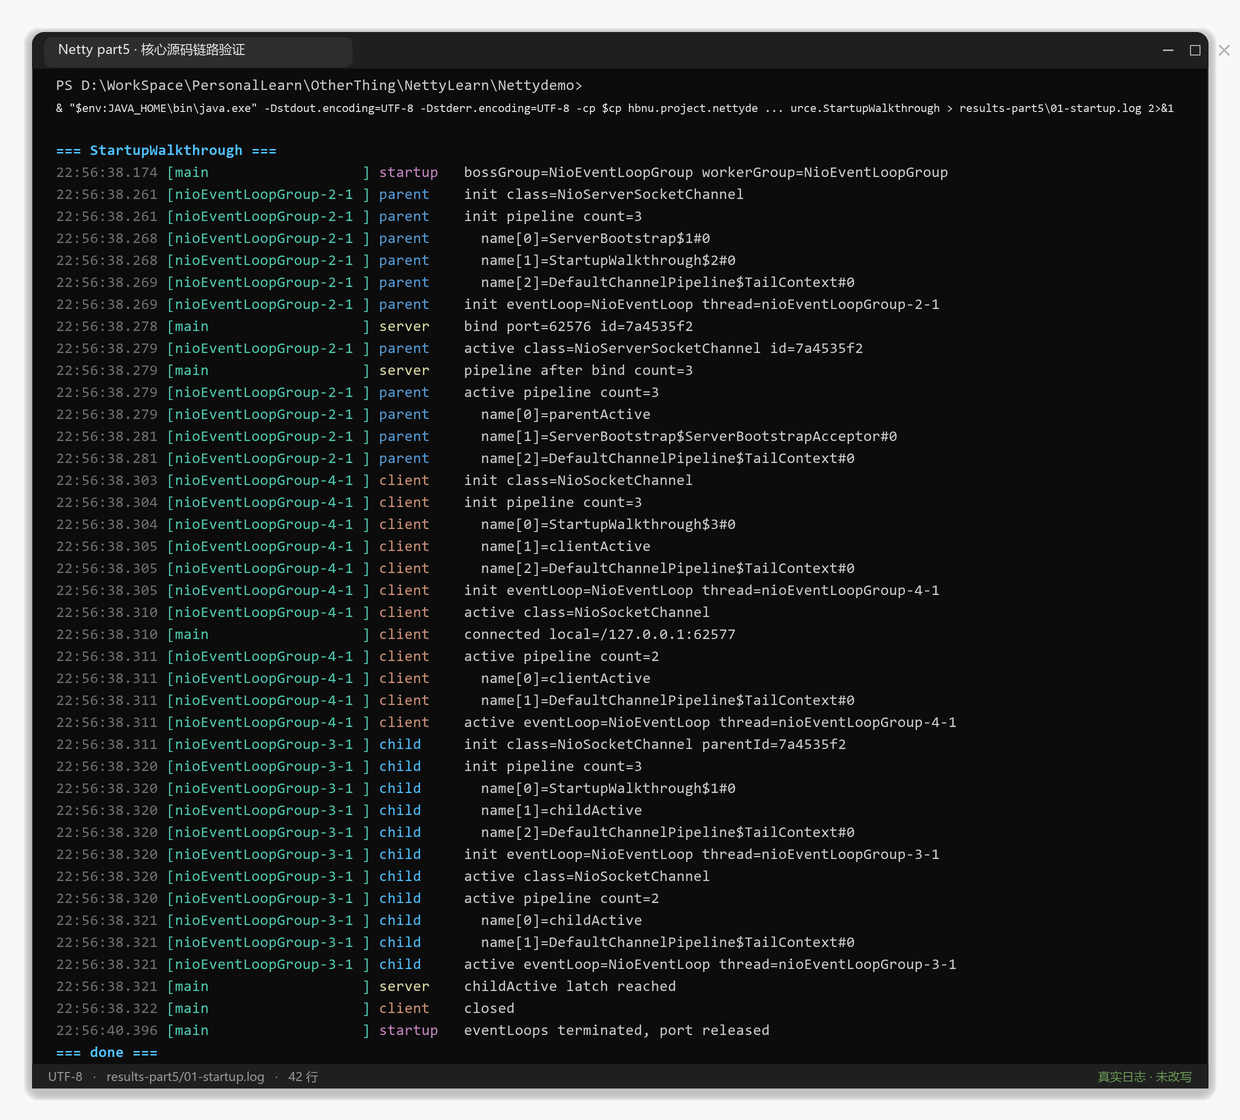
可以从日志里核对:父 Channel 是
NioServerSocketChannel,子 Channel 是
NioSocketChannel,两者的 EventLoop 线程不同;子 Channel 的
Pipeline 名称里包含 childHandler 里的 Handler,父 Channel
的 Pipeline 里有 ServerBootstrapAcceptor。
EventLoop
4.2 的类结构和 4.1 的差异
4.1 里我们熟悉的 NioEventLoop 在 4.2.17 已经被标记为
@Deprecated:
1 | /** |
4.2 把 单线程事件循环 和 IO 多路复用实现 拆开了:
SingleThreadIoEventLoop:线程、任务队列、run()循环;NioIoHandler:Selector、select、processSelectedKeys、注册 key;MultiThreadIoEventLoopGroup+NioIoHandler.newFactory():替代NioEventLoopGroup。
旧代码里的 NioEventLoopGroup
仍能跑,但新项目应该用新的写法。读源码时也要注意:4.1 文章里的
NioEventLoop.run,在 4.2 要拆成
SingleThreadIoEventLoop.run 和
NioIoHandler.run 两段看。
EventLoopGroup 与 chooser
NioEventLoopGroup 继承自
MultithreadEventExecutorGroup,内部是一个
EventExecutor[]。创建时按线程数创建
children,每个 child 是
SingleThreadIoEventLoop;next() 通过 chooser
选一个 executor。
chooser 的实现很值得看:
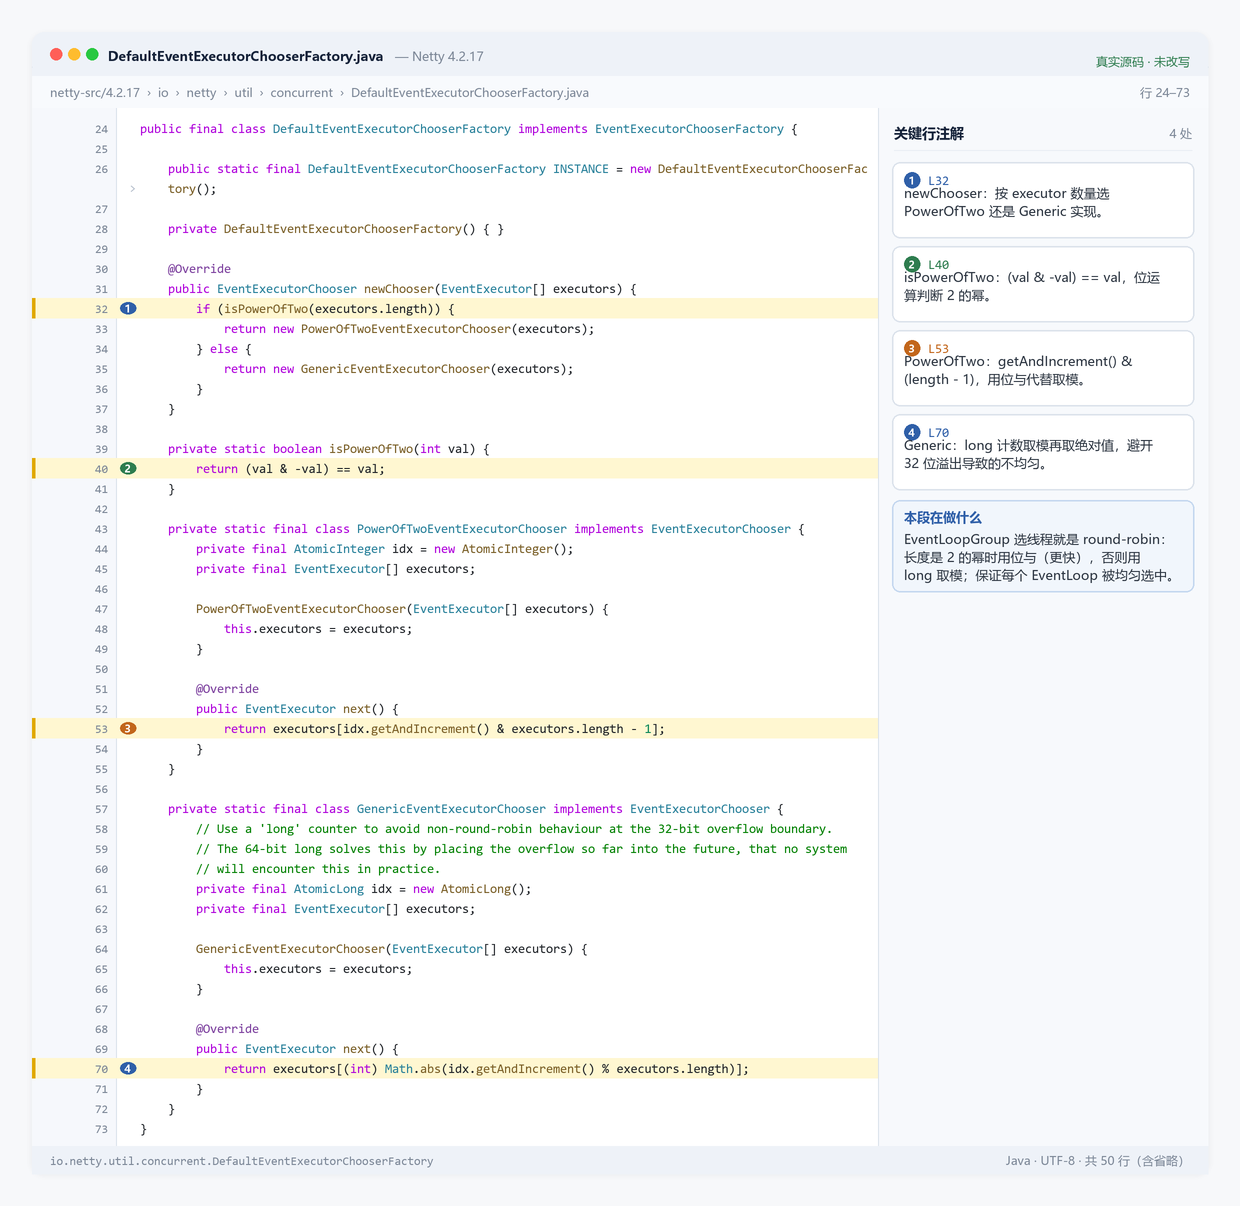
1 | public EventExecutorChooser newChooser(EventExecutor[] executors) { |
线程数是 2 的幂时,next() 用
idx.getAndIncrement() & (length - 1) 取模;否则用
% length。这是为了把取模的除法开销省掉。线程数不是 2
的幂时,源码用 long 计数器避免 32 位溢出后轮询不均匀。
一个 Channel 注册到哪个 EventLoop,由
group.register(channel) 时的 next()
决定;一旦注册,后续所有 I/O 都在这个 EventLoop 线程上执行。这就是“一个
Channel 绑定一个 EventLoop”的源码位置。
任务队列与定时任务
SingleThreadEventExecutor 有两个队列:
taskQueue:普通任务,execute/submit提交;scheduledTaskQueue:定时任务,schedule/scheduleAtFixedRate提交,按 deadline 排序。
普通任务队列在 4.2 里通常是 MPSC 队列,多个线程可以并发 offer,只有 EventLoop 线程 poll。这样跨线程提交任务不需要锁。
每轮 runAllTasks(timeoutNanos)
先把到期的定时任务搬进普通队列,再循环 poll:
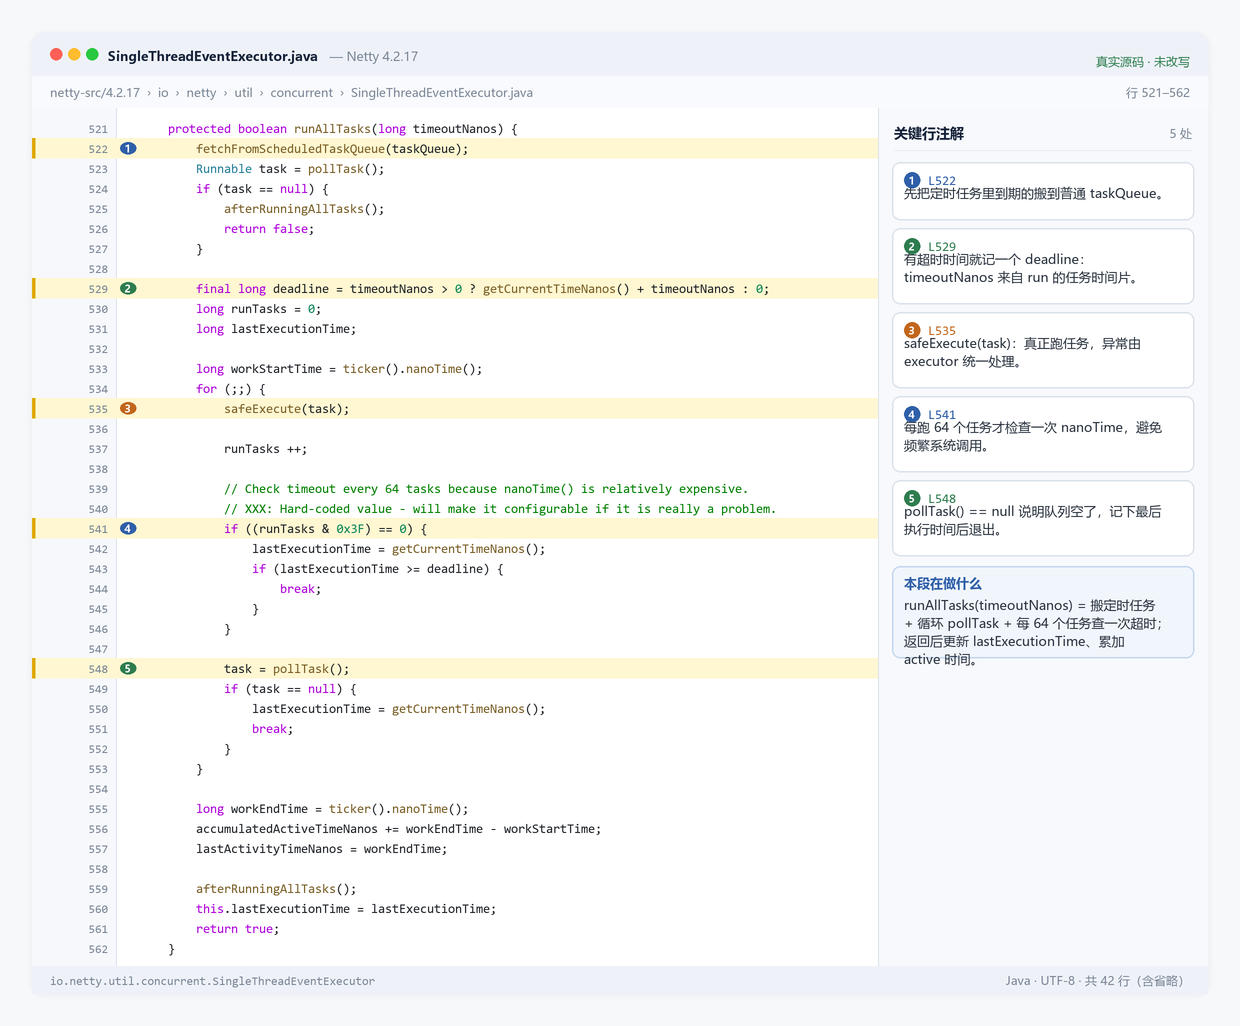
1 | protected boolean runAllTasks(long timeoutNanos) { |
几个细节:
- 每 64 个任务才检查一次时间,因为
nanoTime()有开销; safeExecute会捕获任务异常,避免一个任务把 EventLoop 线程打死;fetchFromScheduledTaskQueue只搬已经到期的任务,没到期的不动;- 任务跑完一个时间片就回到
runIo(),保证 I/O 不会被任务饿死。
EventLoopWalkthrough 的日志能对上:execute
的任务在 EventLoop 线程执行,schedule(100ms) 的真实延迟是
113ms,scheduleAtFixedRate 跑 3 次后取消。
execute 之后发生了什么
EventLoop.execute(task) 不是直接 new Thread,而是:
1 | private void execute(Runnable task, boolean immediate) { |
三个动作:
addTask把任务放进 MPSC 队列;- 如果当前不是 EventLoop 线程,
startThread()懒启动线程; wakeup让阻塞的select立刻返回。
wakeup 对 NIO 来说就是
selector.wakeup(),但源码里包了一层 CAS 标记:
1 | protected void wakeup(boolean inEventLoop) { |
WAKEUP_TASK 是一个空 Runnable,用来把 select 唤醒后让
runAllTasks 看到队列非空。真正的
selector.wakeup() 在 NioIoHandler.wakeup
里,wakenUp 标记避免重复系统调用。
schedule 与定时任务
schedule(task, delay, unit) 创建
ScheduledFutureTask,按 deadline 放进优先队列。每轮
runAllTasks 的 fetchFromScheduledTaskQueue
只把到期的任务搬进普通队列:
1 | private boolean fetchFromScheduledTaskQueue(Queue<Runnable> taskQueue) { |
定时任务不是由单独的 Timer 线程执行,而是复用 EventLoop 线程。所以
schedule 的回调里如果阻塞,同样会拖慢
I/O。scheduleAtFixedRate
的周期任务还会在每次执行后重新计算下一次
deadline,任务执行时间过长会导致周期漂移。
任务拒绝
EventLoop 关闭后,offerTask 会调用
reject(),抛出
RejectedExecutionException。如果这个任务带了消息(比如写任务),safeExecute
会 release 消息、fail promise,避免泄漏:
1 | private static boolean safeExecute(EventExecutor executor, Runnable runnable, |
所以 EventLoop 关闭后提交任务 不是静默丢弃,而是会得到一个失败结果。业务在关闭阶段提交任务时要处理这个异常。
run 主循环
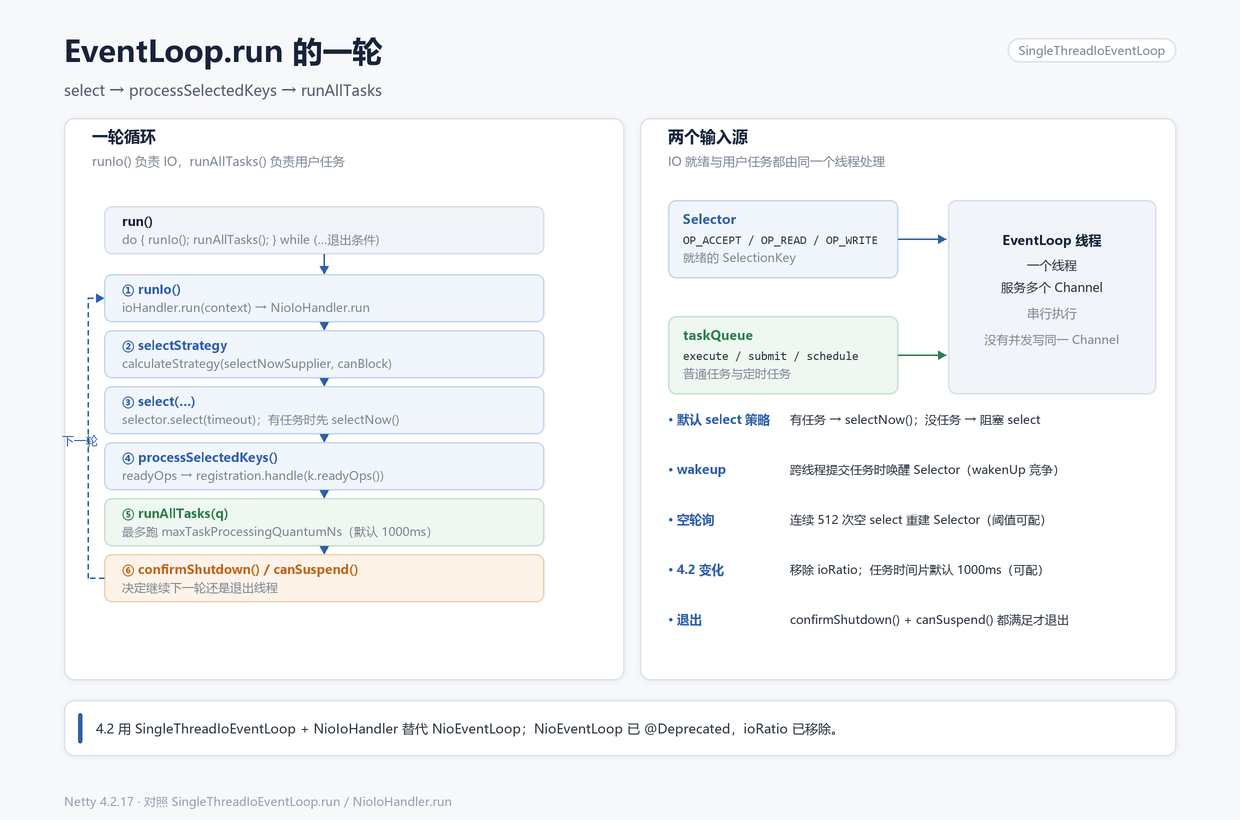
SingleThreadIoEventLoop.run 在 4.2.17 里是这样:
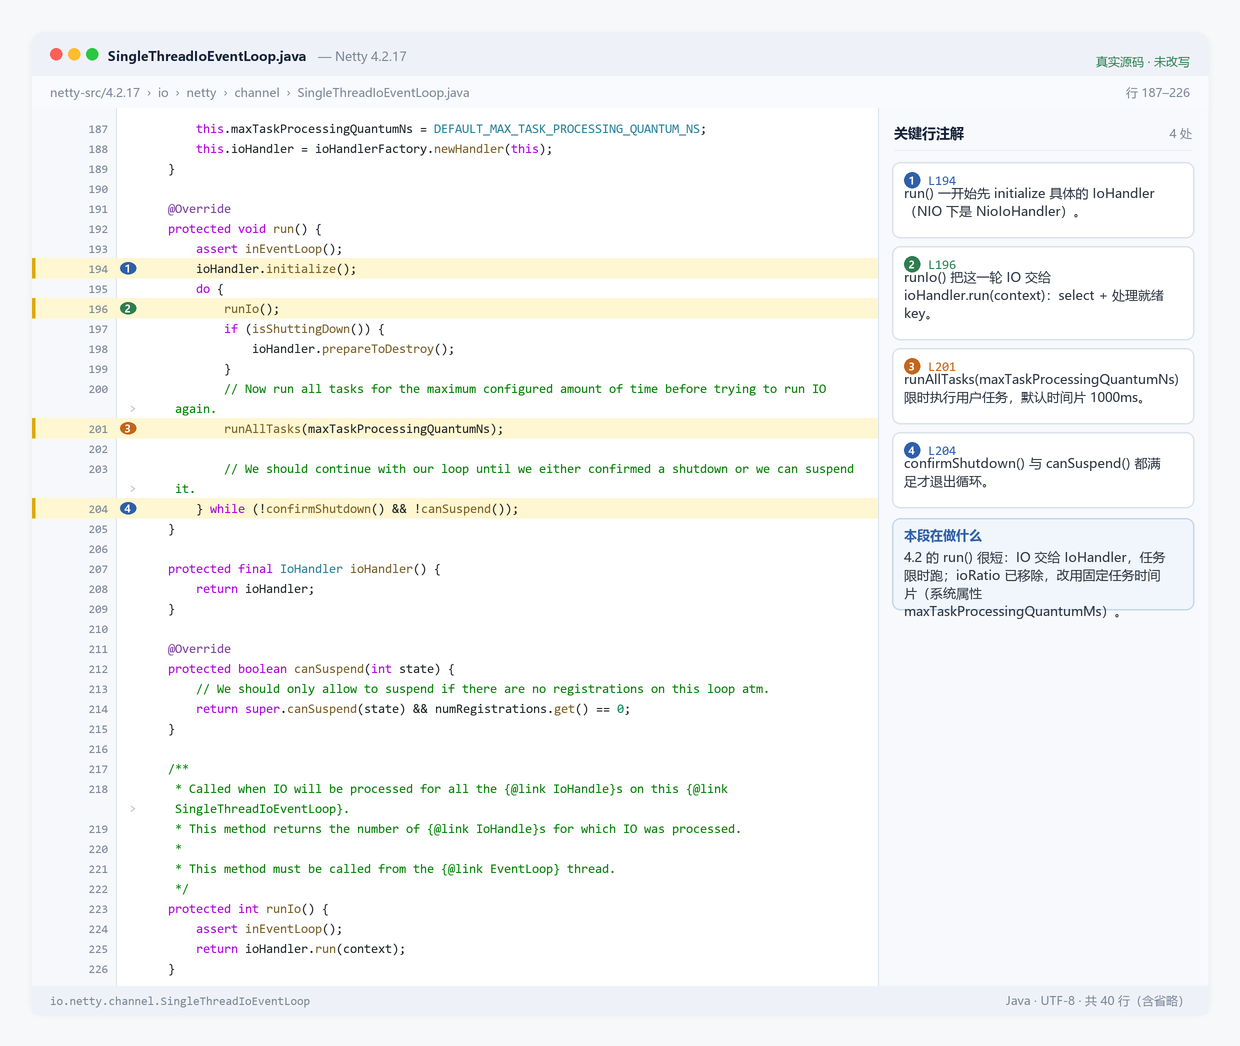
1 | protected void run() { |
runIo() 调用 ioHandler.run(context),对 NIO
来说就是 NioIoHandler.run:
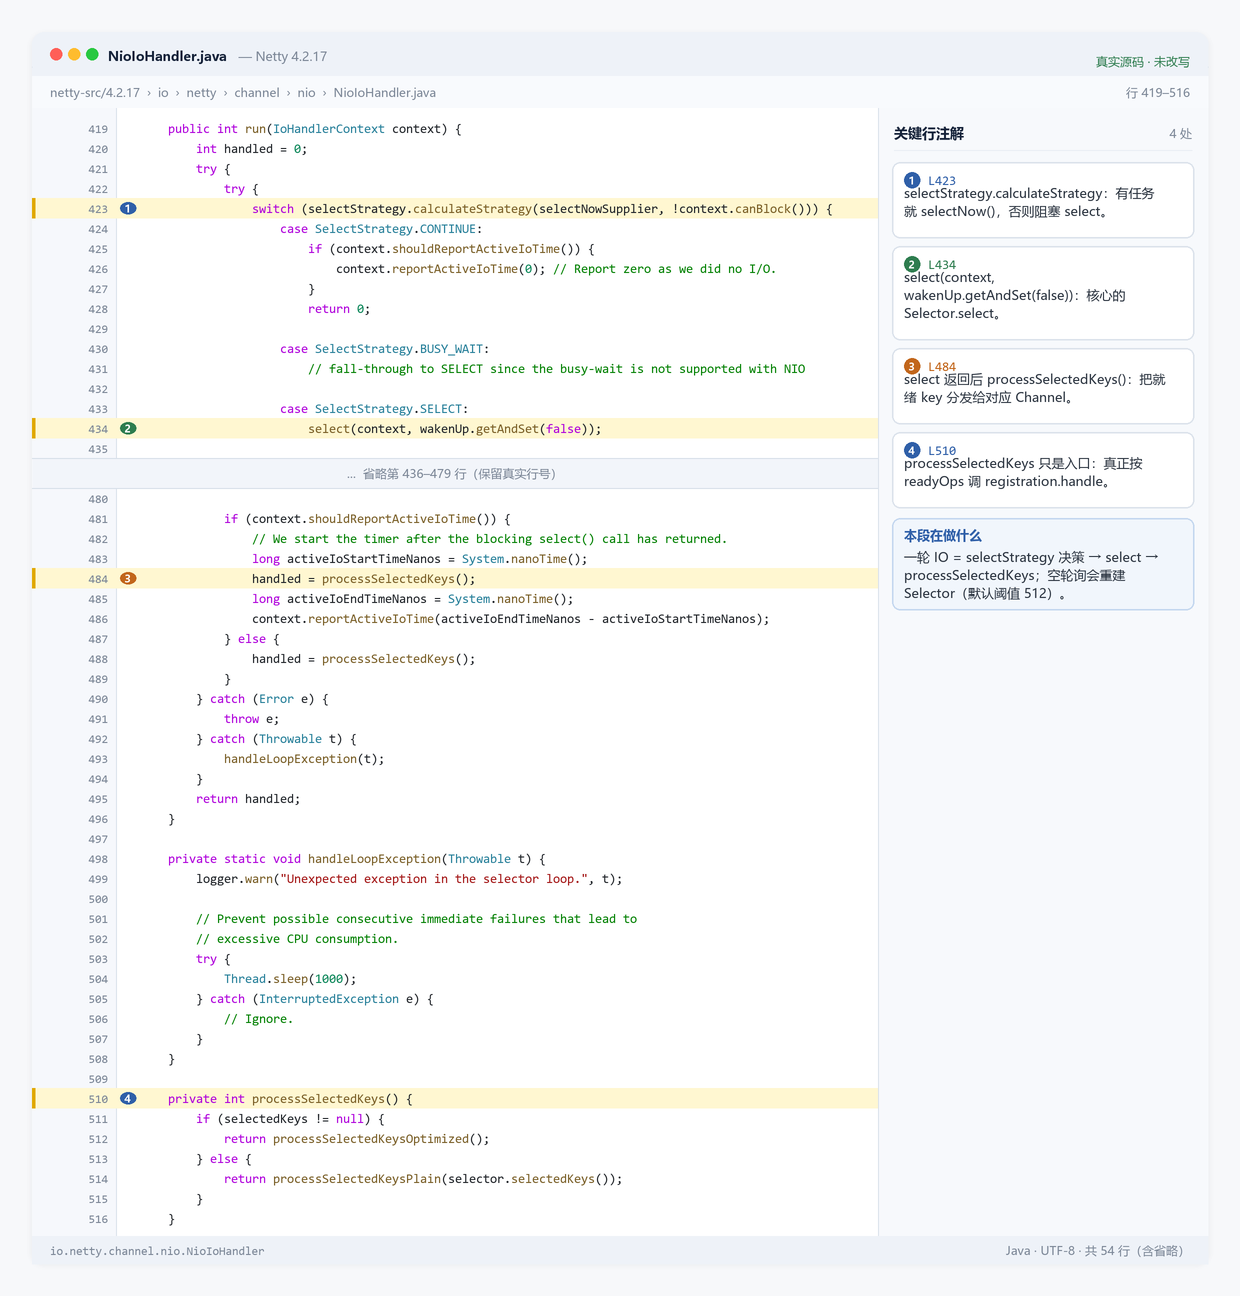
NioIoHandler.run 先按 selectStrategy 决定是
select 还是 selectNow,然后
processSelectedKeys()。SingleThreadIoEventLoop
负责把“跑任务”这件事接在后面。
4.1 的 NioEventLoop.run 用一个 ioRatio 控制
I/O 和任务的时间比例;4.2 移除了 ioRatio,改成每轮 I/O
后跑一个固定时间片的任务,默认约 1000ms,可用
io.netty.eventLoop.maxTaskProcessingQuantumMs 调整。
select 策略与 wakeup
NioIoHandler.select 的核心逻辑可以概括成:
- 先看有没有到期任务,算出
timeoutMillis;没有任务就阻塞等待; - 如果任务队列里有任务,
canBlock()为 false,先selector.selectNow()不阻塞; - 正常
selector.select(timeoutMillis); - select 返回后再检查
wakenUp和任务队列,避免“任务提交了但 select 还在睡”的竞态; - 被用户
wakeup()或中断时及时退出。
关键代码:
1 | int selectedKeys = selector.select(timeoutMillis); |
wakeup 的细节很值得看:execute()
提交任务时会尝试 selector.wakeup(),让阻塞的 select
立刻返回。wakenUp 是一个 CAS 标记,避免重复 wakeup
的系统调用开销。源码里有一段长注释专门解释 wakeup 和 select
的竞态,读一遍就能理解为什么“提交任务后 EventLoop 能马上醒”。
把 select 的完整循环展开,它其实在解决四个问题:
- 没有任务时阻塞,避免空转;
- 有任务时先
selectNow(),不阻塞; - select 被唤醒后,再检查一次任务队列,避免“任务已提交但 select 还没返回”的丢失;
- 连续空轮询时重建 Selector。
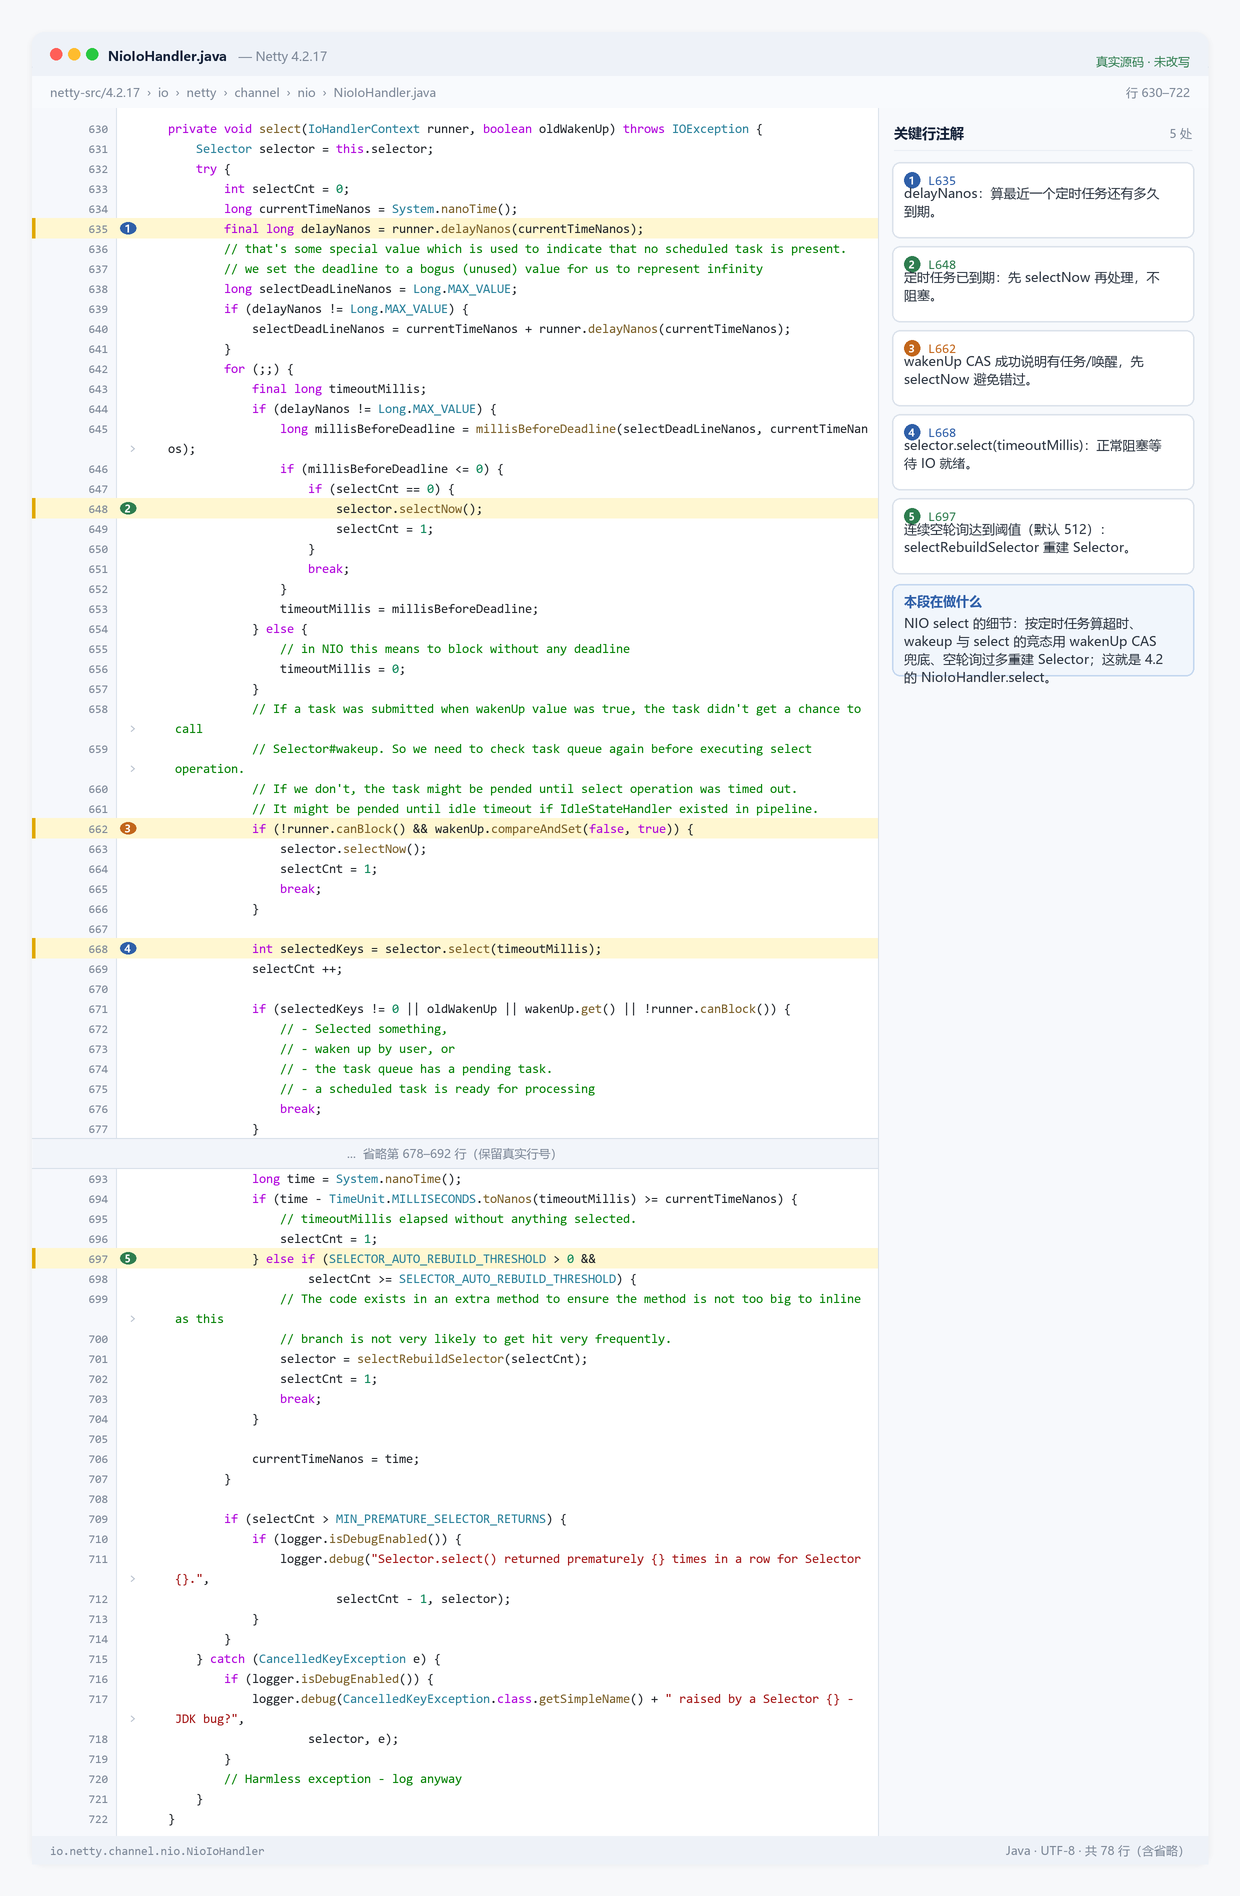
关键分支:
1 | if (!runner.canBlock() && wakenUp.compareAndSet(false, true)) { |
runner.canBlock()
的定义是“没有普通任务、没有定时任务”。如果业务在别的线程提交了一个任务,canBlock
变 false,select 会立刻返回。这个设计让 EventLoop 在 I/O
和任务之间保持低延迟。
select 的 timeoutMillis
来自最近一个定时任务的 deadline;没有定时任务时,delayNanos
返回 SCHEDULE_PURGE_INTERVAL,不是无限大。这样 EventLoop
至少会定期醒来清理取消的定时任务。
processSelectedKeys:从 key 到 Channel
select 返回后,NioIoHandler 遍历就绪
key。它有两个实现:processSelectedKeysOptimized
用数组,processSelectedKeysPlain 用 Set
迭代器。数组版是默认路径:
1 | private int processSelectedKeysOptimized() { |
几个细节:
selectedKeys.keys[i] = null是为了让已关闭 Channel 的SelectionKey能被 GC,避免 select 数组持有引用;needsToSelectAgain在cancel()次数达到阈值时置位,强制重新 select,避免取消的 key 还留在本次结果里;attachment()是注册时放进去的DefaultNioRegistration,它再调handle(readyOps),最终到AbstractNioChannel.handle;- 无效 registration 直接
close,不抛异常。
AbstractNioChannel.handle 再按
CONNECT → WRITE → READ
的顺序分发,这个顺序在“写”一节已经展开。
空轮询与重建 Selector
JDK 的 epoll 有一个历史 bug:没有事件时 select
也可能立即返回,导致循环空转、CPU 100%。Netty 的处理在
select 的末尾:
1 | if (time - TimeUnit.MILLISECONDS.toNanos(timeoutMillis) >= currentTimeNanos) { |
默认阈值是 512。重建时会把旧 Selector 上的 Channel 迁移到新 Selector,然后关闭旧的。这个逻辑解释了“为什么 Netty 能绕过 epoll 空轮询”这个常见面试题。
任务与优雅退出
runAllTasks(maxTaskProcessingQuantumNs)
每轮最多跑一个时间片,避免任务太多把 I/O 饿死。任务来源包括
execute、schedule、scheduleAtFixedRate
和跨线程提交的写任务。
优雅退出时,shutdownGracefully()
设置状态,confirmShutdown()
在循环里检查是否还有任务,canSuspend() 还会检查
numRegistrations == 0。这解释了一个常见现象:只调用
shutdownGracefully() 而不关闭 Channel,EventLoop
可能不会立刻退出,因为还有注册的 Channel。
confirmShutdown 的逻辑比想象中复杂:
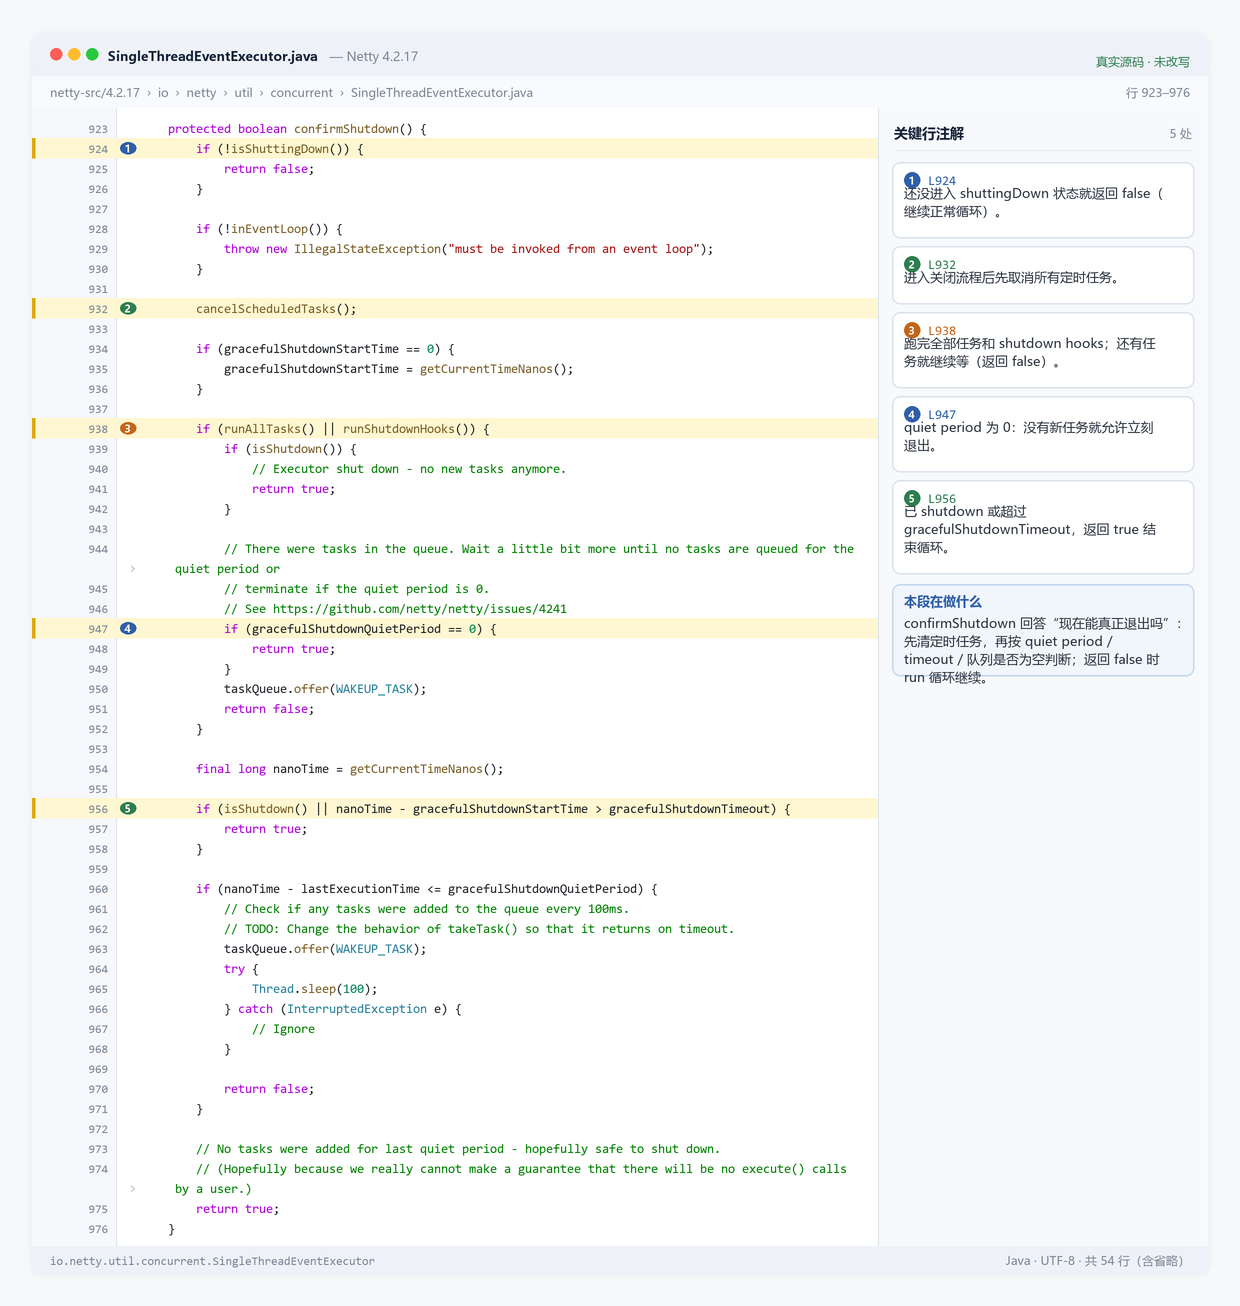
1 | protected boolean confirmShutdown() { |
三个参数:
quietPeriod:没有任务之后,还要等多久才退出,用来兜住“关掉之后还有任务提交”的情况;timeout:整个优雅关闭的最长时间,超过就强制退出;shutdown():不等待,直接标记为关闭。
runAllTasks() 在关闭阶段还会执行已提交的任务,所以
shutdownGracefully()
之后提交的任务可能仍被执行。业务要把“停止接收新任务”和“等待已有任务完成”分开处理。
canSuspend() 是 4.2 新增的挂起机制:没有注册的
Channel、没有任务、没有定时任务时,线程可以挂起而不是空转。这也是 4.2
相对 4.1 的一个运行效率改进。
EventLoopWalkthrough
不直接打印源码内部状态,而是从外部观察:线程名、任务执行顺序、inEventLoop()、定时任务延迟。它和源码对照,能确认“任务确实在
runAllTasks 阶段执行”。
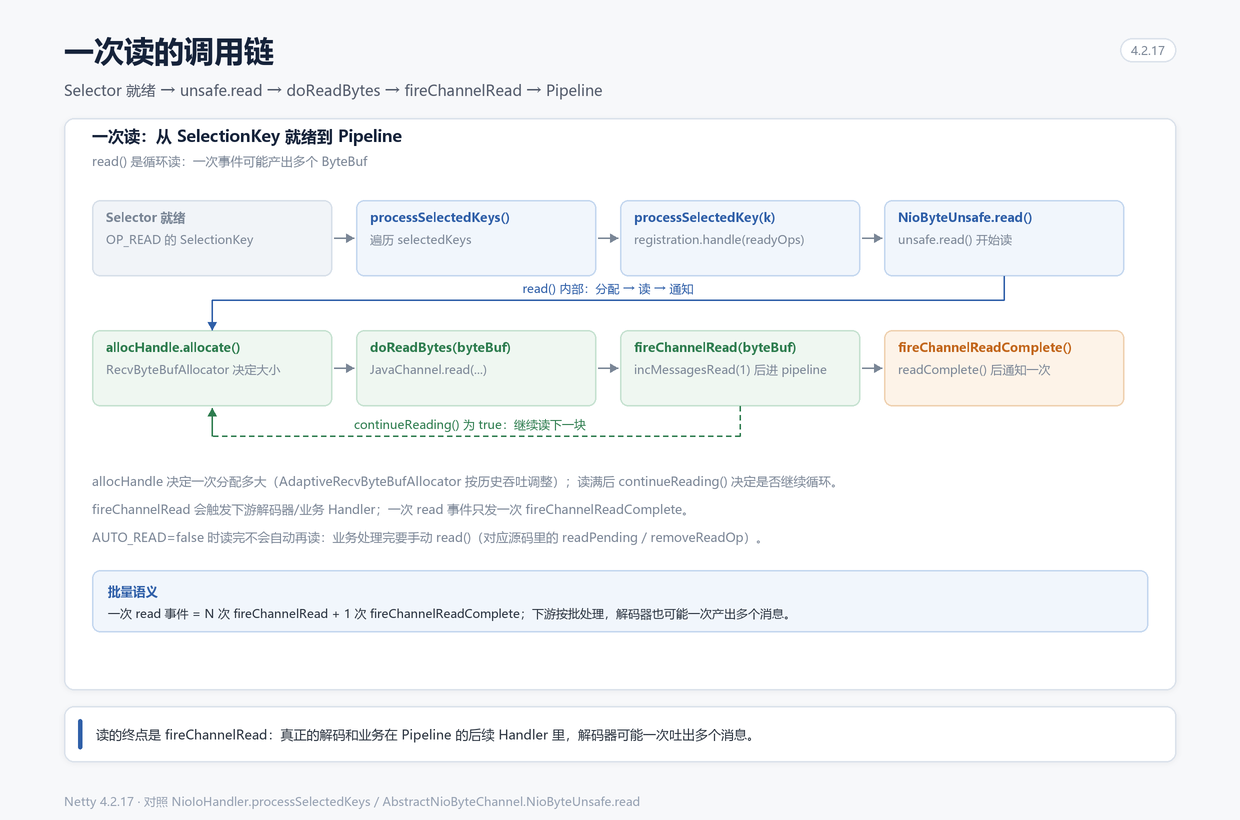
读
从 Selector 到 unsafe.read
NioIoHandler.processSelectedKeys 遍历就绪的
SelectionKey,根据 ready ops 调用注册对象的
handle。对读就绪,最终会走到
AbstractNioByteChannel.NioByteUnsafe.read:
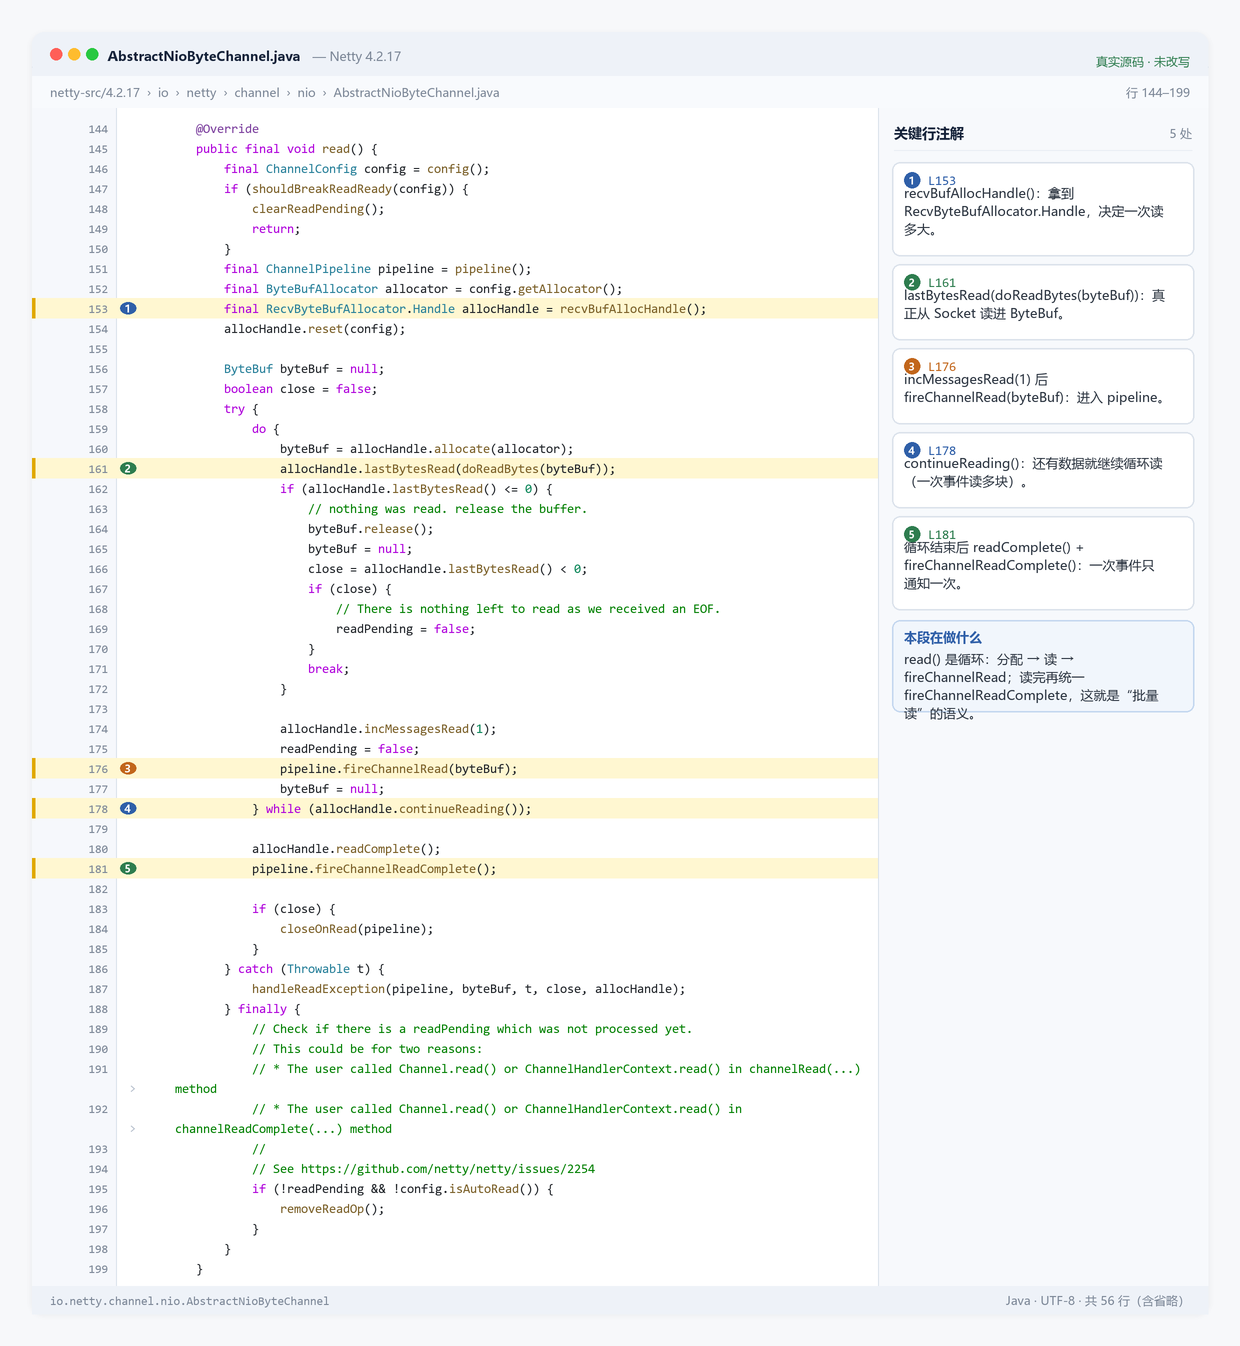
核心是一个 do-while:
1 | do { |
三个点:
allocHandle决定这次分配多大,RecvByteBufAllocator会根据上一次读到的字节数调整下一次的分配大小;doReadBytes返回实际读到的字节数,<= 0表示没数据或 EOF;- 每读到一块就
fireChannelRead,读循环结束后再fireChannelReadComplete。
这解释了为什么一次 channelReadComplete 可能对应多次
channelRead:读循环里每读一块就 fire 一次,循环结束才 fire
complete。
接收缓冲区为什么会自适应
allocHandle 不是固定的 1024 字节。默认的
AdaptiveRecvByteBufAllocator
会根据上一轮读到的数据量调整下一次分配大小:
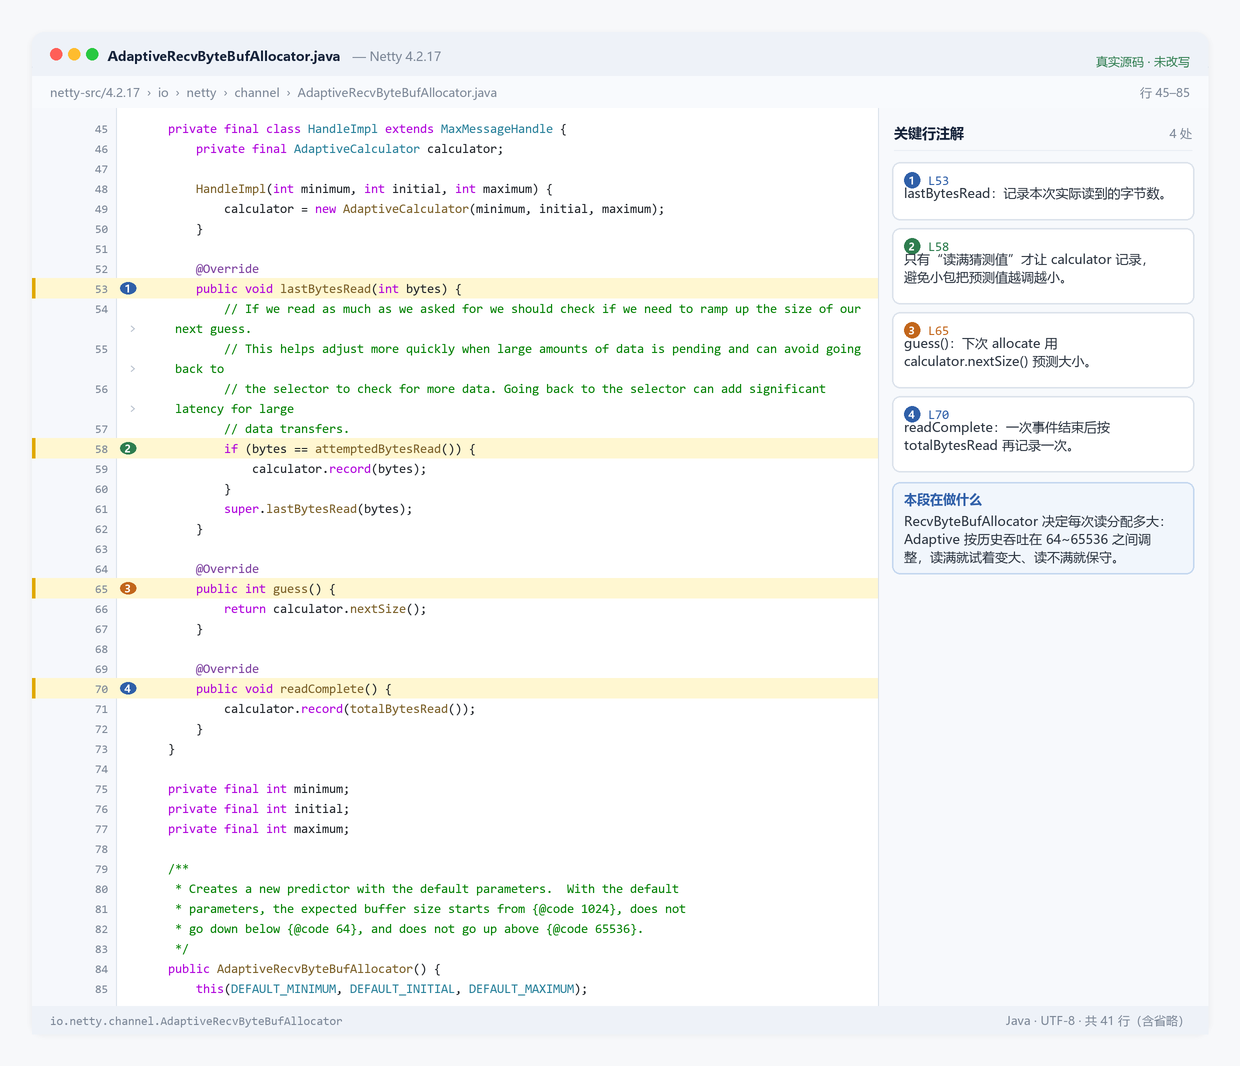
1 | public void lastBytesRead(int bytes) { |
扩容策略是“上次读满了,下次就增大;上次没读满,下次就减小”,但被限制在
minimum 和 maximum 之间(默认
64B–64KB)。这样小包不会一上来分配
64KB,大流量又能快速升到合适大小。
continueReading 的三个条件
读循环不是无限读的,continueReading() 有三个约束:
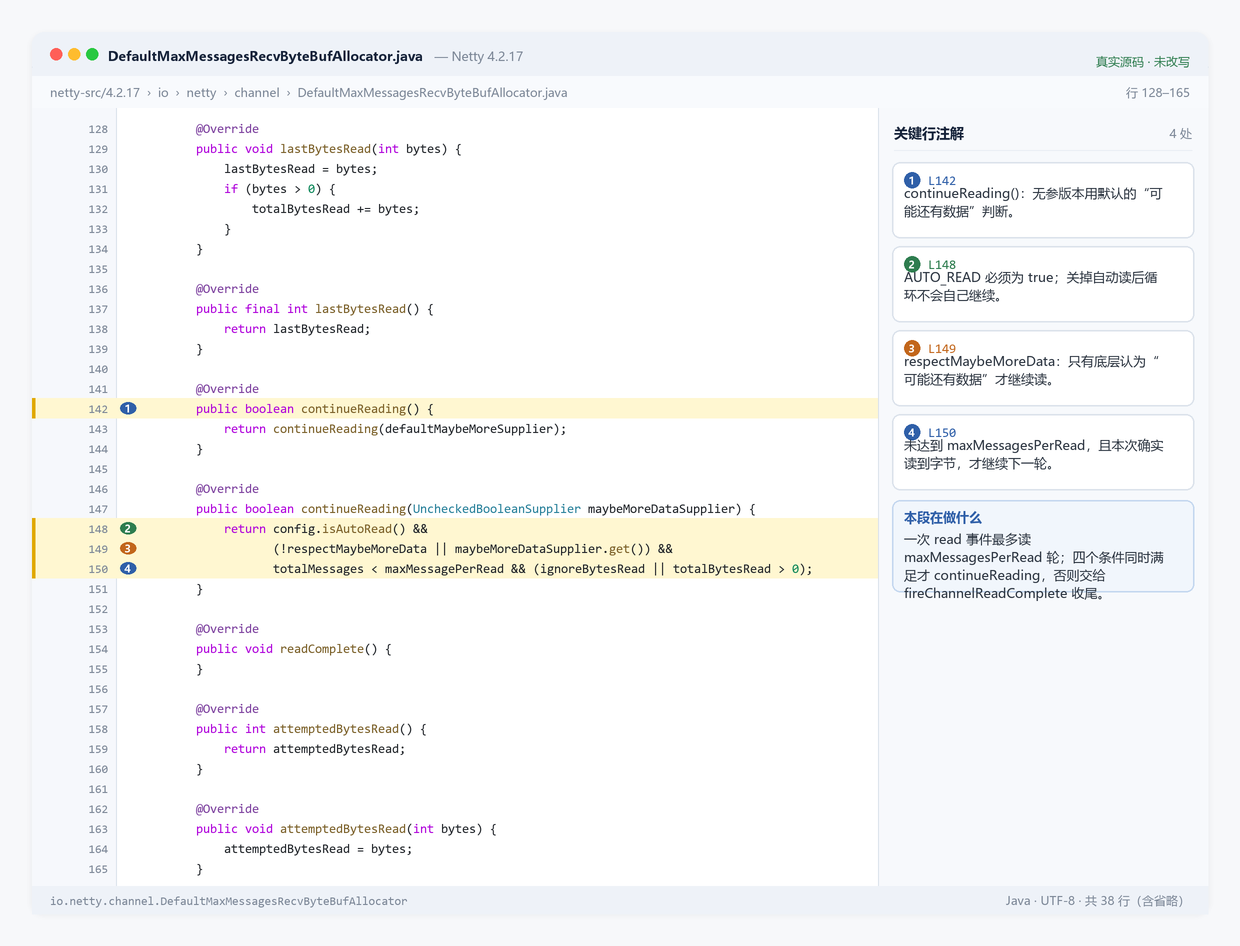
1 | public boolean continueReading(UncheckedBooleanSupplier maybeMoreDataSupplier) { |
isAutoRead():手动背压模式下,业务不read()就不会继续;respectMaybeMoreData:上一次是否读满,读满才认为“可能还有数据”;maxMessagePerRead:默认 16,防止一个连接把 EventLoop 占死;totalBytesRead > 0:至少读到一点数据,否则退出。
maxMessagesPerRead
的存在解释了一个现象:一条连接持续高速发送时,EventLoop
不会无限循环读它,而是每 16 次读就回去处理其他
Channel,保证公平性。这个值可以按业务调整,但调大意味着单连接可能占用更多
CPU。
fireChannelRead 进入 Pipeline
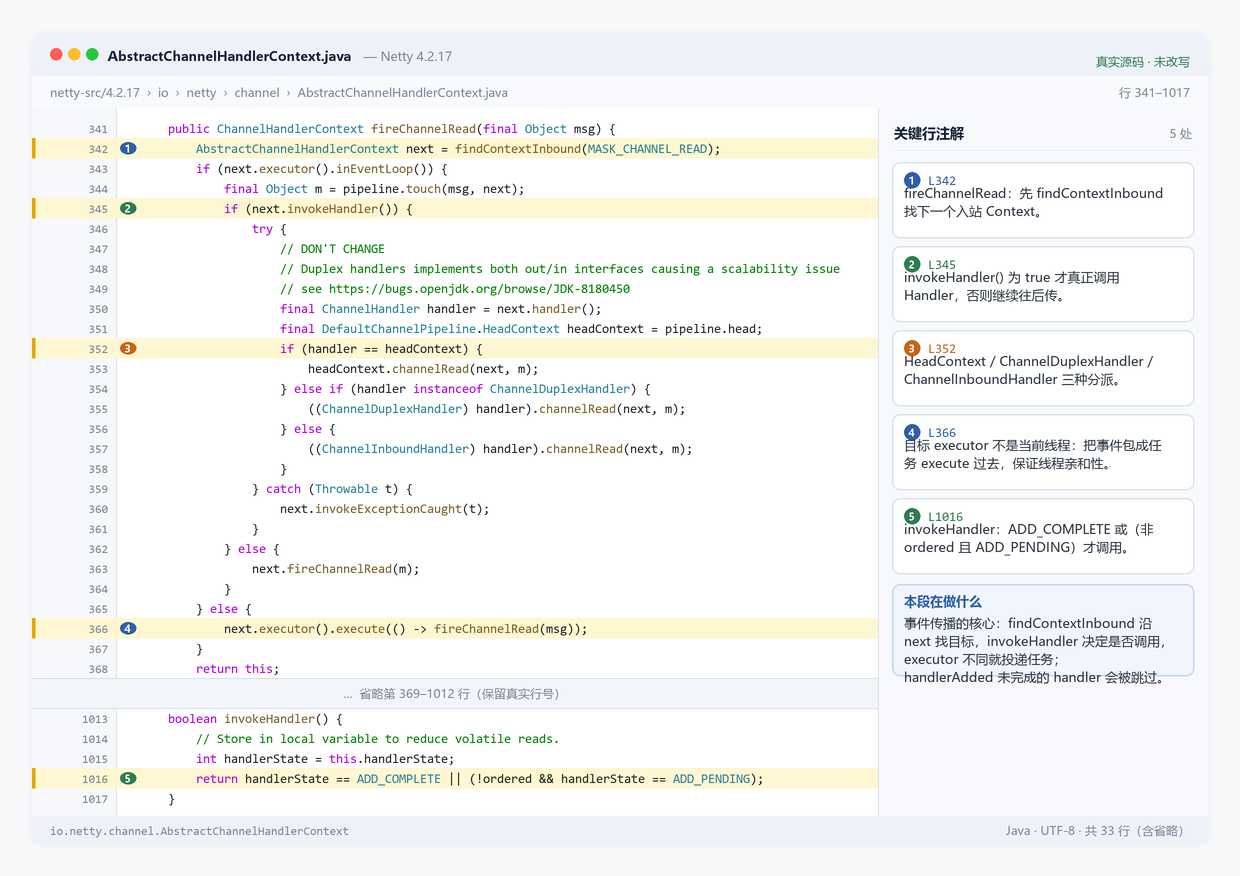
fireChannelRead 从头节点开始找下一个入站 Handler:
1 | public ChannelHandlerContext fireChannelRead(final Object msg) { |
findContextInbound 从当前 Context 的 next
开始找,跳过不处理入站事件的 Handler;findContextOutbound
从 prev 开始找,方向相反:
1 | private AbstractChannelHandlerContext findContextInbound(int mask) { |
这个实现和上一篇的实验完全对应。skipContext
的判断是:
1 | return (ctx.executionMask & (onlyMask | mask)) == 0 || |
第一个条件是 Handler 类型不匹配;第二个条件是同一个 executor 且不关心这个事件。如果 executor 不同,即使类型不匹配也不能跳过,否则事件会绕过一个线程边界,破坏该 Handler 看到的顺序。
channelReadComplete 与 AUTO_READ
HeadContext.channelReadComplete
在把事件传给后面之后,会调用 readIfIsAutoRead():
1 | public void channelReadComplete(ChannelHandlerContext ctx) { |
AUTO_READ=true 时,读完一批会重新注册读事件;设为 false
时不会自动读,需要业务调用
read()。这就是背压的源码位置。
写
write 只是入队
ctx.write(msg) 最终走到
AbstractChannelHandlerContext.write:
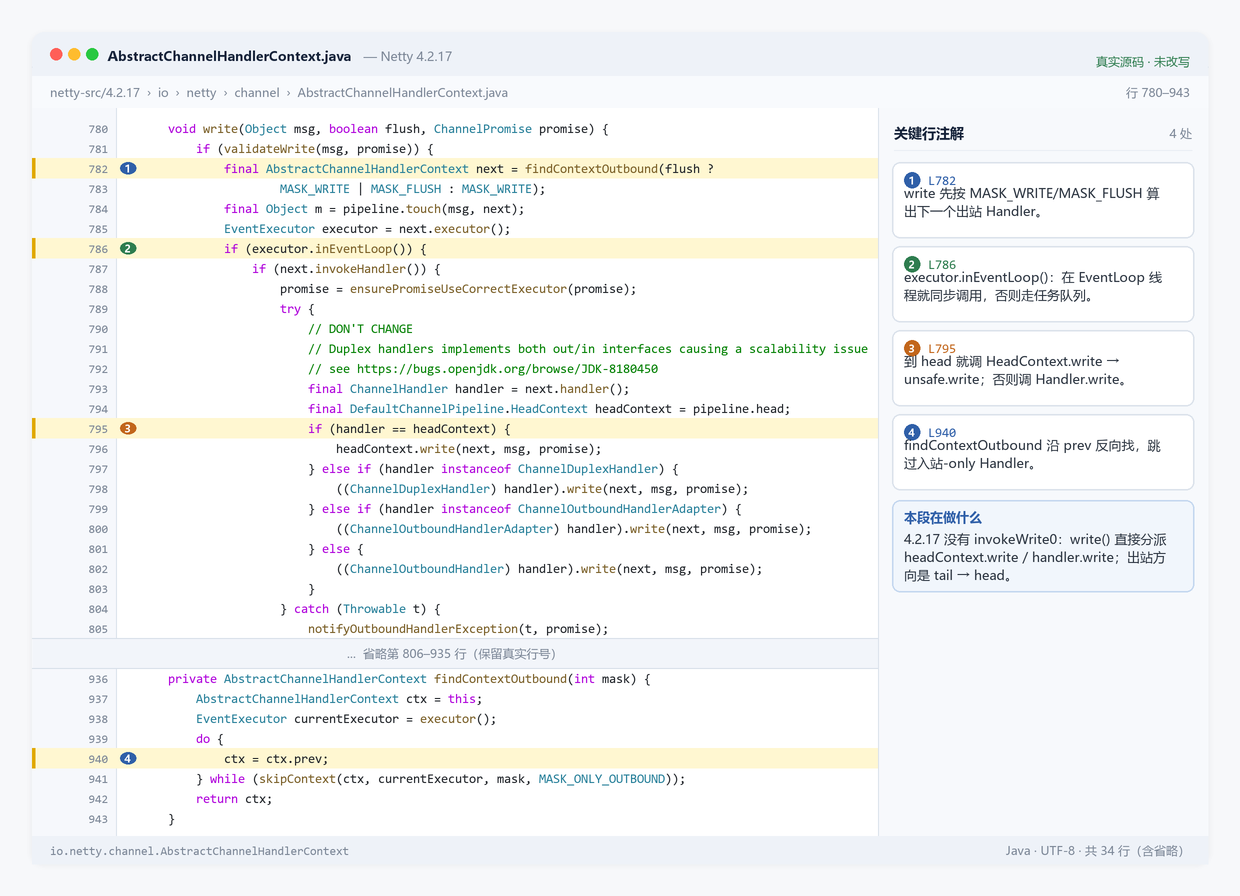
关键几行:
1 | final AbstractChannelHandlerContext next = findContextOutbound(flush ? |
如果当前线程不是出站 Handler 的 executor,写操作会包装成
WriteTask 投递到对应线程。findContextOutbound
从当前 Context 往 prev 找,直到 head;head 的
write 调用 unsafe.write:
1 | public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) { |
AbstractChannel.AbstractUnsafe.write
做三件事:过滤消息(filterOutboundMessage)、估算大小、outboundBuffer.addMessage。到这一步,数据只是进入了
ChannelOutboundBuffer,还没有写 Socket。
ChannelOutboundBuffer 的三个指针
ChannelOutboundBuffer 不是一个简单的
ArrayDeque,它用三个指针维护三类 entry:
1 | flushedEntry unflushedEntry tailEntry |
flushedEntry:已经 flush、可以被doWrite取出的第一条;unflushedEntry:还没 flush 的第一条;tailEntry:最后一条,用来 O(1) 追加。
addMessage 只动 tailEntry 和
unflushedEntry,不碰 flushedEntry:
1 | public void addMessage(Object msg, int size, ChannelPromise promise) { |
addFlush 才把 unflushedEntry 到
tailEntry 这一段接到 flushedEntry 后面,并把
flushed 计数加上去。remove() 每次取
flushedEntry,释放消息、通知 promise、扣减 pending
字节,再把指针后移。
这个三指针设计让 write 和 flush 可以分开:write 只追加,flush 只改边界,doWrite 只消费。三者都在 EventLoop 线程执行,所以不需要锁。
跨线程写:WriteTask 与 executor
ctx.write 不要求当前线程是 EventLoop
线程。AbstractChannelHandlerContext.write 会先找下一个出站
Context,然后看它的 executor:
1 | EventExecutor executor = next.executor(); |
WriteTask 是 Recycler
池化的对象,避免每次跨线程写都 new 一个 Runnable。它被投递到目标
executor 后,在目标线程里重新执行 write。这保证了:
- Handler 的
write只在它绑定的 executor 上执行; - 业务线程调用
write不会直接操作 Channel,避免线程安全问题; - 如果 executor 拒绝任务,消息会被释放、promise 失败,不会泄漏。
ensurePromiseUseCorrectExecutor 还处理了 promise
的线程归属:如果 promise 的 executor 不是当前 EventLoop,会创建一个新的
promise 并把结果 cascade 过去,保证出站 Handler 加的 listener
在自己的线程执行。
写失败:failFlushed 与 close
连接断开时,ChannelOutboundBuffer
里可能还有没写出去的消息。AbstractUnsafe.close 会调用:
1 | outboundBuffer.failFlushed(cause, false); |
failFlushed 循环
remove0(cause, notify),把已 flush 的 entry 逐个 release 并
fail promise;close 再处理 unflushed entry:
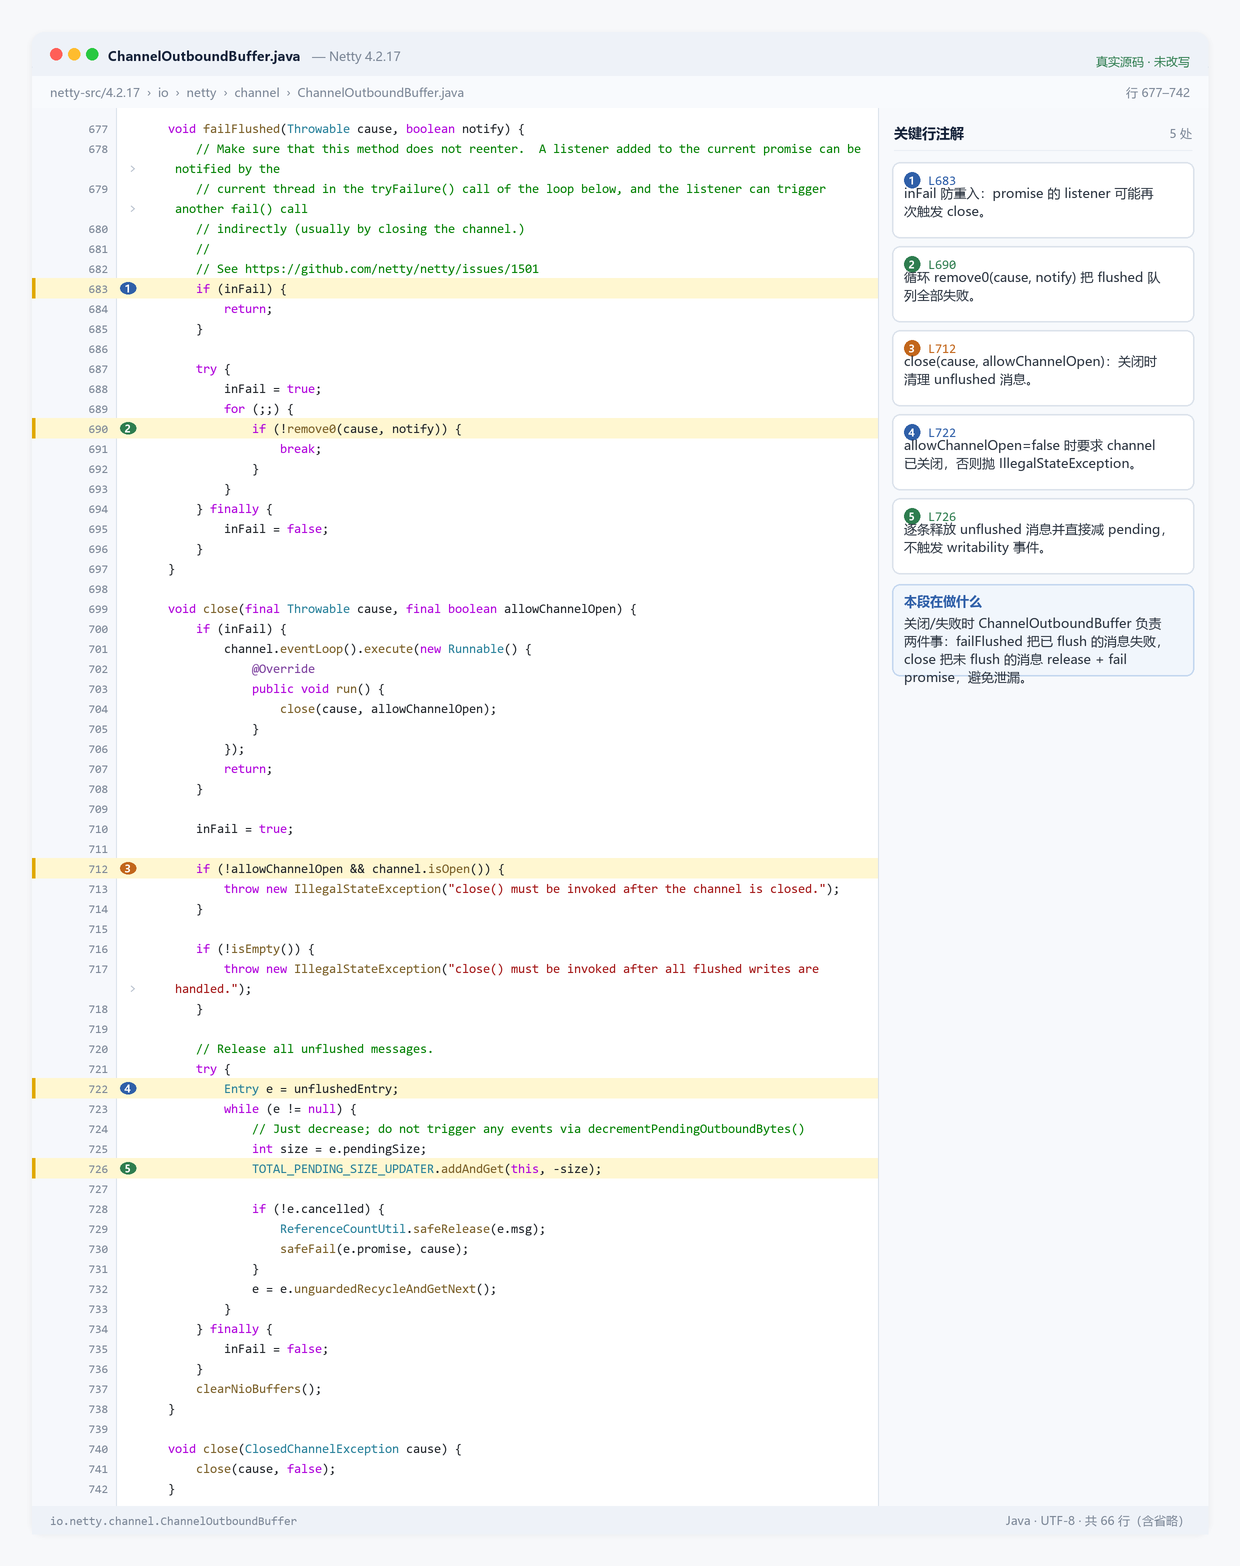
1 | void close(final Throwable cause, final boolean allowChannelOpen) { |
inFail 是防重入标记:promise 的失败回调可能再次触发
close,如果没有这个标记会递归。这个细节在写“断线时批量失败 pending
请求”的代码时很重要。
flush 才写 Socket
flush() 调用
outboundBuffer.addFlush(),把未 flush 的 entry
标记为可写;然后 flush0() 调用
doWrite(outboundBuffer)。addFlush
的核心是:
1 | Entry entry = unflushedEntry; |
write 只是把 entry 挂到 unflushed
链表上,flush 才把它移到 flushed 链表,doWrite
才能看到。所以调用 write 之后不
flush,数据永远不会发出去;反过来,writeAndFlush
等于两步一起做。
flush0 在 AbstractChannel 里:
1 | protected void flush0() { |
inFlush0 防止 flush 重入;isActive
检查防止在连接未激活时写;handleWriteError
处理写失败(自动关闭或 shutdownOutput)。
ChannelOutboundBuffer.addMessage
每加一条消息,incrementPendingOutboundBytes 就累加 pending
字节:
1 | long newWriteBufferSize = TOTAL_PENDING_SIZE_UPDATER.addAndGet(this, size); |
超过高水位(默认 64KiB)时,Channel 变为不可写,触发
channelWritabilityChanged;降到低水位(默认
32KiB)以下才恢复可写。isWritable()、bytesBeforeWritable()、bytesBeforeUnwritable()
都是围绕这个 pending 值算出来的。
doWrite 在 AbstractNioByteChannel 里循环把
ChannelOutboundBuffer 里的 ByteBuf 写到 Socket:
1 | protected void doWrite(ChannelOutboundBuffer in) throws Exception { |
doWriteInternal 调用 doWriteBytes(buf)
真正写 Socket,写多少就 in.progress(...) 多少;写不完时
incompleteWrite 会注册 OP_WRITE,等 Socket
可写再继续。写完后移除 OP_WRITE。这就是“write
不保证立刻发出去”的源码依据。
NioSocketChannel 还覆写了 doWrite,用
gather write(writev)一次写多个 ByteBuf:
1 | protected void doWrite(ChannelOutboundBuffer in) throws Exception { |
ChannelOutboundBuffer.nioBuffers(...) 把多个 ByteBuf
的底层 ByteBuffer
收集成数组,SocketChannel.write(ByteBuffer[])
一次系统调用写多个缓冲区。这减少了系统调用次数,但要求所有消息都是
ByteBuf,且总大小受 maxBytesPerGatheringWrite 限制。
writeSpinCount 是每次 flush 最多做多少次写尝试,默认
16。写不完就 incompleteWrite:如果 spin 次数用完,注册
OP_WRITE;否则把 flush 任务重新投递到
EventLoop,稍后再试。
flush0 在 NIO 下的特殊处理
AbstractNioChannel 覆写了 flush0:
1 | protected final void flush0() { |
如果 OP_WRITE 已经注册,说明之前有写没完成,这时不重复
flush,等 OP_WRITE 事件来了再
forceFlush。这避免了每次 writeAndFlush 都尝试一遍写、但
Socket 仍然不可写 的空转。
Selector 就绪事件的处理顺序
AbstractNioChannel.handle
里,就绪事件不是随便处理的:
1 | if (nioReadyOps.contains(NioIoOps.CONNECT)) { |
先 CONNECT,再 WRITE,最后
READ。写优先是为了尽快把积压的数据写出去、释放内存;读放在最后,是因为读可能触发业务处理,耗时更长。这个顺序在源码里有注释说明,不是随意的。
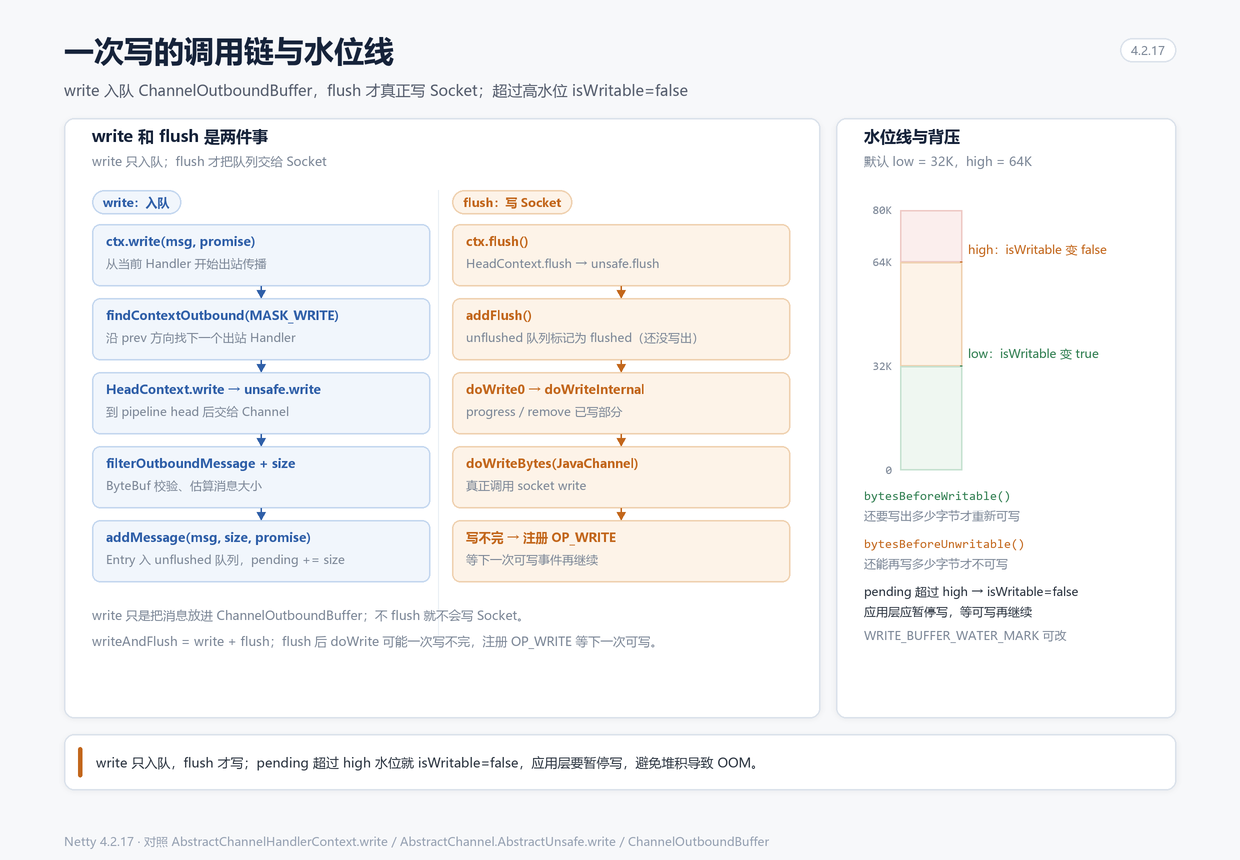
ReadWriteWalkthrough 在真实连接上观察水位线:
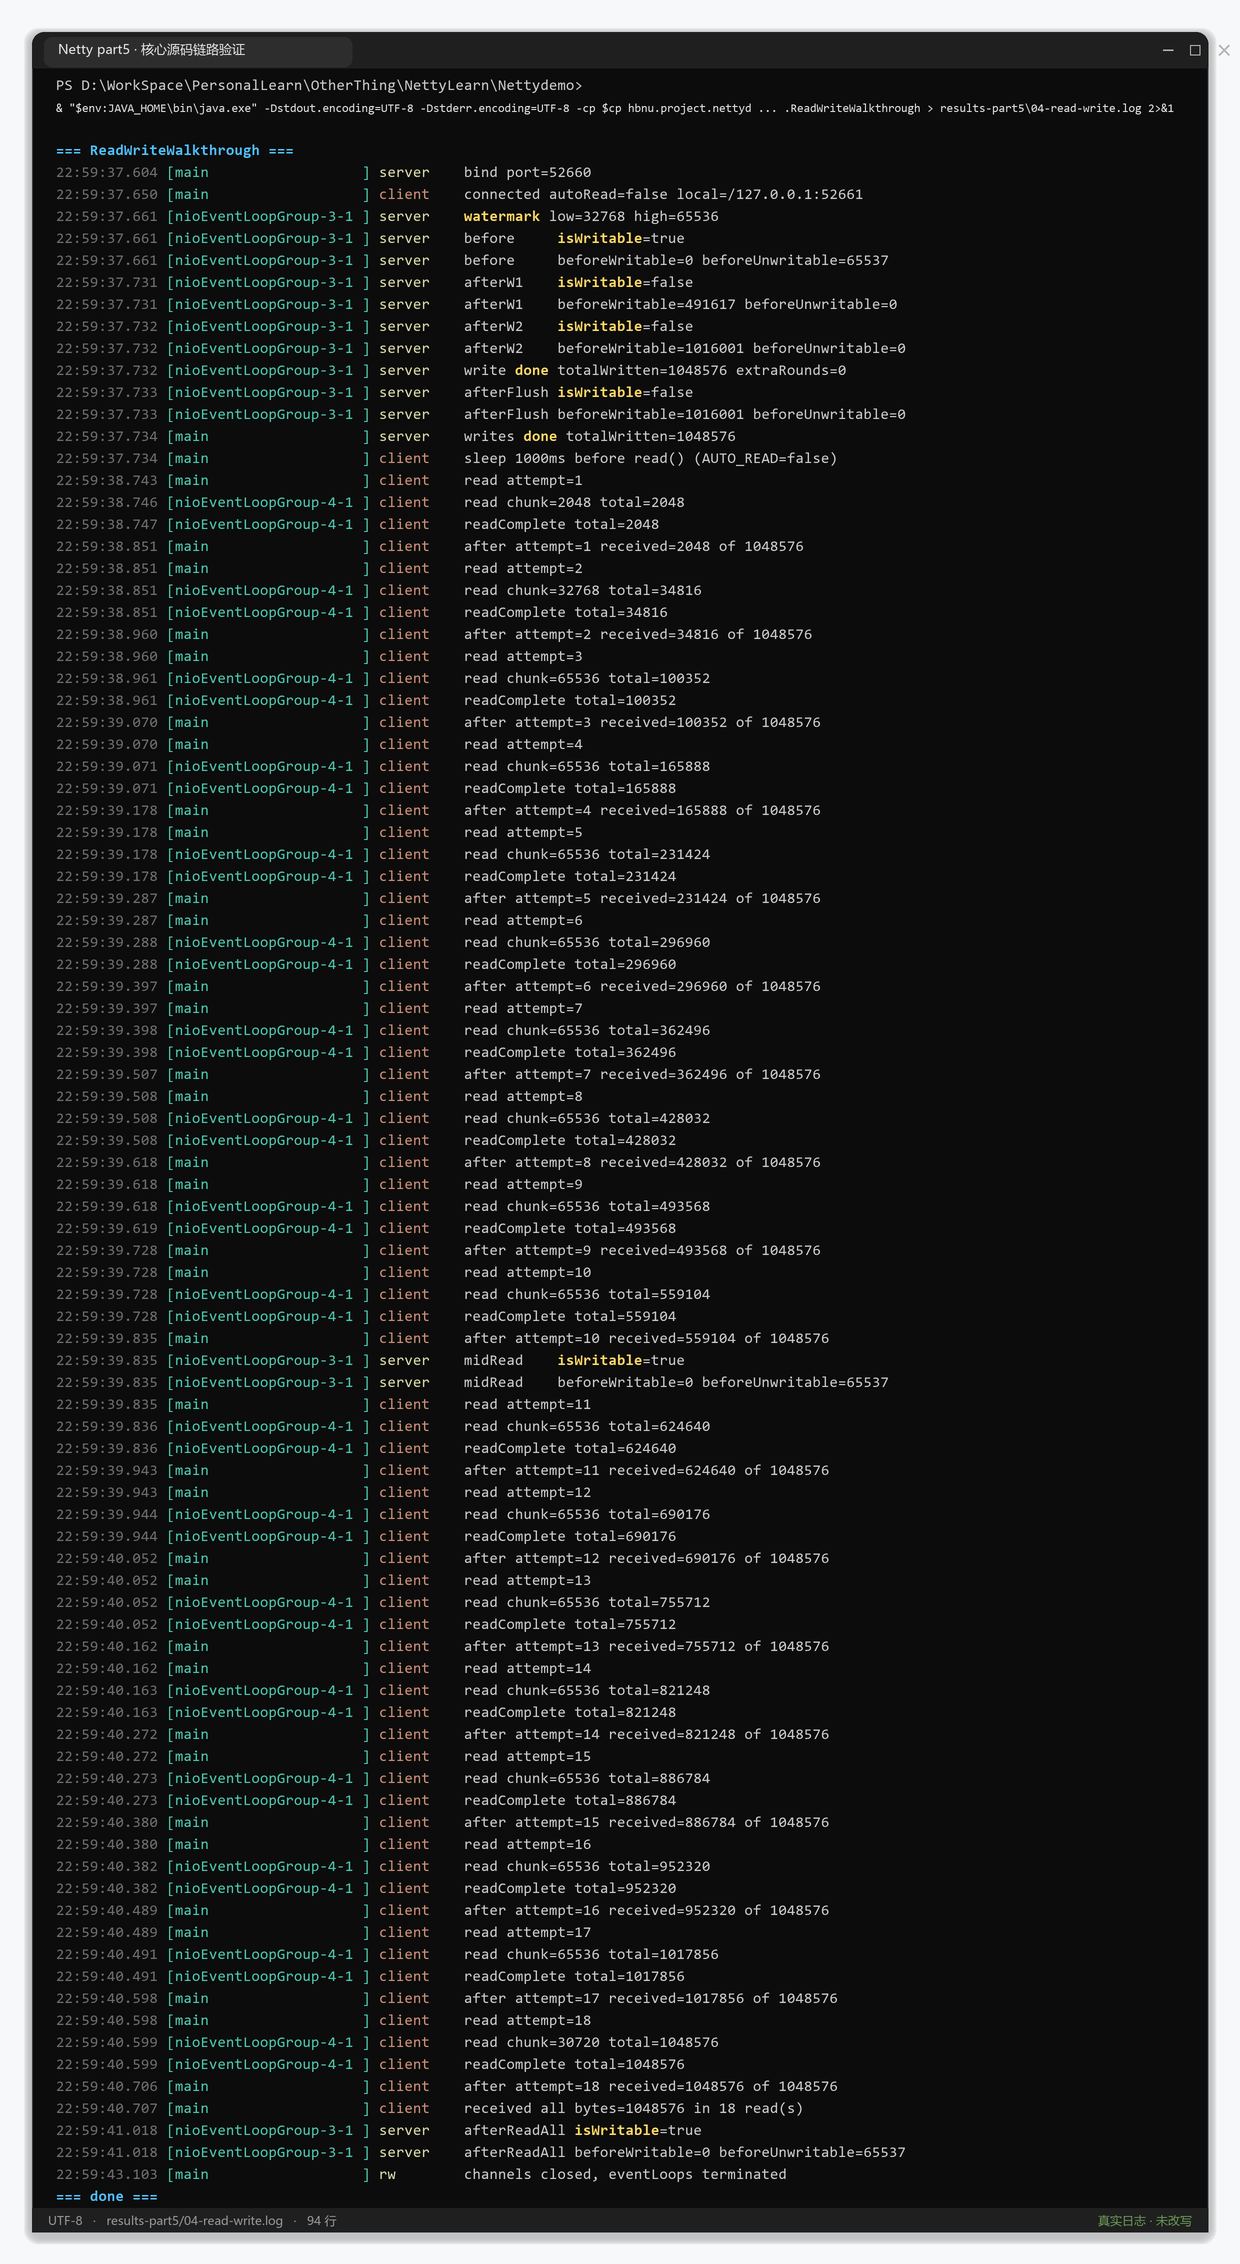
日志里的
isWritable、bytesBeforeWritable、bytesBeforeUnwritable
会随 pending 字节变化,和 ChannelOutboundBuffer
的判断完全一致。这次实测的值是:
1 | watermark low=32768 high=65536 |
写第一块 512KB 时 pending 超过高水位,Channel
从可写变成不可写;第二块继续积压,beforeWritable
继续变大;客户端读走 1MB 后,pending 降到低水位以下,Channel
恢复可写,beforeUnwritable 回到 65537。这个 65537 也说明
bytesBeforeUnwritable
的计算包含了“还能再写多少字节”的边界。
ChannelOutboundBuffer 里这两个值的计算也解释了 65537
的来源:
1 | public long bytesBeforeUnwritable() { |
高水位是“超过才不可写”,低水位是“低于才恢复可写”,所以两边都
+1。pending 为 0 时 65536 - 0 + 1 = 65537,和日志一致。
水位线的实际意义
水位线不是“TCP 发送缓冲”,而是 Netty 自己的
ChannelOutboundBuffer 积压量。它代表“已经调用
write、但还没真正写到 Socket 的字节数”。isWritable=false
时继续 write
不会报错,只会继续积压,所以业务要主动检查并降级、限流或断开慢客户端。
传播
Context 链表与两个方向
Pipeline 内部是 AbstractChannelHandlerContext
的双向链表,head 和 tail 是两个哨兵。每个 Context 记录
handler、executor、executionMask,以及前后指针。
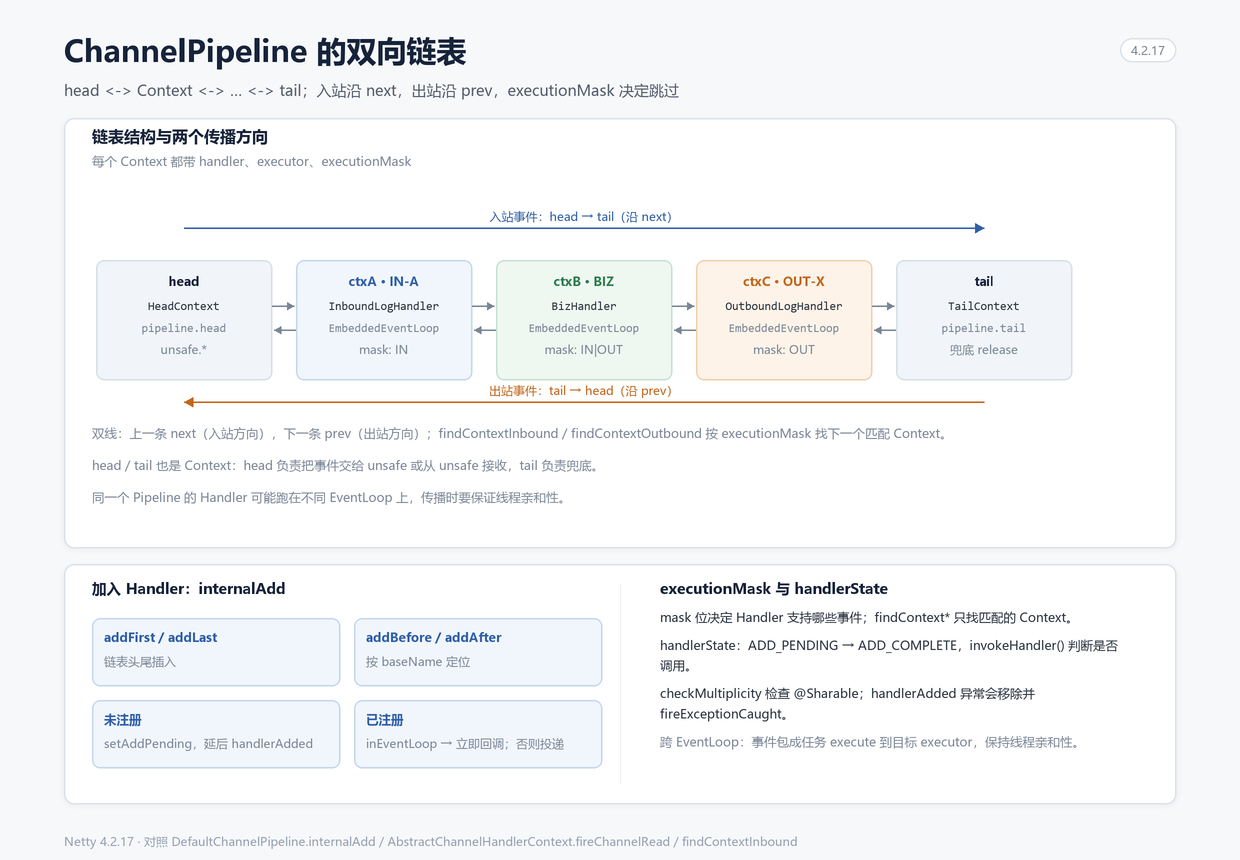
- 入站:
findContextInbound从next往后找,跳过不处理入站事件的 Handler; - 出站:
findContextOutbound从prev往前找,跳过不处理出站事件的 Handler; - 如果下一个 Handler 的 executor 不是当前线程,事件会被投递到它的 executor 执行。
skipContext 里有一个细节:只有“executor 相同且 mask
不匹配”才跳过;executor 不同时不能跳过,否则会破坏 handler
的执行顺序。这是业务线程组场景下的关键逻辑。
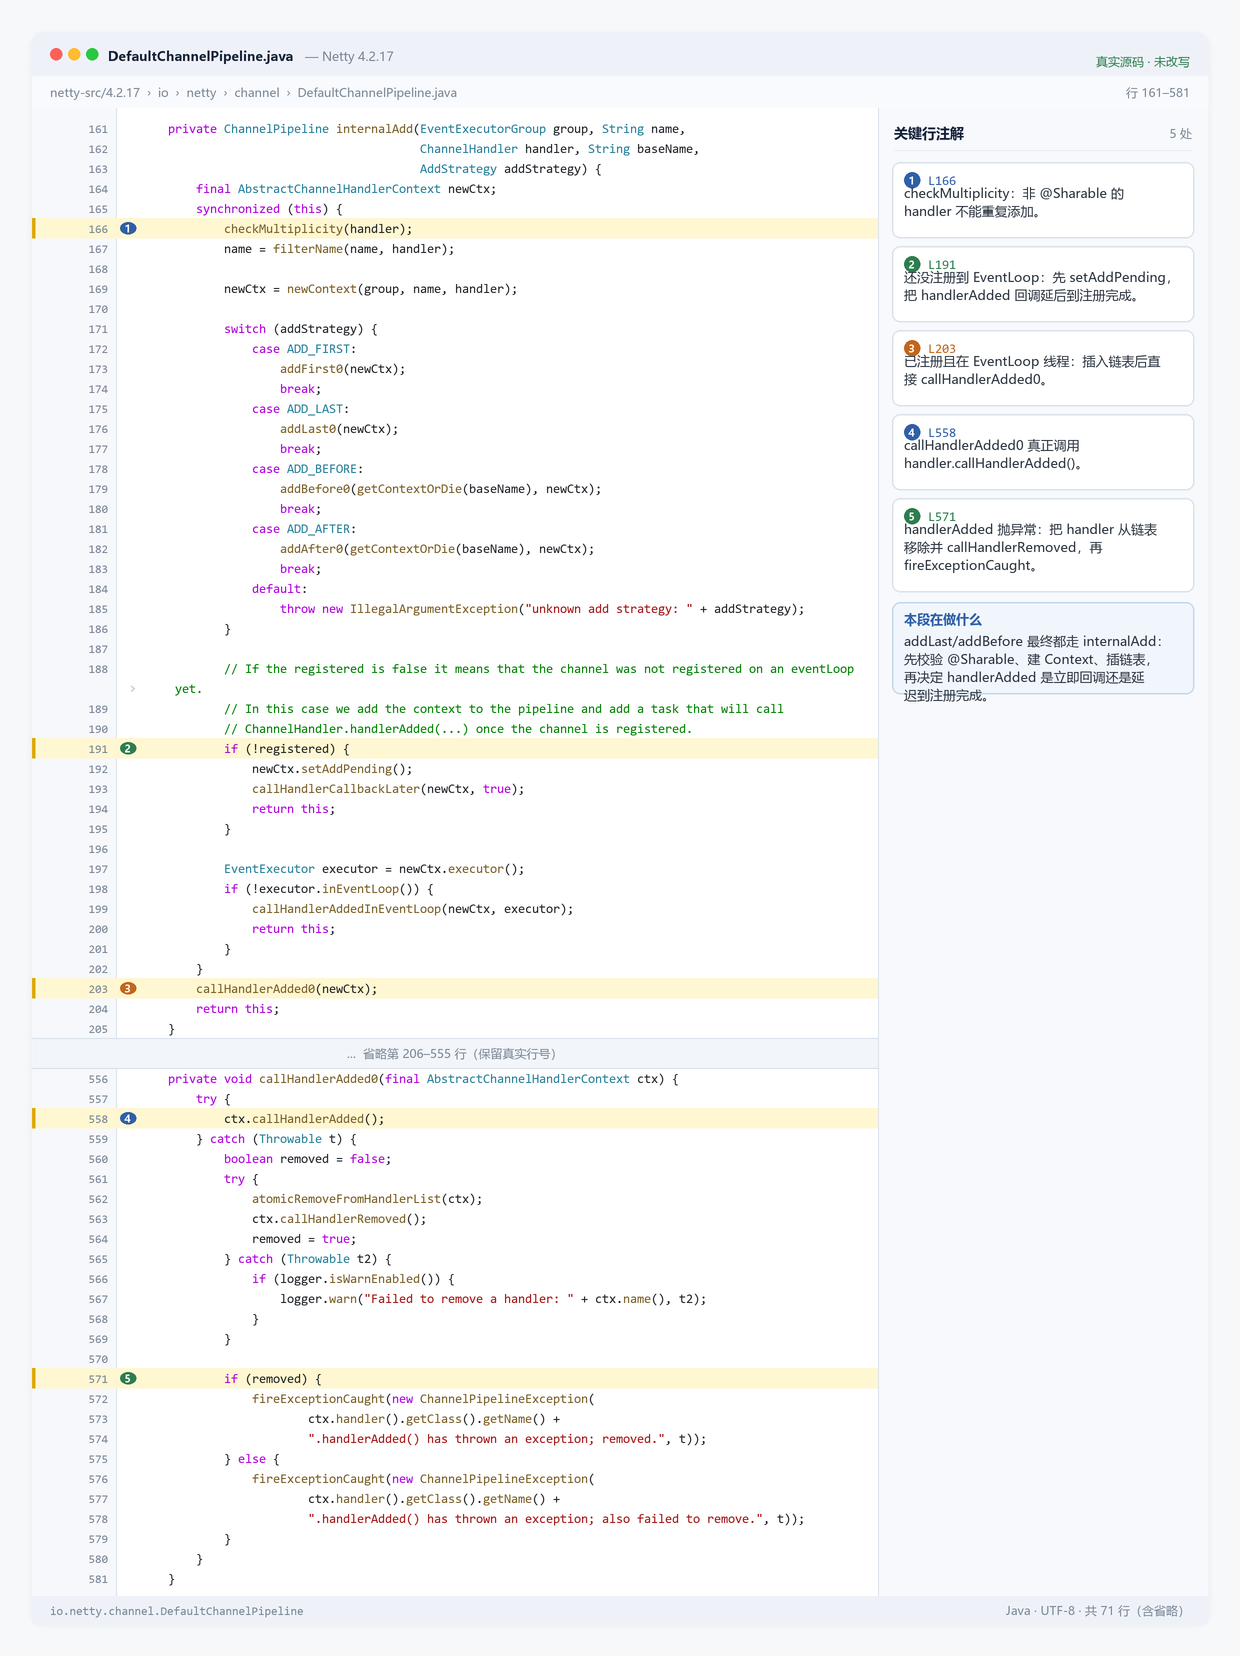
Pipeline 的链表怎么插
DefaultChannelPipeline 的 addLast 最终走
internalAdd:
1 | private ChannelPipeline internalAdd(EventExecutorGroup group, String name, |
链表插入本身只是四行指针操作,比如 addLast0:
1 | private void addLast0(AbstractChannelHandlerContext newCtx) { |
真正复杂的是 handlerAdded 的时机:
- Channel 还没注册时,只把 Context 挂进链表,设置
ADD_PENDING,把handlerAdded放到待执行队列; - Channel 注册完成后,
register0里的pipeline.invokeHandlerAddedIfNeeded()统一补发; - 已经注册且当前线程是 Context 的 executor,才直接调用
callHandlerAdded0; - 否则投递到 executor,异步补发。
这解释了两个常见疑问:
- 为什么在
channelRegistered里能看到后面添加的 Handler?因为 Handler 可能已经挂进链表,但handlerAdded还没跑; - 为什么在
handlerAdded里ctx.pipeline().addLast(...)不会乱序?因为ChannelInitializer在handlerAdded里装配,装配出的 Handler 会按链表顺序依次收到handlerAdded。
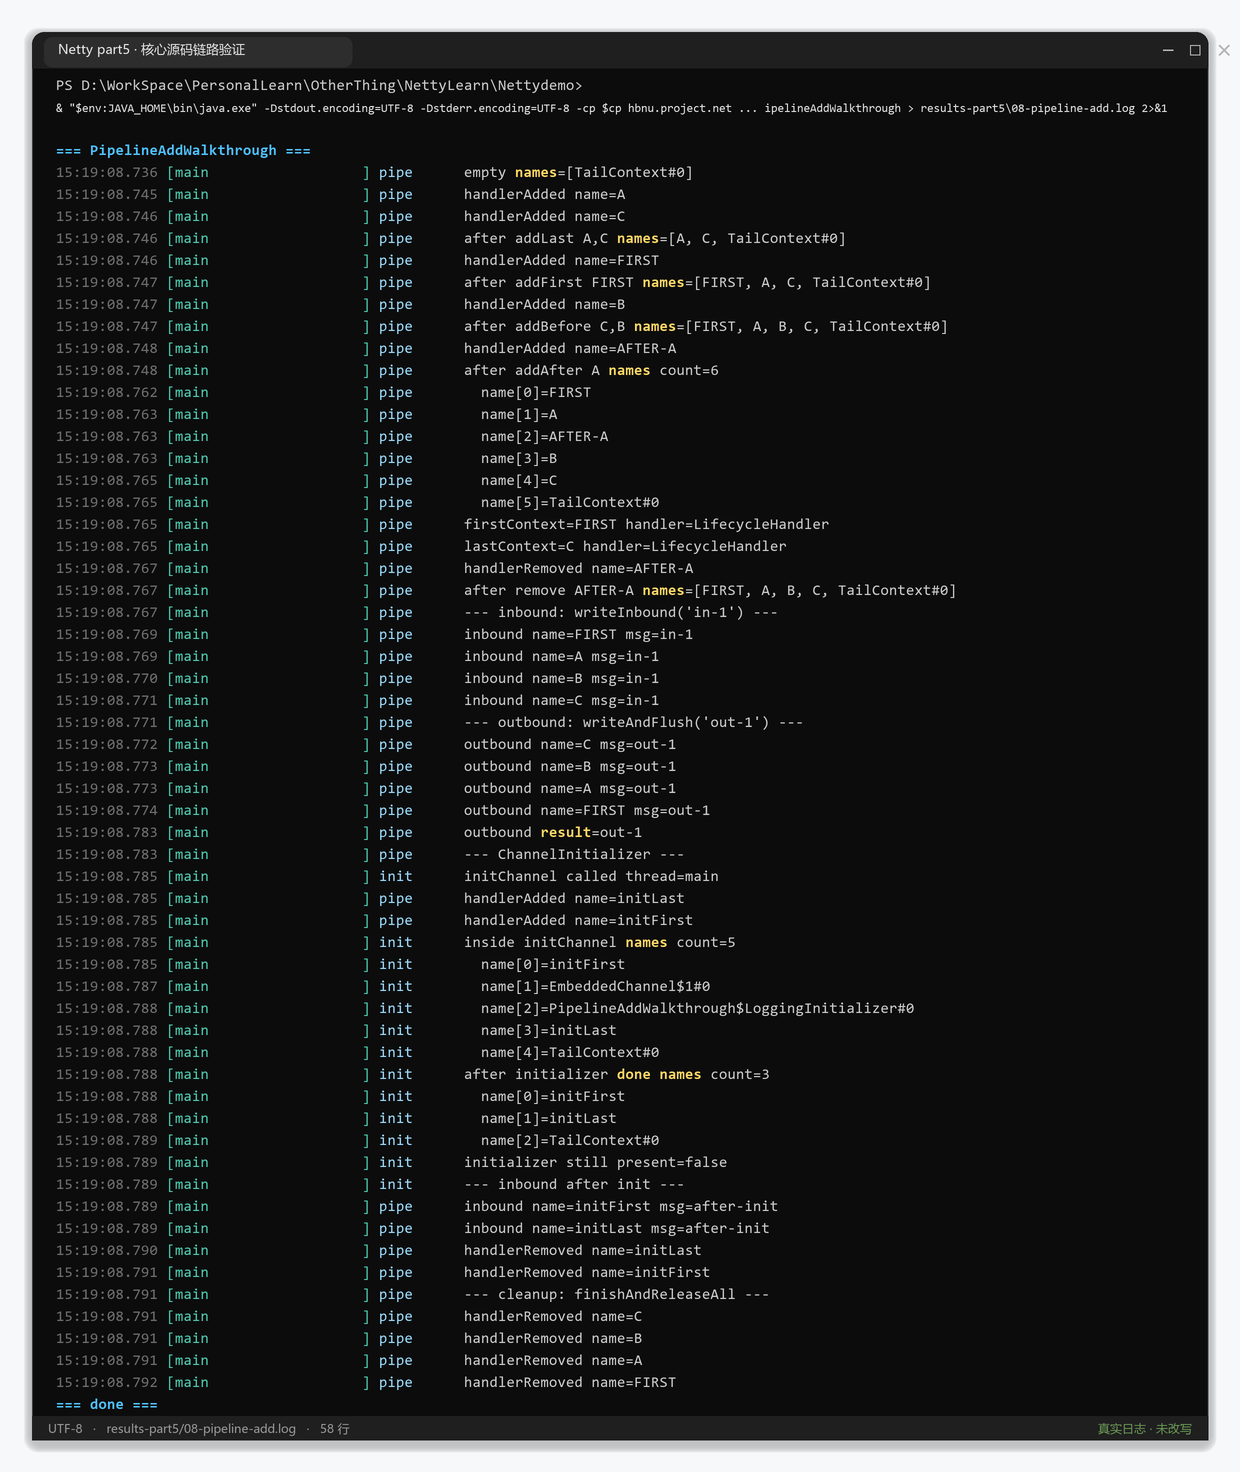
PipelineAddWalkthrough
的真实日志把动态添加/移除的顺序打印出来:
@Sharable 与重复添加
checkMultiplicity 在插入前检查:
1 | private static void checkMultiplicity(ChannelHandler handler) { |
一个 Handler 实例如果没有
@Sharable,只能被添加一次。重复添加会直接抛
ChannelPipelineException,而不是等到运行时出现状态串扰。这个检查放在
synchronized (this)
里,保证并发添加时也只有一个能成功。
handlerState 与 invokeHandler
Context
不是一挂进链表就能处理事件。AbstractChannelHandlerContext
有三个状态:
ADD_PENDING:已挂链表,handlerAdded还没执行;ADD_COMPLETE:handlerAdded已执行;REMOVE_COMPLETE:handlerRemoved已执行。
invokeHandler() 决定这次事件要不要交给 Handler:
1 | boolean invokeHandler() { |
ordered 表示 Handler 是否要求严格顺序。普通 Handler 在
ADD_PENDING 时也可以先处理事件;带 executor group 的
Handler 必须等 handlerAdded 完成,否则会破坏顺序。
这两个字段在 Context 构造时就确定:
1 | AbstractChannelHandlerContext(DefaultChannelPipeline pipeline, EventExecutor executor, |
executionMask 由
ChannelHandlerMask.mask(handlerClass) 计算:它根据 Handler
实现的接口和 @Skip 注解,把“这个 Handler
关心哪些事件”编码成一个位掩码。findContextInbound/Outbound
用位运算跳过不关心的 Handler,避免每个事件都做 instanceof
判断,这是 Pipeline 高频路径上的一个优化。
ordered 的规则是:由 EventLoop
驱动(executor == null)或 executor 是
OrderedEventExecutor 时,事件顺序有保证;否则 Handler
可能并发执行,handlerAdded 必须完成后才能处理事件。
contextExecutor 是 executor()
的缓存:第一次调用时解析成 childExecutor 或
channel().eventLoop(),之后直接读字段。注册到新的 EventLoop
时,AbstractChannel.register 会清空所有 Context 的
contextExecutor 缓存,避免拿到旧的 executor。
异常传播与 tail 兜底
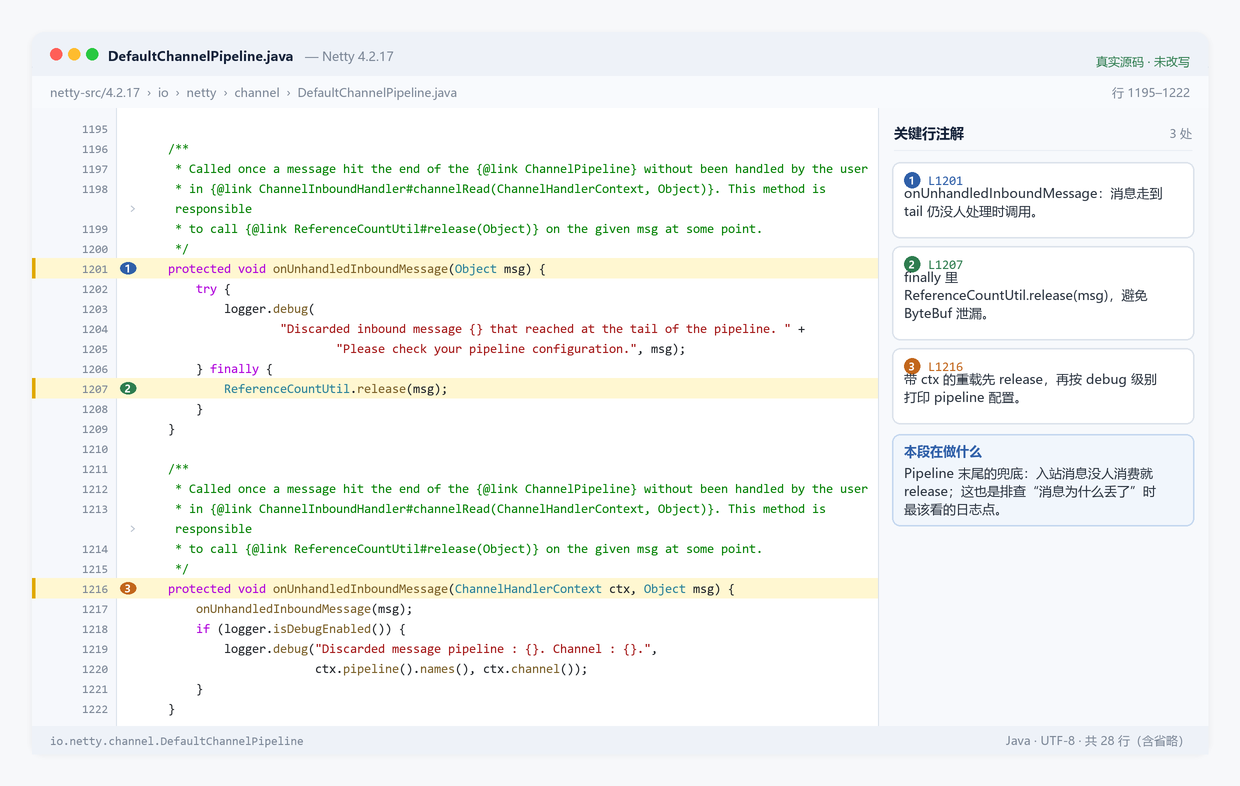
入站事件一路走到
tail,如果没人处理,TailContext.channelRead 调用
onUnhandledInboundMessage:
1 | protected void onUnhandledInboundMessage(Object msg) { |
异常则走 fireExceptionCaught,同样从当前 Context 往后找
MASK_EXCEPTION_CAUGHT,最后到 tail 的
onUnhandledInboundException,至少会打一条 warn
日志。业务如果不覆写
exceptionCaught,异常不会“消失”,但也不会自动关闭连接;是否关闭要业务自己决定。
head 与 tail 的职责
HeadContext
是出站事件的最后一站:bind/connect/write/flush/close 最终都调用
unsafe 的对应方法;入站事件则从 head 开始往 tail 传。
TailContext
是入站事件的最后一站,负责兜底释放没有被人消费的消息:
1 | protected void onUnhandledInboundMessage(Object msg) { |
这就是“消息一路没人处理,tail 会
release”的源码位置。TailContext.channelRead
直接调用这个方法,所以未处理的 ByteBuf 不会泄漏。
Promise 与 Future
ChannelFuture 与 Promise 的区别
Future 是只读的结果,Promise 是可写的
Future。Netty 里:
ChannelFuture继承Future<Void>,多了channel()、sync()、await();ChannelPromise继承ChannelFuture和Promise<Void>,可以setSuccess/setFailure;DefaultPromise是默认实现,DefaultChannelPromise在它上面绑定了 Channel。
业务代码大多数时候只拿到 ChannelFuture,但在 Handler
里创建写操作时拿到的是 ChannelPromise。理解 Promise
的状态机,才能理解“listener 什么时候执行、为什么 sync()
会死锁”。
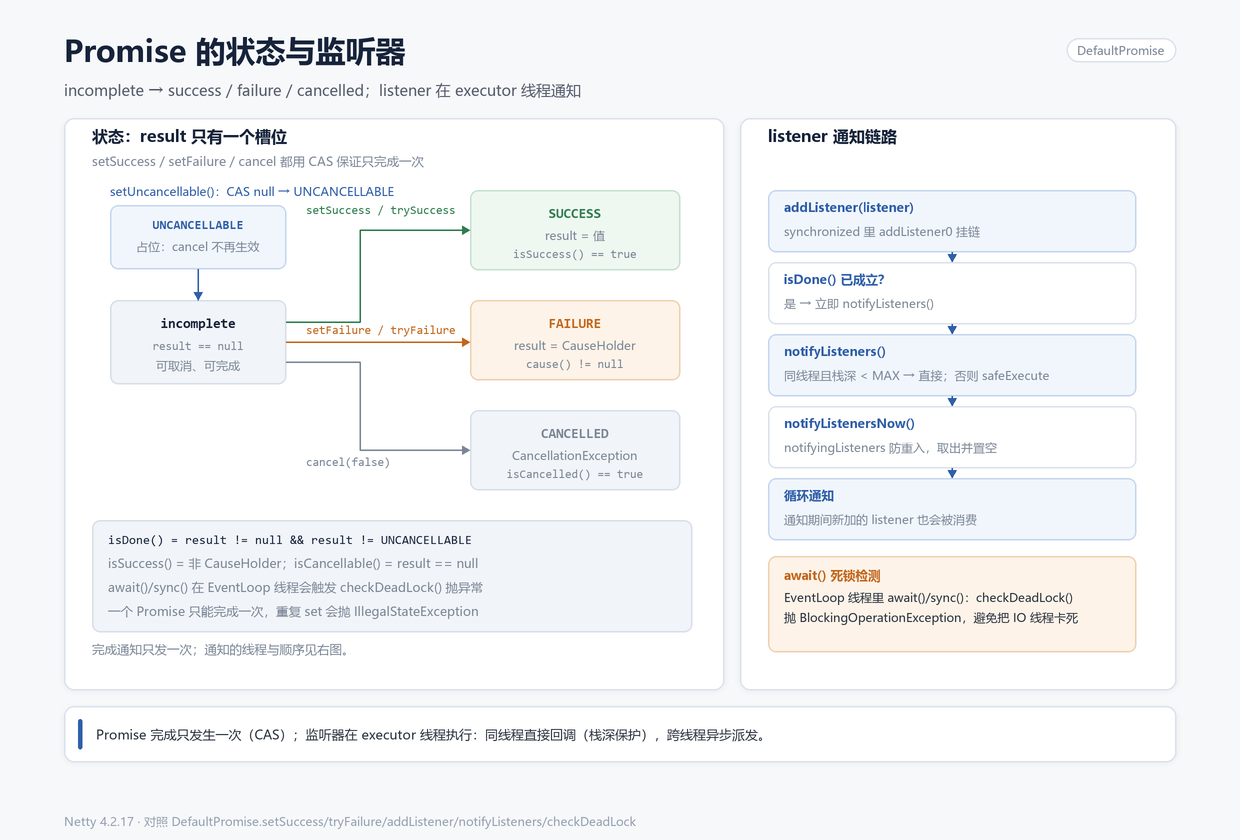
DefaultPromise 的状态
DefaultPromise 用一个
volatile Object result 表示状态:
null:未完成;SUCCESS:成功但没有返回值;- 普通对象:成功,对象就是返回值;
CauseHolder:失败,内部持有Throwable;CANCELLATION_CAUSE_HOLDER:已取消;UNCANCELLABLE:已标记不可取消。
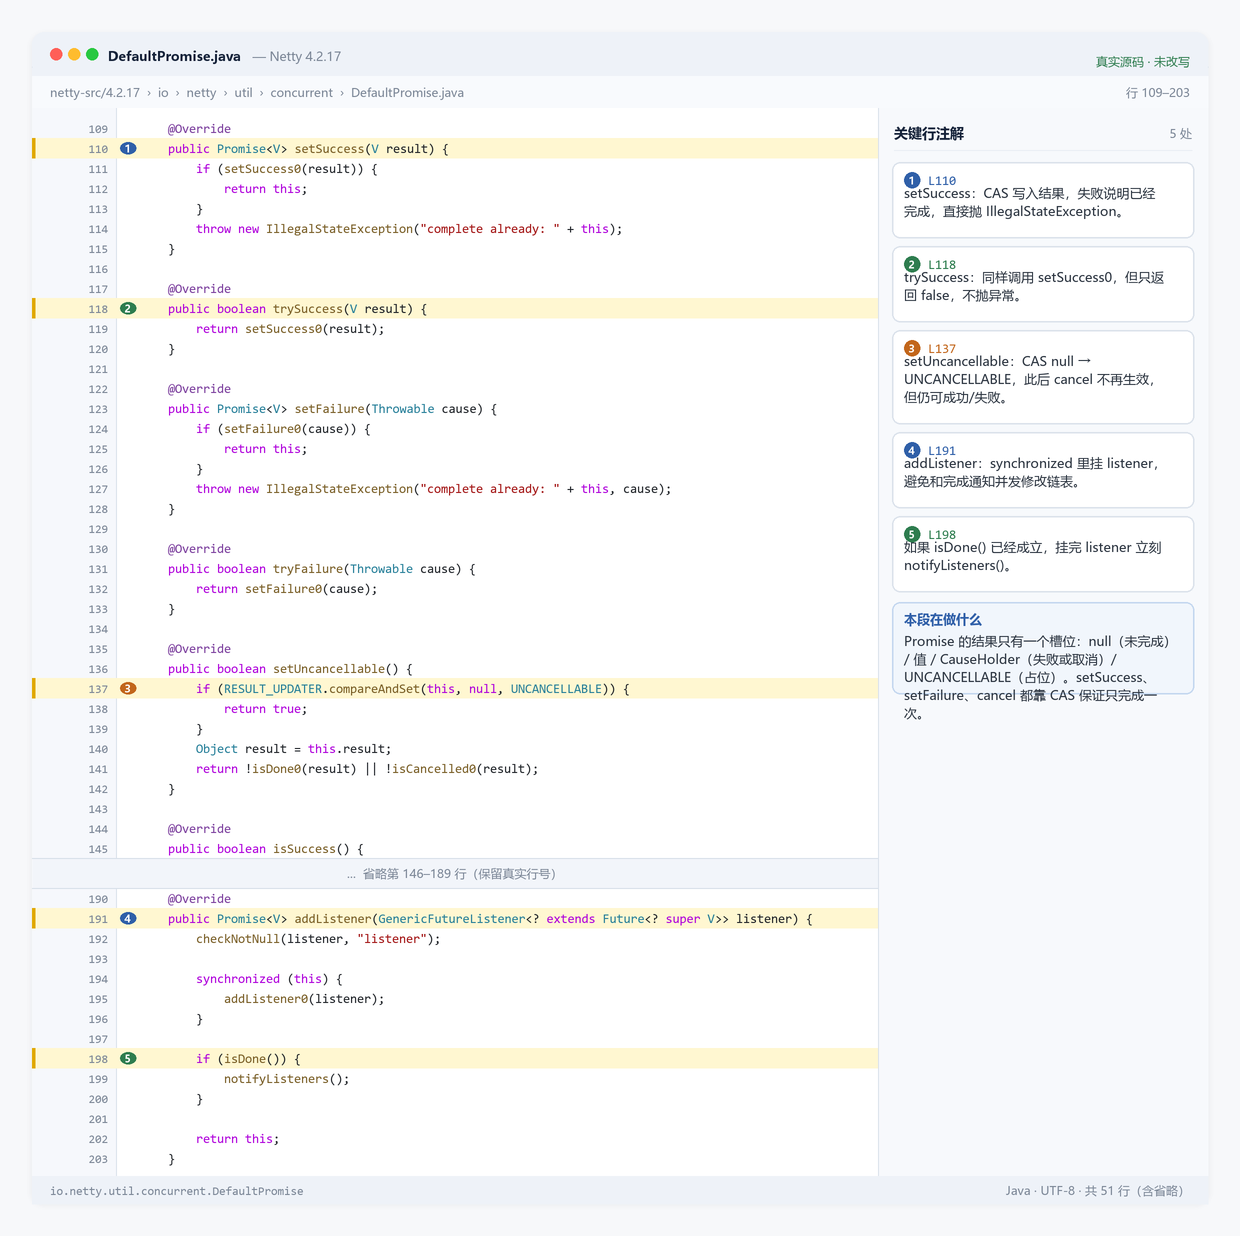
setSuccess 和 trySuccess
的区别只在“已完成时”:
1 | public Promise<V> setSuccess(V result) { |
setSuccess 重复调用会抛异常,trySuccess
返回 false。并发场景优先用
trySuccess/tryFailure,避免竞争时抛异常。
两者最终都走 setValue0:
1 | private boolean setValue0(Object objResult) { |
CAS 的期望值是 null 或
UNCANCELLABLE,所以一个 promise 只能从 未完成/不可取消
这种状态来变成完成,不能从成功再变失败。checkNotifyWaiters()
负责唤醒 await 的线程,同时返回是否有 listener
需要通知。
listener 在哪个线程执行
addListener 先把 listener 挂到 promise 上;如果 promise
已完成,立刻 notifyListeners():
1 | public Promise<V> addListener(GenericFutureListener<? extends Future<? super V>> listener) { |
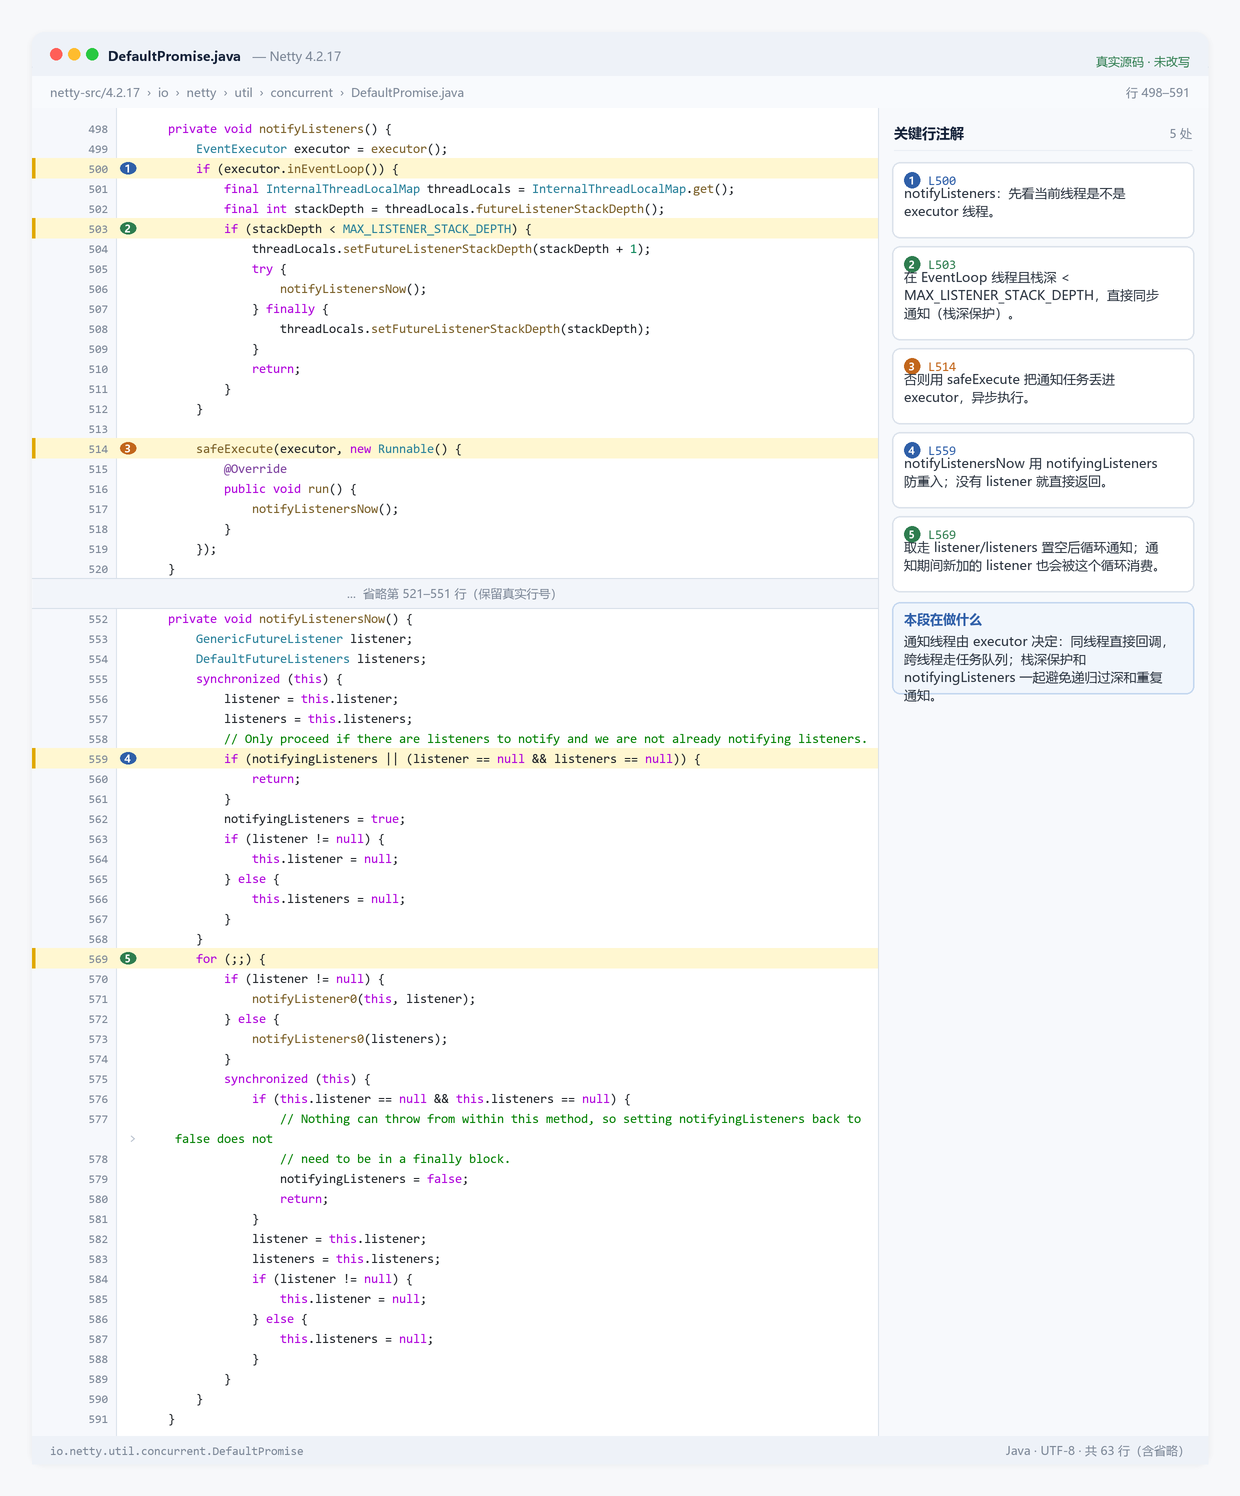
notifyListeners 的关键分支:
1 | private void notifyListeners() { |
三个结论:
- 如果当前线程是 promise 的 executor,listener 会同步执行,不会投递到队列;
- 如果当前线程不是 executor,listener 会投递到 executor,异步执行;
- 递归深度超过 8 层时改为异步,避免 listener 里再完成 promise 导致
StackOverflowError。
所以“addListener 一定异步”是错的,“addListener 一定在 EventLoop 线程”也只在 promise 绑定 EventLoop 时成立。
await 为什么会死锁
DefaultPromise.await 会先
checkDeadLock():
1 | protected void checkDeadLock() { |
如果当前线程就是 promise 的 EventLoop,await() 会直接抛
BlockingOperationException,而不是傻等。因为 EventLoop
线程被阻塞后,完成 promise 的任务永远没机会执行,等下去就是死锁。
这也是为什么:
sync()/await()只能用在非 EventLoop 线程;- 在 Handler 里等另一个 Channel 的操作,必须用 listener 或
CompletableFuture,不能sync(); ChannelFuture.sync()在 EventLoop 线程里同样会抛BlockingOperationException。
PromiseWalkthrough 在 EventLoop 任务里对一个未完成
Promise 调 await(),日志会打印
BlockingOperationException,和源码里的
checkDeadLock 对应。
listener 顺序与完成顺序
同一个 promise 上,listener 按添加顺序执行;但“promise 完成”和“Channel 事件”之间没有全局顺序。
例如客户端连接:
1 | boolean promiseSet = promise.trySuccess(); // 先通知 connect listener |
所以 connect().sync() 返回时,channelActive
可能还没跑。写操作也一样:write 的 promise
成功只代表数据被写进了 Socket
缓冲,不代表对端收到;closeFuture 完成也不代表
channelUnregistered 已经执行。
PromiseCombiner 的边界
PromiseCombiner 把多个 Future
聚合成一个,但它不是“超时器”:
- 它只在所有 Future 完成时完成聚合 Promise,任一失败则失败;
- 它不负责取消子 Future;
- 它不支持“超时后自动失败”,要业务自己加定时任务。
真正的超时控制还是 ScheduledFuture +
tryFailure,或者
CompletableFuture.orTimeout。这部分在 part4
的客户端连接里已经用过。
PromiseWalkthrough 的真实日志:
日志里能看到 listener A/B 的顺序、完成后追加 listener C
的线程、tryFailure 的 cause,以及 EventLoop 内
await 抛出的 BlockingOperationException。
解码器源码
ByteToMessageDecoder.channelRead
ByteToMessageDecoder 是帧解码器的基类。它的
channelRead 做四件事:
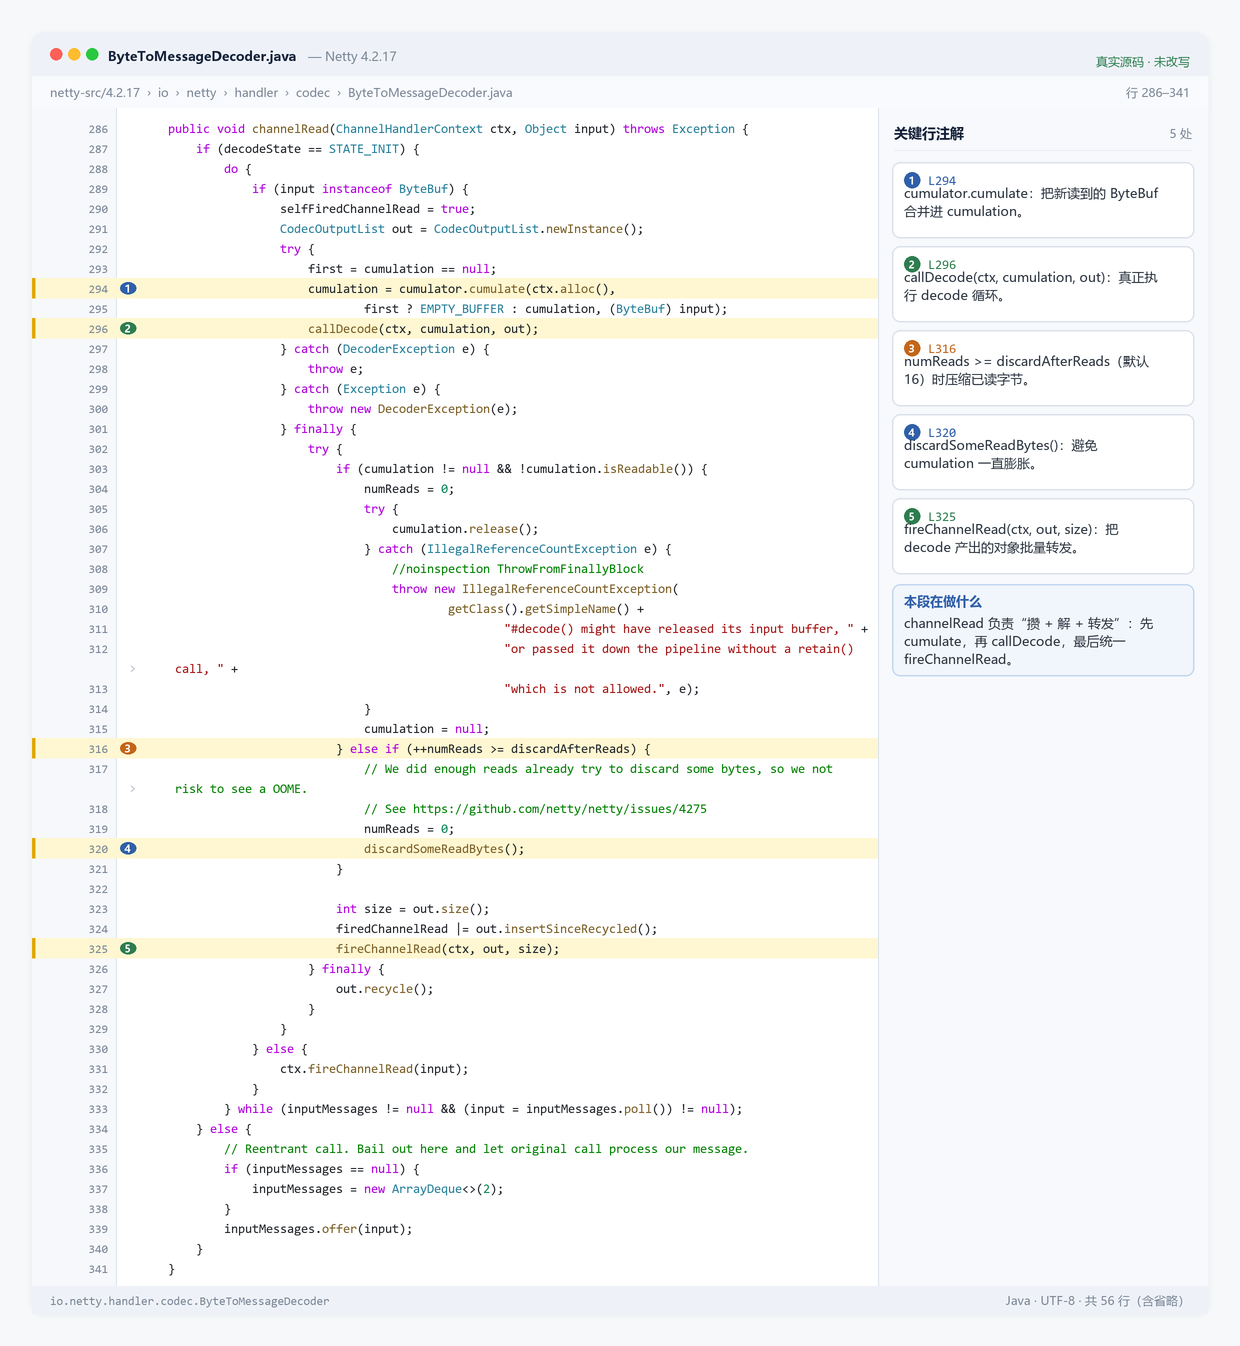
1 | first = cumulation == null; |
- 第一次读时 cumulation 为空,把输入直接作为累积区;
- 之后每次把新读到的 ByteBuf 追加到 cumulation;
- 调用
callDecode尝试解码; - 如果 cumulation 没有可读字节,释放并置空;否则每 16 次读后
discardSomeReadBytes(),避免累积区无限增长。
fireChannelRead 会把 out
里的消息逐个传给后面的 Handler。如果 out 里有多个消息,一次
channelRead 就会触发多次下游 channelRead。
cumulation 的三种处理
ByteToMessageDecoder 的累积器不是每次都拷贝。它有两种
Cumulator:
MERGE_CUMULATOR:把新 ByteBuf 合并到旧 cumulation,必要时扩容;COMPOSITE_CUMULATOR:把多个 ByteBuf 组合成CompositeByteBuf,尽量避免拷贝。
默认用
MERGE_CUMULATOR,因为大多数协议帧不大,连续内存对后续解析更友好。first
为 true 时直接把输入当 cumulation,省掉一次拷贝;之后才走合并逻辑。
累积区什么时候释放?
1 | if (cumulation != null && !cumulation.isReadable()) { |
- cumulation 没有可读字节:释放并置空,下一轮重新开始;
- 还有可读字节:每
discardAfterReads(默认 16)次读后discardSomeReadBytes(),把已经读过的部分丢掉,避免 cumulation 无限增长; discardSomeReadBytes()只移动 readerIndex/压缩内存,不改变未读数据。
discardAfterReads 不是“每 16 个字节”,是“每 16 次
channelRead”。所以一个只发了半帧、之后长时间没数据的连接,cumulation
会一直保留那半帧,直到有更多数据或连接关闭。这是半包场景的正常行为,不是泄漏。
out 列表与重入
channelRead 里用
CodecOutputList.newInstance() 创建
out,解码完成后
fireChannelRead(ctx, out, size),最后
out.recycle()。CodecOutputList
是池化的,避免每次读都创建 ArrayList。
解码器还可能被重入:decode 里调用
ctx.fireChannelRead(...),下游 Handler
又触发一次读/解码。ByteToMessageDecoder 用
inputMessages 队列处理重入:
1 | if (decodeState == STATE_INIT) { |
这样同一个解码器不会在 decode 还没结束时被嵌套调用,避免
cumulation 被两个线程/两层调用同时修改。
解码器的释放责任
ByteToMessageDecoder 只负责 cumulation 的释放,不负责
out 里消息的释放:
decode里out.add(...)的消息,所有权交给下游 Handler;- 下游如果是
SimpleChannelInboundHandler,它自动释放; - 下游如果是
ChannelInboundHandlerAdapter,业务必须自己释放; - 如果
decode抛异常,尚未交给下游的out消息由解码器/异常路径释放。
自定义解码器最常见的泄漏是:在 decode 里
readBytes 出一个新 ByteBuf,既没 out.add,也没
release。只要记住“要么交出去,要么释放”,就能避免大部分问题。
callDecode 的循环
callDecode 是解码循环的核心:
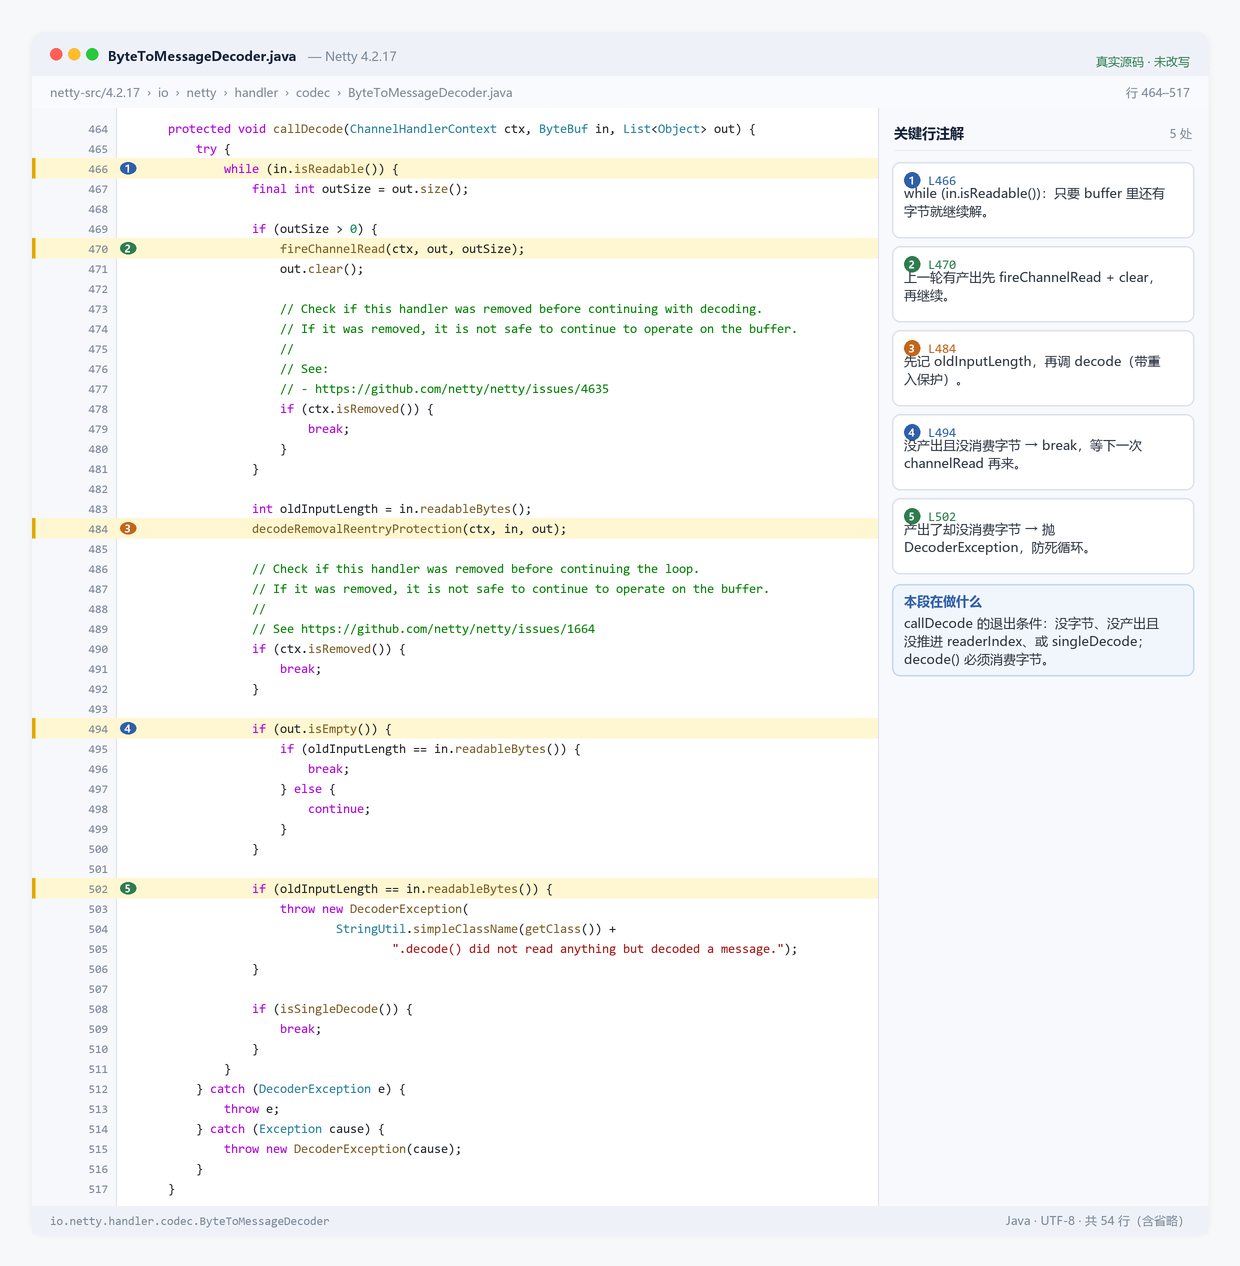
1 | while (in.isReadable()) { |
这段代码解释了自定义解码器的两个硬性要求:
- 数据不够时直接 return,不要消费字节,也不要
out.add; - 产出了消息就必须消费字节(推进
readerIndex),否则抛DecoderException。
decodeRemovalReentryProtection 还处理了“解码过程中
Handler 被移除”的情况,避免继续操作已经失效的 Buffer。
LengthFieldBasedFrameDecoder.decode
LengthFieldBasedFrameDecoder 是长度字段方案的实现。它的
decode 分几步:
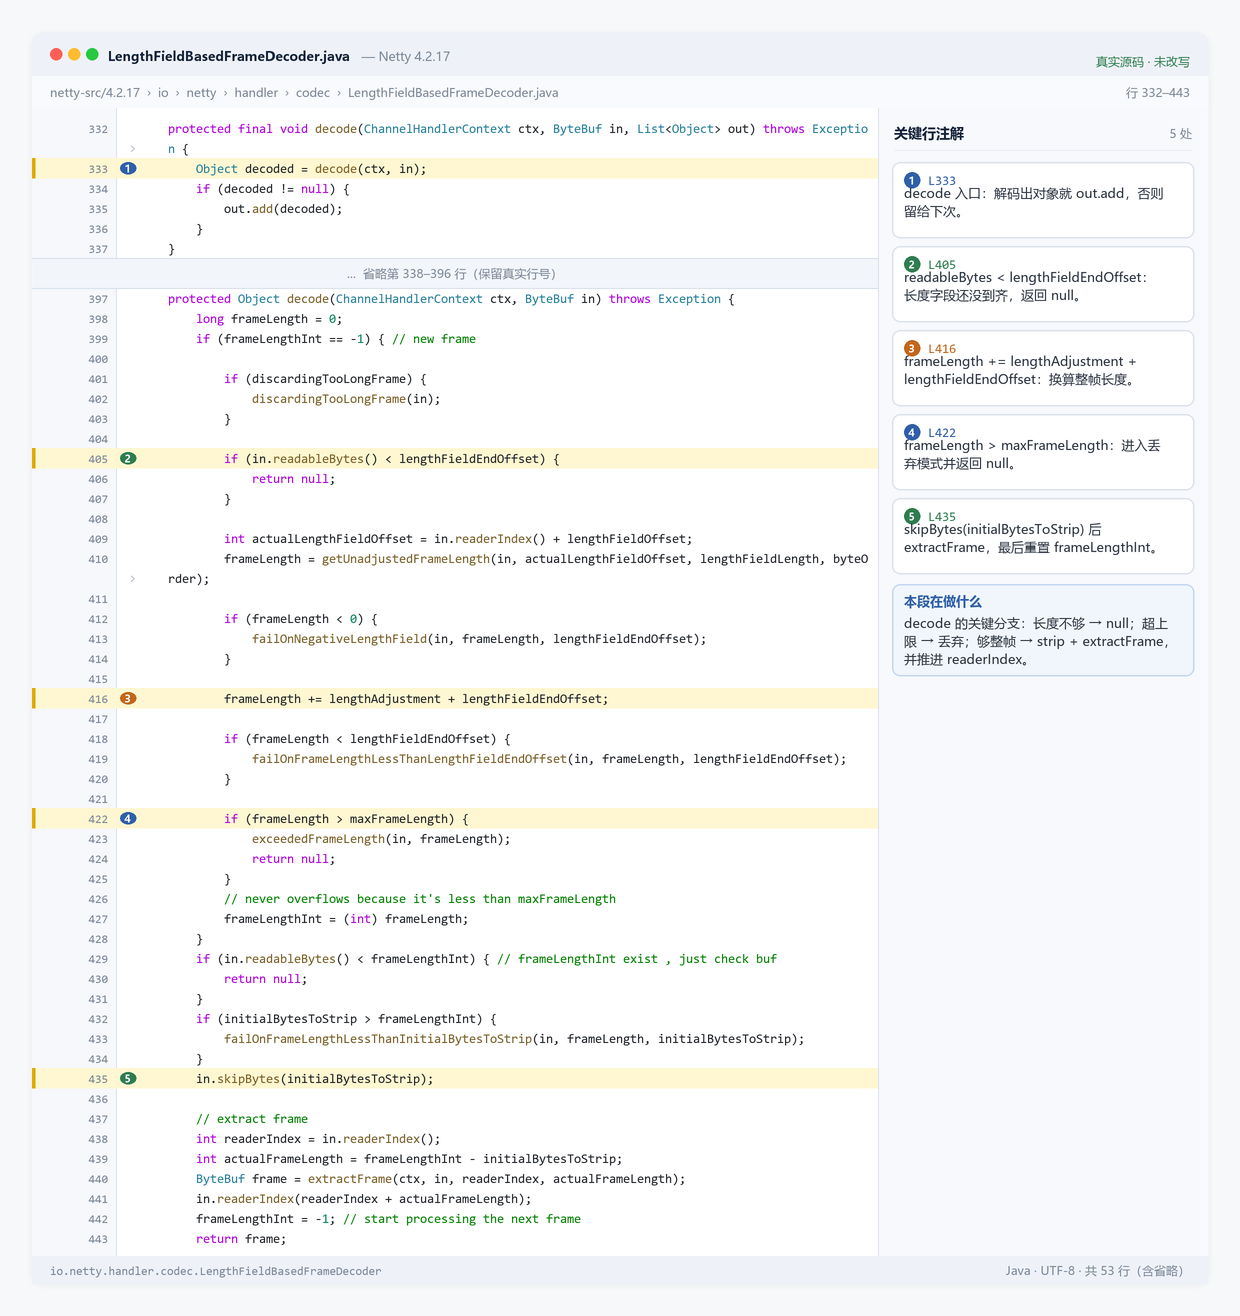
关键代码:
1 | if (frameLengthInt == -1) { // new frame |
逐段读:
frameLengthInt == -1表示当前没有在解析一帧,需要先读长度字段;readableBytes() < lengthFieldEndOffset表示连长度字段都没到齐,直接返回,ByteToMessageDecoder会保留 cumulation;getUnadjustedFrameLength支持 1/2/3/4/8 字节长度字段,按byteOrder读取;frameLength += lengthAdjustment + lengthFieldEndOffset就是上一篇反复强调的公式;maxFrameLength检查防止恶意长度;readableBytes() < frameLengthInt表示 body 还没到齐;skipBytes(initialBytesToStrip)剥掉帧头;extractFrame默认buffer.retainedSlice(index, length),返回共享内存的视图。
extractFrame 的实现:
1 | protected ByteBuf extractFrame(ChannelHandlerContext ctx, ByteBuf buffer, int index, int length) { |
所以解码出来的帧不是拷贝,业务处理完要释放;如果后面接
StringDecoder,它会负责把 ByteBuf 转成 String 并释放。
failFast 的逻辑在
failIfNecessary:failFast=true
时,第一次发现超长就抛异常;failFast=false 时,先进入
discardingTooLongFrame 模式,把字节丢弃,丢完再抛。
MessageToByteEncoder:出站编码的模板
入站是 ByteToMessageDecoder,出站是
MessageToByteEncoder。它的 write
方法只有一段:
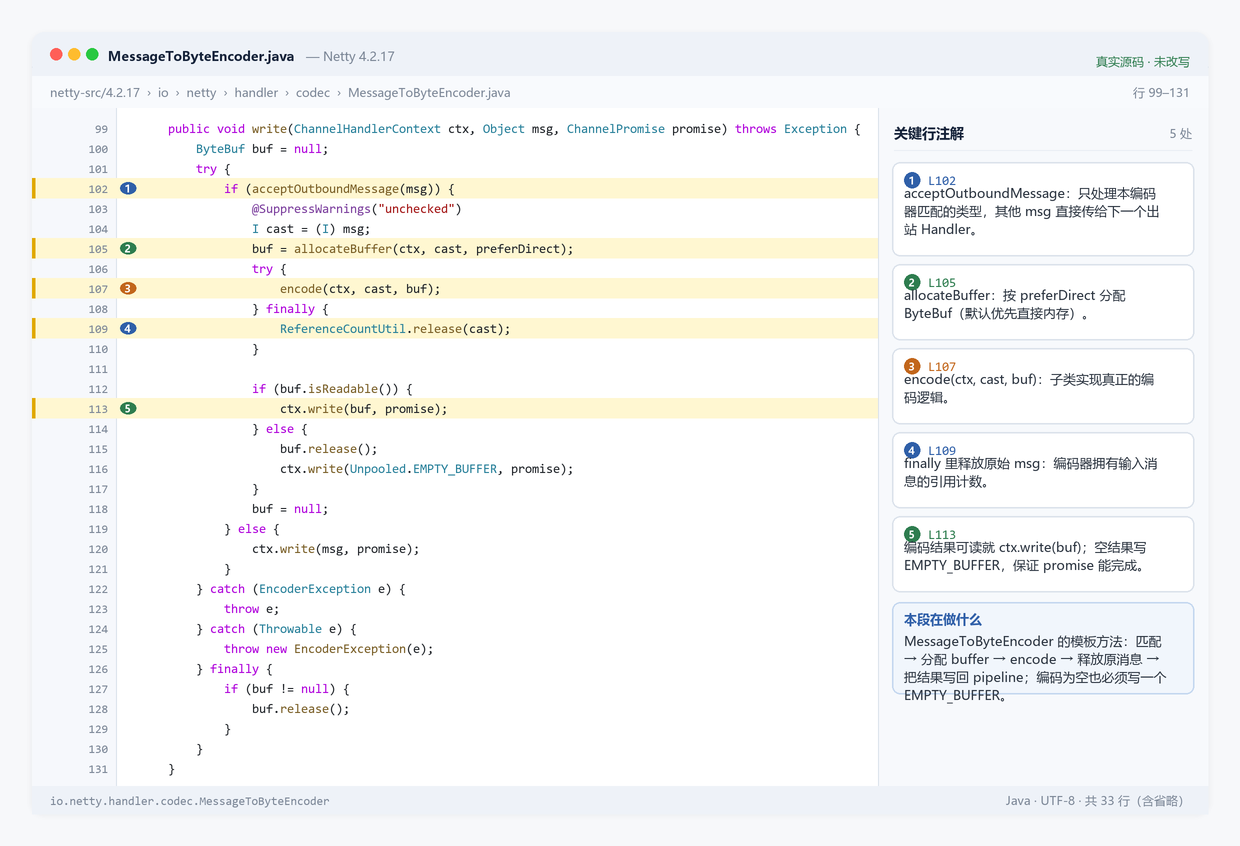
1 | public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception { |
这里有几个资源所有权细节:
- 编码完成后,原消息
cast会被 release;业务不要在encode外面再 release 一次; - 编码后的
buf交给ctx.write后,所有权转移给 Pipeline,不能再 release; - 如果编码结果为空,释放
buf并写EMPTY_BUFFER,保证 promise 仍能完成; - 如果编码抛异常,
finally会释放buf,异常包装成EncoderException。
自定义编码器时,encode 里只管往 out
写,不要自己 release(out);preferDirect
控制分配 direct 还是 heap,网络传输通常 direct 更合适。
HTTP 解码器的状态机
HttpObjectDecoder 是 ByteToMessageDecoder
的子类,但它的 decode
不是“一个循环解一帧”,而是一个状态机:

1 | switch (currentState) { |
这段代码解释了 HTTP 解码的几个关键行为:
- 请求行/头没读全时直接返回,
ByteToMessageDecoder保留 cumulation,等下次读; READ_HEADER解析完头后,如果 body 长度为 0,直接产出LastHttpContent.EMPTY_LAST_CONTENT;Transfer-Encoding: chunked进入READ_CHUNK_SIZE,之后逐块产出HttpContent;- 固定长度 body 进入
READ_FIXED_LENGTH_CONTENT,按maxChunkSize分块; - 响应没有
Content-Length也没有 chunked 时,按连接关闭来界定 body,进入READ_VARIABLE_LENGTH_CONTENT。
所以 HttpObjectAggregator 才有存在的必要:它把
HttpMessage + 多个 HttpContent 聚合成一个
FullHttpRequest/FullHttpResponse,业务不用自己处理状态机和
LastHttpContent。
HttpObjectAggregator 本身继承
MessageAggregator,核心是四个钩子:
1 | protected Object startMessage(ChannelHandlerContext ctx, HttpObject msg); |
startMessage:收到HttpMessage(请求行/头)时创建FullHttpMessage;aggregate:把每个HttpContent的 body 写进聚合 buffer;finishAggregation:收到LastHttpContent时设置Content-Length、Connection等头,产出FullHttpRequest;handleOversizedMessage:body 超过maxContentLength时返回 413(请求)或关闭连接(响应)。
几个容易混淆的点:
HttpObjectAggregator不会自动处理 keep-alive,它只负责拼完整消息;keep-alive 需要HttpServerKeepAliveHandler或业务正确设置Connection/Content-Length。- 它会处理
Expect: 100-continue,在 body 过大时可以直接回 413,而不必等客户端把 body 发完。 - 它是有状态的,每个 Channel 一个实例,不能加
@Sharable。 FullHttpRequest的 content 是一个 ByteBuf,业务处理完要释放;SimpleChannelInboundHandler<FullHttpRequest>会自动释放。
HttpObjectAggregator 的源码在 codec-http
模块,和 HttpObjectDecoder 一起,构成了“字节流 → HTTP 消息
→ 完整请求”的两级转换。
HttpObjectAggregator 还会处理
Expect: 100-continue、请求体超过上限时的
413、以及部分非法请求。它是有状态的,不能加 @Sharable;每个
Channel 需要独立实例。
编解码器的组合顺序
一个常见的服务端 Pipeline:
1 | ByteToMessageDecoder(拆帧) |
出站方向相反:
1 | 业务 Handler |
顺序错了会出现“解码器拿到的是半帧”或“编码器把已经编码的 ByteBuf 又编码一次”。判断方法:入站时谁先看到字节,谁就放在前面;出站时谁最后写 Socket,谁就放在后面。
内存分配
4.2 默认用哪个分配器
ByteBufAllocator.DEFAULT 来自
ByteBufUtil.DEFAULT_ALLOCATOR,4.2 的默认值不是很多人以为的
PooledByteBufAllocator:
1 | String allocType = SystemPropertyUtil.get("io.netty.allocator.type", "adaptive"); |
adaptive:4.2 默认,按平台和分配模式自动选择;pooled:启用池化,适合高吞吐、频繁分配;unpooled:每次 new,适合调试或分配很少的场景。
可以用 -Dio.netty.allocator.type=pooled
强制池化。生产环境如果要精确控制 direct
memory,通常会显式配置分配器,而不是依赖默认值。
]
PooledByteBufAllocator 的层级
池化分配器的结构可以记成四层:
1 | PooledByteBufAllocator |
关键参数:
pageSize默认 8192;maxOrder默认 9,chunkSize = pageSize << maxOrder,即 4MB;nHeapArena/nDirectArena默认是 CPU 核数 × 2;- tiny/small/normal 分配走不同路径,huge 分配直接走
allocateHuge,不进池。
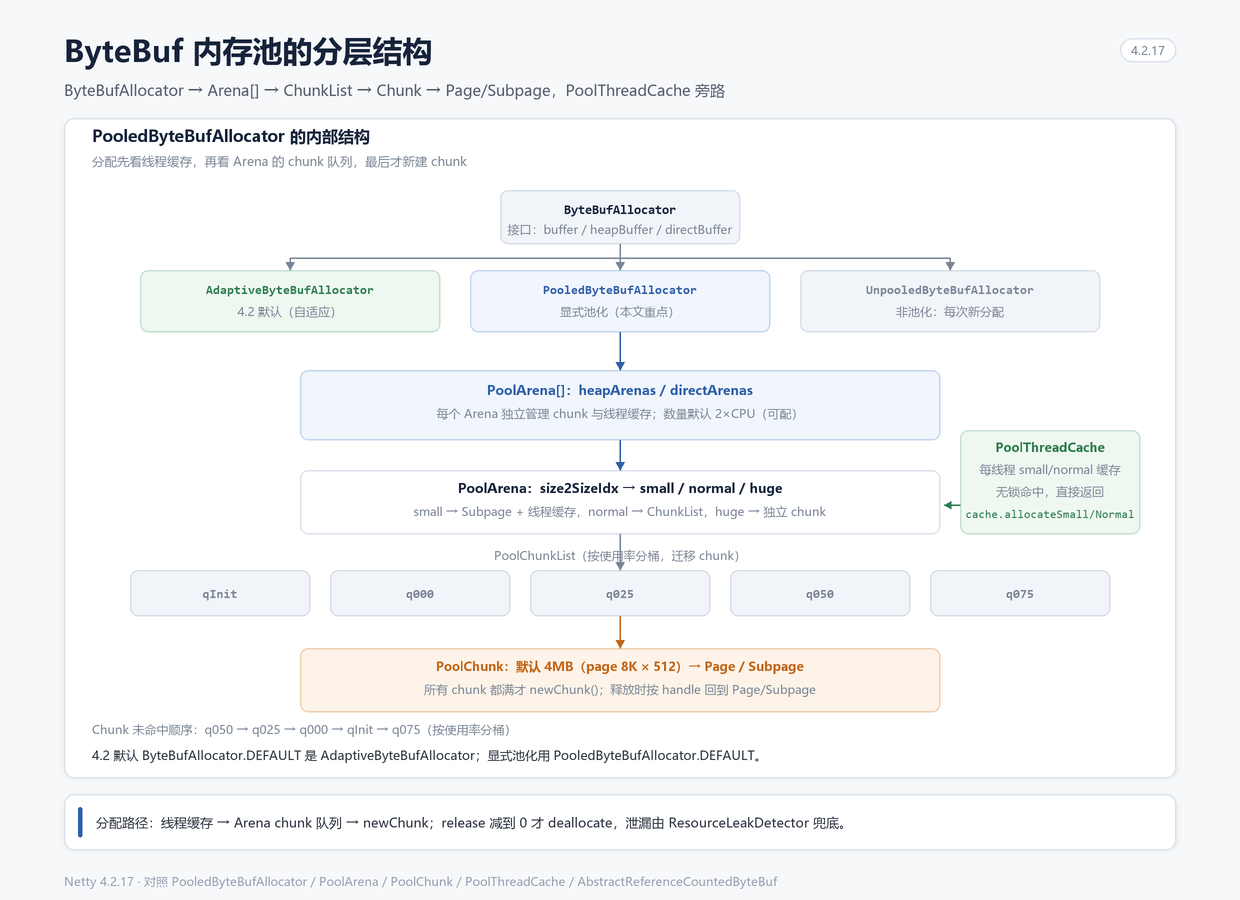
PoolArena 怎么选路径
PoolArena.allocate 先算 size class:
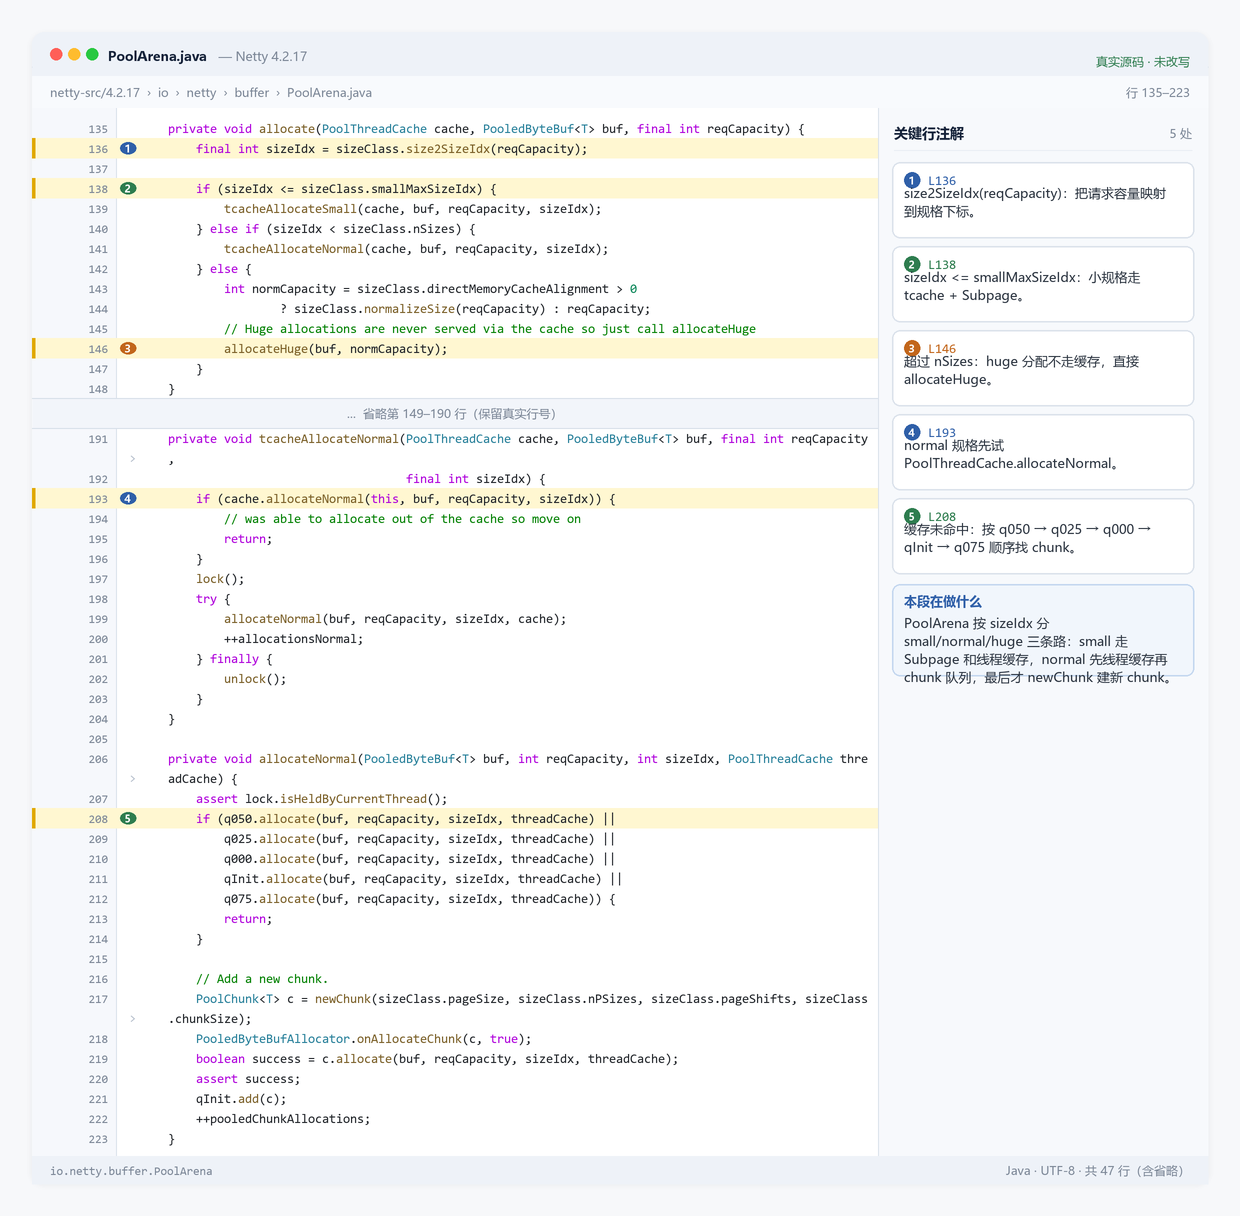
1 | private void allocate(PoolThreadCache cache, PooledByteBuf<T> buf, final int reqCapacity) { |
- 小对象先走
PoolThreadCache,没有命中再从PoolSubpage分配; - 普通对象走
PoolChunk的 normal 链表; - 超过 chunk 能表达的范围,直接
allocateHuge,不受池管理。
PoolThreadCache 是性能关键:每个 EventLoop
线程有自己的缓存,分配/释放大部分时候不需要碰全局锁。代价是内存可能在不同线程的
cache 里滞留,所以 Netty 提供了 trim() 和
PooledByteBufAllocatorMetric 来观察。
PooledByteBufAllocator 创建 Arena 的代码:
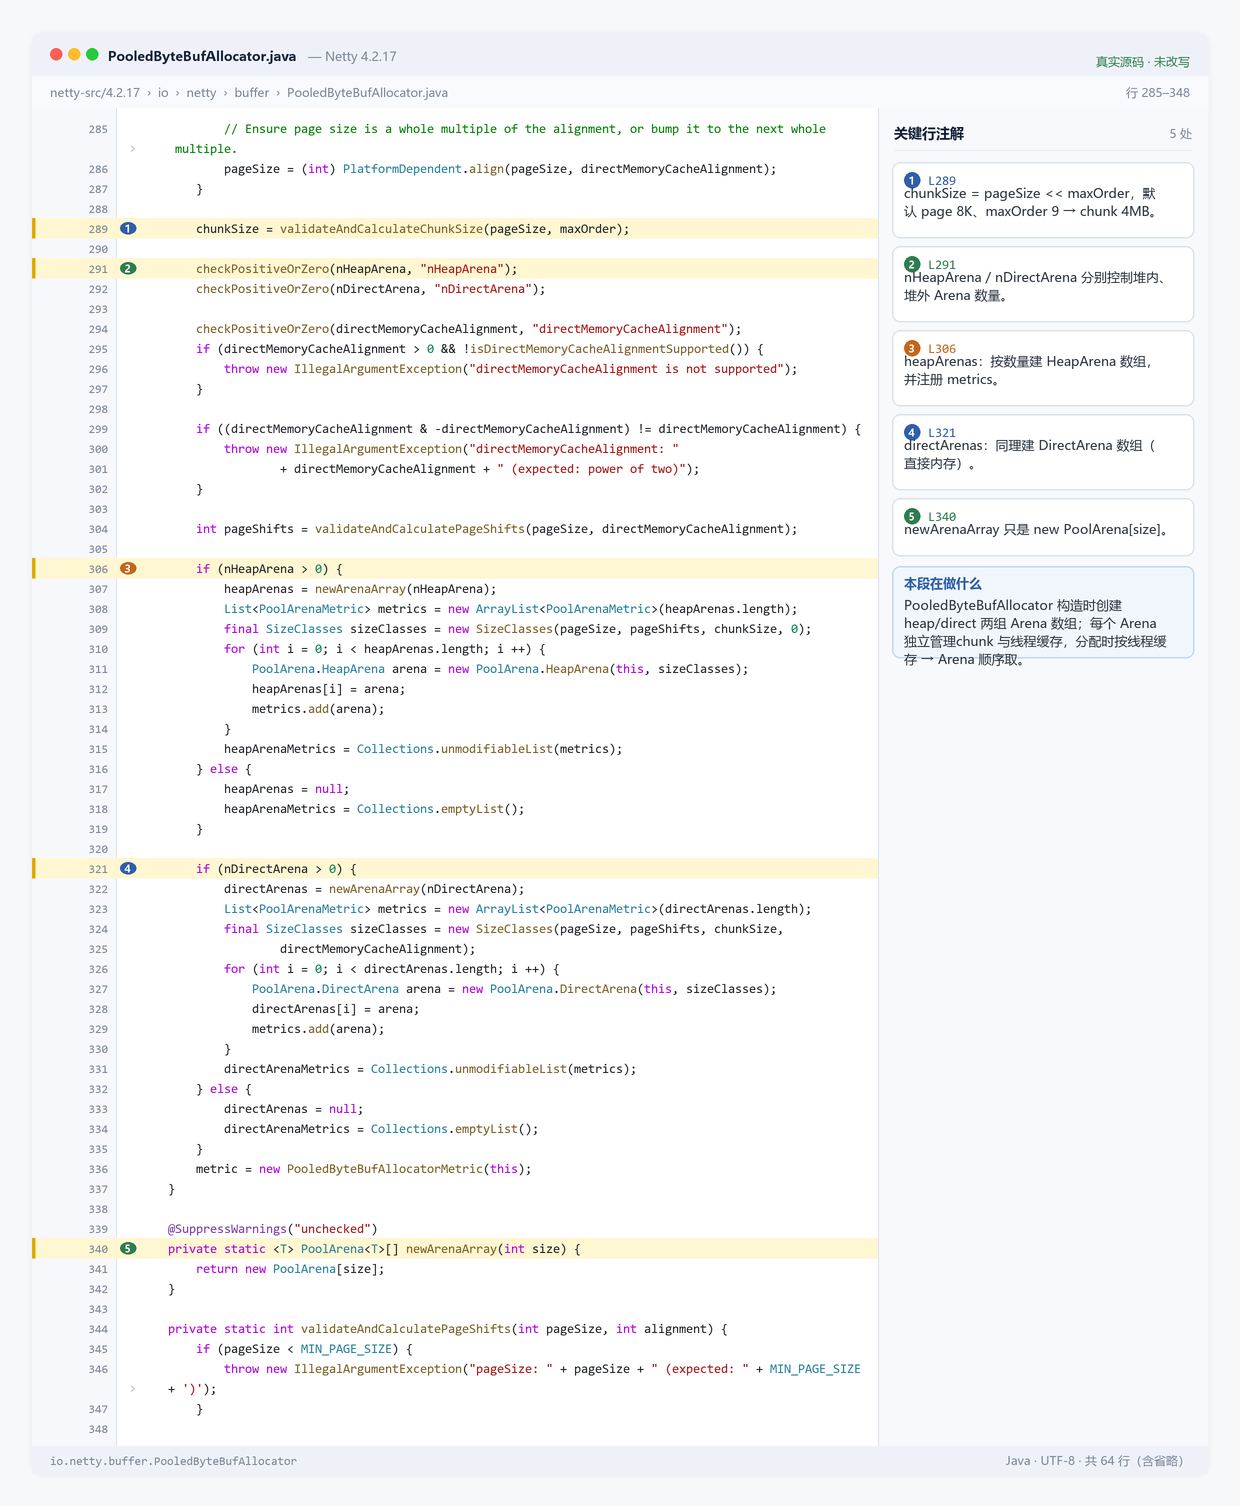
Chunk、Page 与 Subpage
PoolChunk 是一块 4MB 的连续内存,按 8KB 的 Page
切分。PoolChunk
用一棵完全二叉树(memoryMap)记录每个节点的分配状态:
- 叶子节点对应 Page;
- 非叶子节点记录子树的空闲状态;
- 分配 Page 时从根往下找第一个足够大的空闲节点;
- 释放时把节点标记回空闲,并向上合并。
小对象(小于一个 Page)不会直接占一个 Page,而是走
PoolSubpage:把一个 Page 再切成固定大小的槽位,用 bitmap
记录哪些槽位被占用。PoolSubpage 适合 tiny/small
对象,避免每个小 ByteBuf 都浪费 8KB。
PoolArena 的 PoolChunkList 按使用率把 Chunk
分成 qInit、q000、q025、q050、q075:
- qInit:新分配或几乎全空的 Chunk;
- q000/q025/q050/q075:使用率逐渐升高;
- 分配时从 q050 开始找,尽量保持 Chunk 的使用率在中间区间;
- 释放时按使用率把 Chunk 移到合适的链表,必要时合并/回收。
这套设计的目的是减少内存碎片,同时让分配/释放的复杂度保持在可接受范围。业务不需要直接操作这些结构,但是这个解释了,为什么池化分配器的内存占用不是线性的。
泄漏检测
ResourceLeakDetector
默认只采样一部分分配,记录调用栈;当对象被 GC 但引用计数不为 0
时,打印泄漏报告。检测级别:
| 级别 | 行为 |
|---|---|
DISABLED |
关闭检测 |
SIMPLE |
默认,采样少量分配 |
ADVANCED |
采样更多,报告更详细 |
PARANOID |
每个分配都记录,适合定位问题,性能开销大 |
可以通过 -Dio.netty.leakDetection.level=paranoid
临时打开。它检测的是“对象被 GC 但没
release”的泄漏;如果对象一直被强引用,检测器也无能为力。
引用计数释放路径在 AbstractReferenceCountedByteBuf:
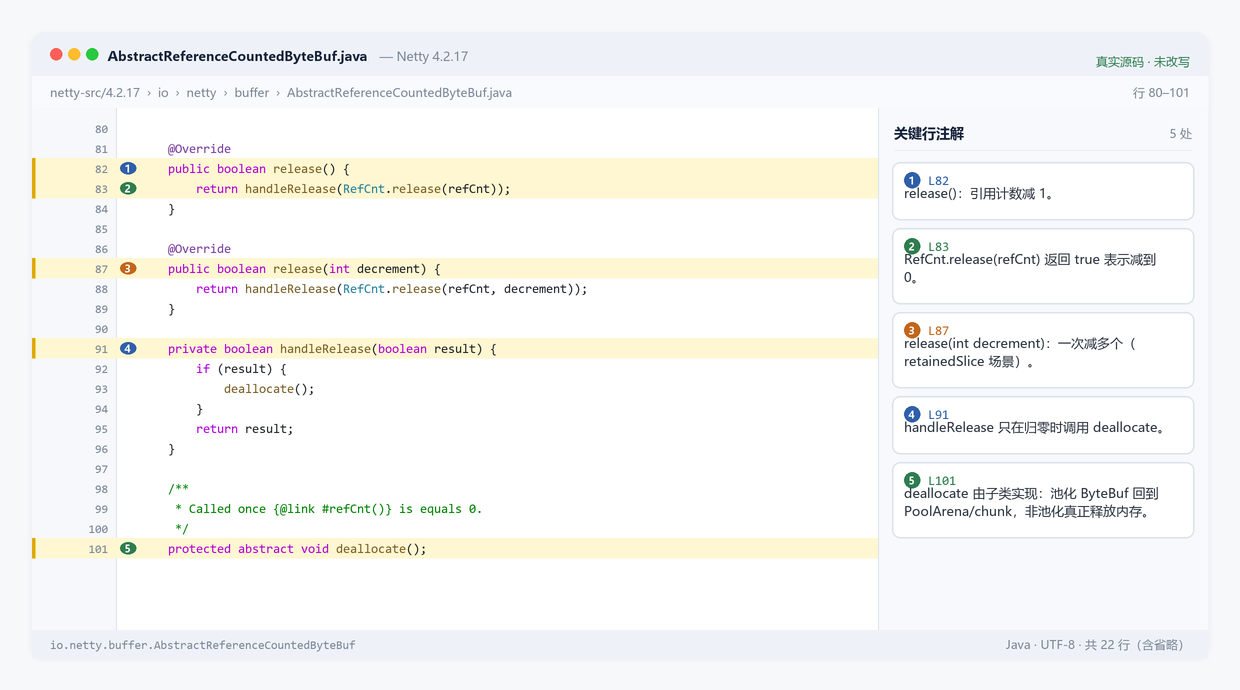
1 | public boolean release() { |
release() 返回 true 表示这次释放把计数降到
0,deallocate() 才会真正归还内存:
- 池化 ByteBuf 的
deallocate()把内存还给PoolArena或线程缓存; - 非池化 ByteBuf 的
deallocate()释放底层数组或 direct buffer; - 重复 release 会抛
IllegalReferenceCountException,这就是泄漏检测之外的“过度释放”问题。
ResourceLeakDetector
在分配时记录调用栈,泄漏时打印“被分配但未释放”的位置。它只能检测“完全没
release”的泄漏,检测不到“release 次数不对但对象已被回收”的逻辑错误。
内存分配的三个实践结论
- 入站 Buffer 由 Netty
分配,业务处理完必须释放;
SimpleChannelInboundHandler会自动释放,ChannelInboundHandlerAdapter不会。 - 出站 Buffer 一旦交给
ctx.write,所有权转移给 Pipeline,业务不能再 release。 - 需要零拷贝时用
slice/retainedSlice/CompositeByteBuf,但要清楚每个视图的 refCnt 和谁负责 release。
这部分在 part3 已经用 ByteBuf 实验跑过;这里补的是“分配器内部怎么把 release 变成回收”。
重要 Handler
IdleStateHandler:定时任务怎么触发
IdleStateHandler 在 handlerAdded
后初始化三个定时任务:
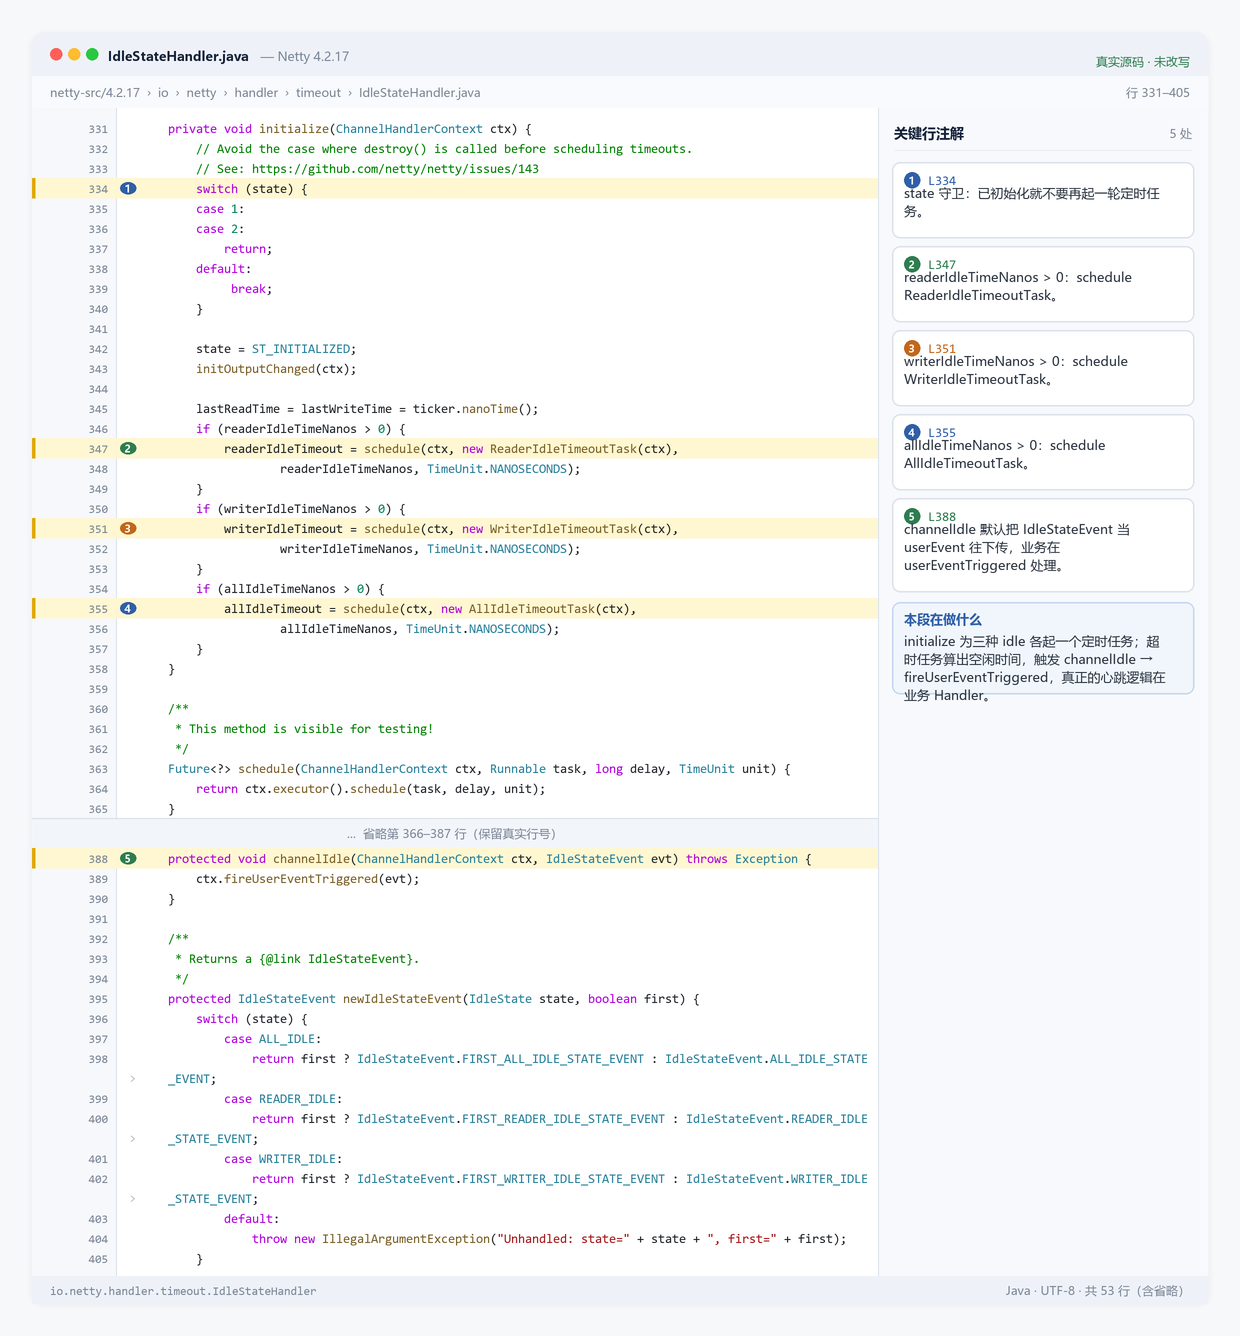
1 | private void initialize(ChannelHandlerContext ctx) { |
三个任务都用
ctx.executor().schedule(...),所以定时器跑在 EventLoop
上。任务到期后检查“距上次读/写的时间”,满足条件才
channelIdle,否则重新 schedule。
channelIdle 只 fire 事件,不关闭连接、不发心跳。发
PING、close、重连都是业务 Handler 在 userEventTriggered
里做的。这个区别在 part4 已经强调过,源码位置就是这里。
SslHandler:wrap/unwrap 与 handshakeFuture
SslHandler 是出站/入站双向 Handler。写路径:
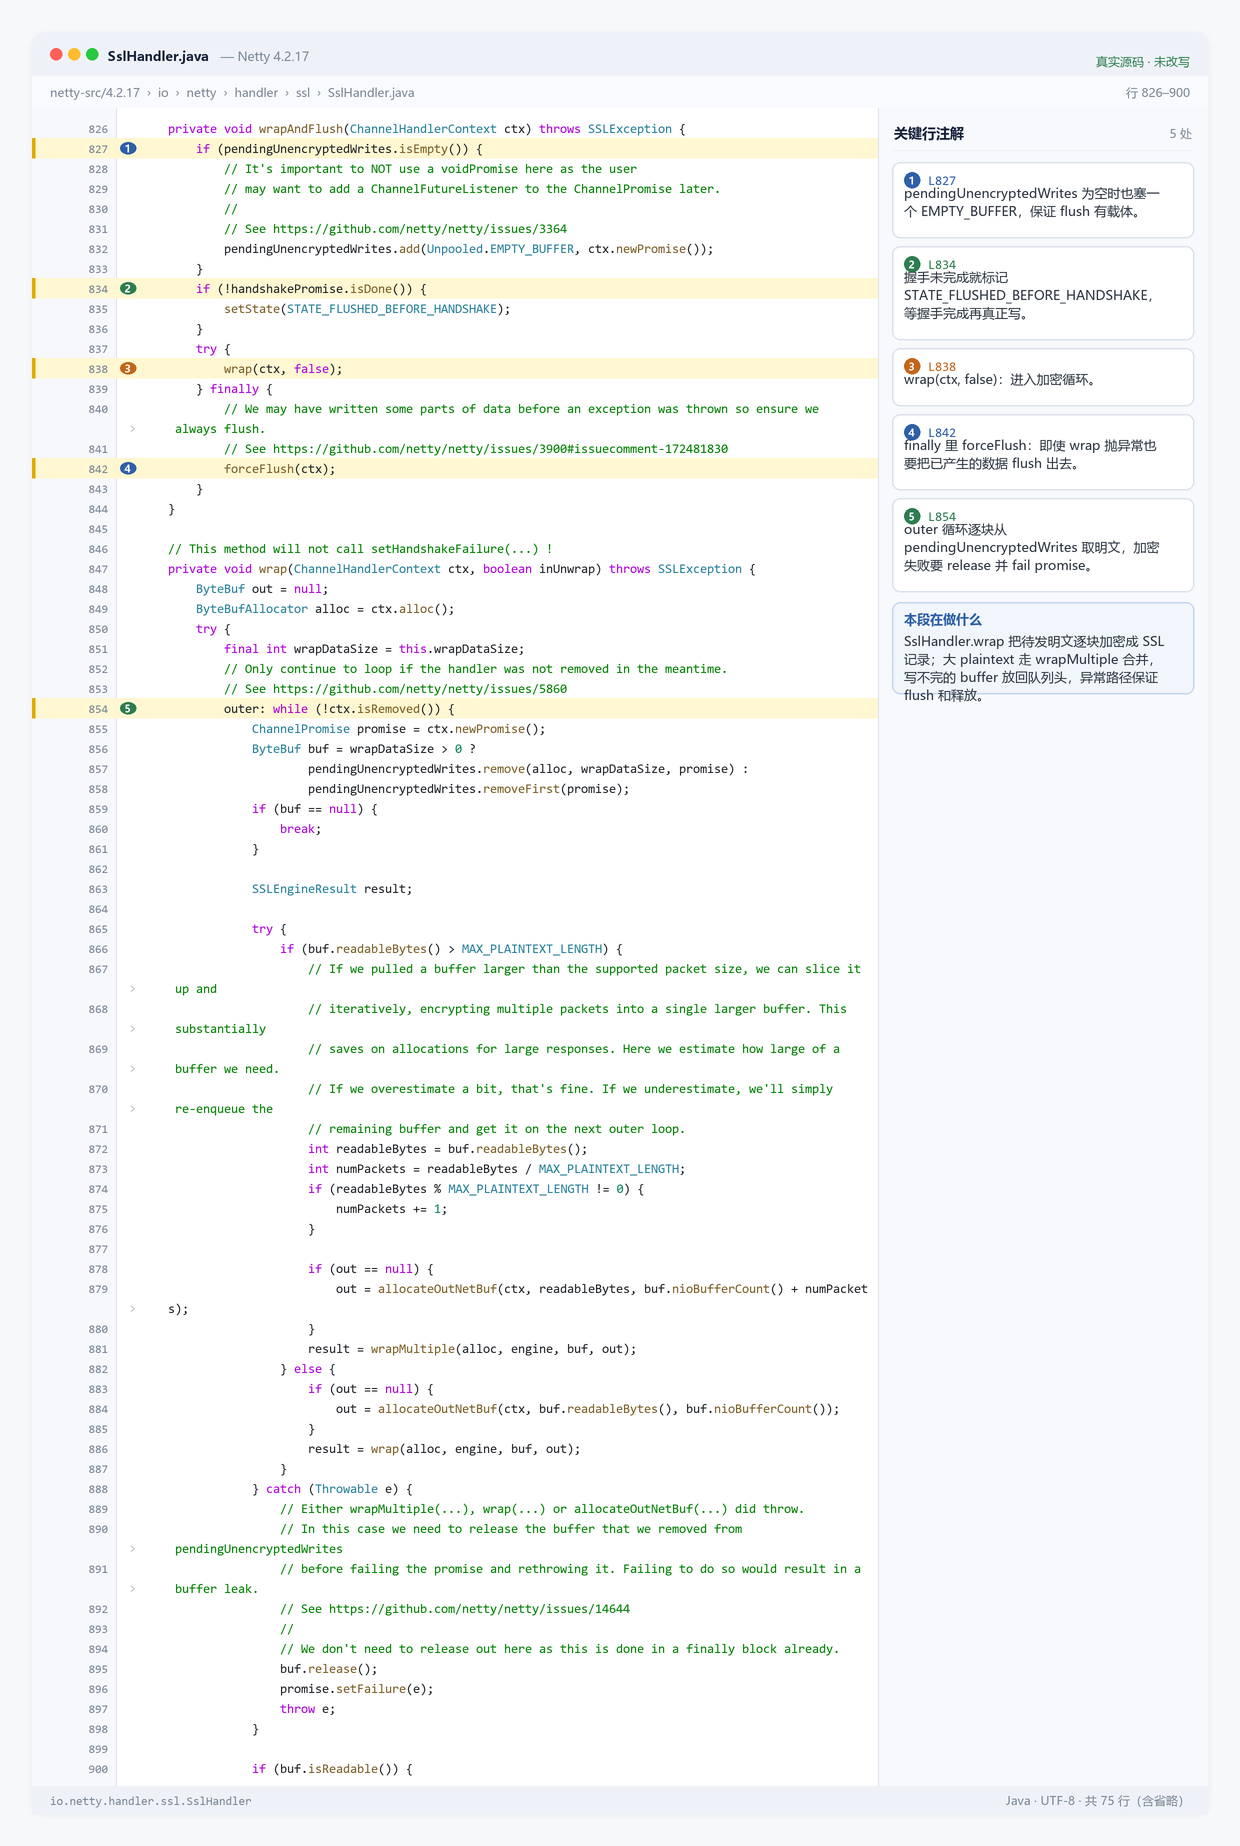
1 | public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) { |
write 不立即加密,只把明文放进
pendingUnencryptedWrites;flush 才调用
wrapAndFlush,把明文 SSLEngine.wrap
成密文写到下一个出站 Handler。这样多个小写可以合并到一次 TLS
记录,减少开销。
读路径相反:SslHandler 本身继承
ByteToMessageDecoder,入站 channelRead
先累积密文,再在 decode 里调 unwrap:
1 |
|
真正解密在 unwrap:
1 | private int unwrap(ChannelHandlerContext ctx, ByteBuf packet, int length) throws SSLException { |
unwrap 里会循环调用
SSLEngine.unwrap,处理四种结果:
OK:解密出应用数据,ctx.fireChannelRead给下一个 Handler;BUFFER_UNDERFLOW:密文不够一个 TLS 记录,等更多数据;BUFFER_OVERFLOW:输出缓冲区不够,扩容后重试;CLOSED:对端关闭 TLS,触发 close。
握手期间的 HandshakeStatus
也要处理:NEED_WRAP 生成握手响应,NEED_UNWRAP
等对端数据,NEED_TASK 执行 SSLEngine
的委托任务,FINISHED 完成
handshakePromise。这些状态机都在 SslHandler
内部,业务只看到 handshakeFuture 和
SslHandshakeCompletionEvent。
SslHandler
的写路径有一个容易忽略的点:write
只入队,flush 才加密。如果业务只 write 不
flush,数据会一直留在
pendingUnencryptedWrites,不会发出去。这和普通 ByteBuf 的
write/flush 语义一致,但 TLS 层多了一层队列,排查时容易看漏。
handshakeFuture() 返回的就是这个
promise。业务要等它完成再发应用数据:
1 | SslHandler sslHandler = sslContext.newHandler(ch.alloc(), host, port); |
SslHandler 必须放在 HTTP codec 之前:入站时先解密再解析
HTTP,出站时先编码 HTTP 再加密。
WebSocket:握手响应与帧编解码
WebSocketServerHandshaker13.newHandshakeResponse
做三件事:
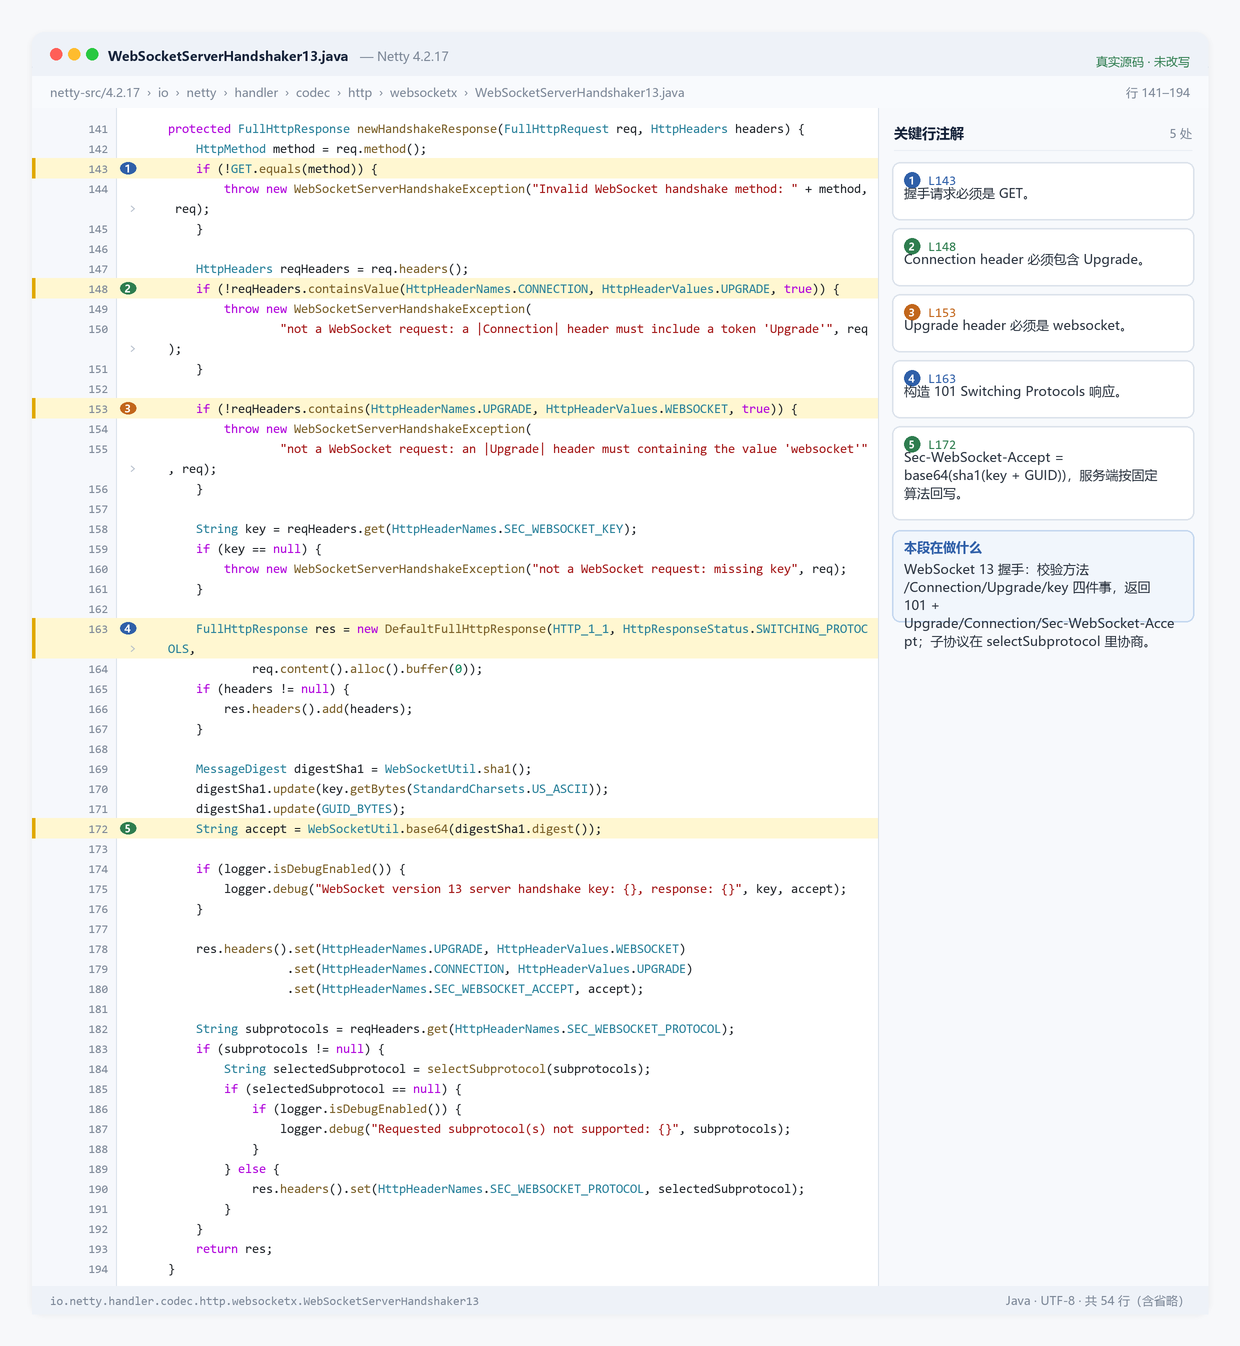
- 校验请求方法必须是 GET、
Connection包含Upgrade、Upgrade包含websocket、Sec-WebSocket-Key存在; - 把
Sec-WebSocket-Key和固定 GUID 拼接,做 SHA-1 再 Base64,得到Sec-WebSocket-Accept; - 构造
101 Switching Protocols响应,并把Upgrade/Connection/Sec-WebSocket-Accept写回头。
1 | MessageDigest digestSha1 = WebSocketUtil.sha1(); |
握手成功后,WebSocketServerProtocolHandler 会把 HTTP
codec 替换成 WebSocket frame decoder/encoder。帧的边界由 WebSocket
帧头决定,不再依赖 Content-Length,这是它和 HTTP
的本质区别。
WebSocket 帧解码器
WebSocket13FrameDecoder 继承
WebSocket08FrameDecoder,负责把字节流拆成
WebSocketFrame。下面是简化后的核心逻辑(省略了分片缓存、扩展和详细校验):
1 | protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) { |
几个关键校验:
- 客户端发来的帧必须 masked,服务端发回去的帧不能 masked;
payloadLength超过maxFramePayloadLength直接抛CorruptedFrameException;- 分片帧(
fin=false)会先缓存,等continuation帧拼完整再交给业务; - 控制帧(Ping/Pong/Close)不能分片,payload 不能超过 125 字节。
WebSocket13FrameEncoder 做相反的事:写帧头、设置
mask(客户端)、写 payload。服务端编码器
new WebSocket13FrameEncoder(false) 的
maskPayload=false,因为服务端不能 mask。
WebSocketServerProtocolHandler 还负责:
- 握手成功后触发
ServerHandshakeStateEvent.HANDSHAKE_COMPLETE; - 处理 Close 帧,按状态码关闭;
- 把 Text/Binary 帧继续传给业务 Handler;
- 对 Ping 自动回 Pong(由
WebSocketProtocolHandler完成,业务看不到)。
所以业务 Handler 通常只需要处理 TextWebSocketFrame 和
BinaryWebSocketFrame;Ping/Pong/Close 交给协议
Handler。
Handler 顺序的共同规律
IdleStateHandler、SslHandler、WebSocket、HTTP 的源码都在回答同一个问题:这个 Handler 看到的是字节、帧还是业务对象?
SslHandler看到 ByteBuf(密文/明文),要放在 codec 前;HttpServerCodec看到 ByteBuf,产出 HttpObject;HttpObjectAggregator看到 HttpObject,产出 FullHttpRequest;IdleStateHandler不改变消息,只观察读写时间,放哪一层都可以,但通常放最前面;- 业务 Handler 看到的是解码后的对象。
顺序错了,拿到的类型就不对,通常会在 ClassCastException
或解码异常里体现。
关闭链路
close 的调用链
channel.close() 最终走到
AbstractChannel.AbstractUnsafe.close:
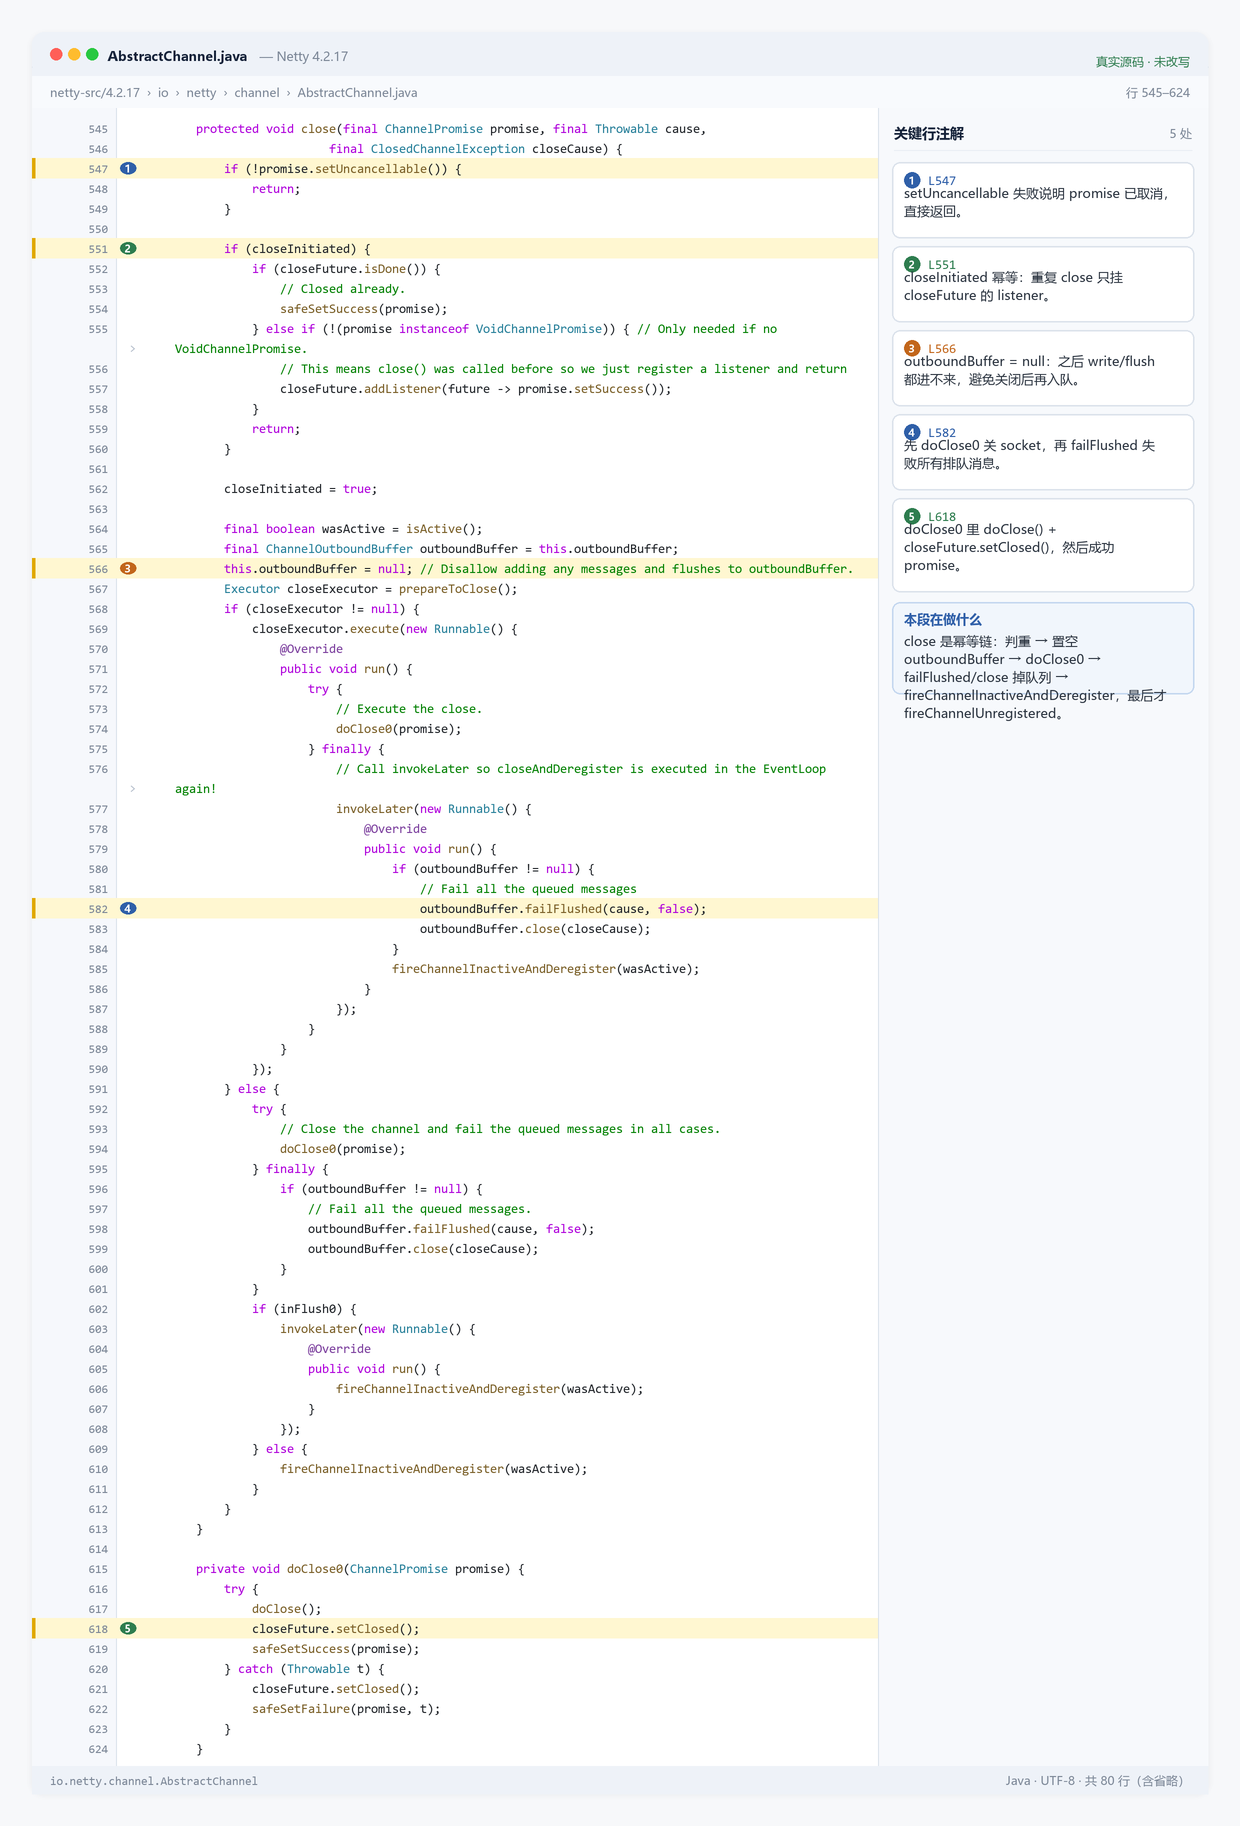
1 | protected void close(final ChannelPromise promise, final Throwable cause, |
顺序是:
- 标记
closeInitiated,重复 close 只挂 listener,不重复关闭; outboundBuffer = null,后续 write 会直接失败并 release 消息;doClose()关闭 JDK Channel,closeFuture.setClosed();failFlushed/close失败所有 pending 写;fireChannelInactiveAndDeregister:如果之前 active,先channelInactive,再doDeregister,最后channelUnregistered。
这解释了一个常见现象:closeFuture
完成时,channelInactive
可能还没执行;channelInactive 之后还有
channelUnregistered。业务如果要在 连接完全关闭
后清理资源,应该等 channelUnregistered 或
closeFuture + 自己的状态机,而不是只等
channelInactive。
启动失败时的关闭路径
不是所有 Channel 都会走到完整的 close 流程。启动阶段失败有三种情况:
channelFactory.newChannel()抛异常:initAndRegister直接返回失败的 promise,没有 Channel 可关;init(channel)抛异常:channel.unsafe().closeForcibly(),只调doClose(),不触发 Pipeline 事件;register失败:如果已经注册,走channel.close();否则closeForcibly()。
doBind0 里还有一个
ChannelFutureListener.CLOSE_ON_FAILURE:bind
失败会关闭 Channel。这个 listener
是启动失败时最常见的“自动清理”入口。
closeForcibly 和 close 的区别:
closeForcibly()只调doClose(),不保证channelInactive/channelUnregistered;close()走完整流程,失败 pending 写、触发 inactive、deregister、unregistered。
所以启动失败时不要假设业务 Handler 一定收到
channelInactive;如果要清理资源,最好在
initAndRegister/bind/connect 的失败 listener
里做。
半关闭
shutdownOutput()
只关闭输出方向,输入方向还可以继续读。它把 outboundBuffer
置空,调用 doShutdownOutput(),再 failFlushed
+ close:
1 | private void shutdownOutput(final ChannelPromise promise, Throwable cause) { |
半关闭适合“我发完了,但还要读对端响应”的协议。普通 HTTP/业务连接很少用,但 TCP 代理、文件传输会用到。
CloseWalkthrough 的真实顺序
CloseWalkthrough 用单进程 server+client 记录:
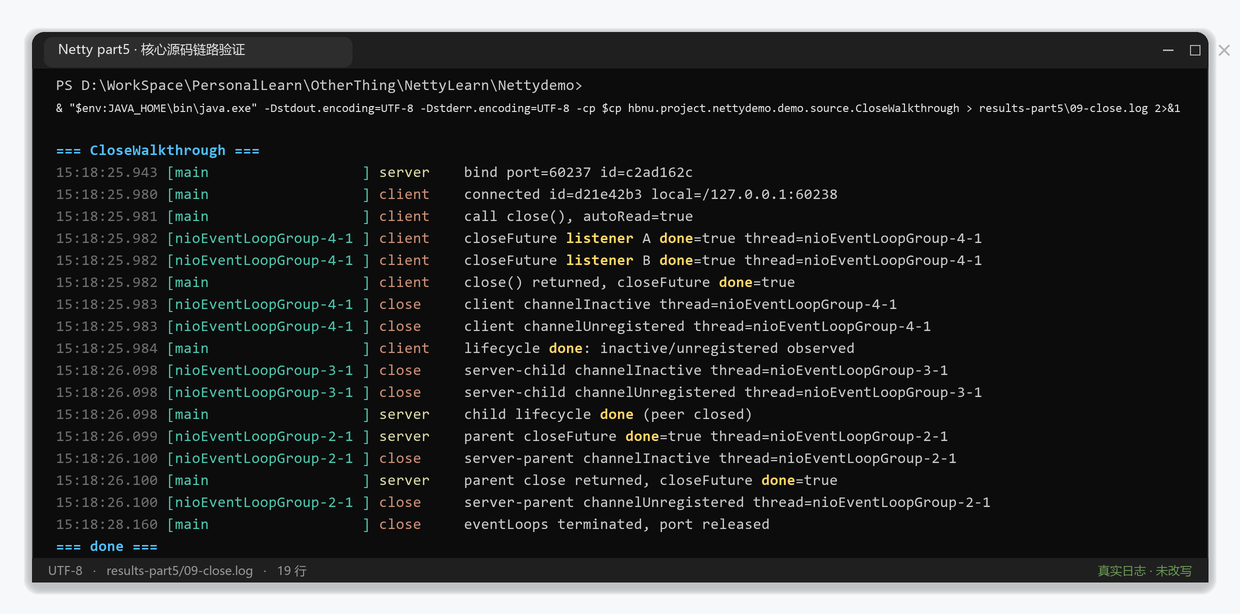
日志里按时间顺序出现
closeFuture、channelInactive、channelUnregistered,和源码里的调用顺序一致。不同版本/不同
transport 的顺序可能有细微差异,以实际日志为准。
调试
断点位置
把下面这些方法加入断点,基本覆盖一次请求:
| 阶段 | 类/方法 |
|---|---|
| 启动 | AbstractBootstrap#doBind、initAndRegister、AbstractChannel#bind |
| 注册 | AbstractChannel#register0、DefaultChannelPipeline#fireChannelRegistered |
| 客户端 | Bootstrap#doResolveAndConnect、AbstractNioChannel#connect、finishConnect |
| accept | NioServerSocketChannel#doReadMessages、ServerBootstrapAcceptor#channelRead |
| 事件循环 | SingleThreadIoEventLoop#run、NioIoHandler#select、processSelectedKeys |
| 任务 | SingleThreadEventExecutor#runAllTasks、fetchFromScheduledTaskQueue、confirmShutdown |
| Promise | DefaultPromise#addListener、notifyListeners、checkDeadLock |
| 读 | AbstractNioByteChannel#read、RecvByteBufAllocator.Handle#allocate、continueReading |
| 写 | AbstractChannel#write/flush、ChannelOutboundBuffer#addMessage/addFlush/remove |
| 传播 | AbstractChannelHandlerContext#fireChannelRead/findContextInbound、DefaultChannelPipeline#internalAdd |
| 解码 | ByteToMessageDecoder#channelRead/callDecode、LengthFieldBasedFrameDecoder#decode、HttpObjectDecoder#decode |
| 内存 | PoolArena#allocate、AbstractReferenceCountedByteBuf#release |
| 关闭 | AbstractUnsafe#close、failFlushed、deregister |
线程名与调用栈
线上排查时,线程名是第一手信息。EventLoop 线程通常叫
nioEventLoopGroup-3-1(4.1/4.2 兼容写法)或
multiThreadIoEventLoopGroup-...(4.2 新写法)。看到某个
Handler 的日志线程名不是 EventLoop
线程,要么它被挂到了业务线程组,要么是跨线程回调。
调用栈能回答“谁触发了这个方法”。比如在 channelRead
断点停下来,往上看几层,通常能看到
AbstractNioByteChannel.read 或
ByteToMessageDecoder.channelRead;在 write
断点停下来,能看到业务 Handler 或 WriteTask.run。
线上没有断点时,用 jstack 抓线程栈:
1 | & "$env:JAVA_HOME\bin\jstack.exe" <PID> > target\jstack.txt |
重点看 EventLoop 线程在
select、processSelectedKeys 还是业务 Handler
里;如果大量 EventLoop 线程停在业务代码,说明有阻塞操作;如果停在
sun.nio.ch.EPollArrayWrapper.epollWait,是正常的空闲等待。
4.2 的线程名要看具体构造方式:
- 旧的
NioEventLoopGroup:nioEventLoopGroup-3-1; - 新的
MultiThreadIoEventLoopGroup+NioIoHandler:通常是multiThreadIoEventLoopGroup-...; - 客户端如果单独建 group,线程编号会从自己的 group 开始,不要用编号猜角色。
排查线程时,先抓线程名,再抓栈:
1 | & "$env:JAVA_HOME\bin\jstack.exe" <PID> | Select-String -Pattern "nioEventLoopGroup|multiThreadIoEventLoopGroup" -Context 0,12 |
如果 EventLoop 线程卡在
DefaultPromise.await、CountDownLatch.await、JDBC
socketRead,就是典型的阻塞调用;如果卡在
AbstractChannelHandlerContext.invokeChannelRead 或业务
Handler,说明业务代码本身慢。前者要把同步调用移出
EventLoop,后者要优化业务或加线程池隔离。
4.2 与 4.1 的类名差异
| 4.1 写法 | 4.2.17 对应 | 说明 |
|---|---|---|
NioEventLoop / NioEventLoopGroup |
SingleThreadIoEventLoop /
MultiThreadIoEventLoopGroup +
NioIoHandler |
4.2 已 deprecated 旧类 |
NioEventLoop#run 里的 ioRatio |
SingleThreadIoEventLoop#run + 固定任务时间片 |
4.2 移除了 ioRatio,任务时间片默认 1000ms |
NioEventLoop#select |
NioIoHandler#select |
select 与循环拆到两个类 |
AbstractNioByteChannel.NioByteUnsafe.read |
同名,但注册/分发走 IoHandler |
读方法本身变化不大 |
ChannelPipeline#addLast(EventExecutorGroup, handler) |
4.2 已 deprecated | 推荐手动 dispatch,或直接使用
MultiThreadIoEventLoopGroup |
NioEventLoop 内部
invokeChannelRead/invokeWrite0 |
4.2 的 Pipeline 做了 flatten,事件分派直接在
fireXxx/write 里完成 |
旧文章里的“invoke 方法”在 4.2 可能找不到 |
SslHandler 对 NioSocketChannel
的类型判断 |
4.2 的 setOpensslEngineSocketFd 会
instanceof UnixChannel |
classpath 缺 netty-transport-native-unix-common 时会
NoClassDefFoundError |
WebSocketClientProtocolHandler 的握手回调 |
4.2 的构造/回调有变化 | 很多场景直接用 WebSocketClientHandshaker 更稳 |
读旧文章时,先确认它讲的类在 4.2 里是否还存在;如果不存在,找对应的新类,不要硬套方法名。
注意
- “handlerAdded 一定在 addLast
返回前执行”:错。Channel 未注册、或当前线程不是 Context 的
executor 时,
handlerAdded会延迟。 - “channelRead 一定在 EventLoop 线程”:只有 Channel 注册的 EventLoop 线程才会;如果 Handler 被挂到独立 executor group,事件会切线程。
- “write 成功就是对端收到了”:
write只是入队,flush才写 Socket,promise 成功只代表本端写缓冲接受。 - “tail 不会释放消息”:tail 的
onUnhandledInboundMessage会 release,未消费的 ByteBuf 不会泄漏,但业务也不该依赖它兜底。 - “池化分配器一定更快”:池化有线程缓存、arena 竞争、内存滞留的代价;小对象/低分配场景 unpooled 可能更简单。
- “4.2 和 4.1 只是版本号”:EventLoop、Pipeline flatten、SslHandler 依赖、WebSocket 客户端 API 都有实际变化,照搬旧代码会踩坑。
EmbeddedChannel 复现传播顺序
EmbeddedChannel 不经过真实 Socket,直接把事件写进
Pipeline,非常适合验证传播顺序和释放逻辑:
1 | EmbeddedChannel channel = new EmbeddedChannel( |
PipelineWalkthrough 把
pipeline.names()、firstContext()/lastContext()、ctx.name()/executor()
都打印出来:
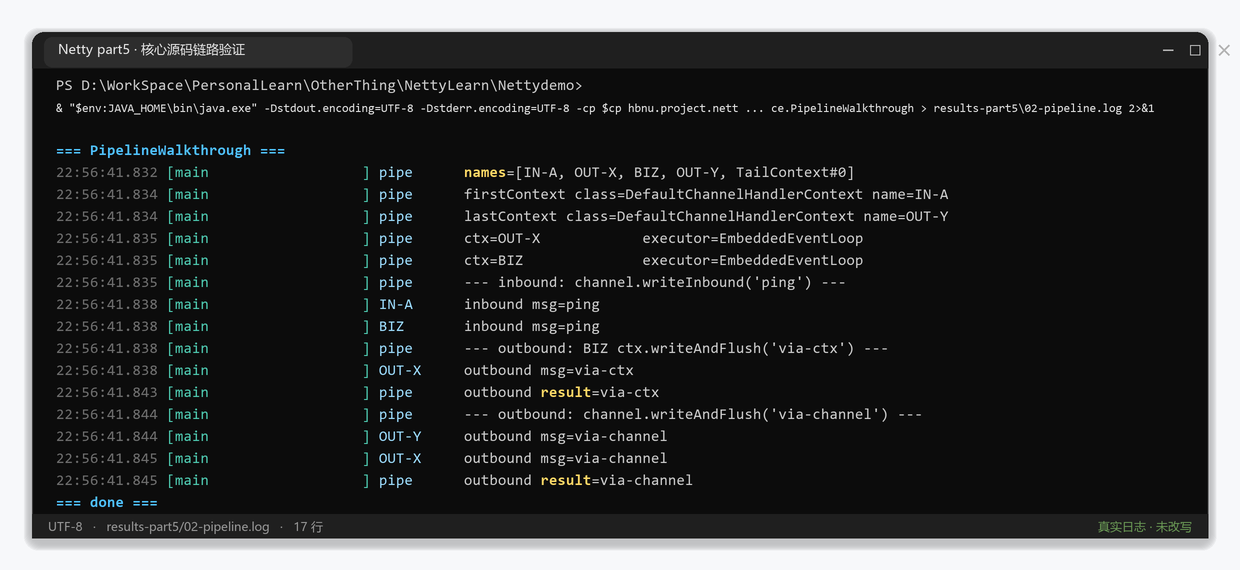
PipelinePropagationTest 用断言固定了顺序和 tail
释放:把未消费的 ByteBuf 写入
EmbeddedChannel,finishAndReleaseAll 后 refCnt
为 0,说明 tail 的兜底释放生效。
把这一篇串起来
把源码串起来,一次连接从建立到关闭的调用链是:
1 | bind |
源码地图
| 层 | 关键类 | 一句话 |
|---|---|---|
| 启动 | AbstractBootstrap、ServerBootstrap、Bootstrap、ChannelInitializer |
创建 Channel、装 Pipeline、注册、bind/connect |
| 事件循环 | SingleThreadIoEventLoop、NioIoHandler、SingleThreadEventExecutor |
select、任务、定时任务、优雅退出 |
| Promise | DefaultPromise、DefaultChannelPromise |
状态、listener、线程与死锁 |
| 读 | AbstractNioByteChannel、RecvByteBufAllocator |
分配、读、fireChannelRead |
| 写 | AbstractChannel、ChannelOutboundBuffer、NioSocketChannel |
入队、flush、writev、OP_WRITE、水位线 |
| 传播 | DefaultChannelPipeline、AbstractChannelHandlerContext |
双向链表、mask、executor、head/tail |
| 编解码 | ByteToMessageDecoder、MessageToByteEncoder、HttpObjectDecoder |
累积、拆帧、编码、协议状态机 |
| 内存 | ByteBufAllocator、PoolArena、AbstractReferenceCountedByteBuf |
池化、引用计数、释放 |
| 关闭 | AbstractUnsafe、ChannelOutboundBuffer |
失败 pending 写、inactive、unregistered |
参考资料
Netty 4.2.17.Final 源码(本文主要引用)
- AbstractBootstrap.java:
bind/doBind/initAndRegister/doBind0。 - ServerBootstrap.java:
init、ServerBootstrapAcceptor.channelRead。 - AbstractChannel.java:
register/register0/bind/write/flush。 - NioServerSocketChannel.java:
doBind/doReadMessages。 - SingleThreadIoEventLoop.java、NioIoHandler.java:4.2 的事件循环与 select/processSelectedKeys。
- NioEventLoop.java:4.2 中已 deprecated,用于对照 4.1。
- AbstractNioByteChannel.java、AbstractNioMessageChannel.java:读循环、accept、doWrite。
- AbstractChannelHandlerContext.java:
write、fireChannelRead、findContextInbound/Outbound。 - DefaultChannelPipeline.java:head/tail、
onUnhandledInboundMessage。 - ChannelOutboundBuffer.java:
addMessage/addFlush、pending 字节与水位线。 - ByteToMessageDecoder.java:
channelRead/callDecode。 - LengthFieldBasedFrameDecoder.java:
decode与长度计算公式。 - 本地源码:
netty-src/4.2.17/io/netty/(文中截图与行号以此为准)。 - Netty 4.2 Migration Guide、Netty 4.2.0.Final released:4.2 类名与调度机制变化。
- ByteToMessageDecoder(4.2 API)、LengthFieldBasedFrameDecoder(4.2 API):官方 API 说明。
- DefaultPromise.java:状态、listener、
await死锁检测。 - SingleThreadEventExecutor.java:任务队列、
runAllTasks、confirmShutdown。 - DefaultEventExecutorChooserFactory.java:2 的幂位运算与轮询。
- ChannelInitializer.java:延迟装配与自我移除。
- AdaptiveRecvByteBufAllocator.java、DefaultMaxMessagesRecvByteBufAllocator.java:接收缓冲区自适应与
continueReading。 - Bootstrap.java:客户端
DNS、
doResolveAndConnect。 - MessageToByteEncoder.java:出站编码的释放与空 buffer 处理。
- HttpObjectDecoder.java:HTTP 请求行/头/body 状态机。
- IdleStateHandler.java:三个定时任务与
channelIdle。 - SslHandler.java:
write/flush的 wrap、handshakeFuture。 - WebSocketServerHandshaker13.java:
Sec-WebSocket-Accept与 101 响应。 - NioSocketChannel.java:
doReadBytes/doWrite与 writev。 - PoolArena.java、PooledByteBufAllocator.java:Arena/Chunk/Page/Subpage。
- AbstractReferenceCountedByteBuf.java:引用计数释放路径。
- ByteBufUtil.java:4.2
默认
adaptive分配器的选择。 - ChannelPipeline(4.2 API)、ByteBufAllocator(4.2 API)、DefaultPromise(4.2 API)。
中文源码分析(对照阅读)
- 一文搞懂 Netty 发送数据全流程(博客园,2022-07-07):write 传播、OutboundBuffer、水位线、OP_WRITE 全链路(基于 4.1,读 4.2 时注意方法名变化)。
- Netty 源码—2.Reactor 线程模型一(腾讯云,2025-05-27):EventLoopGroup 创建、线程启动、空轮询重建。
- Netty
源码-Server 启动流程(SegmentFault,2024-09-14):按断点走
initAndRegister → register → doBind0 → doBeginRead。 - Netty 源码剖析之 Netty 启动流程(掘金,2022-11-25):启动链路的中文对照。
- Netty 出站缓冲区 ChannelOutboundBuffer 源码解析(博客园,2018-05-19):三指针链表、addMessage/addFlush、水位线。
- Netty 源码分析——ChannelPipeline 的事件传播(简书,2020-07-04):入站/出站传播方向。
- Spring Boot WebSocket 方案对比(ITPUB,2026-02-02):Netty 与 Spring 封装差异(part4 交叉引用)。