前言
上一篇我们把一条连接从建立到关闭走了一遍,也把事件线程、Pipeline 和异步结果拆开讲了。那一篇最后留下一个问题,解码器和编码器都要放在业务 Handler 之前,可它们到底在解什么,又在编什么。
答案在字节和对象之间。网络里流动的只有字节,业务代码想拿到的却是一个个消息对象。从 Socket 读出来的是一段没有边界的字节流,写回去的也是一个 ByteBuf。中间这层转换,就是编解码。
先把承载字节的 ByteBuf 拆开,看它的读写指针、内存位置、引用计数和零拷贝视图;再讨论粘包半包是怎么产生的,三种拆包方案各自适合什么场景;然后跟着 Netty 的解码器看一遍累积和解码循环;最后用一个能跑的自定义协议,把帧结构、消息分发和序列化选型串起来。
读完应该能回答下面这些问题:
| 问题 | 对应小节 | 对应实验 |
|---|---|---|
| ByteBuf 的 readerIndex 和 writerIndex 分别管什么 | ByteBuf 里的数据长什么样 | ByteBufIndexDemo |
| 堆内存和直接内存、池化和非池化怎么选 | ByteBuf 放在哪,怎么分配 | ByteBufAllocDemo |
| 为什么 ByteBuf 要引用计数,谁负责 release | 引用计数 | ReferenceCountDemo、LeakDetectDemo |
| slice 和 copy 差在哪,视图什么时候不能乱用 | 零拷贝 | ByteBufViewDemo |
| 粘包半包是谁造成的,为什么不是 Netty 的 bug | 粘包与半包 | FrameCodecDemo(9006) |
| 解码器怎么从半截字节里攒出一条消息 | ByteToMessageDecoder | CustomDecoderDemo |
| LengthFieldBasedFrameDecoder 的五个参数怎么配 | LengthFieldBasedFrameDecoder | LengthFieldConfigDemo |
| 自定义协议该有哪些字段,怎么兼容旧版本 | 自定义协议 | ProtocolDemo(9007) |
| 测试拆包和坏帧不用开端口怎么做 | 用 EmbeddedChannel 测编解码 | FrameCodecTest、ProtocolCodecTest |
ByteBuf 里的数据长什么样
上一篇里 ByteBuf 只作为 Pipeline 中流动的消息出现,这一节把它拆开。API 的完整定义在 ByteBuf 4.2 javadoc,下面只讲实际写代码会用到的部分。
读写指针分离
JDK 的 ByteBuffer 只有一个 position,读和写共用,所以每次切换方向都要
flip() 或 compact()。一个 Buffer
同一时刻要么在读要么在写,所以说 ByteBuf 把这件事拆成了两个指针:
readerIndex:下一次读从哪开始;writerIndex:下一次写从哪开始。
两个指针正常读写时只会往前走,互不干扰。读多少,readerIndex
往右移多少;写多少,writerIndex
往右移多少。要回退读位置,必须显式调用 setReaderIndex 或
readerIndex(int);read/write
系列自己不会倒退。已经读过但还没丢弃的部分,仍然留在内存里,只是不再属于可读区。
这样做的好处很直接:
- 读和写可以交替进行,不需要
flip(); - 想回到某个读过的位置,可以把
readerIndex往回set; - 底层内存是否扩容、是否复制,对上层读写 API 没有影响。
代价是索引关系需要自己维护。readBytes、writeBytes、skipBytes
这些方法会动指针,getByte、setByte 这类带
get/set
前缀的方法不会。写代码时如果混用,很容易出现数据写进去了但读不出来,因为可读区是
readerIndex 到 writerIndex,不是 0 到
capacity。
和 JDK 的 ByteBuffer 放在一起对比:
| ByteBuffer | ByteBuf | |
|---|---|---|
| 读写位置 | 一个 position,读写切换要
flip/compact |
两个指针,读写互不影响 |
| 容量 | 固定,不能扩容 | 可扩容,有 capacity/maxCapacity |
| 内存 | 堆内/直接内存 | 堆内/直接内存,另外支持池化和复合 |
| 生命周期 | GC 管理 | 引用计数,需要 release |
| 视图 | slice/duplicate |
slice/duplicate/retainedSlice,语义更细 |
ByteBuf 的能力更多,代价是 API 更多、释放责任更重。这也是为什么 Netty
要在 SimpleChannelInboundHandler、tail
这些地方替业务兜底释放。
三段结构与容量
ByteBuf 把 0 到 maxCapacity
这段空间按两个指针切成三段:
1 | 0 readerIndex writerIndex capacity maxCapacity |
对应的几个方法:
| 方法 | 含义 |
|---|---|
readableBytes() |
writerIndex - readerIndex |
writableBytes() |
capacity - writerIndex |
maxWritableBytes() |
maxCapacity - writerIndex |
isReadable() / isWritable() |
可读区/可写区是否非空 |
discardReadBytes() |
把可读区整体左移,丢掉已读部分,腾出尾部空间 |
clear() |
把两个指针都置 0,不擦除内存 |
discardReadBytes()
会移动内存,频繁调用会有拷贝开销;clear()
只是重置指针,旧数据还在,下一次写会覆盖。这两个方法的区别,在复用
buffer 的场景里经常被搞混。
常用 API 按是否移动指针分成两组:
| 会移动指针 | 不移动指针 |
|---|---|
readByte/readInt/readBytes |
getByte/getInt/getBytes |
writeByte/writeInt/writeBytes |
setByte/setInt/setBytes |
skipBytes |
readerIndex(int) / writerIndex(int)
可以直接设置位置,markReaderIndex() /
resetReaderIndex()
用来暂存和恢复读位置。自定义解码器解析失败时,通常先
mark,读长度后发现 body 不够再
reset,等下一次数据到达重新解析。
容量方面有两个值。capacity
是当前已经分配的大小,maxCapacity
是允许扩容到的上限。写入超过 capacity 时,ByteBuf
会自动扩容,直到 maxCapacity;超过 maxCapacity
再写,就会抛 IndexOutOfBoundsException。
Unpooled.buffer(16, 48) 的意思就是初始容量 16,最多扩到
48。默认的 maxCapacity 是
Integer.MAX_VALUE,所以不设上限的 buffer
在异常写入时可能一路吃内存,直到 OOM。对帧解码这类长度不可信的场景,给
buffer 设一个合理的 maxCapacity 是必要的。
扩容不是简单的每次翻倍。4.2 的规则是,小于 4 MiB 时按 2
的幂增长,超过 4 MiB 后按 4 MiB 线性递增,并且始终不超过
maxCapacity。它是分段策略,不是固定倍数。
Unpooled.wrappedBuffer(byte[]) 是一个例外,它的
maxCapacity 等于数组长度,不能扩容,写超长度直接抛
IndexOutOfBoundsException。
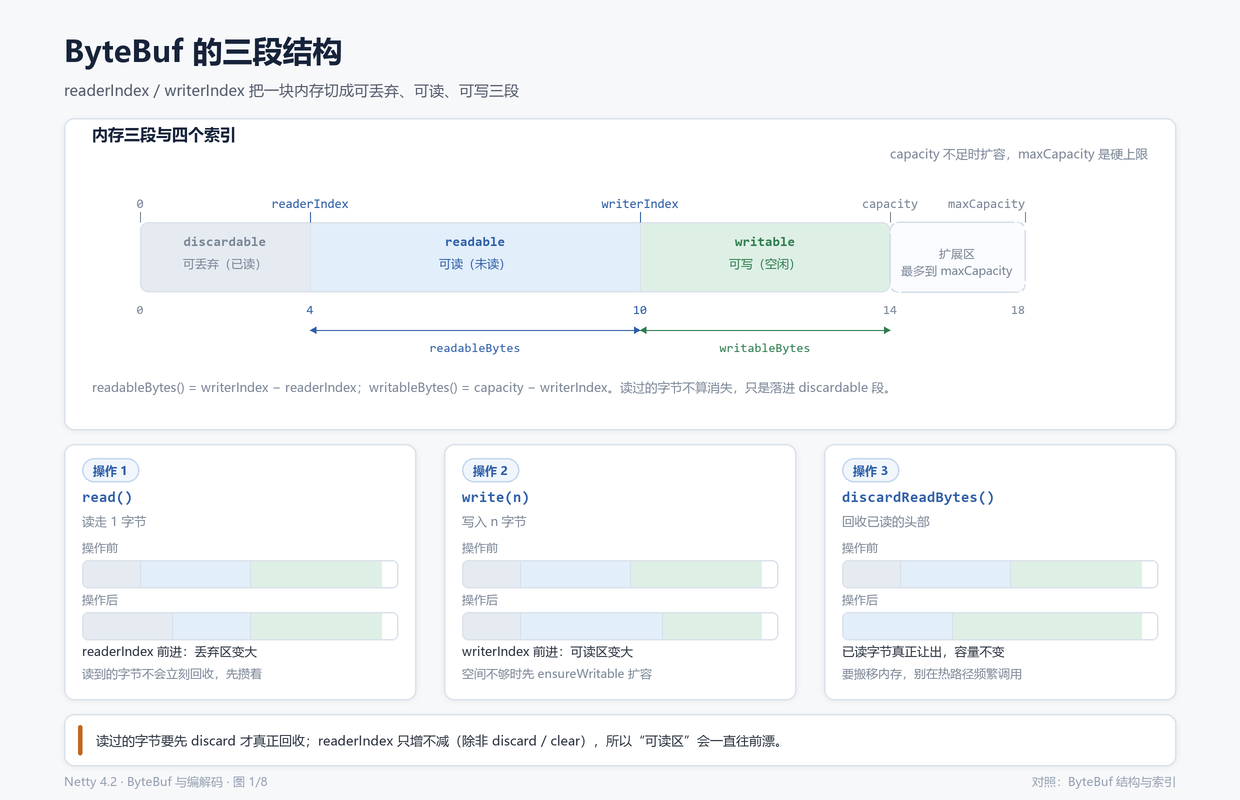
大约就是如图所示
索引操作实验
ByteBufIndexDemo
把读写、丢弃、扩容和越界都跑了一遍:
1 | // ① 初始容量 10,上限 20:故意设小,方便观察扩容和越界 |
运行结果:
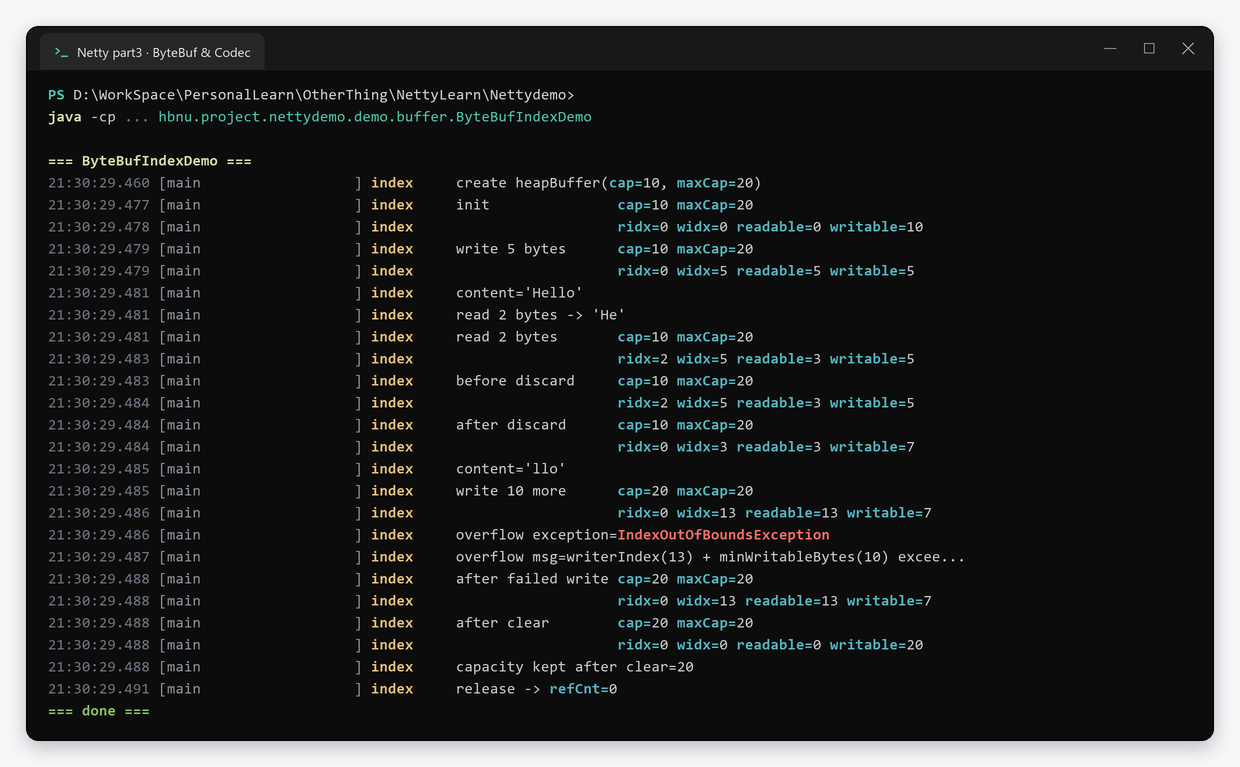
几个可以从输出里直接看到的点:
- 初始
cap=10 maxCap=20,两个游标都是 0,可读 0、可写 10。 - 写 5 字节后
ridx=0 widx=5,可读 5、可写 5;读 2 字节后ridx=2 widx=5,可读 3、可写 5。可读和可写的总量仍然等于 capacity。 discardReadBytes()之后ridx=0 widx=3,可读区还是 3 字节,但可写区从 5 变成 7,容量不变。它真正做的是把可读字节左移,腾出尾部空间。- 再写 10 字节,容量从 10 扩到
20,
widx=13;越界那次写入抛IndexOutOfBoundsException,writerIndex(13) + minWritableBytes(10)超过了maxCapacity(20)。 clear()之后两个游标归零,但capacity=20没有缩回去,这就是 buffer 复用时的状态:空间还在,数据会被下一次写覆盖。
ByteBuf 放在哪,怎么分配
索引决定 ByteBuf 怎么用,内存位置决定它的分配和释放成本。
堆内存与直接内存
ByteBuf 的数据可以放在 JVM 堆里,也可以放在堆外的直接内存。
堆内存 ByteBuf 底层是一个 byte[],分配快,受 GC 管理。写
Socket 时,JVM
需要先把堆内数据复制到一块直接内存,再交给内核,因为系统调用不能直接操作会被
GC 移动的堆对象地址。这一趟拷贝是堆内存 ByteBuf 的主要代价。
直接内存 ByteBuf 在 JVM 堆外,写 Socket 时可以跳过堆到堆外的复制。代价是分配要走系统调用,比堆内慢;不受 GC 管理,必须手动 release,否则就是堆外内存泄漏。
| 堆内存 | 直接内存 | |
|---|---|---|
| 底层 | byte[] |
堆外地址 |
| 分配 | 快 | 慢,走系统调用 |
| 写 Socket | 多一次堆到堆外拷贝 | 少一次拷贝 |
| 回收 | GC | 手动 release,池化复用 |
| 适用 | 业务对象、临时拼装 | 网络收发、大 buffer |
直接内存不受 GC 管理,也不是无限的。它的上限受 JVM 的
-XX:MaxDirectMemorySize 和 Netty 的
io.netty.maxDirectMemory 影响,分配过多会抛
OutOfMemoryError: Direct buffer memory。池化分配器可以通过
PooledByteBufAllocator.metric()
看到正在使用的内存量,排查堆外内存问题时比 jmap
更直接。
池化与非池化
池化和非池化是另一个维度。池化分配器预先向系统申请大块内存,自己切分,用完不还给系统,而是还回池子;非池化每次分配都重新申请。
网络框架里 buffer 的分配极其频繁,每个连接、每次读写都可能要一个新的。池化能减少系统调用和 GC 压力,但会带来额外的管理开销和内存占用。分配次数少、buffer 存活时间长、大小不规则的场景,池化的收益可能抵不过开销。
Netty 的分配器大致可以这样分:
| 分配器 | 特点 |
|---|---|
PooledByteBufAllocator |
池化,支持 heap/direct,按 Arena/Chunk/Page 管理 |
UnpooledByteBufAllocator |
非池化,每次分配新内存 |
Unpooled 工具类 |
非池化,提供
buffer()、directBuffer()、wrappedBuffer()
等快捷方法 |
池化和堆内/堆外是正交的,所以组合起来有四种:池化堆内、池化堆外、非池化堆内、非池化堆外。
具体怎么选,可以先按三个问题过一遍:
- 这块 buffer 会不会直接写到 Socket?会,优先直接内存;
- 创建频率高不高、大小是否集中在少数几档?高且集中,池化收益明显;
- 生命周期是方法内,还是跨 Handler、跨线程?跨生命周期时,释放责任比“省一次拷贝”更重要。
没有哪一个选项在所有场景都更快。分配器、池化参数、消息大小分布要一起看,压测时也不能只测吞吐,还要看 P99 和内存占用。
Netty 4.2 默认的 ByteBufAllocator.DEFAULT 是
AdaptiveByteBufAllocator,它会根据运行情况在池化和非池化之间做自适应选择。这个类在
4.2 才成为默认值,4.1 及更早版本默认是
PooledByteBufAllocator。
Adaptive 在官方文档里还标着 experimental,4.2
发布说明又把它作为默认实现,两个官方口径并不完全一致。如果只是想把行为对齐
4.1,可以显式加
-Dio.netty.allocator.type=pooled;生产环境是否切换,要结合自己的分配模式和压测结果判断。
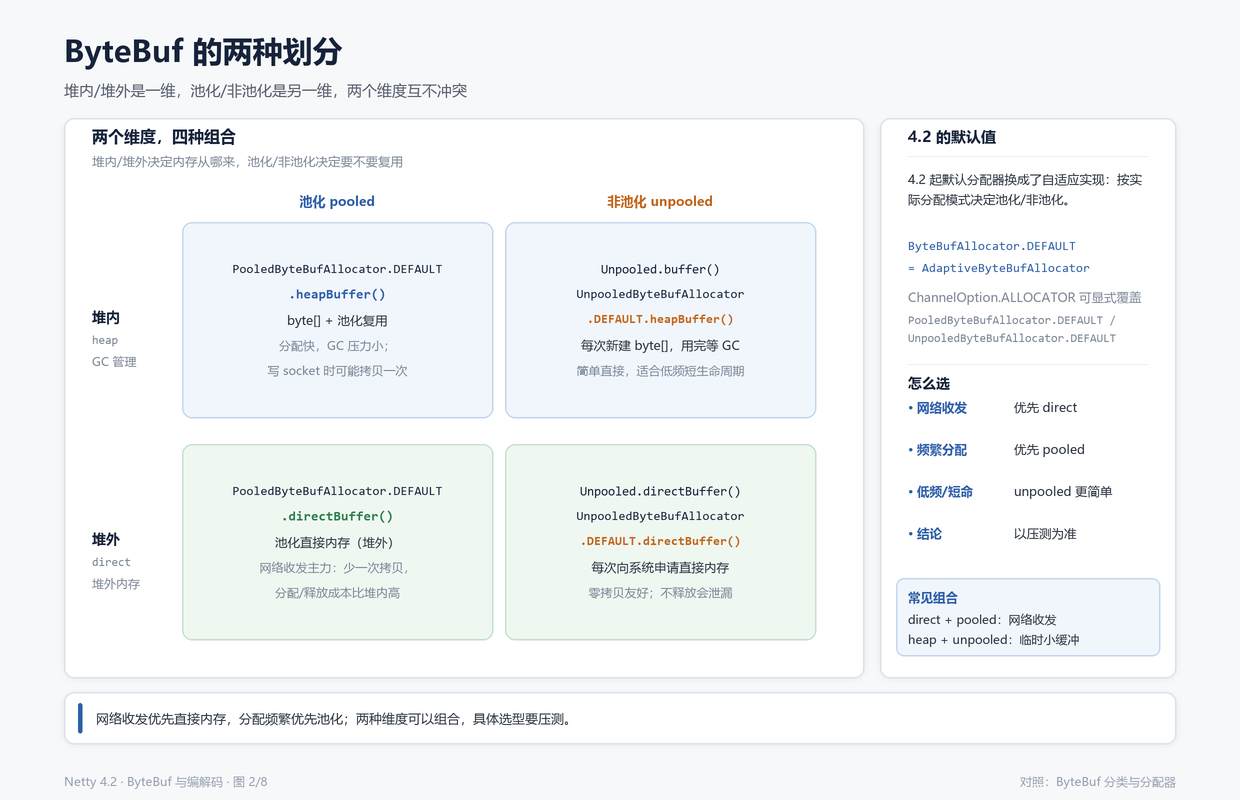
分配方式实验
ByteBufAllocDemo 打印了五种分配方式的关键属性:
1 | // 五种最常用的创建方式 |
describe 只做三件事:打印类名、打印
isDirect/hasArray/capacity/maxCapacity、打印分配器类名。
运行结果:
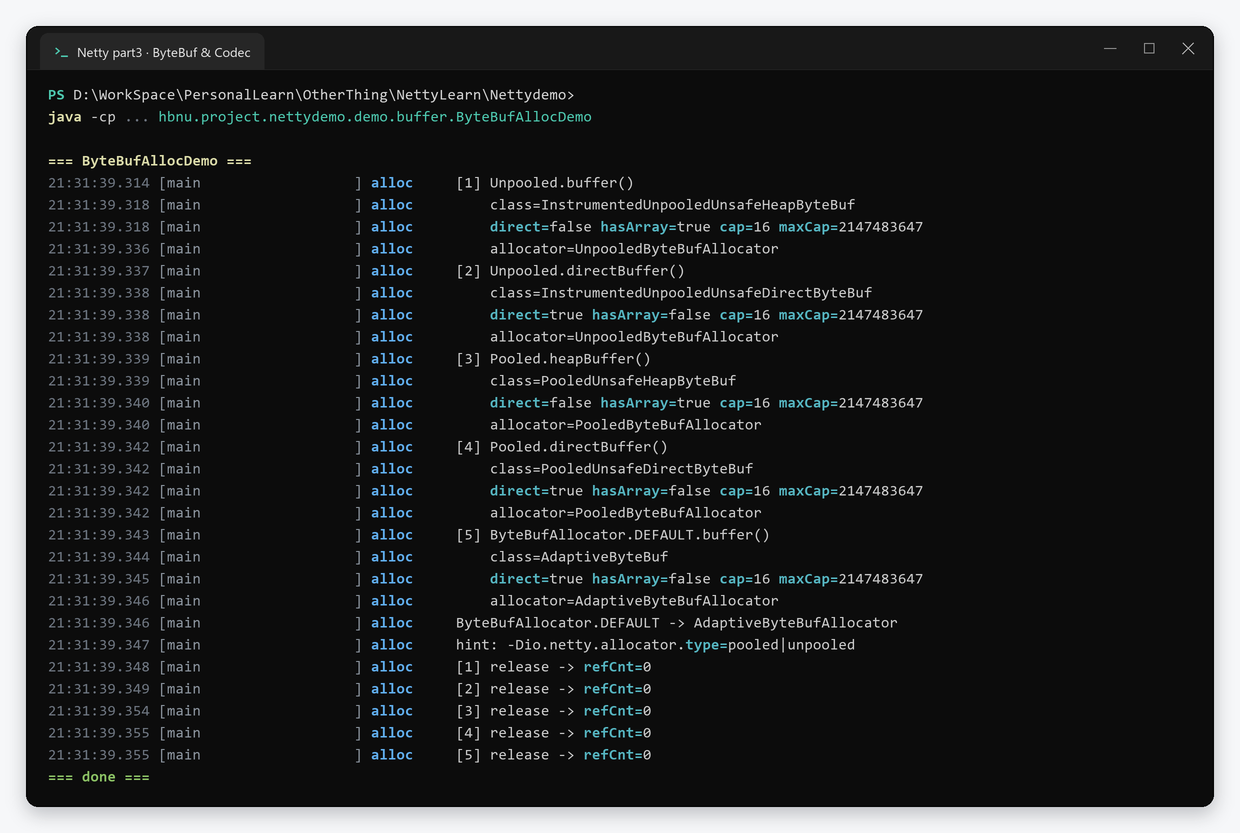
从输出里可以按三个维度判断:
Unpooled.buffer()的类名带Unpooled,direct=false、hasArray=true,是堆内非池化;Unpooled.directBuffer()的类名带Unpooled,direct=true、hasArray=false,是堆外非池化;PooledByteBufAllocator的 heap/direct 类名都带Pooled,maxCapacity是Integer.MAX_VALUE;ByteBufAllocator.DEFAULT.buffer()返回AdaptiveByteBuf,分配器是AdaptiveByteBufAllocator,这是 4.2 的默认行为;- 五块 buffer 释放后
refCnt都归 0。
这里顺带回答一个常见问题:池化 buffer 调 release()
之后,内存并没有还给操作系统,而是回到池子里。所以“释放了内存占用却没降”是正常的,池子会保留已申请的内存供后续复用。
引用计数
ByteBuf 可以池化,也可以放在堆外,这两件事都有同一个问题,这块内存什么时候能还给池子或系统。Java 的 GC 管不了池化和堆外内存,Netty 用引用计数来管。
这个 ByteBuf 对象没被 GC 回收 ≠ 它背后的内存可以还回去了
为什么需要引用计数
引用计数回答的是一个很具体的问题,这块 buffer 现在还有没有人用。
ByteBuf 创建时 refCnt 是 1。每次 retain()
加 1,每次 release() 减 1。减到 0 时,Netty
知道这块内存没人用了,可以归还池子或释放堆外内存。
1 | ByteBuf buffer = ctx.alloc().buffer(128); // refCnt = 1,我是所有者 |
这段代码的关键不是 release() 本身,而是
buffer = null。writeAndFlush 会把 buffer
交给写流程,写完之后由 Netty 负责 release。如果调用方还保留引用并在
finally 里再 release 一次,就是重复释放。
引用计数带来的规则比 GC 严格得多,因为 GC 下你几乎不用想是谁释放的,但引用计数必须显式约定所有权
- 谁创建、谁最后使用,谁负责 release;创建者默认是所有者,用完要减
- 把 buffer 交给异步任务或别的线程,要明确所有权是否转移;转移了就别再 release;没转移就自己 release
- 视图和原 buffer 共享同一个引用计数,release 任何一个都作用在同一个计数上;
- 计数归零后再访问,会抛
IllegalReferenceCountException。
这些规则在官方 wiki 的 Reference counted objects 里有一份完整说明(Reference counted objects),本文只展开最常用的部分。
retain 与 release
retain() 不只是给 我要多用一会 准备的,它也是跨线程传递
buffer 时的所有权声明。
A 线程创建 buffer 交给 B 线程异步处理,B 线程处理期间 A
可能已经结束,B 就需要先 retain() 再使用,处理完再
release()。如果两边都以为对方会
release,就会泄漏;如果两边都 release,就会重复释放。
所以跨线程时,retain() 是 加入使用者名单
的动作,release() 是 我退出名单。关键是:谁 retain
了,谁就负责对应的 release。
Netty 提供了
ReferenceCountUtil.release(msg),它对非引用计数对象是空操作,对
ByteBuf 会调用 release,适合写在通用的 finally 里。
还有一个ReferenceCountUtil.safeRelease(msg),release
时如果抛异常,只记日志、不打断当前流程。适合异常处理路径,你正在处理一个异常,不想因为
release 再抛一个异常把原始错误盖掉。
异常路径是最容易漏 release 的地方。正常路径通常有
finally,但编码失败、下游抛异常、连接提前关闭这些分支,代码可能直接
return 了。美团技术团队记录过一个生产案例:断连时 encode 抛
NPE,导致后面的 release 没有执行,每次连接泄漏 256
字节,长期累积成堆外内存泄漏(Netty
堆外内存泄露排查盛宴)。异常路径也要释放,不是一句代码规范,是生产环境验证过的教训。
SimpleChannelInboundHandler 为什么不用手动释放
SimpleChannelInboundHandler
把消息释放写进了模板方法:
1 | public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception { |
业务代码只写
channelRead0,消息在方法返回后自动释放。这也是为什么上一篇说,用
SimpleChannelInboundHandler 时不需要自己 release。
这里有一个容易被忽略的边界:它只对类型匹配的消息自动释放。如果消息类型不匹配,acceptInboundMessage
返回 false,release=false,消息会继续往后传,本 Handler
不释放。所以“它会把所有消息都释放”的说法是错的。
换成 ChannelInboundHandlerAdapter
就没有这层保护。消息到了
channelRead,谁消费谁负责释放;如果只是看一眼又往后传,就不应该
release,因为后面的 Handler 还要用。如果一路没人消费,消息传到 Pipeline
末尾的 tail,tail 会兜底释放,避免泄漏。
这也是为什么“用哪个基类”会影响释放责任,而不只是代码风格。
引用计数实验
ReferenceCountDemo 把
retain、release、归零后再访问、自动释放和手动释放放在一起:
1 | // ① 手工 retain / release:创建时 refCnt=1 |
运行结果:
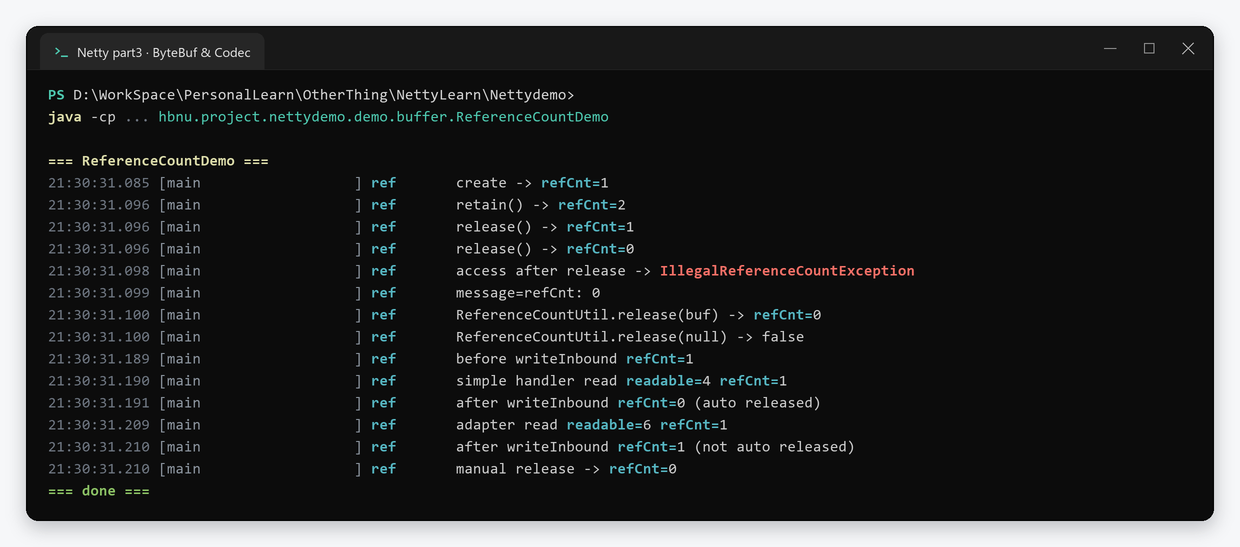
几个关键行:
create -> refCnt=1,retain() -> refCnt=2,连续两次release()后归 0;- 归 0 后再
writeByte,抛IllegalReferenceCountException,message 是refCnt: 0; SimpleChannelInboundHandler的writeInbound返回后,同一块 buffer 的refCnt=0,说明框架已经释放;ChannelInboundHandlerAdapter的writeInbound返回后refCnt=1,必须手动 release。
这也解释了一个常见困惑:同样是入站 Handler,为什么有的写法不用 release,有的必须 release。区别不在“谁更规范”,而在基类有没有替你做这件事。
泄漏检测
引用计数最怕的是忘记 release。Netty 提供了
ResourceLeakDetector 来抓这类问题。它不会实时扫描所有
buffer,而是用采样的方式记录 buffer 的分配点,在对象被 GC
后、下一次有被采样的分配发生时,检查引用队列并打印 LEAK 报告。
这个时机很重要:不是 release 时立刻报,也不是每次 GC
都报。没有新的分配,就没有人去检查引用队列,这也是
LeakDetectDemo 每轮 GC 后都要再分配一个小 buffer
的原因。
泄漏检测的级别:
| 级别 | 行为 |
|---|---|
DISABLED |
关闭 |
SIMPLE |
默认,低开销,只采样少量 buffer |
ADVANCED |
采样更多,能给出更完整的分配栈 |
PARANOID |
每个 buffer 都记录,开销最大,适合排查阶段 |
打开方式是在启动参数里加:
1 | -Dio.netty.leakDetection.level=paranoid |
LeakDetectDemo 故意分配一个 buffer 不释放,然后循环触发
GC,等 Netty 打出报告:
1 | // 故意分配一个 direct buffer,写入后不 release;方法返回后局部引用消失 |
运行结果:
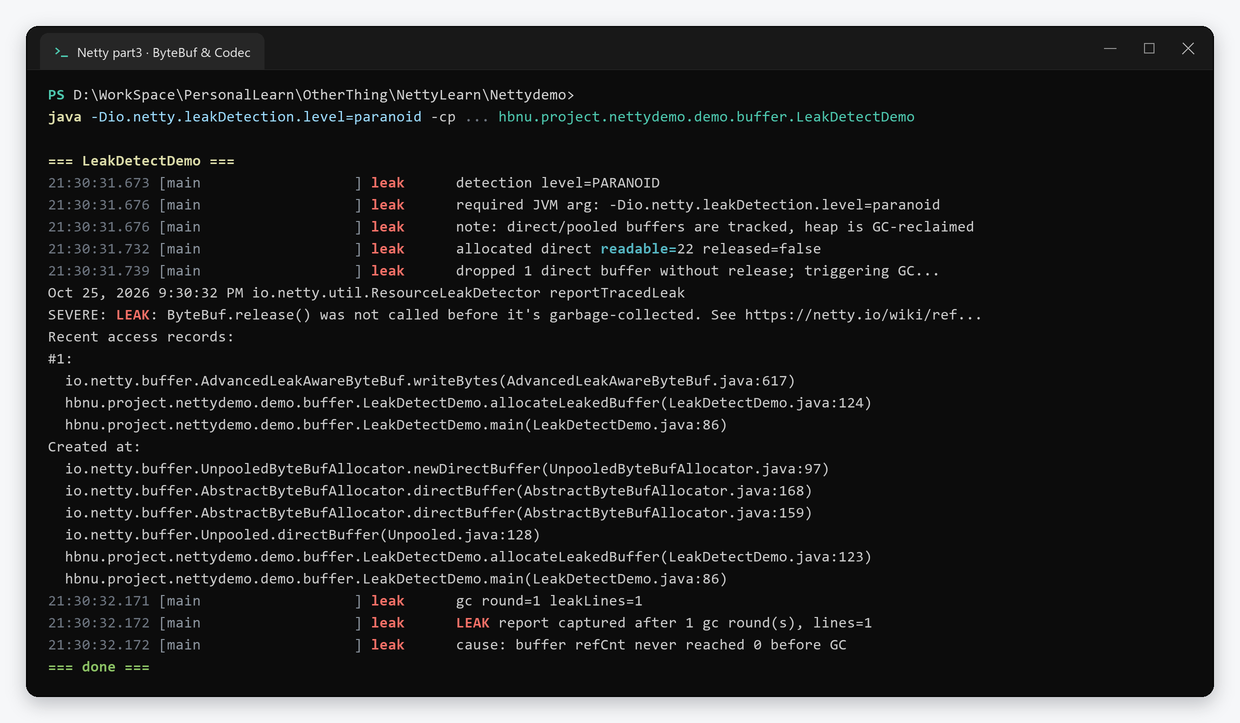
报告里的
LEAK: ByteBuf.release() was not called before it's garbage-collected
就是正文,下面会带分配点和最近的访问记录。
这里有两个细节值得注意:
- 演示故意用
directBuffer。在 4.2 里,堆内 buffer 不会被 leak-aware 包装,故意泄漏堆内 buffer 通常看不到 LEAK; - 报告里的分配点指向
allocateLeakedBuffer,能看到是哪一行创建了 buffer。targetRecords越大,保留的访问记录越多,开销也越大。
生产环境不建议长期开
PARANOID,它会让每次分配都记录调用栈,吞吐会明显下降。SIMPLE
的采样开销很小,可以常驻;怀疑泄漏时再临时开到 ADVANCED 或
PARANOID,配合
-Dio.netty.leakDetection.targetRecords=...
调整记录条数。
零拷贝的几种做法
前面提到过零拷贝。在 Netty 里,零拷贝不只有网络收发时的直接内存和
FileRegion,还有一组 buffer 层面的
API,用来避免不必要的内存复制。
这几个 API 经常被放在一起讲,但它们的语义差别很大。有的只是视图,有的真的减少了拷贝,有的会增加引用计数。
slice 与 duplicate
slice() 从原 buffer 中切出一段,返回一个新的 ByteBuf。新
buffer 的 readerIndex 从 0 开始,capacity
是切片长度,底层内存和原 buffer 是同一块内存。
1 | ByteBuf buf = Unpooled.buffer(10); |
- 它不复制数据,只是换了一组索引来访问同一块内存。修改 slice,原 buffer 的内容会变;反过来也一样。
slice自己的索引从 0 开始:slice.readerIndex()==0,slice.capacity()==4。也就是说,在 slice 眼里slice.getByte(0)就是原 buffer 的getByte(2)。- 双向可见:改 slice → 原 buffer 内容变;改原 buffer → slice 看到的内容也变。因为是同一块内存。
duplicate() 复制整个 buffer
的索引状态,读写指针各自独立,但底层内存仍然共享。类似于深拷贝。
- 不复制数据,底层内存完全共享
- 区别在索引,
duplicate复制的是整个 buffer 的索引状态(capacity、readerIndex、writerIndex 的当前值),而且之后两个 buffer 的读写指针互不影响。
这两个 API 都不会增加引用计数,返回的 buffer 和原 buffer 的
refCnt() 是同一个值。
1 | System.out.println(buf.refCnt()); // 1 |
它们共享同一个 refCnt。这意味着:
slice.release()减的是父 buffer 的计数。- 父 buffer 的计数归零被回收后,slice/duplicate 也不能再用了(再用抛
IllegalReferenceCountException)。
所以说,视图的生命周期必须绑定在父 buffer 上。父 buffer 释放了,视图立即失效
最常见的错误:对视图也 release 一次
2
3
4
5
6
7
8
9
ByteBuf slice = buf.slice(...); // 还是同一个 refCnt = 1
// 错误做法:
slice.release(); // refCnt 减到 0 → 内存被归还!
buf.release(); // 再减 → 重复释放 / 异常!
// 正确做法:只 release 一次,通常 release 父 buffer 即可
buf.release(); // refCnt = 0,slice 随之失效
- 只是临时用一下视图,不要 release 视图,让父 buffer 的生命周期统一管理
- 视图要脱离父 buffer 长期独立存活,那得自己
retain()父 buffer 来延长生命周期,用完再release()。因为你不能指望父 buffer 的所有者替你养着这块内存。
retainedSlice 与 copy
retainedSlice() 和 slice()
的区别只有一点,它会把引用计数加 1,相当于声明
这个视图要独立存活一段时。用完必须自己 release,否则父 buffer
的计数永远不归零。
copy() 是真正的复制,会分配一块新内存,把数据拷进去。新
buffer 的引用计数是独立的,生命周期也和原 buffer
无关。代价就是一次内存复制。
| API | 是否复制 | refCnt | 生命周期 |
|---|---|---|---|
slice() |
否 | 与父 buffer 相同 | 依附父 buffer |
duplicate() |
否 | 与父 buffer 相同 | 依附父 buffer |
retainedSlice() |
否 | +1 | 可独立存活,需 release |
copy() |
是 | 独立,初始 1 | 完全独立 |
CompositeByteBuf |
否 | 组合视图 | 持有组件的所有权 |
wrappedBuffer(byte[]) |
否 | 1 | 包装原数组,不复制 |
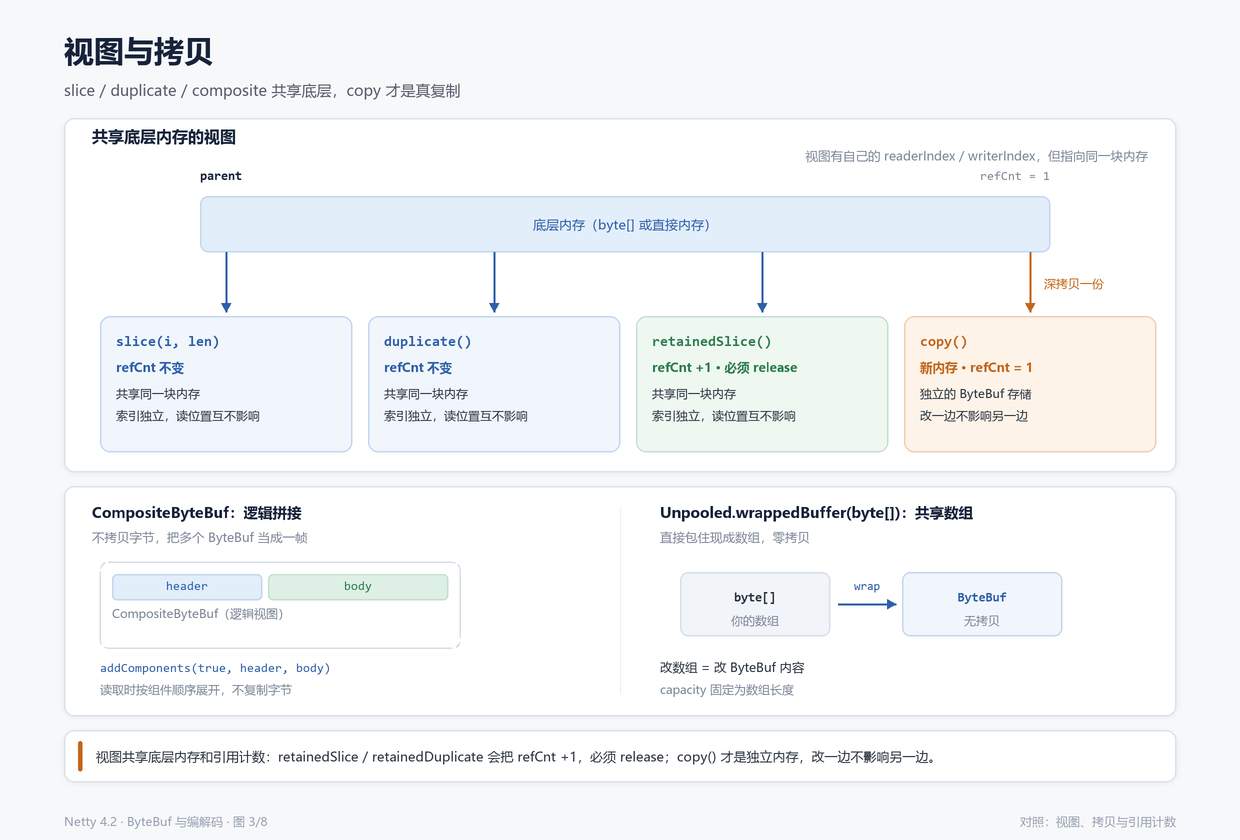
CompositeByteBuf
CompositeByteBuf 用来把多个 buffer 逻辑上拼成一个。
假设协议消息由 header 和 body 两段组成,两段分别来自不同的
buffer。最直接的做法是申请一块大内存,把 header 和 body
逐个拷进去。CompositeByteBuf
提供另一种思路,不复制,只维护一个组件列表,对外仍然表现得像一个连续的
ByteBuf。
1 | CompositeByteBuf message = Unpooled.compositeBuffer(); |
`addComponents(true, ...) 的第一个参数是
increaseWriterIndex:传 true
时,组件会被当作”已经写好的数据”直接接到可写区后面(writerIndex
相应增加)。如果传 false,组件虽然加进去了,但
writerIndex 不变,你需要自己调
writerIndex(...) 把它推进到可读位置。
组件一旦加入
CompositeByteBuf,所有权就转移了:
- 释放
composite时,会一并释放所有组件。 - 调用方不能再单独
release组件,否则就是重复释放。
组合视图的代价是随机访问,因为本质上不是一块连续内存。按下标读写时,要先定位落在哪个组件里,比连续数组慢。顺序读取则没有这个问题。
CompositeByteBuf 还有一个容易忽略的行为:组件数超过
maxNumComponents(默认 16)时,它会触发一次
consolidate,把多个组件合并成一块连续内存。这一步会真正拷贝。组件不多时它才是零拷贝,组件越拆越碎,收益会反过来。
wrappedBuffer
Unpooled.wrappedBuffer(byte[])
把一个已有的字节数组包装成 ByteBuf,不复制数组。修改原数组,buffer
的内容会跟着变;反过来也一样。
但是它不接管数组的生命周期,这一点和 CompositeByteBuf
正好相反:
wrappedBuffer只负责包装,不负责数组的回收。数组的生命周期必须由调用方自己保证。
数组是 Java 对象,本身由 GC 管理,wrappedBuffer
也管不了它,它甚至没有释放数组这个概念。但你要注意:
- 只要 buffer 还被使用,你就必须保证底层数组没有被逻辑上作废,比如被复用、被清空、被别的代码改写。
- buffer 无法阻止数组被修改,它只是一层视图。
视图实验
ByteBufViewDemo 把这些 API
放在一起,验证它们是否真的共享内存、引用计数怎么变:
1 | // 父 Buffer:HELLO-WORLD |
运行结果:
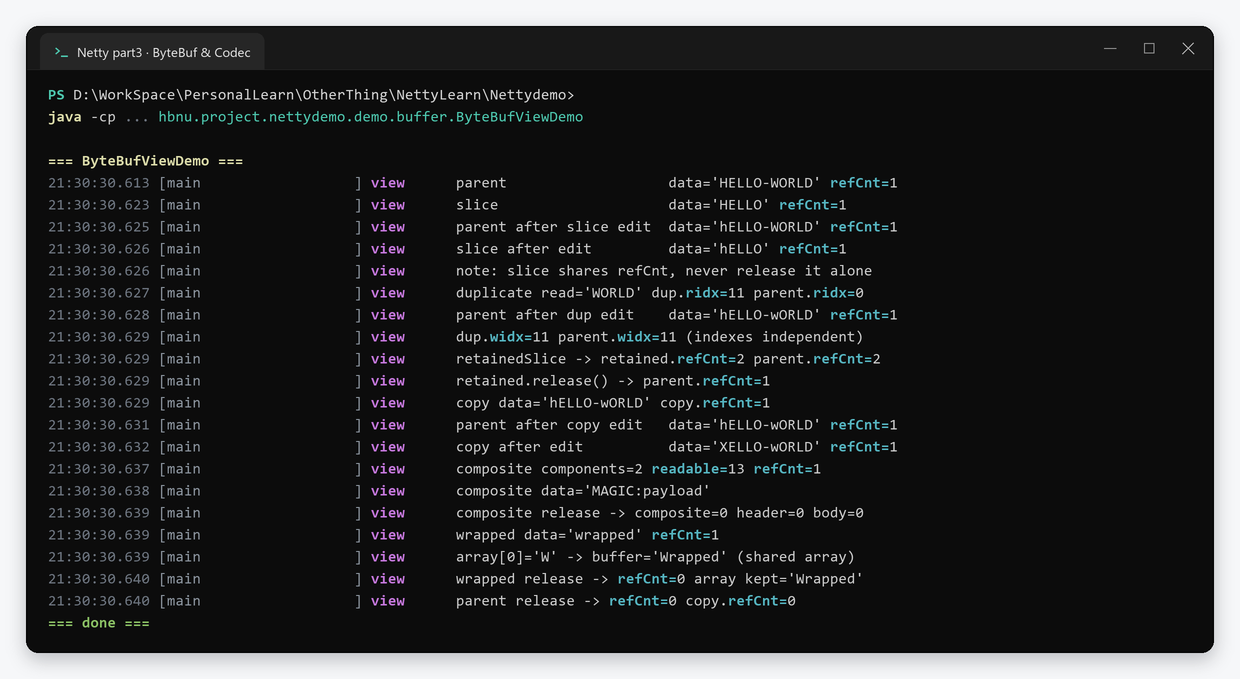
从输出可以确认几件事:
slice和父 Buffer 的refCnt始终是 1,改 slice 的字节,父 Buffer 同步变化,说明它们共享内存和引用计数;duplicate的ridx/widx独立推进,但改字节仍然影响父 Buffer;retainedSlice之后父子refCnt=2,release 后回到 1;copy改首字节后父 Buffer 不变,copy.refCnt=1;composite的numComponents()=2,整体读出MAGIC:payload,release 之后组件的 refCnt 一起归 0;wrappedBuffer包装数组后,改array[0],buffer 内容同步变化,说明底层就是同一个数组。
最容易出错的是 slice 和
retainedSlice:前者不能单独 release,后者必须单独
release。名字只差一个 retained,所有权正好相反。
粘包与半包
ByteBuf 解决的是 数据怎么放,接下来要解决 一条消息到哪结束。这就是粘包和半包的问题。
字节流不保留消息边界
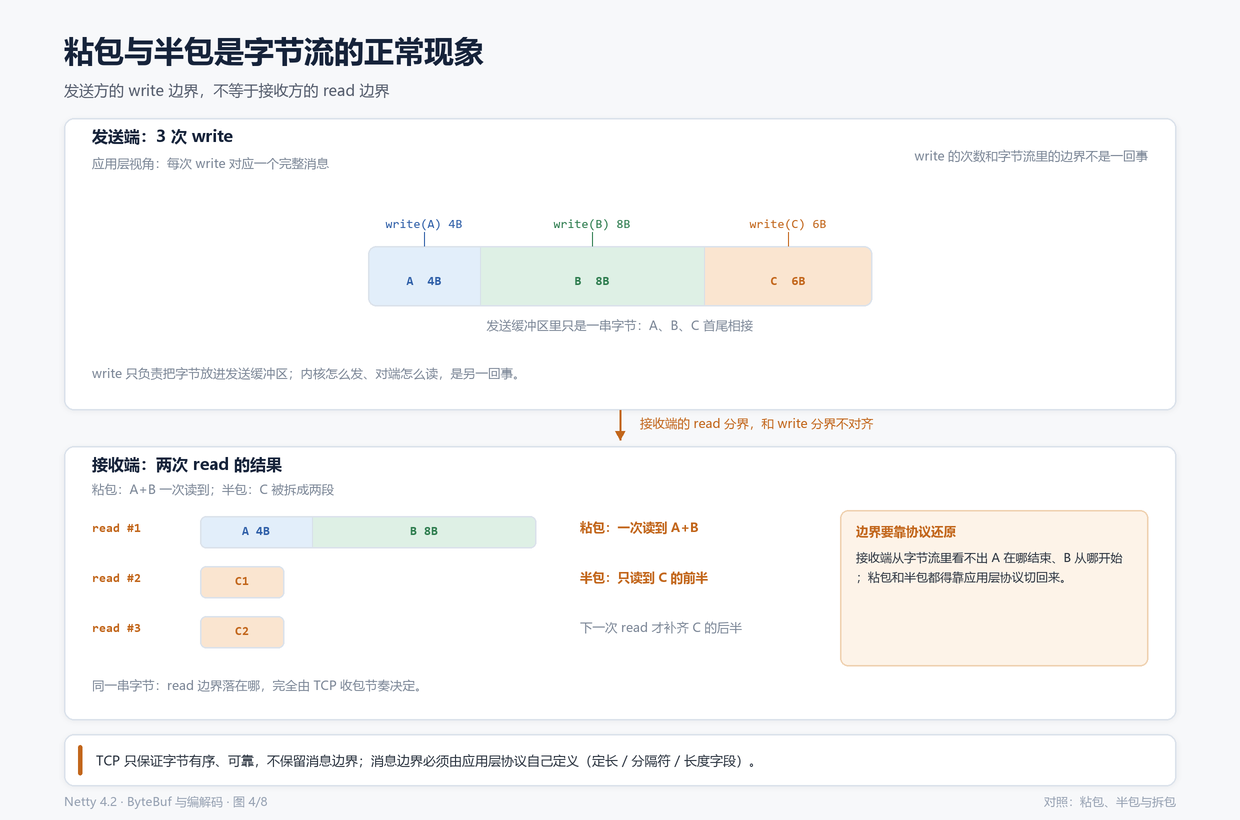
TCP 是字节流协议。它保证字节按顺序、可靠地到达,但不保留应用层
write 的边界。
发送方调用三次
write,每次写一条消息。到了接收方,可能是三次
read 各读到一条,也可能一次 read
读到两条、下一次读到半条,还可能一条消息分三次才读全。
TCP 只负责把字节送到,至于这些字节怎么分组、每次读出来多少,和发送方的写次数没有一一对应关系。
放大这个差异的还有几个因素:Nagle 算法会把小包攒起来再发,MSS/MTU
会限制单个 TCP
段的大小,接收缓冲区和滑动窗口决定了一次能交给应用多少字节。所以同一条消息在发送端是一个
write,在接收端可能是 1 次、2 次甚至更多次
read。
所以“粘包”和“半包”描述的是接收方的读取结果不符合应用层的消息边界预期,不是 TCP 出错了。字节本身完全正确,只是应用层还没有定义“一条消息到哪结束”。官方 User Guide 在 Dealing with a Stream-based Transport 一节里用同样的例子解释过这个问题(Netty User Guide)。
三种拆包方案
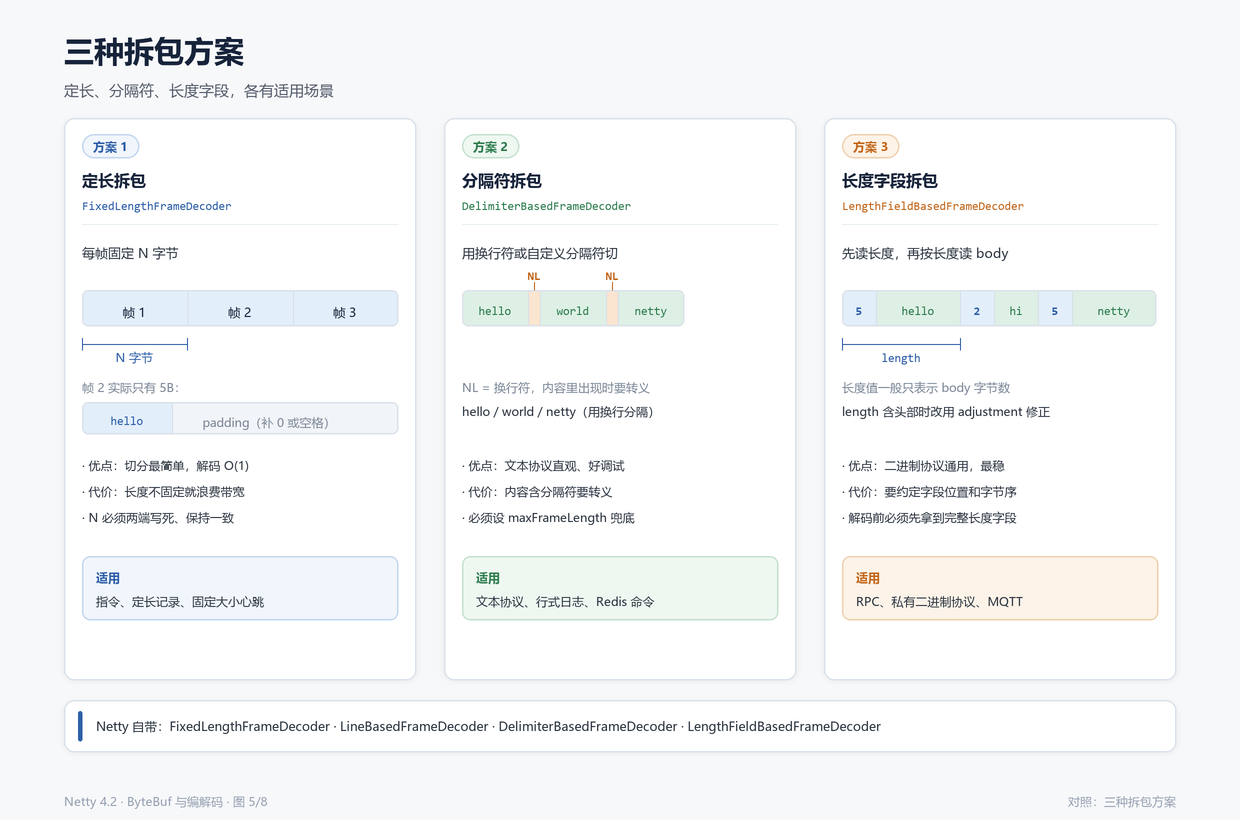
应用层要自己定义消息边界。常见做法只有三种:
| 方案 | 规则 | 优点 | 代价 |
|---|---|---|---|
| 定长 | 每条消息固定 N 字节 | 实现最简单,解析快 | 消息长度必须固定,不足要填充,浪费带宽 |
| 分隔符 | 用特殊字节标记消息结束,如换行 | 文本协议友好,可读性好 | 消息内容不能随意包含分隔符,需要转义或限制长度 |
| 长度字段 | 消息头里写 body 长度,先读长度再读 body | 通用,二进制协议常用,长度可预知 | 需要设计帧头,长度字段本身也要防越界 |
Netty 为这三种方案都提供了开箱即用的解码器:
FixedLengthFrameDecoder;DelimiterBasedFrameDecoder,LineBasedFrameDecoder是它的换行特化版;LengthFieldBasedFrameDecoder。
选哪种,取决于协议是不是自己设计的。对接已有文本协议,通常只能用分隔符;自己设计二进制协议,长度字段最通用。
一个真实的粘包/半包实验
FrameCodecDemo 在 9006 上起了一个单进程的 server 和
client。server 的 Pipeline 里,第一个 Handler 打印每次从 Socket
读到的原始字节数,后面才是长度字段解码器和业务 Handler。
client 手工构造帧,一个字节一个字节地控制写入方式:
- 写一个完整帧;
- 把两个完整帧拼成一个 ByteBuf,一次 write;
- 把一个帧拆成两半,分两次 write,中间 flush。
server 端能看到原始 chunk 的大小和最终解出的帧数对不上,这正是粘包和半包。
1 | // server:raw 观察者必须在解码器之前,才能看到 TCP 每次 read 的边界 |
运行结果:
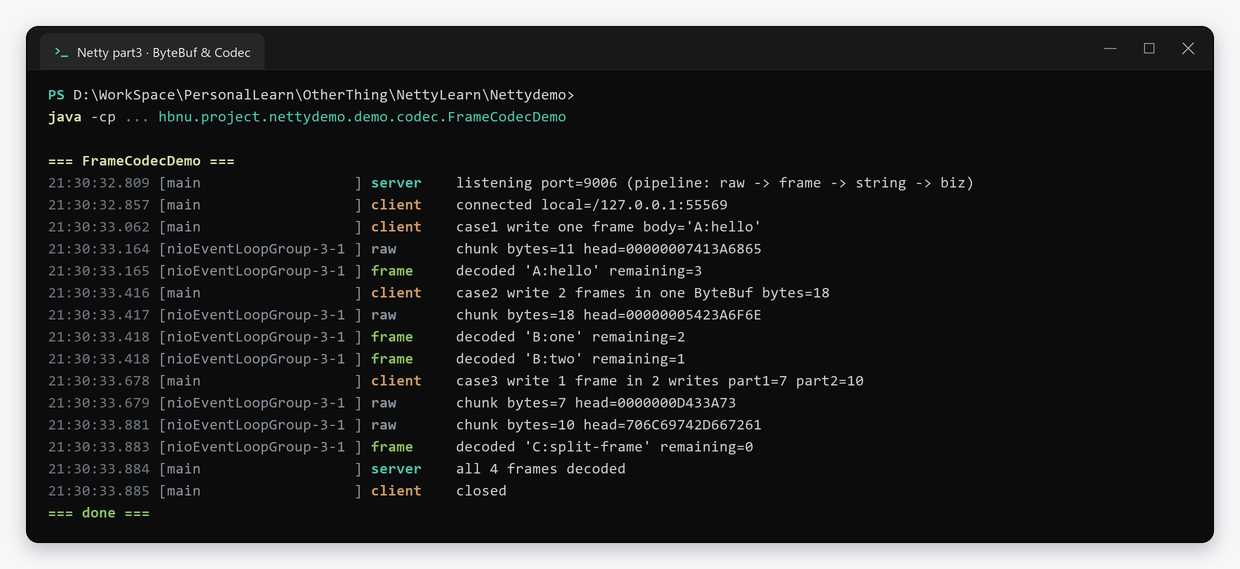
对着日志看三组对比:
- case1:
raw chunk bytes=11,frame decoded 'A:hello',11 刚好是 4 字节长度加 7 字节 body; - case2:
raw chunk bytes=18只有一行,但frame有两行B:one、B:two,一次 read 里的两个帧被解码器循环切开了; - case3:
raw有两行 7 和 10 字节,frame只有一行C:split-frame,半包被累积区拼了回来。
日志里的 remaining=
是还没收到的帧数倒数,不是剩余字节数,remaining=3 → 2 → 1 → 0
对应四个帧依次到齐。
这一段先说明粘包半包的成因和三种方案。下面进入 Netty 的解码器,看它怎么把半截字节攒成完整消息。
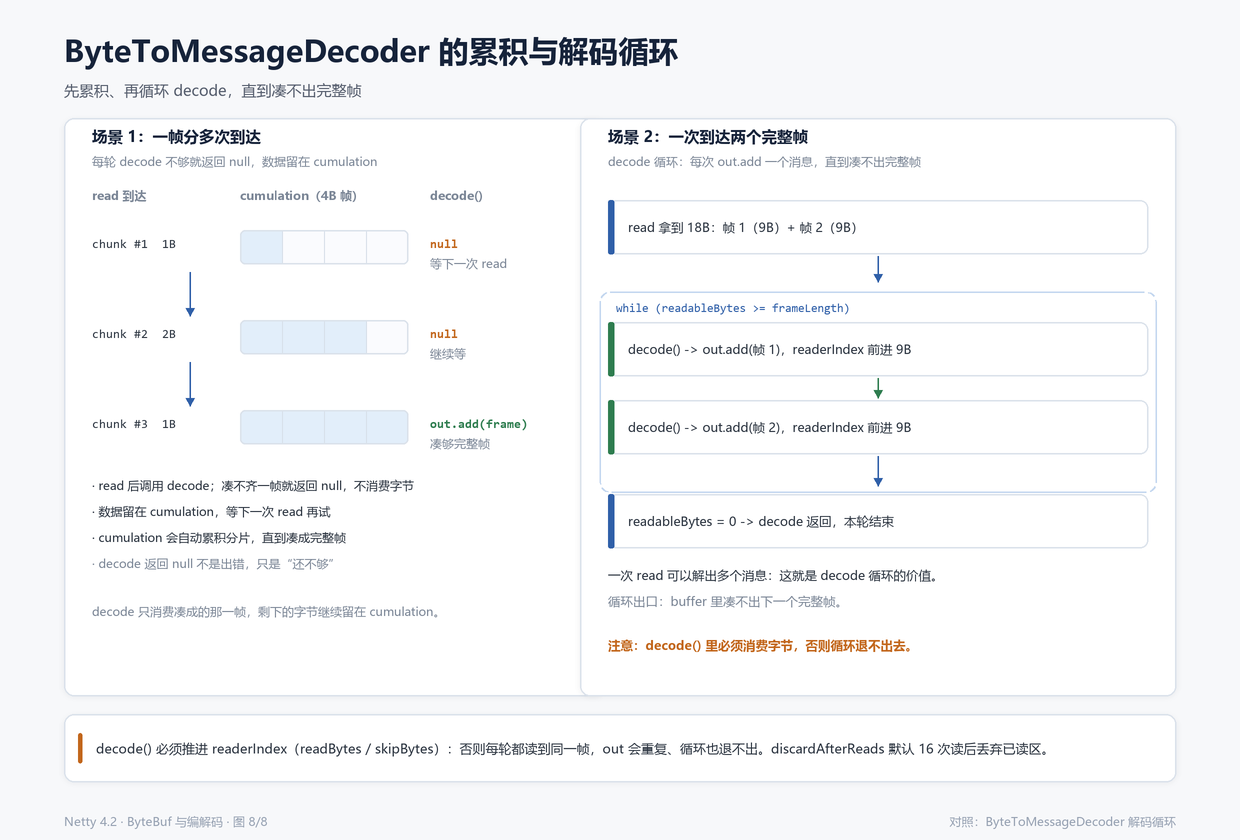
ByteToMessageDecoder
Netty 的帧解码器都继承自
ByteToMessageDecoder。它解决的是同一个问题:一次读到的字节可能不够一条消息,也可能多了好几条消息,解码器要自己维护一个累积区,把字节攒够再切(ByteToMessageDecoder
4.2 javadoc)。来避免粘包和半包的问题。
累积缓冲区
ByteToMessageDecoder 内部持有一个
cumulation,类型也是 ByteBuf。数据到达时,它先把新读到的
ByteBuf 累积进去,再尝试解码。
1 | Socket 读到的 chunk |
累积区存在的意义是让 decode
方法可以假设,我拿到的是一段可以反复看的字节,而不是这一次 read
的全部。
解码器可以只看头部 4 个字节判断长度,不够就返回,等下一次数据到达再继续。直到能接码出一个完整的消息
解码循环
一次数据到达后,ByteToMessageDecoder 不会只调用一次
decode,而是循环调用,直到累积区里凑不出完整消息:
1 | // 简化后的 callDecode 逻辑 |
两个关键点:
decode必须消费字节(推进readerIndex)或者产出消息,否则循环会停住。只读不消费,是自定义解码器最常见的 bug。如果产出了消息却没有消费任何字节,Netty 会直接抛DecoderException,提示decode() did not read anything but decoded a message。- 一次
decode可以产出多条消息。比如累积区里已经有两个完整帧,decode可以连续out.add两次,框架会依次传给后面的 Handler。
解码器不需要自己处理 数据不够 的情况。只要 decode
返回时没有产出消息,框架就知道要等下一次
read。累积区会在合适的时候丢弃已经读过的部分,默认是 16
次读之后(discardAfterReads),避免无限增长。
decode 里也不能做阻塞操作。因为它运行在 EventLoop
线程上,Thread.sleep、await、同步 RPC
都会卡住这个线程上所有的连接。数据没到就返回,让框架等下一次
read,这是解码器唯一需要做的等待方式。
这里实际用的是
discardSomeReadBytes(),不是每次读一半就搬内存。它只在
cumulation.refCnt() == 1 时才丢弃,因为如果外部还持有
retainedSlice,搬动累积区会让那些视图失效。
1 字节分片实验
CustomDecoderDemo 自己写了一个长度字段解码器,然后用
EmbeddedChannel 每次只喂 1 个字节,观察 decode
被调用了几次、累积区里还有多少字节:
1 | private static final class LengthFieldDecoder extends ByteToMessageDecoder { |
运行结果:
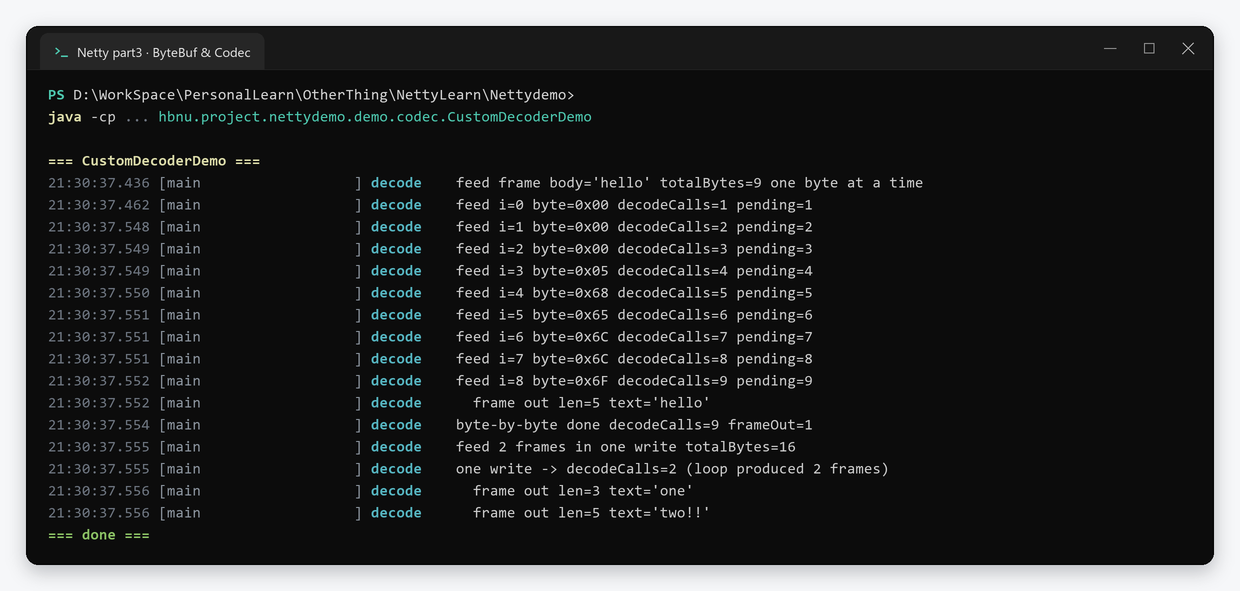
前 9 行每次只喂 1 个字节,decodeCalls 从 1 涨到
9,pending 也从 1 涨到 9:前 4
个字节时长度字段不完整,decode 直接返回;第 5
个字节开始有长度没有 body,decode 读长度后
resetReaderIndex,继续等;直到第 9 个字节到齐,才
out.add 出一个 5 字节的帧。
第二组一次性喂两个帧(共 16 字节),decodeCalls=2
就产出了两条消息,说明一次 channelRead 里
decode 可以被循环调用。decode 不是“每次 read
调一次”,而是“只要累积区还能解出东西就继续调”。
这里能看到解码器和业务 Handler 的分工:解码器只负责把字节变成完整帧,业务 Handler 收到的一定是“一条完整消息”,不需要再关心半包。
LengthFieldBasedFrameDecoder
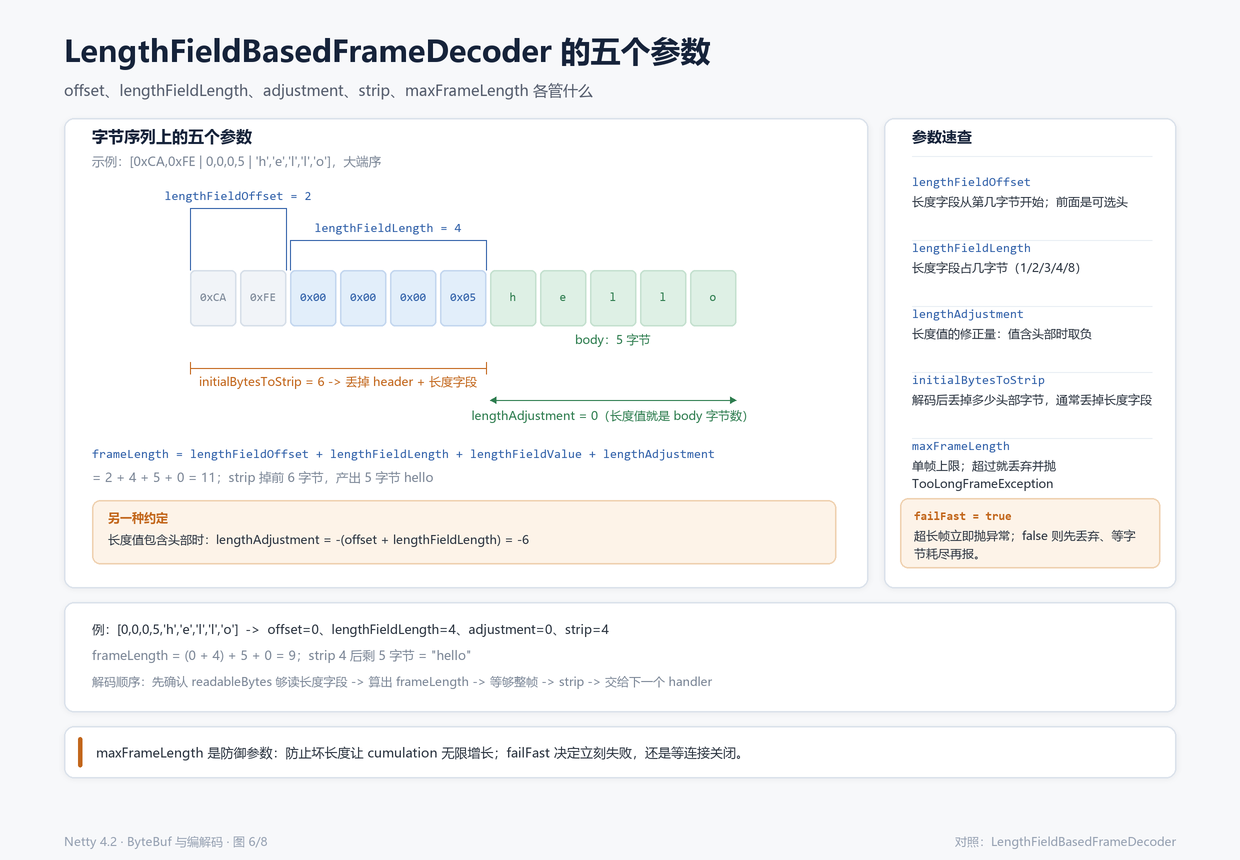
三种方案里,长度字段最通用,也最容易配错。Netty 的
LengthFieldBasedFrameDecoder 把常见的变化都抽象成了参数
五个参数和实验
构造器的完整签名是:
1 | new LengthFieldBasedFrameDecoder( |
| 参数 | 作用 |
|---|---|
maxFrameLength |
一帧的最大长度,超过就抛
TooLongFrameException,防止恶意长度把内存撑爆 |
lengthFieldOffset |
长度字段从帧头的第几个字节开始 |
lengthFieldLength |
长度字段本身占几个字节,支持 1、2、3、4、8 |
lengthAdjustment |
长度字段的值需要修正多少,才能得到整帧长度 |
initialBytesToStrip |
解码后从帧头去掉多少字节,比如去掉长度字段 |
failFast |
长度超过 maxFrameLength
时,是立刻抛异常还是读完再抛 |
把常见的几种帧结构对应的参数列在一起,配参数时可以直接对号入座:
| 帧结构 | offset | lengthFieldLength | adjustment | strip |
|---|---|---|---|---|
| 长度字段 + body,返回整帧 | 0 | 4 | 0 | 0 |
| 长度字段 + body,只返回 body | 0 | 4 | 0 | 4 |
| 2 字节头 + 长度字段 + body | 2 | 4 | 0 | 6 |
| 长度字段的值是整帧长度 | 0 | 4 | -4 | 4 |
| 2 字节头 + 长度字段 + body + 2 字节尾 | 2 | 4 | 2 | 6 |
lengthAdjustment
是最容易绕晕的参数。它调整的是整帧长度:
1 | frameLength = lengthFieldValue + lengthAdjustment + lengthFieldEndOffset |
如果长度字段的值就是 body 长度,lengthAdjustment 是
0;如果长度字段的值包含了帧头,修正值就是负数,大小等于长度字段之前的那些字节;如果长度字段后面还有别的字段,修正值就要把这些字段算进去。
举个例子:帧头 2 字节,长度字段 4 字节,长度字段的值是整帧长度 13(2
+ 4 + 7),要把长度值修正成 body 长度 7,lengthAdjustment
就是 -(2 + 4) = -6。这个负号是很多参数配错的来源。
initialBytesToStrip 则决定返回给业务 Handler
的帧是什么样子。设成
0,返回的帧包含长度字段和帧头;设成长度字段的结尾,返回的帧就只有
body。解码器返回的帧是 retainedSlice
视图,不是拷贝,所以帧仍然共享底层内存,也要按引用计数释放。
参数实验
LengthFieldConfigDemo
用同一段字节,配不同的参数,观察解出来的帧:
1 | // 样例 A:4 字节长度 + "hello" |
运行结果:
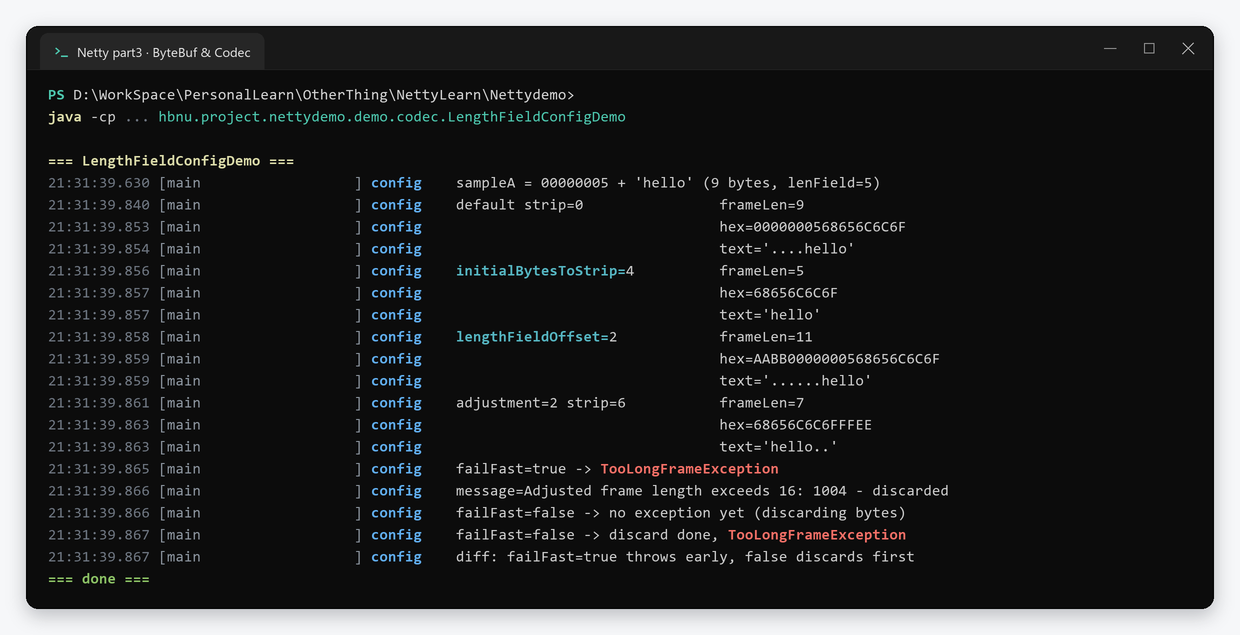
逐行对照:
- 默认配置返回
frameLen=9,十六进制是00000005 68656C6C6F,长度字段还在帧里; initialBytesToStrip=4后frameLen=5,只剩hello;lengthFieldOffset=2时帧变成 11 字节,保留了前面的AABB头;adjustment=2 strip=6时,长度字段仍是 5,但帧尾有 2 字节 trailer,所以frameLength = 5 + 2 + 6 = 13,strip 掉 6 字节后返回 7 字节hello加 2 字节 trailer;failFast=true在读到长度字段时就抛TooLongFrameException,failFast=false会先丢弃超长帧的字节,丢完再抛。
adjustment 的正负号是最容易写错的地方。是公式
frameLength = lengthFieldValue + lengthAdjustment + lengthFieldEndOffset,代入自己的帧结构算一遍
关于 failFast 与 maxFrameLength
maxFrameLength
是防御性参数,不是可选项。长度字段是客户端给的,如果不校验,一个
0x7FFFFFFF 的长度就能让服务端分配 2GB 内存。
failFast 决定校验的时机:
failFast=true:读到长度字段就校验,超过上限立刻抛异常,连接可以尽早关闭;failFast=false:也会抛TooLongFrameException,但它会先把整个超长帧读进来、丢弃,再抛异常;不会因为长度超限就提前断开。
大多数场景用 true。协议对接方如果会发送大帧,先确认
maxFrameLength 足够大,再谈 failFast。
编码器 MessageToByteEncoder
解码是字节到对象,编码是对象到字节。Netty 的
MessageToByteEncoder 负责出站方向:
1 | public class ProtocolEncoder extends MessageToByteEncoder<ProtocolMessage> { |
它的模板方法做了几件事:判断消息类型是否匹配、分配 ByteBuf、调用
encode、把编码后的 buffer
写出去、释放原消息。原消息的释放在 finally 里,即使
encode 抛异常也会释放。编码失败时,已经分配的 buffer
也会被释放,异常包装成 EncoderException 抛出。
所以编码器里的 encode 只负责 往 out 里写,不需要自己
release 原消息,也不要自己调用 writeAndFlush。这是和业务
Handler 写法最大的区别。
自定义协议
前面讲的都是单个机制。真实项目里,这些机制要组合成一个协议。来满足项目自定义通信的需求。
帧结构
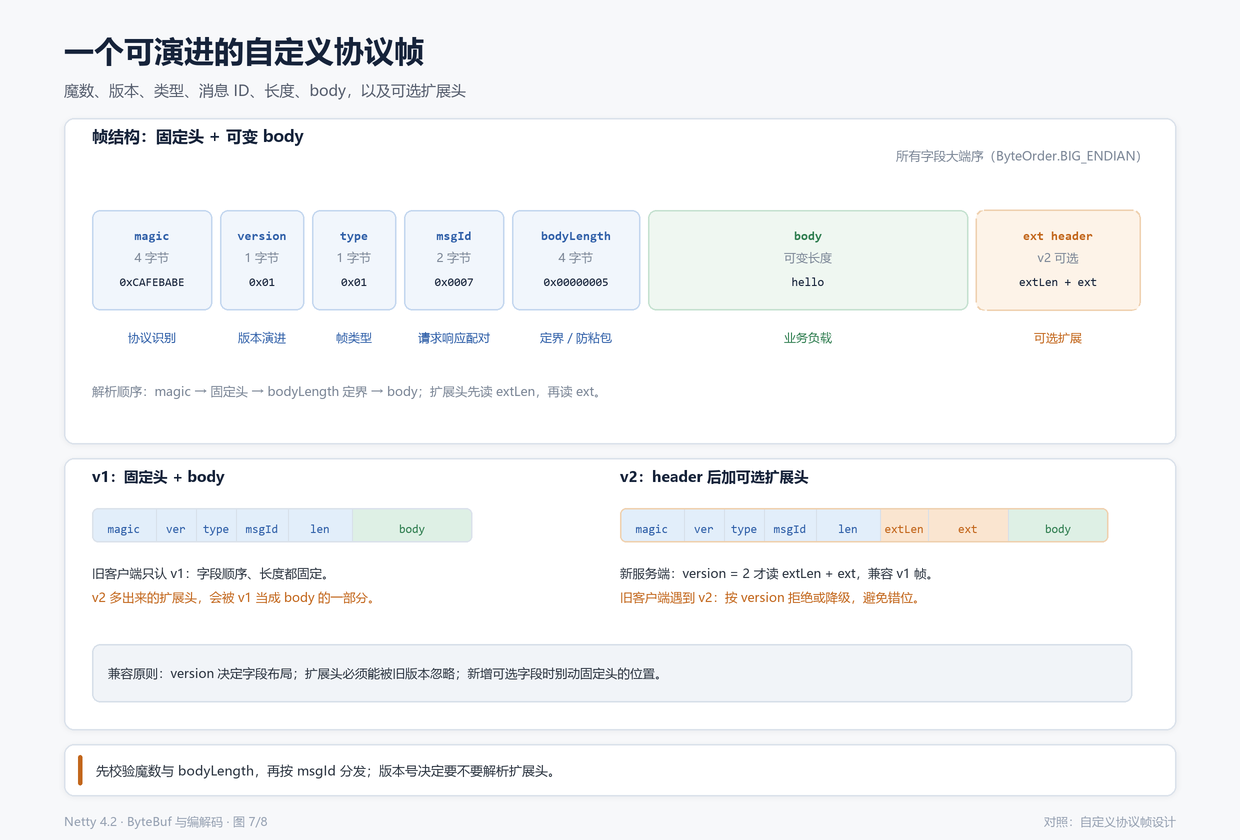
协议帧要回答四个问题:怎么找到帧开头、怎么知道帧多长、这条消息是什么、body 怎么解析。
一个能演进的最小帧结构:
1 | magic(4) | version(1) | type(1) | msgId(2) | bodyLength(4) | body |
| 字段 | 作用 |
|---|---|
magic |
固定魔数,用来识别“这确实是我的协议”,也能在字节错位时快速失败 |
version |
协议版本,为后续字段扩展留余地 |
type |
消息类型,比如请求、响应、事件 |
msgId |
消息 ID,用来路由到具体业务处理 |
bodyLength |
body 的字节长度,解码器据此切帧 |
body |
序列化后的业务数据 |
请求和响应还需要关联。最简单的做法是响应复用请求的
msgId;如果同一个连接上会并发发多个请求,就需要再增加一个请求
ID,响应把它原样带回来,客户端才能把响应和请求对上。推送类消息没有请求,type
标成事件即可,不需要响应字段。
字段顺序和字节序一旦定下来,就不能随便改。ByteBuf
默认使用大端序,也就是网络字节序;如果协议要求小端,必须显式用
writeIntLE 或
order(ByteOrder.LITTLE_ENDIAN),并且两端保持一致。大小端混用是最难排查的一类协议问题:帧能切出来,字段值却是一个完全不相关的数字。
版本与兼容
协议一旦上线,就会有旧客户端。版本字段和扩展头是为了让新老版本能共存:
- 新版本增加字段时,优先追加在 body 后面,并用长度字段界定,不要改变已有字段的位置;
- 旧服务端遇到不认识的
msgId,记录并忽略,不要直接断开连接; - 新服务端遇到旧版本请求,按旧格式解析;遇到更高版本,明确拒绝或降级;
- 扩展头用“标志位 + 长度”描述,旧版本可以跳过不认识的扩展。
扩展头本身也要有边界。常见做法是在固定头里放一个 flags 字节和一个
extLength 字段,v1 客户端把 flags 置 0,v2 服务端读 flags
决定要不要继续读 extLength
和扩展内容。这样旧版本不需要理解扩展内容,也能正确跳过后面的 body。
这些规则不复杂,但要在第一次设计协议时就写进文档。等上线后再改字段顺序,成本会高很多。
消息分发
解码器把字节变成 ProtocolMessage 之后,下一步是按
msgId 分发。
最直接的做法是按 msgId 路由。用 switch 或
Map<Integer, Handler> 都可以,本例用
switch,把“有回包”和“忽略”两种结果分开:
1 | public Optional<String> dispatch(ProtocolMessage msg) { |
新增消息类型时只加一个分支,不用改 Pipeline。未知消息只记录、不抛异常,是协议兼容的基本要求。
处理逻辑里不要做耗时操作。解码和分发都在 EventLoop 线程上,慢查询、同步 RPC 要按上一篇的办法移出去。
序列化选型
body 里放什么格式,是另一个需要提前定的事。
| 方式 | 体积 | 性能 | 可读性 | 跨语言 | 适用 |
|---|---|---|---|---|---|
| JSON | 较大 | 一般 | 好 | 好 | 对外 API、调试友好、字段变化频繁 |
| Protobuf | 小 | 好 | 差,需要 schema | 好 | 内部服务、对带宽和延迟敏感、有明确 schema |
| Java 原生序列化 | 大 | 一般 | 差 | 差 | 不推荐用于跨进程协议 |
JSON
的优点是人和工具都能读,改字段方便;缺点是体积大、解析慢。Protobuf
需要先写
.proto,再用工具生成代码,换来的紧凑编码和解析速度;代价是
schema 管理和工具链。Java
原生序列化带有类名和字段元数据,体积大,还有反序列化安全风险,不适合作为网络协议格式。
Protobuf 官方对 wire format 的描述是 TLV/varint 编码,体积和解析成本都优于文本格式,但需要 IDL 和代码生成,而且不是 canonical 编码(Protobuf Overview、Protobuf Encoding)。网上常见的“比 JSON 小几倍、快几倍”没有统一基准,具体项目的数字要自己压测。
演示工程没有引入 Protobuf 依赖,SerializationCompareDemo
只对比 JSON、Java 序列化和简化二进制编码的体积。实测同一个
LoginRequest:
| 编码方式 | 字节数 | 原因 |
|---|---|---|
| JSON | 48 | 字段名和引号都占字节,但可读 |
| Java 原生序列化 | 169 | 带类描述符和 serialVersionUID,JVM 专用 |
| 简化二进制 | 22 | 只保留字段值,但没有 schema 就不能演进 |
这三个数字来自同一次运行,和 ProtocolDemo
的输出在同一个截图里。Protobuf 通常落在“二进制 22 字节”和“JSON 48
字节”之间,具体大小取决于字段编号和类型,不能用一个固定倍数概括。
选型时可以按场景过一遍:
- 对外 API、需要人排查、字段经常变:JSON 更省沟通成本;
- 内部服务、带宽和延迟敏感、有明确 schema:Protobuf 更合适;
- 只在 JVM 内部临时传输、不落盘不跨语言:Java 原生序列化可以临时用,但不建议进入网络协议;
- 无论选哪种,都要给 body 设长度上限,并在解码前校验,不能把长度字段直接当分配大小。
协议实战
ProtocolDemo 在 9007 上起了一个单进程的 server 和
client,client 依次发送登录、聊天、未知 msgId、带新版本号的消息。server
端打印解码出的字段、分发结果和回包。
1 | // ProtocolCodec 继承 ByteToMessageCodec:入站 decode、出站 encode 都在这一个类里 |
客户端四种请求对应四条发送日志,服务端把解码字段、分发结果和回包都打出来。
运行结果:
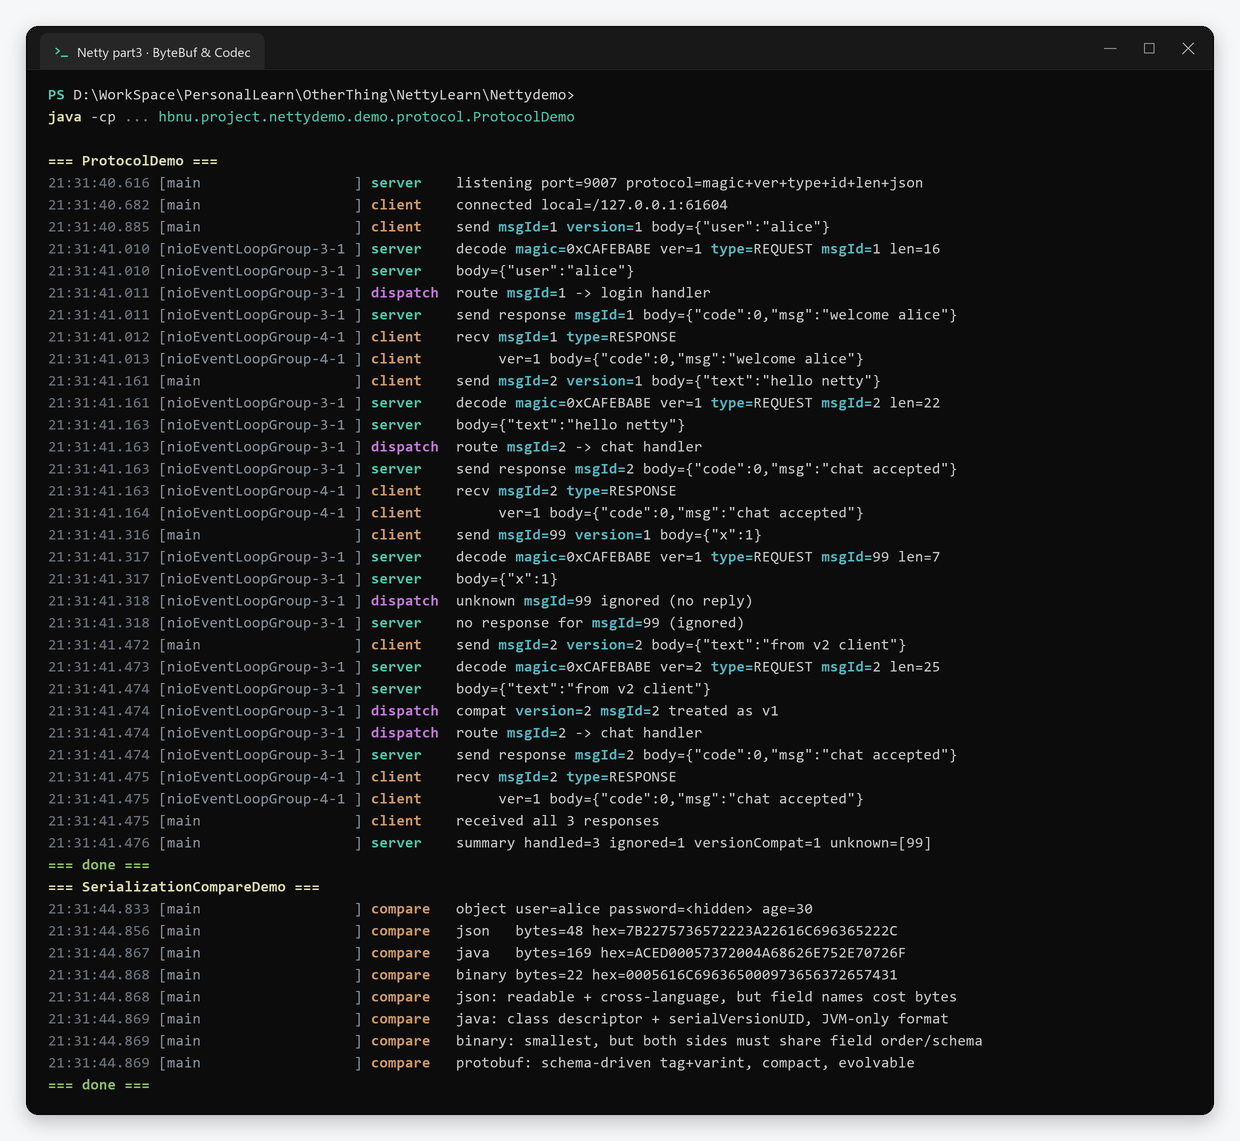
从日志能对上四个场景:
- login 和 chat
正常解码、路由、回包,
magic=0xCAFEBABE、ver=1、type=REQUEST都是从字节里读出来的; msgId=99解码成功,但dispatch打印unknown msgId=99 ignored (no reply),服务端没有回包,连接也没有断;version=2的消息打印compat version=2 msgId=2 treated as v1,然后继续按 chat 处理;- 最后的 summary 是
handled=3 ignored=1 versionCompat=1 unknown=[99],未知消息和版本兼容都被计数,方便灰度期观察。
截图下半部分是 SerializationCompareDemo
的输出,JSON、Java 序列化和简化二进制的字节数就是从这里读的。
编解码器怎么选,怎么放
Netty 提供了几组基类,分别是入站,出站和双向的
| 基类 | 方向 | 用途 |
|---|---|---|
ByteToMessageDecoder |
入站 | 字节流切帧、字节转对象 |
MessageToByteEncoder |
出站 | 对象转字节 |
ByteToMessageCodec |
双向 | 同时处理入站解码和出站编码,适合成对出现的协议 |
MessageToMessageDecoder |
入站 | 消息到消息的转换,不直接碰字节 |
MessageToMessageEncoder |
出站 | 消息到消息的转换 |
MessageToMessageCodec |
双向 | 双向的消息转换 |
ByteToMessageCodec
适合“编码和解码是同一个协议的两面”的场景,比如自定义协议。MessageToMessageCodec
不处理字节,只处理消息对象,适合在 Pipeline
中间做转换,比如把字符串命令转成协议消息,或者把内部消息转成对外的
DTO。
一个 MessageToMessageCodec 的例子,把文本命令行转成
ProtocolMessage:
1 | public final class StringToMessageCodec |
它必须放在 StringDecoder 之后,因为它拿到的已经是
String,不是 ByteBuf。拆包和字节解码仍然由前面的帧解码器负责。两类 codec
的分工可以用一句话记住:ByteToMessageCodec
管字节边界,MessageToMessageCodec
管同层转换,不要把拆包塞进后者。
ByteToMessageCodec 在构造时就调用了
ensureNotSharable(),子类加 @Sharable
会直接失败,因为它内部一定带累积缓冲区。MessageToMessageCodec
没有这层强制检查,如果子类确实无状态,理论上可以共享;但它通常持有转换状态,实际项目里不要把它做成单例
Bean。判断标准仍然是“有没有随连接变化的状态”。
放置顺序沿用上一篇的结论:
- 入站:帧解码器在前,消息解码器在后,业务最后;
- 出站:编码器要在业务 Handler 之前,业务用
ctx.write才会经过它; - 一个编解码器只做一件事,不要把切帧、反序列化、业务路由塞进同一个类。
释放责任也要分清。ByteToMessageDecoder
负责管理累积区;MessageToByteEncoder
负责释放原消息;ByteToMessageCodec
是两者的组合,入站和出站分别遵循上面的规则。业务 Handler 如果继承
SimpleChannelInboundHandler,收到的消息会自动释放;如果继承
ChannelInboundHandlerAdapter,谁消费谁释放。
用 EmbeddedChannel 测编解码
编解码的测试不需要真的开端口。使用EmbeddedChannel
可以把字节直接写进 Pipeline,再把解出来的消息读出来。
三种最值得写的测试:
- 1 字节分片:把一帧拆成很多次
writeInbound,每次 1 字节,最后能读出完整消息; - 粘包:一次
writeInbound写入两个帧,能读出两条消息; - 坏帧:超长帧、非法长度、错误魔数,能抛出预期异常,且不会把 Channel 卡死。
除了这三类,还值得测未知 msgId
和版本兼容。它们不一定会抛异常,但决定了协议演进时旧连接会不会被误断。测试的目标不是覆盖所有分支,而是把“边界条件”和“兼容行为”固定下来。
1 | EmbeddedChannel channel = new EmbeddedChannel( |
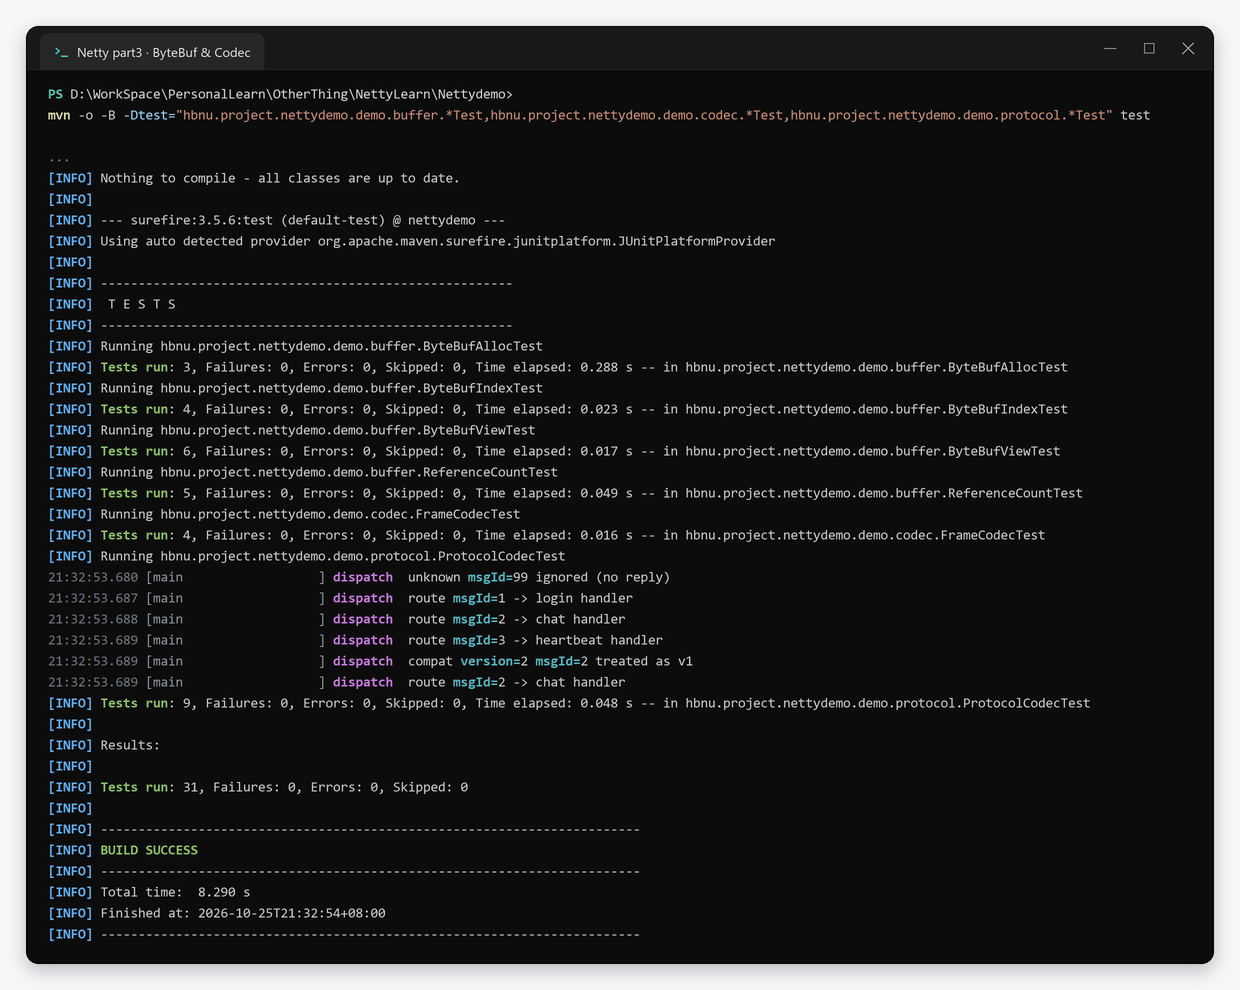
FrameCodecTest 和 ProtocolCodecTest
把这些场景都写成了用例:
1 |
|
测试结果:
串起来所有内容
一条消息的完整旅程
把这一篇的机制串起来,一条消息从 Socket 到业务代码,再写回去,大致经过:
- EventLoop 读到字节,放进 ByteBuf;
- 帧解码器从累积区里切出一个完整帧;
- 消息解码器把帧转成业务对象;
- 业务 Handler 处理,可能调用
ctx.write写回; - 编码器把对象转成 ByteBuf;
- 写回 Socket。
每一步都涉及所有权和边界:ByteBuf 谁分配、谁 release;帧从哪开始、到哪结束;消息对象谁消费。把这三件事想清楚,编解码就不会出大问题。
Netty 4.2 的变化
本文的代码基于 Netty 4.2.17.Final。和 ByteBuf、编解码相关的差异主要有两点:
- 默认分配器变成
AdaptiveByteBufAllocator,4.1 及更早版本默认是PooledByteBufAllocator。看到旧文章里“默认池化”的结论,要结合版本看。 - codec
相关模块进一步拆分,
StringDecoder、StringEncoder、LineBasedFrameDecoder等在netty-codec-base里,netty-all在 4.2 是一个聚合模块。依赖写法变了,类名和用法基本没变。
ByteBuf 的读写指针、引用计数和编解码器 API 在 4.2
里保持稳定,只不过虽然上一篇文章提到的 NioEventLoopGroup
废弃、addLast(EventExecutorGroup, handler)
废弃,但是不影响这一篇的内容。
参考资料
官方源码与文档(Netty 4.2.17.Final / 4.2 javadoc)
- ByteBuf(4.2
API):读写索引、
discardReadBytes、clear、derived buffers 的官方定义。 - ByteToMessageDecoder(4.2
API):frame detection、
@Sharable限制、discardAfterReads=16。 - LengthFieldBasedFrameDecoder(4.2
API):多组参数示例与
failFast语义。 - SimpleChannelInboundHandler(4.2
API):
autoRelease的边界。 - ByteBufAllocator(4.2 API)、AdaptiveByteBufAllocator(4.2 API):分配器接口与 4.2 默认实现。
- ResourceLeakDetector(4.2 API):泄漏检测级别、采样与 API。
- ProtobufDecoder(4.2 API)、ProtobufVarint32FrameDecoder(4.2 API):Protobuf pipeline 与 varint 长度前缀。
- NumberEncoder.java(官方 factorial 示例,tag 4.2.17.Final):魔数 + 长度字段的最小协议。
- TelnetServerInitializer.java(官方
telnet 示例,tag
4.2.17.Final):
DelimiterBasedFrameDecoder+ String 编解码器。 - Netty
User Guide for 4.x:stream-based
transport、
ByteToMessageDecoder、MessageToByteEncoder、入站消息释放。 - Reference counted objects:引用计数规则、derived buffer、泄漏检测级别。
- Netty
4.2 Migration Guide:adaptive
默认、
io.netty.allocator.type=pooled、codec 模块拆分。 - Netty 4.2.0.Final released、Netty 4.2.17.Final released:版本变更与 buffer 泄漏修复。
中文解读与案例
- 聊一聊
Netty 数据搬运工 ByteBuf
体系的设计与实现(博客园,2024-08-14):源码级 ByteBuf
结构、
discardReadBytes、引用计数、视图与 Composite。 - 浅谈
LengthFieldBasedFrameDecoder(腾讯云,2023-08-30):多组参数与
EmbeddedChannel实验。 - Netty 堆外内存泄露排查盛宴(美团技术团队,2018-10-18):生产堆外泄漏排查,异常路径漏 release。
- 漫谈网络粘包、半包问题、解码器与长连接、心跳机制实战(阿里云,2024-08-01):粘包/半包实验与三种方案。
- 基于 Netty 实现自定义协议(华为云,2024-11-19):通用协议头与两级编解码示例。
- Netty 之 ByteBuf 零拷贝(简书):Composite、wrap、slice、FileRegion 四类零拷贝。
- 思考 gRPC:为什么是 protobuf(阿里云,2018-07-19):序列化类型信息、安全性与选型。
英文补充(Protobuf 官方)
- Protocol Buffers Overview:protobuf 的定位与不适用场景。
- Protobuf Encoding:wire format、varint/TLV、2 GiB 上限、非 canonical。
- ProtoJSON Format:JSON 形态比二进制低效、演进保证更弱。