前言
前几篇讲的都是服务端的相关内容,包括怎么启动、怎么处理连接、怎么拆包、怎么设计协议。这一篇就涉及到客户端的相关内容,问题立刻变得不一样。
服务端关心的是 同时接住很多连接,客户端关心的是 这一条连接出现了问题该怎么办。网络抖动、服务端重启、DNS 变化、空闲超时、握手失败,这些在服务端只是某条连接的生命周期结束,在客户端却必须变成可恢复的状态。
本篇按客户端可靠性的顺序往下走:先用 Bootstrap
把连接建立起来,处理同步/异步与超时;再讨论心跳和空闲检测,判断连接是不是还活着;然后设计断线重连,包括退避、抖动、重新鉴权和会话恢复;最后落到两个常见的应用层协议,WebSocket
和 HTTP/HTTPS,以及连接池的基本概念。
读完应该能回答下面这些问题:
| 问题 | 对应小节 | 对应实验 |
|---|---|---|
connect().sync() 和异步 connect()
差在哪,超时怎么设 |
客户端连接 | AsyncConnectDemo |
| 多个异步操作怎么组合,同步 API 为什么只能用于启动/测试 | 客户端连接 | AsyncConnectDemo |
IdleStateHandler 的三个参数分别管什么,和
ReadTimeoutHandler 怎么配合 |
心跳与空闲检测 | HeartbeatDemo |
| 重连为什么要指数退避加抖动,重连后要恢复什么 | 断线重连 | ReconnectDemo |
ChannelGroup 在客户端/服务端分别解决什么问题 |
断线重连 | ReconnectDemo |
| WebSocket 握手阶段怎么鉴权,Ping/Pong 和业务心跳怎么选 | WebSocket | WebSocketDemo |
| HTTP 的 keep-alive 到底复用了什么 | HTTP | HttpDemo |
HTTPS 的 SslHandler 为什么要放在最前面,ALPN
是什么 |
HTTPS 基础 | HttpsDemo |
| 连接池和 HTTP/2 多路复用解决的是不是同一个问题 | 连接池 | 概念说明 |
客户端连接
Bootstrap 客户端
ServerBootstrap 和 Bootstrap 虽然都继承自
AbstractBootstrap,但设计目标完全不同。
服务端需要 接受连接 和 处理连接 两个阶段,所以必须有两个
EventLoopGroup,分别是
boss/worker。而客户端只作为发起方,只负责 建立连接并处理该连接上的
I/O,所以一个 EventLoopGroup 就够了。
所以说,服务端用 ServerBootstrap,客户端用
Bootstrap。两者的配置方式很像,差别在于客户端只需要一个
EventLoopGroup:
1 | // 客户端场景 |
connect() 返回
ChannelFuture,ChannelFuture 继承自 Netty 的
Future<Void>,它同时承载两类信息
- 连接操作的状态:连接失败时,
cause()里是失败原因;连接成功时,channel()是可用的 Channel。 - 关联的 Channel:即使连接失败,
channel()仍然返回一个非 null 的 Channel 对象
客户端的线程模型
一个 Channel 从生到死,所有入站事件都由同一条 EventLoop 线程驱动;出站操作可以从任意线程发起,但真正落地仍然回到那条 EventLoop 线程。
所以说,客户端和服务端用的是同一套 EventLoop / Pipeline
机制,只是角色不同。Bootstrap 的
EventLoopGroup 里通常有 1–2 个 EventLoop,客户端的所有
Channel 共享这几条线程:
connect()可以由 main 线程调用,结果回到 EventLoop 线程;Bootstrap.connect()本身不阻塞。它做的事情是,创建NioSocketChannel,将其注册到选出的 EventLoop,然后向该 EventLoop 提交一个连接任务。真正的SocketChannel.connect()系统调用是在 EventLoop 线程里执行的。- 因此:
- 调用
connect()的线程(通常是 main 线程或业务线程)拿到的是一个ChannelFuture,立即返回。 - 连接的实际发起和完成发生在 EventLoop 线程上。
- 如果连接成功,
channelActive回调也在 EventLoop 线程上触发。
- 调用
channelActive、channelRead、channelInactive在 Channel 绑定的 EventLoop 线程执行;- 多个服务端连接如果落在同一个 EventLoop,一个连接的慢 Handler
会拖住其他连接;
- 一条 EventLoop 线程上的所有 Channel 共享这条线程的时间片。所以说,EventLoop 应该永远不被阻塞,必须保持随时响应事件的能力
- 重连时复用同一个
EventLoopGroup,不要每次重连都新建 group,否则线程会越积越多。
客户端 Handler 同样要遵守 Callback 不阻塞 的规则。鉴权、数据库查询、同步 HTTP 调用都要移出 EventLoop;客户端的心跳和重连状态更新本身很轻,可以直接在 EventLoop 里做,但是在哪里触发呢?
channelActive:连接成功,启动心跳定时器,状态置为“已连接”。channelInactive:连接断开,取消心跳定时器
客户端只有一个 EventLoopGroup,里面每个
NioEventLoop 是一条线程。默认线程数是
CPU 核数 × 2,但客户端场景下这通常没有必要
。如果客户端只连接一个服务端节点,设置 1 条线程完全足够。
connect().sync() 与异步 connect
上面我们知道,connect() 是异步非阻塞的,main
线程调用后立即返回一个 ChannelFuture,真正的连接建立由 NIO
线程完成 。
那么,sync() 内部调用
await(),阻塞调用线程直到 Future
被标记为完成。连接失败时,sync() 会抛出对应的异常。
Netty 在 connect 操作完成时的内部顺序是,先将 Future
标记为成功并通知监听器,然后才触发 Pipeline 的
channelActive。
connect().sync()
是最常见的写法,也是启动脚本、测试代码里最合适的写法:
1 | Channel channel = bootstrap.connect(host, port).sync().channel(); |
它会阻塞当前线程直到连接完成,失败时抛异常。方便,但只能用在非 EventLoop 线程,而且不适合放在业务逻辑里。
业务代码应该用监听器:
1 | ChannelFuture future = bootstrap.connect(host, port); |
两种写法的区别不只是阻塞与否。sync()
返回时连接已经成功,但 channelActive
回调可能还没执行完;监听器则在 Future 完成时被调用,仍然可能在 EventLoop
线程上。不要在监听器里做耗时操作,也不要在监听器里再
sync()。
连接超时与失败原因
CONNECT_TIMEOUT_MILLIS
控制连接超时。连接一个没有服务监听的端口,通常会很快收到
ConnectException: Connection refused;连接一个丢包地址,才会走到超时,得到
ConnectTimeoutException。
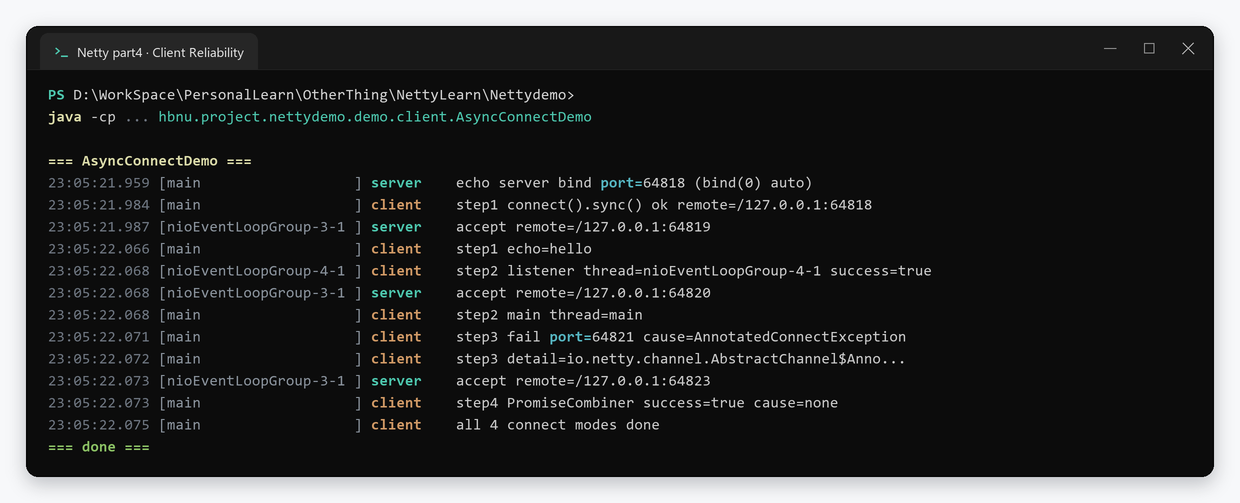
AsyncConnectDemo
把四种情况放在一起:同步成功、异步成功、连接未监听端口失败、PromiseCombiner
组合两个 Future。日志里能看到失败 cause
的类型,以及监听器所在的线程。
connect() 失败之后,Channel 可能已经注册到
EventLoop,但不会进入 active 状态。重连时不要复用这个失败的
Channel,因为这是一个死的 Channel,重新 connect()
生成一个新的。
Future 组合与超时控制
一个连接建立往往不是单个操作:先 connect,再鉴权,再发第一条请求。
如果每一步都用回调嵌套,代码会变成一层套一层的回调地狱,Netty 提供了
PromiseCombiner 把多个 Future 异步操作组合成一个
它的用法很简单,把想等的几个 Future 都加进去,最后给一个总的结果。所有步骤都成功,总结果才算成功;任何一个失败,总结果就失败。
1 | // 把“连接”和“鉴权”这两个异步操作组合在一起 |
PromiseCombiner只负责等全部完成,它不管超时。如果连接卡住了或者鉴权迟迟没响应,它就会一直等下去。所以实际使用时需要自己加一个定时器,超时了主动把总结果标记为失败1
2
3
4
5
6
7
8
9
10
11
12ScheduledFuture<?> timeout = group.next().schedule(() -> {
all.tryFailure(new TimeoutException("connect+auth timeout"));
}, 3, TimeUnit.SECONDS);
all.addListener(f -> {
timeout.cancel(false);
if (f.isSuccess()) {
// 鉴权和连接都完成
} else {
// 任一失败或超时
}
});
更通用的做法是把 Netty Future 转成 CompletableFuture,用
orTimeout 做超时:
1 | // 把 Netty 的 connect Future 转成 CompletableFuture |
- 但最后这个
get只能在启动线程或测试代码里用。如果你把它写在 EventLoop 线程或者 Handler 里,它会阻塞当前线程,导致这个 EventLoop 上其他所有连接都卡住,就是前面讲过的“队头阻塞”。
连接成功之后
connect() 成功只代表 TCP
握手完成,你可以马上发业务数据吗?很明显不行。客户端通常还要做两件事,鉴权和恢复会话。最简单的做法是在
channelActive 里直接发出去
1 |
|
channelActive 在 EventLoop
线程执行,里面不能做耗时操作。
如果鉴权需要调一个同步接口,必须挪到别的线程去。
更常见的做法是把鉴权也当成一条普通消息,在
channelActive
里发出去,然后等服务器回包。收到鉴权成功的回包后,再把连接状态标记为
可用,之后才允许发业务请求。
连接失败时,要记得关闭 Bootstrap 的
EventLoopGroup。客户端通常有一个独立的
group,如果进程不退出,group.shutdownGracefully()
要在关闭流程里调用,否则线程会一直挂着。
客户端连接参数
| 参数 | 作用 | 建议 |
|---|---|---|
CONNECT_TIMEOUT_MILLIS |
TCP 连接超时 | 必设,通常 2–5s |
TCP_NODELAY |
关闭 Nagle | 交互式客户端通常开启 |
SO_KEEPALIVE |
内核保活 | 可以开,但不能替代业务心跳 |
AUTO_READ |
是否自动读 | 需要背压时设 false |
WRITE_BUFFER_WATER_MARK |
写缓冲水位线 | 慢消费场景要关注 |
CONNECT_TIMEOUT_MILLIS 只对连接阶段有效,不包括 DNS
解析、TLS 握手、鉴权。如果目标地址是域名,DNS
解析卡住时,连接超时也救不了;TLS 握手超时要在 SslHandler
上单独设置。这一点在 HTTPS 一节再展开。
心跳与空闲检测
为什么需要应用层心跳
在 Netty 中,客户端和服务端通过 TCP
建立连接后,只要双方没有主动关闭连接,也没有检测到明确的网络异常,连接通常就会保持在
ESTABLISHED 状态。
虽然这很防御,但是 TCP 连接处于
ESTABLISHED,连接一定能够正常通信吗。很明显不行,原因很多。这些情况下,客户端可能并不会立即收到连接关闭通知,Channel.isActive()
也可能暂时仍然返回 true。
这是因为 TCP 是面向连接的协议,但它并不会持续主动验证应用程序是否具备处理消息的能力。因此,对于需要长期保持连接的系统,必须考虑如何及时发现已经不可用的连接。
TCP 本身提供 SO_KEEPALIVE 机制,在 Netty
中可以通过以下方式启用:
1 | bootstrap.option(ChannelOption.SO_KEEPALIVE, true); |
TCP KeepAlive 会在连接满足操作系统规定的空闲条件后,尝试通过 TCP 探测报文判断对端是否仍然能够响应。
但是有两个问题
- 默认检测周期通常较长:例如,Linux 常见默认配置中,TCP KeepAlive 要在连接空闲约 2 小时后才开始探测。对于 RPC、即时通信或者设备长连接服务而言,这样的故障发现时间无法接受。
- 它无法验证应用层的处理能力:TCP KeepAlive 的响应主要由操作系统 TCP 协议栈完成。因此即使服务端业务线程池已经耗尽、应用程序发生死锁,只要操作系统仍然可以正常处理 TCP 探测,连接就可能被认为是存活的。因此,应用层通常需要另外设计心跳机制。
最常见的心跳协议采用请求与应答模式
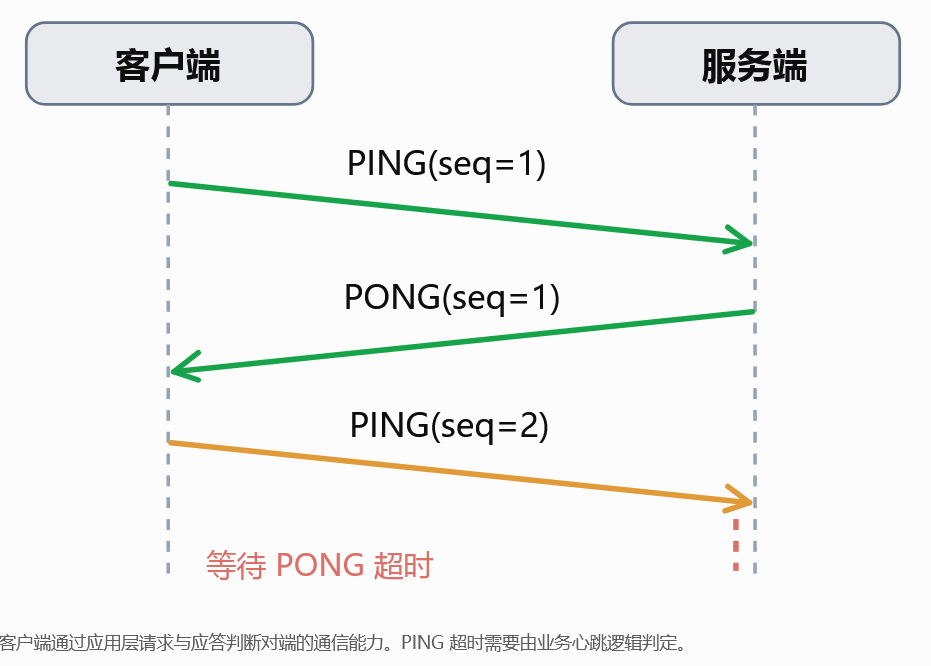
基本流程如下:
- 客户端在指定条件下向服务端发送
PING。 - 服务端收到
PING后,返回对应的PONG。 - 客户端收到有效的
PONG,说明本次心跳成功。 - 如果在规定时间内没有收到对应的
PONG,则记录一次心跳失败。 - 连续失败达到阈值时,客户端主动关闭旧连接,交给重连机制重新建立连接。
其中,PING 通常携带序列号 seq,服务端返回的
PONG 应包含相同的序列号,以便客户端区分不同心跳请求。
关键的是,心跳只能说明,所经过的处理链路在规定时间内能够响应,也就是说,心跳是保活,而不是保可用。因此,心跳检测和应用健康检查属于两个不同层次的机制。
IdleStateHandler 及其原理
Netty 提供 IdleStateHandler,用于监测一个 Channel
在指定时间内是否发生读写活动。它本身不负责发送 PING、验证
PONG,也不会在发生空闲时自动关闭连接。
它的主要职责可以概括为:记录读写活动 → 判断是否超过空闲阈值 → 触发 IdleStateEvent → 由其他 Handler 决定如何处理。
IdleStateHandler 继承
ChannelDuplexHandler,因此能够同时参与入站和出站处理。
IdleStateHandler 的参数是:
1 | // 这三种状态是独立判断的,不是必须按照某个顺序依次触发 |
三个时间参数分别用于检测不同的空闲状态。设置为 0
表示禁用该类型检测。
这三种状态是独立判断的,不是必须按照某个顺序依次触发。任一方向超时,它会触发一个
IdleStateEvent,类型分别是
READER_IDLE、WRITER_IDLE、ALL_IDLE。业务
Handler 会覆写 userEventTriggered 处理
IdleStateEvent
对于这三个类型,假设配置:
new IdleStateHandler(6, 3, 10);,其中,读空闲为 6
秒、写空闲为 3 秒、读写空闲为 10 秒,那么就有
| 类型 | 触发条件 | 典型用途 |
|---|---|---|
READER_IDLE |
连续 6 秒没有入站读取活动 | 检测对端是否长时间没有发送数据 |
WRITER_IDLE |
连续 3 秒没有出站写入活动 | 在发送端空闲时主动发送 PING |
ALL_IDLE |
连续 10 秒没有读取和写入活动 | 检测完全没有通信的连接 |
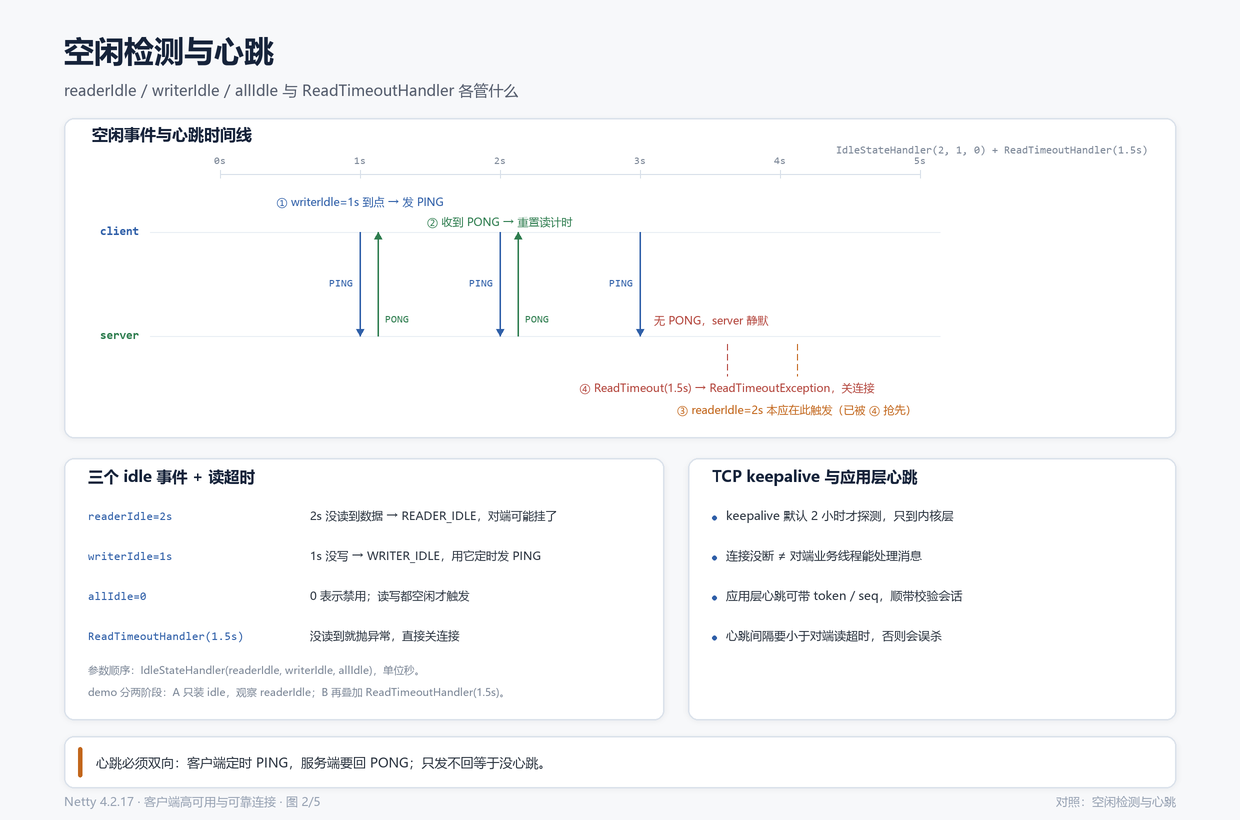
典型配置是客户端 readerIdle=2s, writerIdle=1s:1
秒没写就发 PING,2 秒没读到 PONG 就认为连接有问题。服务端可以配置
readerIdle 更长时间,检测客户端是否消失。
为什么 WRITER_IDLE 不等于固定周期发送 PING?
例如配置:
它表示的是:
如果 Channel 连续 5 秒没有发生写入活动,则触发一次
WRITER_IDLE事件。假设客户端每隔 2 秒主动发送一条业务消息:
2
3
4
5
6
7
2s 发送业务消息
4s 发送业务消息
6s 发送业务消息
8s 发送业务消息
10s 发送业务消息
...由于任意两次写入之间的间隔均小于 5 秒,因此不会触发
WRITER_IDLE。也就是说,即使设置
writerIdle = 5s,也不能保证每隔 5 秒发送一次 PING。这符合设计目的,如果已有正常业务写入,通常没有必要再额外发送用于维持连接活跃的心跳。
但如果业务要求无论是否存在其他流量,都必须周期性验证 PONG,就不能只依赖
WRITER_IDLE,而需要增加独立的周期调度机制。
理解了三种空闲状态之后,可以进一步分析 IdleStateHandler
内部如何实现检测。
它的核心机制可以分为三个部分:
记录最后一次读写活动的时间。
1
2
3
4
5
6
7
8private long lastReadTime;
private long lastWriteTime;
private boolean reading;
private Future<?> readerIdleTimeout;
private Future<?> writerIdleTimeout;
private Future<?> allIdleTimeout;其中:
lastReadTime:最近一次读取活动的时间记录。lastWriteTime:最近一次写入完成的时间记录。reading:当前是否正在处理一个读取批次。- 三个
Future:分别对应三个空闲检测任务。
首先,读取时间并不是简单地在每次
channelRead()中直接刷新。channelRead()会将reading设置为true,随后在channelReadComplete()中更新lastReadTime。其次,写入时间由写操作对应的ChannelFutureListener在写操作完成时更新,通过 EventLoop 执行延迟任务,判断连接是否已经空闲。
IdleStateHandler并不会为每个 Channel 启动一个独立线程。它使用:1
ctx.executor().schedule(task, delay, TimeUnit.NANOSECONDS);
将检测任务注册到当前 Handler 对应的执行器中。这个执行器就是 Channel 所属的
EventLoop。达到空闲阈值后,向 ChannelPipeline 传播
IdleStateEvent当检测任务确定已经超过空闲阈值时,会执行
channelIdle()。它默认将事件IdleStateEvent继续传播,后面的业务 Handler 就可以通过userEventTriggered()接收事件。1
2
3
4
5
6
7
8
9
10
public void userEventTriggered(ChannelHandlerContext ctx, Object evt) {
if (evt instanceof IdleStateEvent event) {
switch (event.state()) {
case WRITER_IDLE -> ctx.writeAndFlush(new PingMessage());
case READER_IDLE -> ctx.close();
default -> { }
}
}
}EventLoop 的定时检测并不是硬实时机制。
如果在
channelRead()、channelRead0()或其他 EventLoop 回调中执行耗时业务,导致 EventLoop 被阻塞,空闲检测任务本身也会延迟执行。所以说,还是那句话,EventLoop 内的任务必须轻量
如何利用 IdleStateHandler 实现基础心跳?
最基本的方案是由客户端主动探测,服务端被动响应。
客户端负责:
- 检测自己是否长时间没有发送消息。检测自己是否长时间没有接收到服务端消息。
- 进入写空闲状态时发送 PING。
- 发生读空闲时关闭连接,触发上层重连流程。
服务端负责:
- 接收客户端发送的 PING。返回对应的 PONG。
- 根据需要,来监控客户端是否长时间没有发送数据。
其中客户端发送 PING 的时机与连接失效的判定是两个独立的逻辑。
假设客户端采用如下配置:
1 | new IdleStateHandler( |
对应的 Handler 可以这样编写:
1 | public class SimpleHeartbeatHandler extends ChannelInboundHandlerAdapter { |
- 首先,
WRITER_IDLE只是负责在发送端空闲时触发 PING READER_IDLE的判断依据是:最近 60 秒内有没有读取任何消息,而不是有没有收到 PONG。
为什么 readerIdleTime 到了不能直接代表 PONG 超时?
假设客户端配置:
很明显,连续 1 秒没有写入,触发
WRITER_IDLE。连续 2 秒没有读取,触发READER_IDLE。现在服务端开始不再回复 PONG。
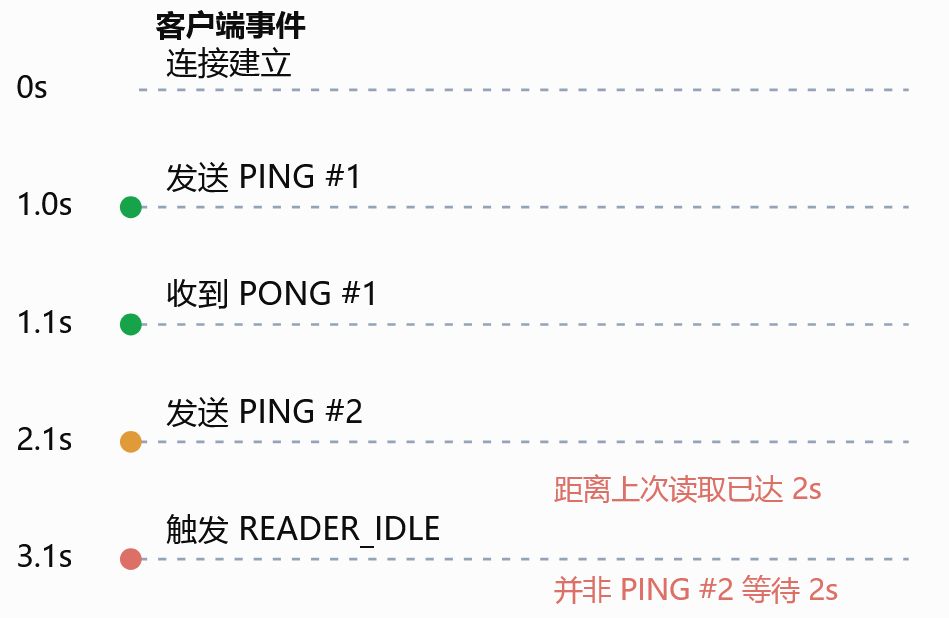
客户端在 1.1 秒收到 PONG 后,读空闲计时被重置。2.1 秒发送第二次 PING,但是这次写入不会重置读空闲计时。2.1 秒发送第二次 PING,3.1 秒收到,但是此时距离最后一次读取已经过去 2 秒。可是此时第二次 PING 只发送了约 1 秒,并没有等待 2 秒。这完全就没有超时。
所以:
readerIdleTime = 2s的准确含义是连续 2 秒没有读取数据,而不是每次发送 PING 后必须在 2 秒内收到 PONG。因此,想要准确识别心跳丢失,就必须维护独立的 PING/PONG 状态。
心跳参数没有统一标准,可以参考这个表:
| 场景 | readerIdle | writerIdle | 说明 |
|---|---|---|---|
| 普通长连接 | 60s | 30s | 30s 没写就发 PING,60s 没读就判定异常 |
| 移动端 | 120s | 60s | 移动网络切换频繁,阈值放宽 |
| RPC | 30s | 15s | 延迟敏感,但要避免误判 |
| WebSocket | 由服务端/中间层定 | 同左 | Ping/Pong 由协议层处理 |
阈值要小于中间设备(Nginx、负载均衡、防火墙)的空闲超时。否则连接会先被中间层断开,客户端还在等自己的心跳超时。
ReadTimeoutHandler 读超时处理器
ReadTimeoutHandler 是读超时处理器
两者最重要的区别是:
IdleStateHandler:检测空闲并触发事件,由业务决定是否关闭连接。ReadTimeoutHandler:检测读超时,默认触发ReadTimeoutException并关闭连接。
例如:
1 | new ReadTimeoutHandler(2, TimeUnit.SECONDS); |
表示:如果 Channel 连续约 2 秒没有发生读取活动,就触发读超时异常,并关闭连接。
从继承关系来看:
1 | ChannelDuplexHandler |
ReadTimeoutHandler 本质上就是基于读空闲机制实现的特化
Handler。
查看 Netty 4.1 的实现,可以发现它的构造方法直接调用父类:
1 | public ReadTimeoutHandler( |
也就是说,它只开启 READER_IDLE
检测,禁用写空闲和读写空闲检测。随后,它覆写
channelIdle():
1 |
|
默认的 readTimedOut() 实现会调用:
1 | ctx.fireExceptionCaught(ReadTimeoutException.INSTANCE); |
因此,ReadTimeoutHandler 并不需要业务 Handler 自己判断
READER_IDLE 再执行
close()。它已经提供了完整的读超时关闭行为。
两者能否一起使用呢?很明显是可以的,三个机制可以协同存在
例如:
1 | pipeline.addLast( |
该配置中:
IdleStateHandler:连续 30 秒没有写入时,触发 PING。ReadTimeoutHandler:连续 90 秒没有收到任何入站消息时,关闭连接。ClientHeartbeatHandler:校验 PONG,并在连续心跳失败后关闭连接。
例如,某个 PING 已经连续失败三次,心跳 Handler
可能先关闭连接;而持续收到业务消息时,ReadTimeoutHandler
则不会触发。
所以说,生产环境下我们通常会将心跳应答超时与连接读空闲超时作为两个独立的策略配置,而且注意保证关闭连接后的清理逻辑具有幂等性,避免重复触发重连。对于普通的请求响应式 RPC,如果连接允许长时间空闲,那么 RPC 请求本身的超时还应该由请求级超时机制管理。
IdleStateHandler 的触发细节
IdleStateHandler
内部为读、写、全部空闲各维护一个定时任务,时间到了就触发对应事件。它判断空闲的依据是上一次读/写的时间,不是当前有没有数据在路上。所以:
- 服务端一直有数据推送,客户端的
readerIdle不会触发;但writerIdle仍可能触发,因为客户端一直没写; allIdle只在读写都停的时候触发,适合完全没动静的检测;- 事件触发后不会自动关闭连接,关闭动作要业务 Handler 自己做。
首先来理解,空闲时间是相对于什么计算的?
例如,客户端添加以下 Handler:
1 | pipeline.addLast( |
这里的三个参数并不是表示:每隔 6 秒检查一下读操作。每隔 3 秒检查一下写操作。每隔 10 秒检查一下所有操作。
更准确地说,它们是三个独立的空闲时间阈值。
假如我们定义
1 | long lastReadTime; // 最近一次读取活动的时间 |
那么可以用三个简化公式理解:
- 读空闲:[ T_{}=now-lastReadTime ];当
T_readIdle >= 6s时,就可能触发READER_IDLE。 - 写空闲:[ T_{}=now-lastWriteTime ];当
T_writeIdle >= 3s时,就可能触发WRITER_IDLE。 - 读写空闲:[ T_{}=now-(lastReadTime,lastWriteTime) ];当
T_allIdle >= 10s时,就可能触发ALL_IDLE。
空闲事件并不是只在第一次进入空闲状态时触发一次。只要空闲状态持续存在,Netty 就可能重复触发相应事件。
上面我们查看了 Netty 4.1 源码,IdleStateHandler
内部有三个关键任务:
1 | private Future<?> readerIdleTimeout; |
在初始化时,会根据配置决定启动哪些任务。
1 | lastReadTime = lastWriteTime = ticksInNanos(); |
然后我们发现
- 首先,这些任务是针对每个 Channel 的 Handler 实例维护的,不是所有连接共用一套读写时间记录
- 其次,它们不是分别创建三个线程。它们通过
ctx.executor().schedule()注册到执行器,通常由 Channel 所属的 EventLoop 调度。 - 因此,一个 EventLoop 可以管理大量 Channel 的空闲检测任务,而不是为每条连接单独创建线程。
而很明显,ReadTimeoutHandler 在内部用
IdleStateHandler(readerIdleTime, 0, 0)
实现,收到读空闲事件时抛
ReadTimeoutException。那这样它就比在业务里自己记时间更可靠,因为它由
EventLoop 的定时任务驱动,不受业务线程池延迟影响。
定时任务触发时,为什么还要重新计算空闲时间?
以
ReaderIdleTimeoutTask为例,核心逻辑可以简化为:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18long nextDelay = readerIdleTimeNanos;
if (!reading) {
nextDelay -= now - lastReadTime;
}
if (nextDelay <= 0) {
// 触发读空闲事件
fireReaderIdleEvent();
// 安排下一轮检测
schedule(readerIdleTimeNanos);
} else {
// 读操作刷新过时间,尚未达到阈值
// 按剩余时间重新调度
schedule(nextDelay);
}假设,
readerIdleTime = 10s,t=0s 时建立连接,安排 t=10s 左右执行读空闲检测,t=7s 收到数据,lastReadTime 更新为 7s,t=10s 定时任务执行,now - lastReadTime = 3s,距离读空闲阈值还差 7s,因此不触发 READER_IDLE,还需要再等 7s。t=17s 时,如果期间没有新的读取,触发 READER_IDLE
那问题就是,为什么不在 t=7s 收到数据时直接取消旧任务,再创建一个 t=17s 的新任务?
因为 Netty 就是在现有任务运行时通过重新计算剩余时间来调整下一次调度,而 Netty 认为没有必要在每次读写事件中反复取消和创建任务。
所以说,整套机制应该这样理解:读写活动更新时间戳,定时任务负责计算剩余空闲时间并触发事件
Ping/Pong 的设计
应用层 PING/PONG 可以自己定义消息类型,也可以直接用 WebSocket 的 Ping/Pong 帧。关键是
- PING 要有唯一序号或时间戳,PONG 原样带回,才能算 RTT 和判断是否丢包;
- 连续 N 个周期没收到 PONG,才判定断线,不要一次超时就重连;
- 心跳消息不要走业务线程池,轻量处理即可;
- 心跳间隔要小于服务端/中间设备的空闲超时,否则连接会被中间层先断开。
而且,完善的心跳协议至少需要维护:
| 状态 | 作用 |
|---|---|
sequence |
为每次 PING 分配唯一序号 |
pendingSequence |
记录当前等待 PONG 的心跳请求 |
sentTime |
记录 PING 发送时间,用于计算 RTT |
pongTimeout |
限制等待 PONG 的最长时间 |
consecutiveFailures |
记录连续心跳失败次数 |
maxFailures |
超过阈值后主动关闭连接 |
- 心跳间隔 是多久尝试发送一次 PING。
- 心跳响应超时是发送一次 PING 后,最多等待多久才认为本次探测失败。
相对明显的一个心跳状态机
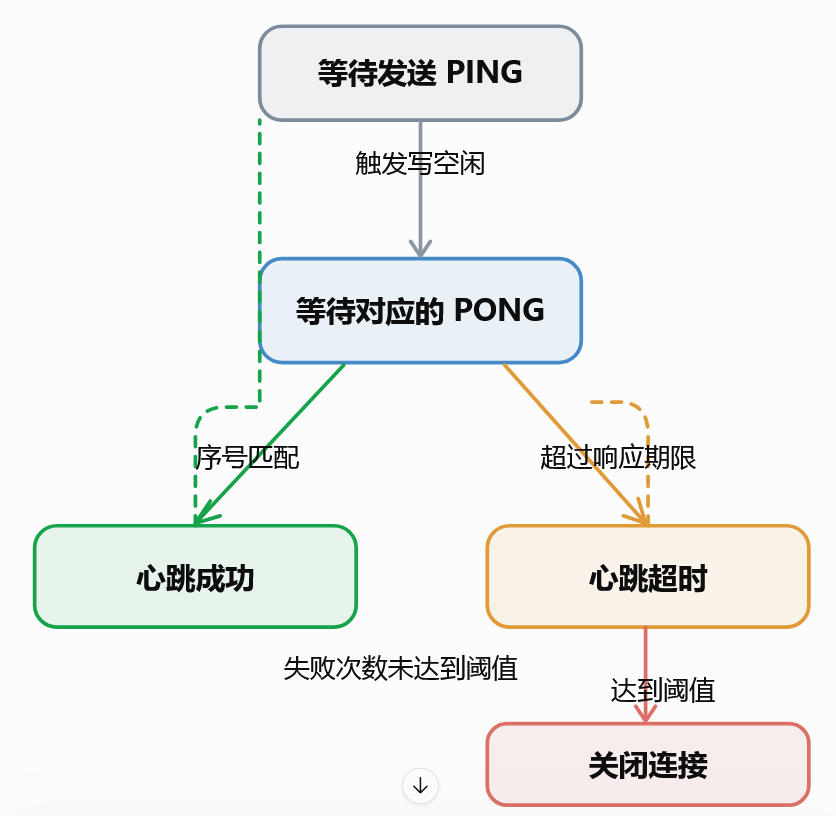
- 触发
WRITER_IDLE时,如果没有等待中的心跳,发送新的 PING。 - 发送成功后,启动对应的 PONG 等待任务。
- 如果收到匹配序号的 PONG,取消等待任务,将连续失败次数清零。
- 如果超时仍未收到对应 PONG,记录一次失败,进行下一轮心跳。
- 连续失败达到阈值时,关闭当前 Channel。
这种方式既避免了 PING 无限积压,也能准确区分网络读写空闲与心跳响应失败。
HeartbeatDemo 用 IdleStateHandler 发
PING,服务端前两次回 PONG,之后静默;客户端的
ReadTimeoutHandler 在等待超时后关闭连接,日志能区分
writerIdle 发 PING、readerIdle 与
ReadTimeoutException。
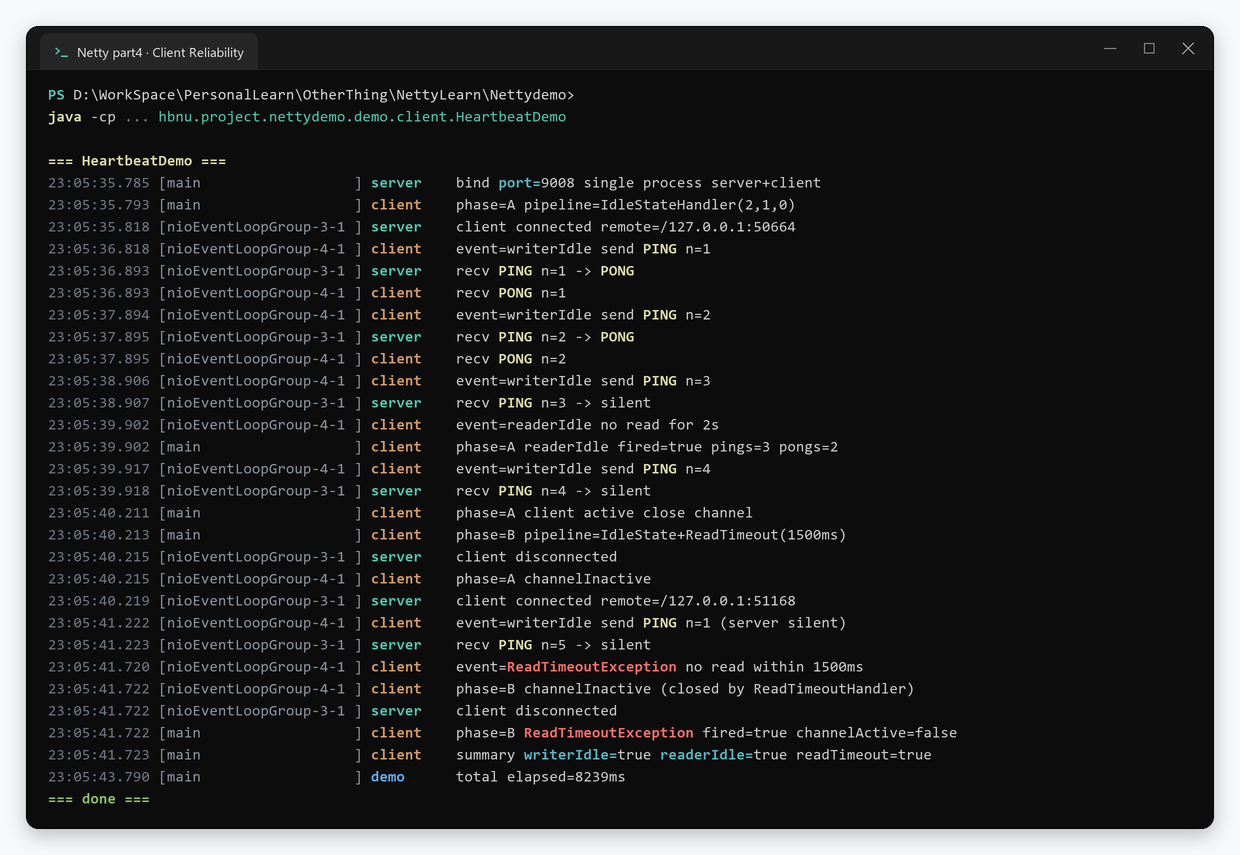
HeartbeatDemo 分两个阶段演示:阶段 A 只挂
IdleStateHandler(2,1,0),观察 writerIdle 发
PING、readerIdle 判定超时;阶段 B 换成
IdleStateHandler + ReadTimeoutHandler(1.5s),观察
ReadTimeoutException。分开的原因是 1.5s 的读超时会先于 2s
的 readerIdle
关闭连接,同一条连接上不可能同时看到这两种事件。真实日志里阶段 A 是
readerIdle fired=true pings=3 pongs=2,阶段 B 是
ReadTimeoutException fired=true channelActive=false。
WebSocket 心跳有什么特殊之处
- WebSocket 与普通自定义 TCP 协议最大的区别在于,WebSocket 标准本身已经定义了 Ping 和 Pong 控制帧。
- Netty 提供
PingWebSocketFrame和PongWebSocketFrame。因此,使用 WebSocket 时通常不需要重新定义 TCP 消息类型来实现基础的 Ping/Pong。 - 因此,使用 WebSocket 时通常不需要重新定义 TCP 消息类型来实现基础的 Ping/Pong
断线重连
连接状态机
在 Netty 中,客户端一般通过 Bootstrap.connect()
与服务端建立 TCP 连接
1 | ChannelFuture future = bootstrap.connect("127.0.0.1", 8080); |
但 TCP 连接并不是永久有效的。在长连接运行过程中,不小心可能就断了,此时如果客户端没有实现重连机制,连接断开后就只能等待业务代码重新发起连接,或者重启客户端进程。因此,长期运行的 Netty 客户端通常需要具备断线重连的能力。
而且,需要注意,断线重连并不是简单地在 channelInactive()
中重新调用一次
connect(),而是一个持续管理连接生命周期的过程。
最简单的连接管理是这样
1 | private boolean connected; |
这种方式的问题是,false
无法说明客户端目前究竟处于什么状态。connected = false
可能表示很多东西,谁知道这次他和上次是不是一个意思,这些状态对应的处理行为不同,不能统一用一个布尔值表示
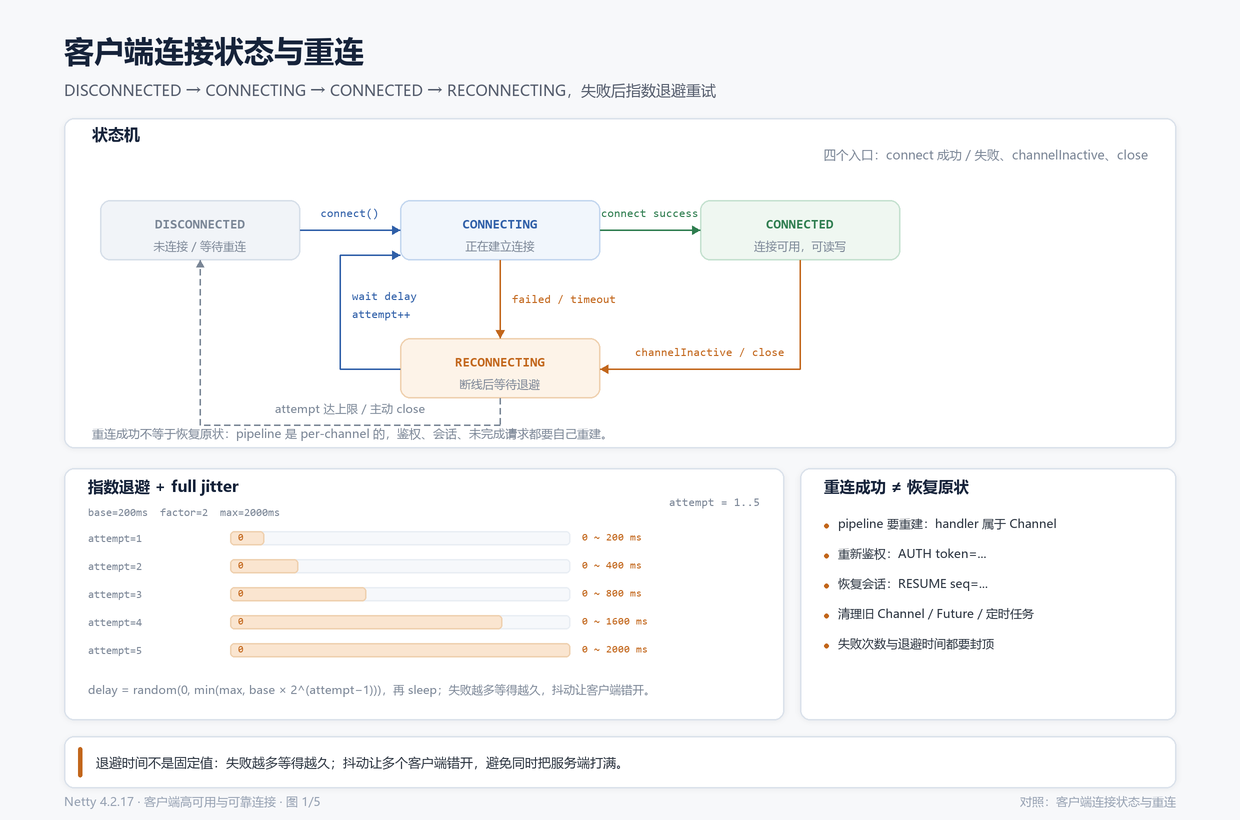
因此,更适合采用有限状态机(Finite State Machine,FSM)管理连接生命周期。所以 Netty 也这样认为,客户端连接不是布尔值,而是一个状态机:
如果没有状态约束,可能创建两条 TCP 连接,最终产生重复会话、重复订阅和资源泄漏。
1 | enum State { |
状态这样流转
1 | DISCONNECTED |
- 在任何允许终止的状态,都可以进入
CLOSED。而且CLOSED是客户端连接管理器的终止状态,不是 NettyChannel自身的状态。Channel关闭以后,可以创建新的Channel;但如果连接管理器进入终止状态,就不应该继续自动创建连接。
每个状态的含义如下。
| 状态 | 含义 | 是否允许发起新的连接 |
|---|---|---|
DISCONNECTED |
尚未建立连接,也没有正在执行的连接操作 | 可以 |
CONNECTING |
已调用 connect(),正在等待连接结果 |
不可以 |
CONNECTED |
TCP 连接已经建立 | 不可以 |
RECONNECTING |
连接失败,已经安排下一次重连 | 不可以重复安排 |
CLOSED |
客户端已终止连接管理,不再自动重连 | 不可以 |
对于生产环境的客户端,仅有 CONNECTED
通常还不够。例如,一个 RPC 客户端可能需要
1 | TCP 连接建立 |
所以一般情况下,区分 TCP 连接成功和业务连接就绪是很常见的,但是 N etty 不会替你做这件事,所以说,Netty 管理底层连接状态,我们自定义状态机管理业务连接状态
因此,更完整的状态机可以设计为
其中新增的两个状态:
RECOVERING:TCP 已连接,正在完成鉴权、会话恢复和订阅恢复。READY:连接和业务状态都已恢复,可以正常处理业务请求。
这样可以避免在 TCP 握手刚完成时,业务线程就向尚未鉴权的 Channel 发送请求。
那么,为什么状态机可以避免重复重连?很简单,因为重连事件可能来自多个位置,Netty
客户端可能通过不同事件发现连接异常。而如果同一次故障同时触发异常处理和关闭处理,就可能重复调用
reconnect()。结果可能是创建多条连接。所以更好的设计是,各个
Handler 负责发现故障、关闭连接;统一的 ReconnectManager 负责重连决策
而且,状态检查还需要考虑线程安全,如果两个线程同时执行重连,依然会产生两个重试任务,在 Netty 中,把同一个连接管理器的所有可变状态操作,都交给一个指定的 EventLoop 执行。
1 | private final EventLoop controlLoop; |
这样可以避免在多个线程中同时修改状态。
指数退避与抖动
固定间隔重连在服务端宕机时会造成重连风暴,这和我们 Redis 防御缓存雪崩是一个道理。
服务端发生故障后,所有客户端在几乎相同的时间断开连接。如果客户端全部采用当时重连,那这样服务端本来就处于故障状态,却还需要不断处理大量 TCP 连接请求,死了。这种大规模客户端同时重试所引起的负载冲击,通常称为重连风暴
常见做法是指数退避:重试次数越多,下一次重试之前等待的时间越长
1 | delay = min(maxDelay, base * factor^attempt) |
- 可见,退避延迟并不会无限增长,而是在达到
maxDelay后保持上限。
单纯的指数退避虽然降低了重试频率,但并没有完全解决大量客户端同时重试的问题。所以说,再加上抖动,避免大量客户端在同一时刻重连:
1 | delay = random(0, delay) // full jitter |
BackoffPolicy 就是这段逻辑的纯实现
1 | public final class BackoffPolicy { |
而且,服务端集群通常有多个地址。客户端不要在重连时随机挑一个就完事,常见策略是:
- 顺序轮询或随机打散,避免所有客户端压同一个节点;
- 将地址顺序随机打散,这样不同客户端可以优先选择不同节点
- 对于更复杂的场景,可以为每个地址维护健康状态,基于健康状态选择节点
- 如果服务端前面存在负载均衡,最好直接服用负载均衡的策略,客户端通常只需要连接负载均衡入口。
如果服务端前面有负载均衡,客户端通常只连一个 VIP,重连风暴的问题会转移到负载均衡层;如果客户端直连多个节点,重连日志里最好把目标地址也打出来,排查时才能知道是哪个节点不可用。
重连的实现
Bootstrap.connect() 是异步的,我们都知道,调用
connect() 后,方法通常会迅速返回一个
ChannelFuture。我们需要监听这个 Future
1 | bootstrap.connect(address) |
一个可用的重连器通常需要维护这些字段
1 | private State state; // 连接状态 |
示例:
1 | public void scheduleReconnect(Throwable cause) { |
状态检查是防重连风暴的,channelInactive、connect
失败、心跳超时,等等问题可能同时触发重连,状态机保证只有一个在跑。重连成功后不要忘记重置
retryCount,否则下一次断线会从很大的 attempt
开始,延迟直接爆炸。
为什么要引入 generation?
假设客户端短时间内经历两次连接
2
3
4
5
6
7
8
9
↓
连接 A 断开
↓
连接 B 创建
↓
连接 B 正常工作
↓
连接 A 的旧异步回调延迟执行如果旧回调没有检查自己属于哪一代连接,就可能错误地关闭连接 B,或者重新安排一次不必要的重连。
因此,可以给每次连接尝试分配一个递增的代次:
在异步回调中比较
2
3
4
// 旧连接的过期回调
return;
}这样可以阻止旧连接的异步结果修改新连接的状态。
重连后重新鉴权与会话恢复
TCP 连接重建后,之前的所有会话状态都没了,我们重试不是只要建立连接,而是需要恢复完整的业务能力。所以说,重连成功只是第一步,后面通常还要:
- 重新鉴权:带 token 或证书重新登录;
- 恢复会话:带上最后一次收到的消息序号,让服务端补发断线期间的消息;
- 恢复订阅:重新订阅频道、房间、主题;
- 重置心跳:新的
IdleStateHandler计时从零开始。
这些步骤要放在“连接成功”之后的同一条异步链里,不能在
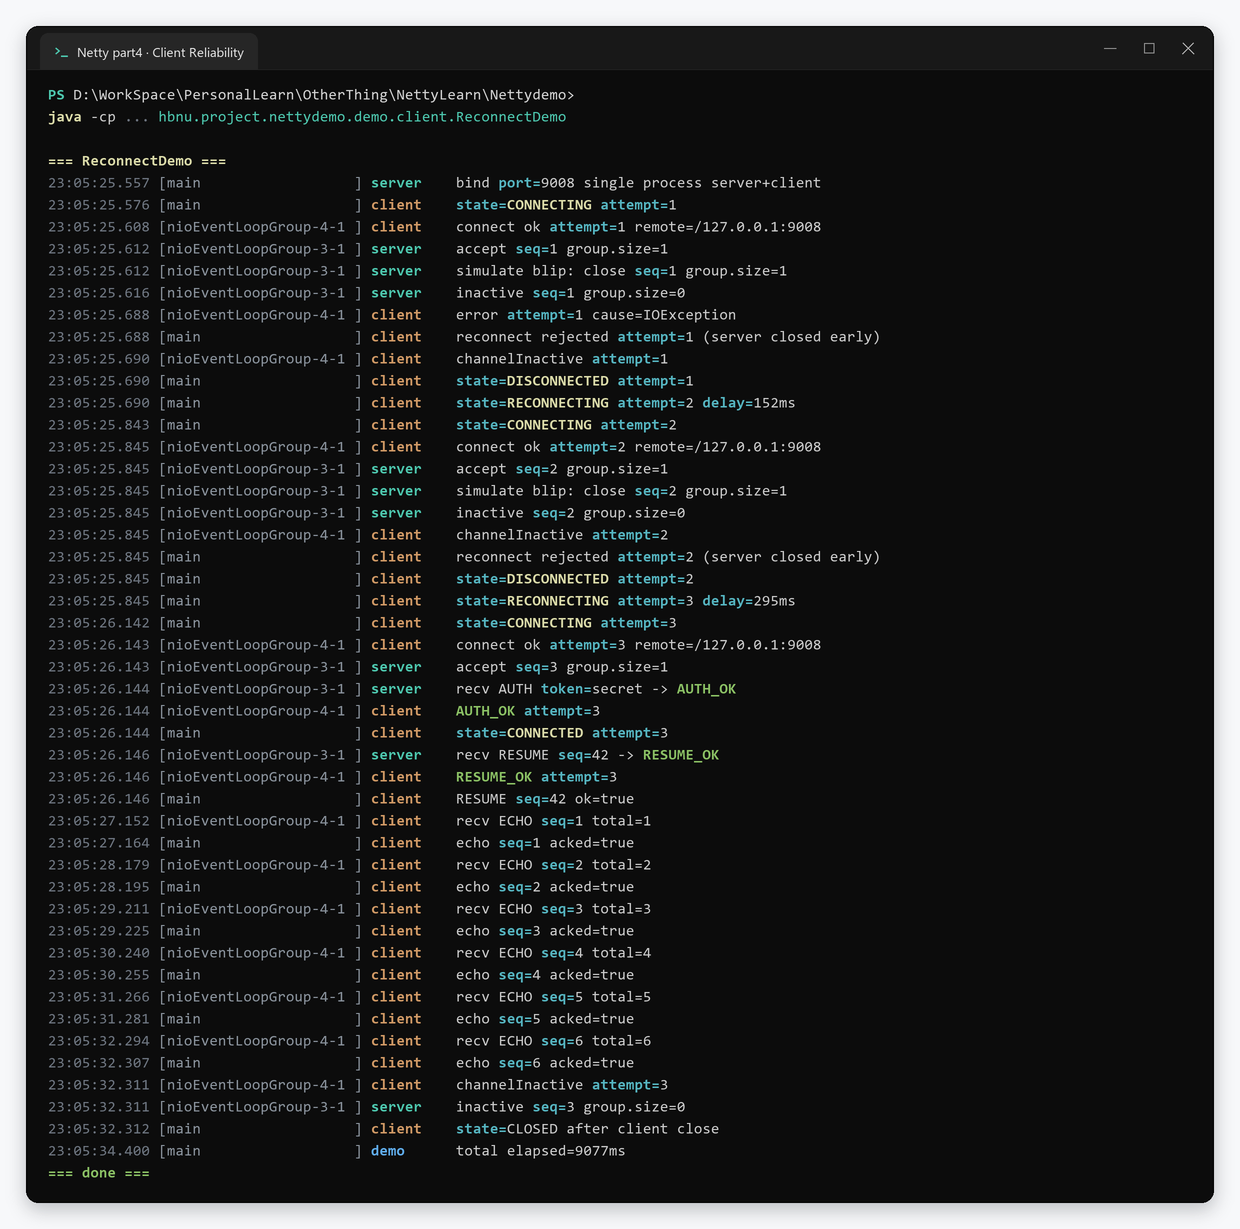
channelActive 里同步阻塞。ReconnectDemo
的日志里会打印 AUTH token=... 和
RESUME seq=...,表示重连后的恢复动作。
ChannelGroup 管理在线连接
ChannelGroup 是一个特殊的
Set<Channel>,是专门用于管理多个 Channel
的集合接口,可以批量操作一组连接:
1 | ChannelGroup clients = new DefaultChannelGroup(GlobalEventExecutor.INSTANCE); |
服务端常用它维护在线连接、广播消息、批量关闭。客户端如果同时连多个服务端,也可以用它管理连接。ChannelGroup
会自动移除已关闭的 Channel,不需要手写清理逻辑。
与普通 HashSet<Channel> 不同,ChannelGroup
额外提供了:
- 线程安全的成员管理。
- 自动移除已关闭的 Channel 的功能
- 批量发送消息、关闭连接。
- 批量操作的异步结果通知。
那么,服务广播,服务端希望向所有在线客户端发送一条通知
1 | ChannelGroupFuture future = clients.writeAndFlush(message); |
- 广播是异步执行的
- ChannelGroupFuture 可以汇总各个 Channel 的写入结果
- Netty 会对 ByteBuf、ByteBufHolder 类型的广播消息执行适当的复制或引用计数处理。
ChannelGroup 和重连配合时有一个问题:
- 重连成功后的新 Channel 要
add进 group,旧的已关闭 Channel 会被自动移除;如果业务用 group 做广播,不要在重连过程中把旧 Channel 留在 group 里,否则广播会失败或阻塞。 - 因为,ChannelGroup 不会因为旧 Channel 关闭而自动创建新 Channel,它不是连接池。它只负责管理被加入的 Channel。因此,重连管理器仍然需要在正确的时机将新 Channel 加入 ChannelGroup。
WebSocket
握手:HTTP Upgrade 与鉴权
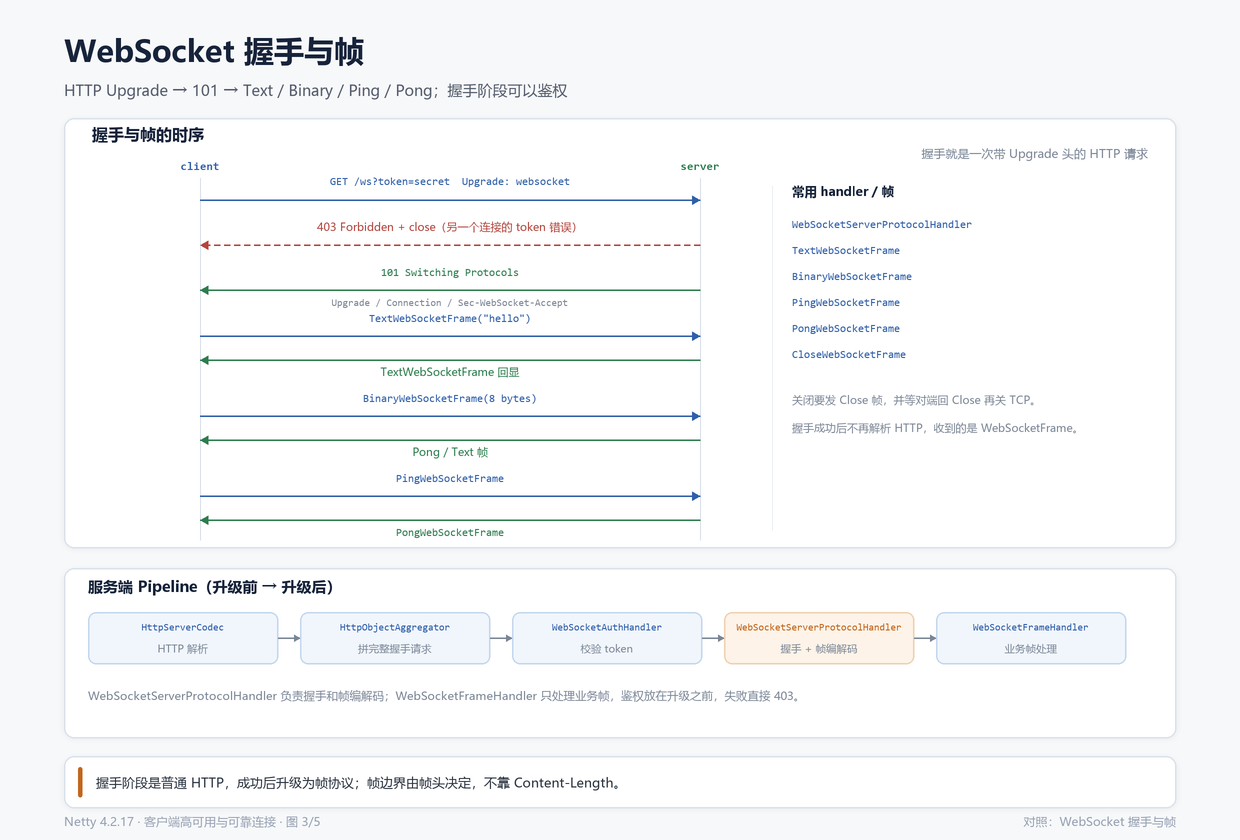
WebSocket 的握手是一个 HTTP 请求:客户端发 GET /ws,带
Upgrade: websocket、Sec-WebSocket-Key
等头;服务端返回 101 Switching Protocols,之后这条 TCP
连接就变成 WebSocket 连接。
一次握手请求的报文大致是:
1 | GET /ws?token=secret |
服务端返回:
1 | 101 Switching Protocols |
Sec-WebSocket-Key
是协议要求的随机值,服务端用固定算法算出
Sec-WebSocket-Accept,它不是鉴权凭证。真正的鉴权要业务自己做,比如
URL 里的 token、Cookie 或自定义 Header。
Netty 的 WebSocketServerProtocolHandler
负责握手和协议升级。握手之前可以插一个 HTTP Handler 做鉴权:
1 | pipeline.addLast(new HttpServerCodec()); |
鉴权放在握手阶段比“连接建立后再发登录消息”更安全:没通过鉴权的连接根本不会升级成
WebSocket。WebSocketAuthHandler 检查 URI 的
token,不通过就写一个 403 响应并关闭连接。
一个最小的握手鉴权 Handler:
1 | public class WebSocketAuthHandler extends SimpleChannelInboundHandler<FullHttpRequest> { |
注意 SimpleChannelInboundHandler 会自动释放
FullHttpRequest,继续往后面传时要
retain(),否则后面的握手 Handler
会拿到一个已经释放的对象。
关闭握手时,WebSocket 关闭需要双方交换
CloseWebSocketFrame,不是直接
ctx.close()。直接 close
会让对端看到连接异常中断,无法区分正常关闭和网络故障。WebSocketServerProtocolHandler
会处理标准关闭握手;业务自定义关闭时,发一个
CloseWebSocketFrame(status, reason),然后等待对端回应再关。
帧类型与心跳
WebSocket 的帧类型包括:
| 帧 | 用途 |
|---|---|
TextWebSocketFrame |
UTF-8 文本 |
BinaryWebSocketFrame |
二进制数据 |
PingWebSocketFrame /
PongWebSocketFrame |
协议层心跳 |
CloseWebSocketFrame |
关闭握手 |
WebSocketServerProtocolHandler 会自动处理 Ping/Pong 和
Close。业务需要自己处理 Text/Binary 帧。如果业务有自己的 PING/PONG
消息,也可以定义 Text 帧;但协议层 Ping/Pong
更轻量,适合做连接保活,业务心跳适合做“服务是否可处理请求”的判断。
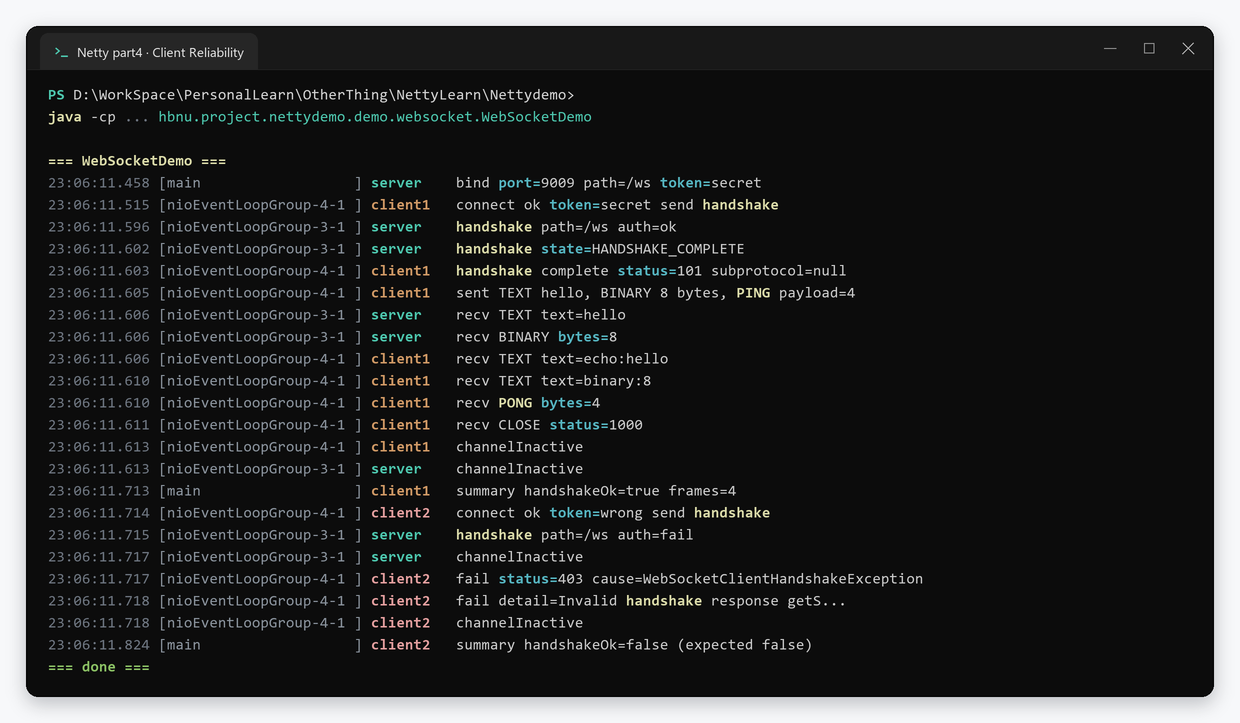
WebSocketDemo 的 client 用
WebSocketClientHandshaker 握手,依次发
Text、Binary、Ping,server 回 Text/Pong;第二个 client 用错误 token
握手,server 返回 403。
客户端握手的代码大致是:
1 | WebSocketClientHandshaker handshaker = WebSocketClientHandshakerFactory.newHandshaker( |
4.2 的 WebSocketClientProtocolHandler
构造签名和握手回调与旧版不同,直接持有
WebSocketClientHandshaker
更直观:channelActive 里调用
handshaker.handshake(channel) 发出升级请求;收到
FullHttpResponse 后调用
finishHandshake(channel, response)。握手失败(比如 403)时
finishHandshake
抛异常,业务能拿到明确的失败原因。握手成功后再开始发帧,不要一连接就发
WebSocketFrame,否则帧会被当成 HTTP 数据。
与 Spring WebSocket 的差异
Spring 的 WebSocket 建立在 Servlet 容器或 WebFlux 之上,开发者实现
WebSocketHandler,由容器负责握手、帧解析和线程调度。Netty
更底层:握手、帧编解码、Pipeline
都要自己装配,但线程模型和协议细节完全可控。
选择上:
- 已经在 Spring MVC/WebFlux 里、只需要业务级 WebSocket:Spring 的封装更省事;
- 需要自定义握手、二进制协议、精细的线程/背压控制:Netty 更合适;
- 两者都可以用
WebSocketServerProtocolHandler那套帧模型,但 Spring 不暴露 Pipeline。
HTTP
HttpServerCodec 与 HttpObjectAggregator
HTTP 的 Pipeline 通常只有三个关键 Handler:
1 | pipeline.addLast(new HttpServerCodec()); // 请求行/头/体的解析与编码 |
HttpServerCodec 是 HttpRequestDecoder 和
HttpResponseEncoder
的组合。HttpObjectAggregator 把 HttpRequest +
HttpContent 拼成
FullHttpRequest,业务只处理一个完整对象,不用自己处理
chunked。
HttpObjectAggregator
的构造参数是最大内容长度。请求体超过这个值时,它会返回
413,而不是把内存撑爆;它还会处理 Expect: 100-continue
和部分非法请求。生产环境不要把上限设得太大,大文件上传应该走流式处理,而不是聚合。
FullHttpRequest 是引用计数对象,业务处理完要释放;如果用
SimpleChannelInboundHandler<FullHttpRequest>,它会自动释放,不要重复
release。
路由、静态资源与 FullHttpResponse
业务 Handler 收到 FullHttpRequest 后,按 URI 路由:
1 | if ("/hello".equals(uri)) { |
要点:
- 必须设置
Content-Length,否则客户端不知道响应体多长; FullHttpResponse的 content 是一个 ByteBuf,写完由 Netty 释放;- 404 也要返回完整响应,不要直接 close;
- 静态资源从 classpath 读取,设置正确的
Content-Type。
keep-alive
HTTP/1.1 默认 keep-alive:一个 TCP
连接可以连续发多个请求/响应。HttpServerCodec 和
HttpObjectAggregator 都支持这种复用;业务只需要正确设置
Content-Length 或
Transfer-Encoding: chunked。
HttpDemo 的 client 在同一个 Channel 上连续发
/hello、/、/missing
三个请求,日志里能看到三个响应复用同一条连接;server 端打印每个请求的
URI 和 keep-alive 状态。
响应头与连接关闭
HTTP/1.1 的 keep-alive 依赖两个头:
Content-Length:告诉对端响应体有多长,连接才能在不关闭的情况下知道响应结束;Connection: close:明确告诉对端这次响应后关闭连接。
如果服务端返回
Content-Length,客户端会按长度读完当前响应,然后继续在同一连接上读下一个响应;如果返回
Transfer-Encoding: chunked,客户端按 chunk 边界读到 0
长度块结束。两种方式都不能省略,否则连接复用会错位。
FullHttpResponse
适合响应体不大、能一次性放进内存的场景。大文件、流式响应不要用
FullHttpResponse,改用 HttpResponse +
HttpContent 分块写,并正确设置
Transfer-Encoding。
HTTP 客户端的请求关联
一个连接上连续发多个请求时,响应不一定按请求顺序回来(HTTP/1.1 有
pipelining,但 Netty 的 HttpClientCodec
默认不开启)。如果业务并发发请求,要靠请求 ID
或响应顺序来关联。HttpDemo
是串行发请求,顺序最简单;真实客户端通常每个请求带唯一
ID,或者一个连接同时只处理一个请求。


HTTPS 基础
SslContext 与 SslHandler
HTTPS 在 TCP 和 HTTP 之间加了一层 TLS。Netty 用
SslContext 表示证书和密钥配置,用 SslHandler
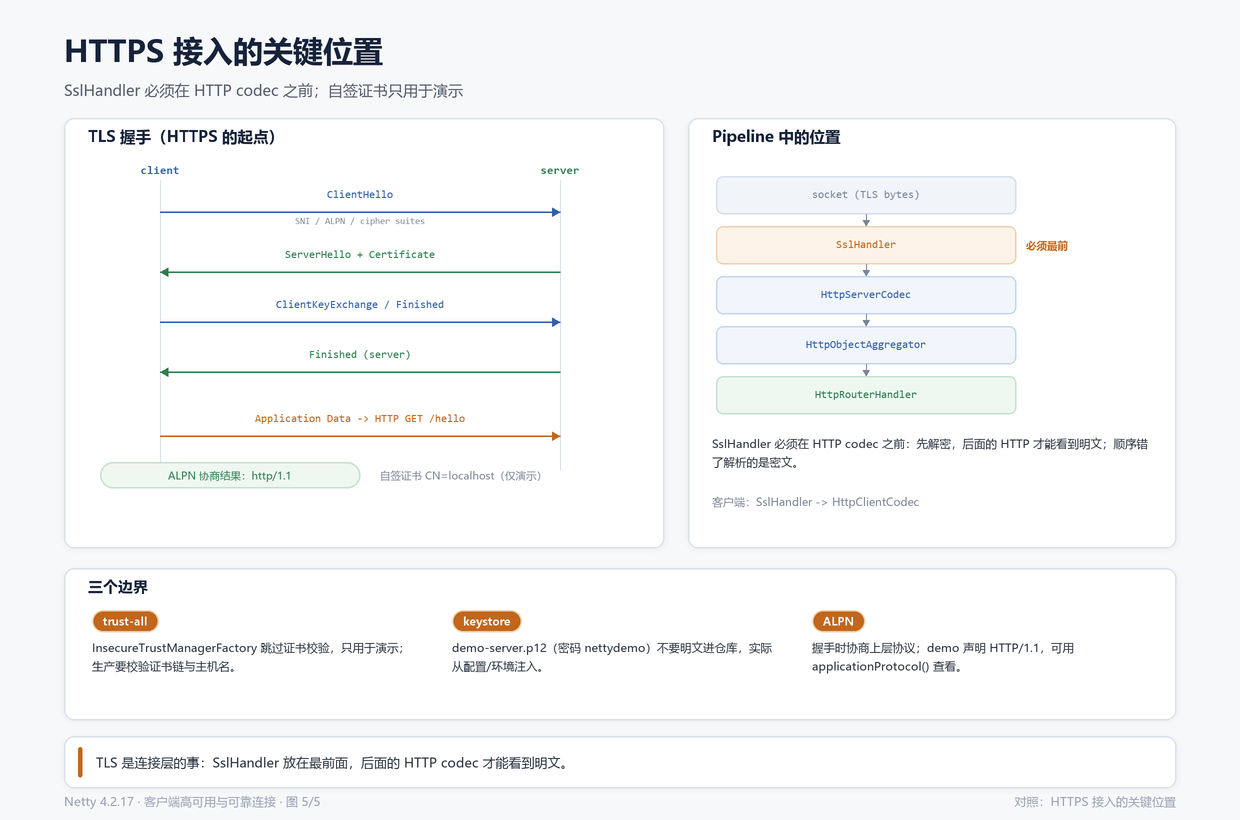
处理握手和加解密。SslHandler 必须放在 Pipeline
最前面,因为它在字节进入 HTTP 解码器之前就要完成解密,在 HTTP
响应写出之后才加密:
1 | KeyStore keyStore = KeyStore.getInstance("PKCS12"); |
这里有一个 4.2 的 API 细节:SslContextBuilder.forServer
没有直接接收 PKCS12 文件 + 密码的重载(PEM 的 File/InputStream
版本才有),所以要先自己加载 KeyStore,再通过
KeyManagerFactory 交给 forServer。这是实际写
HTTPS demo 时踩到的差异,旧文章的写法在 4.2 上不一定能编译。
还有一个依赖细节:4.2 的 SslHandler.handlerAdded 里有
channel instanceof UnixChannel 的判断,如果 classpath
里只有 netty-all、缺少
netty-transport-native-unix-common,这里会抛
NoClassDefFoundError。本地演示时把
netty-transport-native-unix-common 补进运行时 classpath
即可;Maven 项目里显式加这个依赖更稳妥。
客户端:
1 | SslContext clientSsl = SslContextBuilder.forClient() |
trust-all 只适合演示。生产环境要配置真实 CA
或明确的信任库。
自签证书与 keytool
演示用的 keystore 由 keytool 生成:
1 | keytool -genkeypair -alias nettydemo -keyalg RSA -keysize 2048 ` |
SAN
必须包含客户端访问的地址,否则主机名校验会失败。自签证书只用于本地演示,不能直接上生产。
ALPN
ALPN 是 TLS
的扩展,用来在握手阶段协商应用层协议(HTTP/1.1、HTTP/2)。JDK 9+ 支持
ALPN,Netty 通过 ApplicationProtocolConfig
配置。SslHandler 握手完成后可以用
applicationProtocol() 读取协商结果。
只做 HTTPS 时 ALPN 可以省略;如果要上 HTTP/2,ALPN 是必需的,因为 HTTP/2 和 HTTP/1.1 共用同一个端口,必须先协商协议。
TLS 握手流程
HTTPS 建立连接比 HTTP 多几步:
- TCP 连接建立;
- 客户端发 ClientHello,带支持的 TLS 版本、加密套件、ALPN 协议列表;
- 服务端回 ServerHello、Certificate,选定 TLS 版本和套件;
- 客户端校验证书,生成会话密钥;
- 双方交换 Finished,握手完成;
- 之后 HTTP 数据都在 TLS 记录层里加密传输。
在 Netty 里,第 2–5 步由 SslHandler
完成。SslHandler 的 handshakeFuture()
完成才代表 TLS 可用,channelActive 不代表 TLS
已经握手成功。业务如果要在连接建立后立刻发 HTTP 请求,应该等
handshakeFuture(),而不是等
channelActive:
1 | SslHandler sslHandler = sslContext.newHandler(ch.alloc(), host, port); |
常见的 HTTPS 接入错误:
| 现象 | 原因 |
|---|---|
SSLHandshakeException: no cipher suites in common |
两端 TLS 版本/套件不匹配 |
PKIX path building failed |
客户端不信任自签证书 |
No subject alternative names present |
证书 SAN 不包含访问地址 |
| 握手一直不完成 | 网络/代理阻断了 TLS,或 SslHandler 放错位置 |
HttpsDemo 用自签证书 + trust-all 演示,日志里会打印 TLS
协议、加密套件和 applicationProtocol()。这次实测 TLS 版本是
TLSv1.3、套件是 TLS_AES_128_GCM_SHA256,但
applicationProtocol=null,也就是 ALPN 没有协商出协议。只跑
HTTPS 时这不是问题,因为 HTTP/1.1 是默认协议;如果要上 HTTP/2,必须确认
ALPN 协商出 h2,否则会退回 HTTP/1.1。
生产环境要把 trust-all 换成明确的信任库,并且校验主机名和证书链。

连接池
Netty 本身不提供开箱即用的 HTTP 连接池
连接池解决的问题是复用已经建立的连接,避免每次请求都 TCP 握手、TLS 握手。HTTP/1.1 的连接池通常是 每个请求独占一个连接,用完归还;HTTP/2 则支持在一条连接上多路复用多个请求,每个请求有独立的 stream id。
Netty 本身不提供开箱即用的 HTTP 连接池,需要自己维护可用 Channel 队列、请求与响应的关联、超时和健康检查。常见做法是:
- 维护一组
Channel,请求时借出,响应完成后归还; - 用请求 ID 关联 response,避免响应串线;
- 对空闲连接做心跳或定期探活;
- 设置最大连接数、最大等待时间、连接最大生命周期。
借出和归还的简化逻辑:
1 | Channel borrow() throws InterruptedException { |
这段伪代码省略了请求关联、健康检查和最大连接数控制,但能看出连接池的核心:池子里放的是“可复用的、还活着的连接”,不是简单的
ChannelGroup。
连接池不是越大约好。连接数过多会占用文件描述符和服务端资源;连接复用又会带来“一个慢请求占住连接”的问题。HTTP/2 的多路复用缓解了后者,但也引入了 stream 级别的流控和头部阻塞问题。
连接池与 ChannelGroup 的区别
ChannelGroup |
连接池 | |
|---|---|---|
| 管理对象 | 已建立的连接 | 可复用的连接 |
| 核心操作 | 广播、批量关闭、统计 | 借出、归还、健康检查 |
| 生命周期 | 连接关闭自动移除 | 需要自己维护空闲/占用状态 |
| 适用 | 服务端在线连接、客户端多连接 | HTTP 客户端、RPC 客户端 |
ChannelGroup
可以作为连接池的底层容器,但连接池还需要请求关联、超时、空闲回收这些逻辑。把两者混为一谈,最后往往会出现“响应串线”或“连接被重复借出”的问题。
连接池的代价
- 连接复用意味着请求之间可能相互影响,一个慢请求会占住连接;
- 空闲连接需要心跳或定期探活,否则拿到的是半死连接;
- 服务端主动关闭连接时,客户端池子里可能还留着失效连接,首次使用会失败,需要重试;
- 连接最大生命周期和最大空闲时间要配合服务端的 keep-alive 设置。
如果请求量不大、对延迟不敏感,短连接反而更简单。连接池不是默认选项,而是有明确复用收益时的优化。
把这一篇串起来
客户端可靠连接可以按下面的顺序落地:
- 用
Bootstrap建立连接,CONNECT_TIMEOUT_MILLIS必设;启动/测试可以用sync(),业务用监听器; - 连接成功后做鉴权、恢复会话、启动心跳;
- 用
IdleStateHandler发 PING,用ReadTimeoutHandler兜底,连续多个周期失败才判定断线; - 断线进入状态机,指数退避 + 抖动重连,避免重连风暴;
- 重连后重新鉴权、恢复会话,
ChannelGroup管理在线连接; - 应用层协议选型:WebSocket 适合双向推送,HTTP 适合请求/响应,HTTPS 的
SslHandler放最前面; - 需要连接池时,先明确复用粒度和请求关联,再考虑 HTTP/2 多路复用。
参考资料
官方文档与标准
- Bootstrap(4.2
API
javadoc):客户端启动、
CONNECT_TIMEOUT_MILLIS、connect。 - IdleStateHandler(4.2 API javadoc):reader/writer/all 三类空闲事件的语义。
- RFC 6455: The WebSocket Protocol:握手、帧、Ping/Pong、关闭。
- WebSocket API(Spring Framework 官方文档):Spring 的封装层次与 Handler 模型。
- Netty User Guide for 4.x:客户端、Pipeline、编解码器示例。
- Azure Architecture Center: Retry pattern:瞬时故障重试、退避与重试风暴。
- Resilience4j
Retry:
ofExponentialBackoff、ofRandomized等 Java 侧实现。 - Netty 4.2 Migration Guide:4.2 的 EventLoopGroup 与 TLS 配置变化。
中文解读与案例
- 【Netty】应用实战:客户端重连(掘金,2023-09-24):固定延迟重连的最小实现,可作为“为什么需要退避+抖动”的反例。
- Netty 心跳机制实现(客户端与服务端)(博客园,2025-04-25):三种 IdleStateHandler 组合与 NAT 场景。
- 当 WebSocket 遇上多实例部署(腾讯云,2026-09-18):粘性路由、握手期鉴权、串行写防乱序。
- Spring Boot 3 + Netty 构建高并发即时通讯服务(阿里云,2025-06-03):WebSocket Pipeline 与 userId→Channel 会话管理。
- Java Netty 实战指南:从 NIO 线程模型到 TCP 编解码和心跳机制(简书):基础示例与 release 规则。
- Spring Boot WebSocket 方案对比(ITPUB,2026-02-02):Netty 与 Spring 官方 Starter 的差异。
- 为 Netty IM 生成自签名 SSL/TLS 证书(博客园,2023-02-23):keytool/OpenSSL 与 PKCS12 证书。