生成与推理
输出层中从隐藏状态到词表概率分布
前面我们已经完成了 Transformer 内部的全部计算,输入序列经过多层 Transformer Block 后,得到了包含上下文信息的最终隐藏状态。
但是到这里,模型实际上还没有预测出下一个 Token。Transformer 输出的仍然是隐藏状态向量,而不是词表中每个 Token 对应的预测概率,还没到生成这步呢。
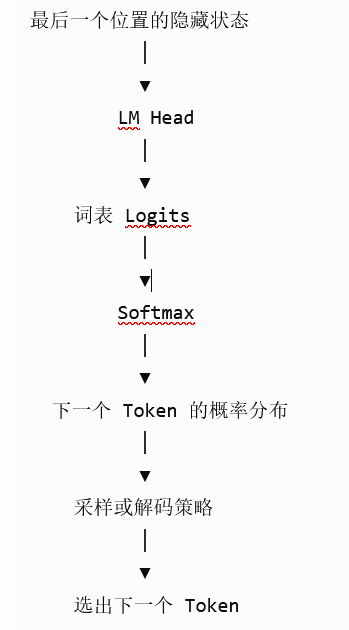
因此,还需要一个输出层,将模型内部的隐藏特征转换为对整个词表的预测分数。这个过程主要分为三个步骤:
- LM Head(Language Modeling Head):将隐藏状态投影到词表空间。
- Logits:得到词表中每个 Token 对应的原始预测分数。
- Softmax:将 Logits 转换为概率分布。
LM Head
假设输入:
1 | 今天天气真 |
模型经过全部 Transformer Block 后,已经得到了最后一个位置的隐藏状态。
我们知道,这个隐藏状态融合了前文信息,可以用于预测下一个 Token。但它可能只是一个 4096 维的向量:
1 | 最后一个位置的隐藏状态:[0.12, -0.35, 0.81, ..., 0.26] |
而模型的任务是预测下一个 Token。假设词表中存在 100000 个 Token,那么最终就需要得到 100000 个候选 Token 的预测分数。问题来了,怎么把 4096 维的隐藏状态转换成 100000 个 Token 的分数?
答案就是通过一个可学习的线性投影层,也就是 LM Head。
假设最终隐藏状态为: \[ h\in\mathbb{R}^{d_{\mathrm{model}}} \] 词表大小为 \(V\),那么输出层的权重矩阵可以表示为: \[ W_{\mathrm{out}}\in\mathbb{R}^{d_{\mathrm{model}}\times V} \] 经过线性投影: \[ \boxed{z=hW_{\mathrm{out}}+b} \] 其中:
- \(h\):最后一个位置的隐藏状态向量。
- \(W_{\mathrm{out}}\):输出层的可学习权重矩阵。
- \(b\):可选的偏置参数,部分模型并不使用。
- \(z\):输出的 Logits 向量。
所以,最终的输出维度为: \[ z\in\mathbb{R}^{V} \] 也就是一个长度等于整个词表大小的向量。
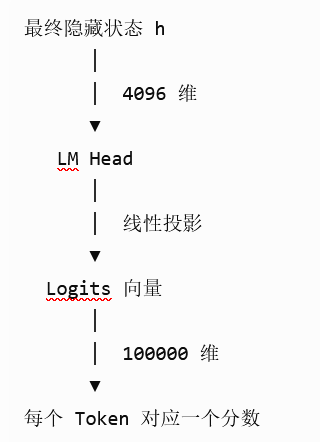
注意,注意力的输出投影负责融合多个 Attention Head 的特征,而 LM Head 负责将最终隐藏状态映射到词表空间,完成语言建模任务的输出预测。
Logits
通过 LM Head,我们已经得到了一个长度为 \(V\) 的向量,每个元素都对应词表中的一个 Token。这个向量就叫 Logits。
例如,还是输入:
1 | 今天天气真 |
假设模型计算出来的部分 Logits 为:
1 | Token Logit |
可以看到,好 的分数最高,热
次之,差 最低。但 Logit 并不是概率。它只是模型对某个候选
Token 给出的原始分数,可以是正数、负数,也不要求所有分数相加等于 1。
那么,模型究竟是根据什么给 Token 打分的,如何决定最后 LLM 使用哪个 Token?其实还是线性代数中的矩阵乘法。
输出矩阵 \(W_{\mathrm{out}}\) 的每一列,都对应词表中某个 Token 的一组可学习参数。假设第 \(j\) 个 Token 对应的权重向量为 \(w_j\),那么它的 Logit 就可以表示为: \[ z_j=h\cdot w_j+b_j \] 也就是说,模型使用最终隐藏状态 \(h\),与某个 Token 对应的权重向量计算点积,再加上偏置,得到该 Token 的分数。
为什么这样就能够预测下一个 Token?
因为输出矩阵和 Transformer 内部参数一样,都是在训练过程中不断优化的。模型为了提高正确 Token 的预测概率,会调整隐藏状态的生成方式以及输出层参数,使得正确候选 Token 的 Logit 相对更高。
例如:
1 | 上下文:"今天天气真" |
所以说,LM Head 的本质就是一个基于隐藏状态的词表分类层,通过训练得到的权重,为每个候选 Token 计算预测分数。
而且,模型判断候选 Token 时,真正重要的是不同 Logit 之间的相对大小和差距。
将 Logits 转换为概率分布
接下来,就需要将 Logits 转换成真正的预测概率。
这里使用的仍然是我们之前接触过的 Softmax,只不过这一次归一化的对象不再是注意力矩阵中的 Token 位置,而是整个词表中的候选 Token。 \[ P(t_j\mid x)= \frac{e^{z_j}}{\sum_{k=1}^{V}e^{z_k}} \] 其中:
- \(x\):当前输入的上下文。
- \(t_j\):词表中的第 \(j\) 个 Token。
- \(z_j\):这个 Token 对应的 Logit。
- \(V\):词表大小。
- \(P(t_j\mid x)\):在当前上下文下,下一个 Token 为 \(t_j\) 的预测概率。
这个公式实际上就是:先对所有 Logits 取指数,再将每个结果除以所有结果的总和。
这样,每个 Token 就得到一个 0 到 1 之间的概率,并且整个词表的概率之和为 1。
例如,假设我们使用一个只有四个 Token 的简化词表:
| Token | Logit | Softmax 后的概率 |
|---|---|---|
| 好 | 2.3 | 64.4% |
| 热 | 1.3 | 23.7% |
| 冷 | 0.3 | 8.7% |
| 差 | -0.7 | 3.2% |
可以看到,Softmax 并没有改变候选 Token 的分数排序,而是把这些分数转换成了可用于预测和采样的概率分布。
其中,好
具有最高的预测概率,但并不意味着模型一定会选择它。因为模型计算概率分布,与模型最终决定生成哪个
Token,是两个不同的步骤。
前者由 LM Head 和 Softmax 完成,后者则由后面要介绍的 Temperature、Top-k、Top-p 等采样策略控制。
实际模型的词表可能包含数万甚至更多 Token,因此 Softmax 的分母需要考虑整个词表,而不是只计算展示出来的几个高概率候选词。
为什么推理时只需要最后一个位置的 Logits?
如果输入序列长度为 \(n\),Transformer 得到的最终隐藏状态为: \[ H\in\mathbb{R}^{n\times d_{\mathrm{model}}} \] 那么,理论上可以对所有位置同时执行 LM Head: \[ Z=HW_{\mathrm{out}} \] 得到: \[ Z\in\mathbb{R}^{n\times V} \] 这意味着,序列中的每个位置都能够产生一组词表 Logits,用来预测它之后的 Token。
在训练阶段,这一点非常重要,因为模型可以一次性计算多个位置的预测结果,并与对应的目标 Token 计算损失。
但是,在实际自回归生成过程中,我们需要的是当前整个上下文之后的下一个 Token。因此,对于一段已经给定的输入上下文,只需要取最后一个位置的隐藏状态进行输出预测: \[ z_{\mathrm{next}}=h_nW_{\mathrm{out}}+b \] 然后计算: \[ P(t_{\mathrm{next}}\mid t_1,\ldots,t_n) = \operatorname{softmax}(z_{\mathrm{next}}) \] 这样,就得到了在当前上下文下,词表中各个 Token 作为下一个 Token 的条件概率分布。
利用这一特点,就避免了对不需要输出的位置执行完整的词表投影,从而减少计算和内存开销。
到这里,模型已经完成了从 Transformer 最终隐藏状态到词表概率分布的转换。
总结
- LM Head:负责将隐藏状态映射到词表空间,为每个 Token 计算预测分数。
- Logits:模型给出的原始预测分数,表示候选 Token 之间的相对倾向。
- Softmax:将 Logits 转换成整个词表上的条件概率分布。
权重绑定
简单说说 Weight Tying,我们在词嵌入章节介绍过,输入 Embedding 使用一个大小为 \(V\times d_{\mathrm{model}}\) 的可训练矩阵,将 Token ID 转换为隐藏向量。
而输出层恰好进行相反方向的维度映射:
1 | 输入 Embedding: |
既然输入和输出都与同一份词表有关,那么能不能复用同一组参数?是可以的。
假设输入嵌入矩阵为: \[ E\in\mathbb{R}^{V\times d_{\mathrm{model}}} \] 在采用权重绑定的模型中,可以设置:\(W_{\mathrm{out}}=E^T\)
这样,输入 Embedding 和输出 LM Head 就共享同一份权重参数,而不是分别维护两套完全独立的矩阵。
例如,词表大小为 100000,隐藏维度为 4096,那么一份矩阵就包含:\(100000\times4096=409600000\),也就是约 4.1e 的参数。
如果输入 Embedding 和输出 LM Head 分别维护独立矩阵,就需要两份这样的参数;而权重绑定能够复用其中一份,减少模型参数量。不过,这是一种可选的架构设计,并不是所有 LLM 都会采用。部分模型为了获得更灵活的输入和输出表示,会选择不共享权重。
采样策略:贪婪、温度、Top-k、Top-p、Beam Search
前面我们已经知道,模型经过 LM Head 和 Softmax 后,会得到下一个 Token 在整个词表上的概率分布。
但是我们也说了,模型计算概率分布,与模型最终决定生成哪个 Token,是两个不同的步骤
还是那个例子,例如,假设模型面对输入:
1 | 今天天气真 |
计算出的候选 Token 概率为:
| Token | 预测概率 |
|---|---|
| 好 | 64.4% |
| 热 | 23.7% |
| 冷 | 8.7% |
| 差 | 3.2% |
那么模型应该直接选择概率最高的“好”,还是允许“热”“冷”等其他 Token 也有机会被选中?这个选择过程就涉及解码策略(Decoding Strategy)。不同的解码策略,会在生成结果的确定性、多样性以及整体序列质量之间做出不同的取舍。
详细了解它们之前先进行快速总览
| 策略 | 核心机制 | 主要特点 |
|---|---|---|
| Greedy | 每次选择最大概率 Token | 确定性强,但容易局部最优 |
| Temperature | 缩放 Logits,调整概率分布 | 控制随机性和多样性 |
| Top-k | 保留概率最高的 k 个 Token | 固定候选数量 |
| Top-p | 保留累计概率达到阈值的候选 | 动态调整候选数量 |
| Beam Search | 同时维护多条高得分序列 | 比较整体序列得分,计算成本更高 |
模型的概率预测能力与最终生成行为,并不是同一回事。相同的模型、相同的上下文,即使计算出的原始 Logits 完全相同,也可能因为不同解码策略而产生不同的输出结果。修改 Temperature、Top-p 等参数,能够明显改变模型回答的稳定性、重复程度和文本多样性。但需要记住,这些策略主要是在调整如何从模型已经学到的概率分布中选择输出,并不会直接改变模型内部已经学习到的知识和能力。
贪婪解码
贪婪解码是最直接的方式:每一步都选择当前概率最高的 Token。 \[ t_{\mathrm{next}}=\arg\max_{t\in V}P(t\mid x) \] 其中,\(\arg\max\) 的意思就是找到概率最大的候选 Token。
例如,上面的概率分布中,“好”的概率为 64.4%,是所有候选 Token 中最高的,所以贪婪解码会直接选择“好”。然后把这个 Token 加入上下文,继续预测下一个 Token。整个过程都采用相同规则。
这种方式具有明显特点:
- 确定性较强:相同模型、输入和计算条件下,通常会得到相同的结果。
- 实现简单:不需要执行随机采样,只需要找到最大概率对应的 Token。
- 容易陷入局部最优:当前概率最高的 Token,不一定能够组成整体概率最高或质量最好的完整文本。
第三点尤其值得注意。因为贪婪解码只考虑当前这一步,不会提前评估某个 Token 对后续整段文本的影响。例如,某个 Token 当前概率很高,但选择它以后,后续能够形成的句子可能并不理想;另一个 Token 虽然当前概率略低,却可能引导出更加合理的完整表达。贪婪解码不会主动比较这些未来路径。所以,Greedy 的核心特点就是局部最优,而不是全局最优。
温度如何调整概率分布
贪婪解码每次只选择最大概率 Token,而随机采样则可以按照概率分布选择不同 Token。
但这里还有一个问题:如果模型原始概率分布过于集中,随机采样也可能几乎总是选择同一个 Token;如果分布过于平缓,又可能频繁选择不太合适的 Token。
因此,可以通过 Temperature 调整概率分布的集中程度。
其计算方式是先对 Logits 进行缩放: \[ P_T(t_i)= \frac{\exp(z_i/T)} {\sum_j\exp(z_j/T)} \] 其中 \(T\) 就是温度参数,通常取正数。
这个公式不需要复杂理解,关键就在于:原本的 Logit \(z_i\),会先除以温度 \(T\),然后再执行 Softmax。这是一个缩放的操作
因此:
- \(0<T<1\):不同 Logit 之间的差距被放大,概率分布更加集中,高概率 Token 更容易被选中。
- \(T=1\):保持原始的 Softmax 概率分布。
- \(T>1\):不同 Logit 之间的差距缩小,概率分布更加平缓,低概率 Token 获得更多采样机会。
例如,假设四个候选 Token 的 Logits 为:
1 | 好: 2.3 |
经过不同 Temperature 调整后,概率分布大概会是这样:
| Token | T = 0.5 | T = 1 | T = 2 |
|---|---|---|---|
| 好 | 86.5% | 64.4% | 45.5% |
| 热 | 11.7% | 23.7% | 27.6% |
| 冷 | 1.6% | 8.7% | 16.7% |
| 差 | 0.2% | 3.2% | 10.2% |
可以看到,降低温度后,“好”的概率进一步提高;而提高温度后,“热”“冷”等候选 Token 的概率也相应增加。
这里需要理解一个很重要的特点:Temperature 不会改变 Logits 的相对排序,而是改变不同候选 Token 被随机采样到的概率。所以,Temperature 并不会直接增强模型的知识或者推理能力。它调整的是输出分布的随机性,进而影响最终生成文本的表现。低温度通常适合需要稳定输出的任务,例如代码生成、信息提取和结构化回答;较高温度则可以增加生成多样性,适用于创意写作、头脑风暴等场景。
另外,API 中的 temperature=0
通常表示使用贪婪解码或近似确定性的生成方式。可不是除以零
Top-k:只在概率最高的 k 个 Token 中采样
Temperature 可以调整概率分布,但它并没有直接限制候选 Token 的数量。
假设一个模型具有十万个 Token,即使某些 Token 的概率非常小,在普通随机采样中仍然可能被选中。但是这其实不太好。为了减少这些低概率候选 Token 对生成结果的影响,可以使用 Top-k Sampling。它的思路是,每一步只保留概率最高的 k 个 Token,其他 Token 全部排除,然后在保留的候选集合中重新归一化并随机采样。
例如:
1 | 原始候选: |
那么只保留“好”和“热”。随后对这两个候选的概率重新归一化:\(P'(t_i)=\frac{P(t_i)}{\sum_{t_j\in S_k}P(t_j)}\),其中 \(S_k\) 是概率最高的 \(k\) 个 Token 组成的集合。最终得到:
1 | 好 73.1% |
这样,模型仍然具有一定的随机性,但不会再选择已经排除的低概率 Token。
不过,Top-k 存在一个问题,它固定保留 k 个候选,而不同上下文中的概率分布可能差异很大。
什么意思呢,例如,有些情况下,模型对下一个 Token 已经非常确定,最高概率可能达到 95%;但在另一些情况下,多个候选 Token 的概率可能非常接近。如果始终固定保留 50 个 Token,那么对于前一种情况,可能保留了太多意义不大的候选;而对于后一种情况,又可能排除一些仍然合理的候选。
因此,Top-k 虽然简单有效,但不能根据概率分布的集中程度自动调整候选数量。我们需要一种更好的方式
Top-p:根据累计概率动态选择候选 Token
为了解决 Top-k 固定候选数量的问题,可以采用 Top-p Sampling,也叫 Nucleus Sampling(核采样)。
Top-p 的核心思路是:按照概率从高到低排序,依次加入候选 Token,直到累计概率达到或超过设定的阈值 p。
例如,设置 \(p = 0.8\),对于前面的概率分布:
| Token | 原始概率 | 累计概率 |
|---|---|---|
| 好 | 64.4% | 64.4% |
| 热 | 23.7% | 88.1% |
| 冷 | 8.7% | 96.8% |
| 差 | 3.2% | 100% |
当加入“热”之后,累计概率达到 88.1%,已经超过 80% 的阈值,因此只保留“好”和“热”,再重新归一化并采样。但如果设置 \(p=0.95\),那么就需要继续加入“冷”,累计概率才能达到 95%。
所以,与 Top-k 最大的区别是:
- Top-k 固定候选数量:无论概率分布如何变化,都只保留概率最高的 \(k\) 个 Token。
- Top-p 固定累计概率阈值:根据当前概率分布,动态确定需要保留多少个 Token。
这意味着,模型越确定时,Top-p 保留的候选通常越少;模型越不确定、概率分布越分散时,保留的候选可能越多。
因此,Top-p 往往能够在控制低概率输出和保持文本多样性之间取得较好的平衡,也是现代 LLM API 非常常见的采样参数。
而且,实际上,它们控制的是不同的环节,因此经常组合使用
- Temperature:调整概率分布的集中程度。
- Top-k:根据候选数量过滤 Token。
- Top-p:根据累计概率过滤 Token。
在一种常见的实现中,采样过程可以表示为:
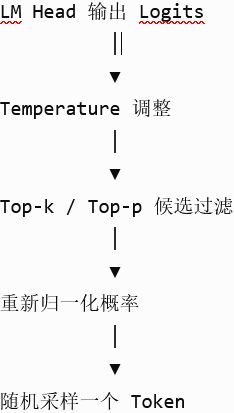
Temperature 调整概率分布,Top-k 和 Top-p 限制候选范围,最终再从保留的 Token 中采样。
此外,很多推理框架还提供 Repetition Penalty、Frequency Penalty 等参数,通过调整候选 Token 的 Logits,减少不必要的文本重复。这就是比较具体的内容了
Beam Search
前面讲解的 Greedy、Top-k 和 Top-p,都主要围绕当前这一步如何选择 Token。
而 Beam Search(束搜索) 则采用不同思路:它不急于只保留一个结果,而是在生成过程中同时维护多条候选序列,并逐步筛选整体得分较高的路径。
假设模型需要生成一段包含两个 Token 的文本。
第一步的候选概率为:
1 | A:60% |
如果使用 Greedy,模型会直接选择 A。
但是继续生成第二个 Token 后,假设:
1 | 选择 A 后,最佳下一个 Token 的概率:30% |
那么两条完整序列的联合概率分别为: \[ P(A,\text{next})=0.6\times0.3=0.18 \\ P(B,\text{next})=0.4\times0.9=0.36 \] 可以看到,虽然 A 在第一步具有更高概率,但由 B 开始的完整序列反而具有更高的联合概率。
而 Beam Search 就是为了保留多个具有潜力的候选序列。这样能够一定程度上避免局部最优。
假设设置 Beam Width = 2,那么在生成过程中,模型会维护最多两条候选路径。每一步都会扩展这些候选路径,计算新序列的累计得分,然后继续保留得分较高的候选。
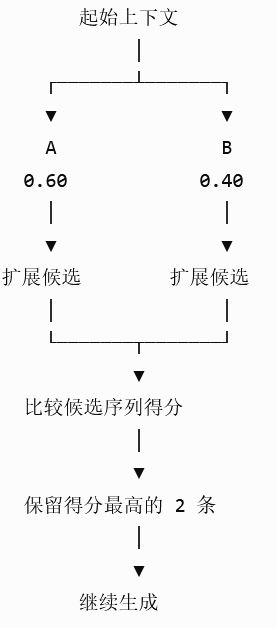
Beam Search 的评分方式是这样:完整序列出现的概率,等于每一步条件概率的乘积。
对于生成序列 \(y_1,y_2,\ldots,y_T\),其联合概率可以写成: \[ P(y_1,\ldots,y_T\mid x)= \prod_{t=1}^{T}P(y_t\mid x,y_{<t}) \] 但实际计算中,如果连续相乘大量小于 1 的概率,很容易产生数值下溢,因此通常使用对数概率累加: \[ S(y)=\sum_{t=1}^{T}\log P(y_t\mid x,y_{<t}) \] 由于对数函数具有单调性,比较这个累计得分,实际上就是在比较候选序列的联合概率。
不过,直接累加对数概率通常会偏向较短的序列,因此 Beam Search 往往还会结合长度惩罚(Length Penalty)、结束条件等机制进行调整。实际上情况会非常非常的复杂和难以琢磨。
不过,序列的模型概率更高,也不一定意味着它对人类来说更加自然、正确或者富有创造性。在机器翻译、语音识别等具有明确序列输出目标的任务中,Beam Search 曾经非常常见。但对于现代通用聊天式 LLM,或者 AI 生图,就不咋用了。所以,现代聊天生成任务通常更常使用 Temperature、Top-p 等采样方式,而 Beam Search 更适合需要比较候选序列整体得分的场景。
自回归生成循环与停止条件
前面我们已经知道,模型经过前向传播,会得到下一个 Token 的概率分布,再通过采样策略选择一个 Token。但是*模型一次预测得到的只是一个 Token,而我们实际需要的是一句话、一段文字,甚至是一篇完整的文章。
因此,LLM 需要不断重复上面的整个预测过程,将新生成的 Token 加入已有上下文,再根据更新后的上下文预测下一个 Token。这就是自回归生成(Autoregressive Generation)。
不过,我们之前已经多次提到这个概念,这里就不再重复基础定义,来看看一次完整的生成请求,在模型推理过程中究竟是如何执行的,以及什么时候结束。
假设用户输入:
1 | 今天天气真 |
模型可能会依次生成:
1 | 第一次预测 → 好 |
这里的 <eos>
是示意性的结束标记,一般来说你看不到。
这个过程主要包含两个阶段
Prefill 预填充阶段:模型一次性处理用户提供的完整输入序列,经过 Transformer 计算得到最后一个位置的 Logits,并根据采样策略生成第一个 Token。
例如:
1
2
3
4
5
6
7
8
9输入上下文:今天天气真
Prefill 计算
│
▼
预测下一个 Token
│
▼
生成:"好"同时,采用 KV-Cache 的推理框架会在这个阶段建立输入序列对应的 K/V 缓存,供后续生成使用。
Decode 解码阶段:这时已经生成了第一个 Token,接下来就需要继续生成后续内容。
在第二次预测时,模型需要根据输入继续预测,,假设得到了句号,之后继续,接下来生成的是
<eos>,那么生成循环就结束了。flowchart TD A[用户输入 Prompt] --> B[Prefill] B --> C[生成第一个 Token] C --> D{检查停止条件} D -->|满足| E[结束生成] D -->|不满足| F[Decode 后续 Token] F --> G[采样 Token] G --> H{检查停止条件} H -->|满足| E H -->|不满足| F虽然我们可以从逻辑上理解为每次都将新 Token 加入完整上下文,但实际使用 KV-Cache 的推理引擎,不需要每次都重新计算全部历史 Token。KV Cache 后续再说
自回归生成必须逐步执行,生成步骤之间存在数据依赖,这是很重要的
对于生成序列 \(y_1,y_2,\ldots,y_T\),模型实际上是在不断计算:\(P(y_t\mid x,y_1,\ldots,y_{t-1})\),其中,\(x\) 是原始输入,\(y_t\) 是第 \(t\) 步要生成的 Token。这个公式的要表达的是,每一步的预测,都依赖原始输入以及之前已经生成的所有 Token。这是一个条件概率的情况,模型只有先生成了“好”,才能在下一次预测时知道当前上下文是“今天天气真好”,进而决定是否生成句号或者继续补充其他内容。
这也意味着,虽然 Transformer 能够并行处理已知的输入序列,但对于普通自回归解码,未来的 Token 尚未产生,因此无法像 Prefill 一样一次性并行生成整段文本。
这也是为什么我们经常会发现,模型处理一段较长的输入可能很快,但生成一段很长的回答却需要持续等待。
最后吗,介绍一下停止条件,也就是模型怎么知道应该结束生成。因为如果模型一直根据前文预测下一个 Token,那么生成过程岂不是会无限循环。
LLM 的神经网络主要负责根据上下文计算预测分数,而持续调用模型、执行采样、管理缓存以及判断何时停止,是推理框架的工作。
生成请求必须具有明确的停止条件。
最常见的停止方式包括:
| 停止条件 | 触发方式 | 实际含义 |
|---|---|---|
| EOS / 结束标记 | 模型生成特定结束 Token | 模型表示当前生成序列可以结束 |
| Max Output Tokens | 达到允许生成的 Token 数量 | 输出长度达到限制,强制结束 |
| Stop Sequence | 输出匹配预设的停止序列 | 应用按约定的文本边界结束生成 |
| 外部终止 | 用户取消、超时、服务中断等 | 由模型外部的系统中断执行 |
EOS:模型主动生成结束标记
EOS(End of Sequence)是模型词表中的特殊 Token,用于标记一个序列的结束。当推理框架检测到模型生成了对应的结束 Token,就可以停止后续 Decode。
EOS 和其他 Token 一样,也可以参与模型的输出预测。所以,在训练过程中,模型会接触包含结束标记的序列,并学习什么样的上下文适合结束。当模型认为当前回答已经完整时,就可能给予结束 Token 较高的预测概率。
Max Output Tokens:本次生成最多允许消耗规定数量的输出 Token。
Stop Sequence:让应用自行规定生成边界
除了模型主动生成结束 Token,以及达到输出长度上限之外,我们还可以人为设置 Stop Sequence
外部停止:一般都会有停止的接口来停止输出
KV-Cache 是推理加速的核心机制
KV-Cache 对 KV 进行缓存,同时改变了注意力计算
前面我们已经知道,LLM 的自回归生成过程是逐 Token 执行的,每生成一个新的 Token,都需要结合前面已有的上下文,预测下一个 Token。之前也经常提到存在一个的非常明显的性能问题,如果每生成一个 Token,都需要把整个上下文重新送入 Transformer,并重新计算所有 Token 的注意力,那么大量计算其实是在重复执行
例如,假设模型正在生成:
1 | 输入:今天天气 |
如果不做任何优化,每次生成时都重新计算整个序列,就意味着“今天”“天气”等历史 Token 会被反复处理。
而且随着上下文不断增长,需要重复计算的历史 Token 也越来越多。那么,之前计算出的结果能不能直接保存起来,在后续生成中复用?这就是 KV-Cache(Key-Value Cache) 的核心思路。
我们前面已经介绍过,自注意力机制需要通过 Q、K、V 计算 Token 之间的关联。在 Decoder-only 自回归模型中,因为存在因果掩码,所以每个 Token 只能访问自己和之前的位置。这里就产生了一个非常重要的性质:对于已经处理过的历史 Token,只要前面的上下文没有改变,那么它们在各层 Transformer 中计算得到的 K、V 也不会因为后面新增了 Token 而改变。
例如,假设当前序列是:
1 | 位置 1:今天 |
由于因果掩码的存在,位置 1 只能依赖自身,位置 2 只能依赖位置 1 和 2,位置 3 则可以依赖全部三个位置。
那么,假设我们在后面追加一个 Token:
1 | 位置 4:好 |
这个新的 Token 并不会反过来影响前面三个位置的隐藏状态。因此,之前为“今天”“天气”“真”计算得到的 K、V 仍然可以继续使用。缓存是有效且有用的!因果注意力保证了历史位置的计算结果不会受到未来 Token 的影响。
KV-Cache 保存的并不是原始 Token,也不是简单的 Token Embedding,而是 Transformer 各层注意力计算得到的 Key 和 Value 张量。
KV-Cache 见名知意,缓存了 K V
假设模型已经处理过 \(n\) 个 Token,那么对于某个注意力层,原本已经计算得到: \[ K=[k_1,k_2,\ldots,k_n] \\ V=[v_1,v_2,\ldots,v_n] \] KV-Cache 就是将这些历史 K、V 保存起来。
当模型继续处理第 \(n+1\) 个 Token 时,只需要计算当前新 Token 的:\(q_{n+1},\quad k_{n+1},\quad v_{n+1}\)
然后,把新的 K、V 追加到缓存中: \[ K_{\mathrm{cache}}=[k_1,\ldots,k_n,k_{n+1}]\\V_{\mathrm{cache}}=[v_1,\ldots,v_n,v_{n+1}] \] 这样,当前 Token 的 Query 就可以直接和缓存中的所有 Key 计算注意力,再对对应的 Value 进行加权聚合。
为什么不缓存 Q 呢?其实很好理解。因为 Q 是用于当前 Token 查询上下文,通常只需要计算当前的 Query。
因为在生成下一个 Token 时,我们只需要使用当前 Token 的 Query,查询所有历史 Token 的 Key,并聚合对应的 Value。之前那些 Token 的 Query 已经在它们各自的计算过程中使用过了,后续生成不再需要使用它们,自然不缓存
另外,每个 Transformer Block 都有自己的注意力层及投影参数,因此每一层都需要维护对应的 K/V 缓存,而不是整个模型只维护一份。
使用 KV-Cache 后,注意力计算发生了变化。
前面我们知道,标准自注意力需要计算整个序列的注意力分数矩阵:\(S=\frac{QK^T}{\sqrt{d_k}}\),对于长度为 \(n\) 的序列,完整注意力分数矩阵的尺寸为 \(n\times n\)。但在 Decode 阶段,我们只需要计算最新位置的输出,而不需要重新计算所有历史位置的输出。因此,使用 KV-Cache 后,可以将当前 Token 的注意力计算简化为: \[ \boxed{ o_t= \operatorname{softmax} \left( \frac{q_tK_{\mathrm{cache}}^T}{\sqrt{d_k}} \right)V_{\mathrm{cache}} } \] 这里:
- \(q_t\):当前 Token 的 Query。
- \(K_{\mathrm{cache}}\):包含当前及历史 Token 的 Key。
- \(V_{\mathrm{cache}}\):包含当前及历史 Token 的 Value。
- \(o_t\):当前 Token 的注意力输出。
如果使用 RoPE,那么实际参与点积的是经过对应位置旋转后的 Query 和 Key,原理并不改变。这个公式相比之前的完整注意力公式,最大的区别是:Q 不再是包含所有 Token 的矩阵,而是当前这一个 Token 的 Query。
因此,在单个注意力头中,原本需要计算的 \(n\times n\) 分数矩阵,现在只需要计算当前 Query 与 \(n\) 个 Key 的匹配关系,也就是 \(1\times n\)。也就是说,使用 KV Cache,只需要计算当前这一行
Prefill 和 Decode 是怎样配合 KV-Cache 的
现在,我们将 KV-Cache 放到实际的推理流程中。
Prefill 阶段:建立初始缓存。
假设用户输入:
1
今天天气真
模型会对这段完整输入进行并行计算,同时在各层生成对应的 K、V,并将其保存到 KV-Cache。
Prefill 完成后,模型使用最后一个位置的输出预测第一个新 Token,假设生成“好”。
此时,缓存中保存的主要还是原始输入 Token 的 K/V,因为刚刚采样得到的“好”,还没有作为模型的输入,来经过下一轮 Decode。
Decode 阶段:读取缓存并增量更新
下一次模型需要处理“好”这个新 Token。
此时:
- 读取已有的历史 KV-Cache。
- 计算新 Token 在各层对应的 Q、K、V。
- 使用当前 Q 和历史及当前 K/V 完成注意力计算。
- 将新 Token 的 K/V 追加到对应层的缓存中。
- 得到下一 Token 的 Logits,继续采样。
KV-Cache 作为 Prefill 和 Decode 中,减少计算,缓存维护的主要衔接内容,Prefill 负责处理已有上下文并建立缓存,Decode 则利用这些缓存进行增量计算。这也是现代 LLM 推理引擎能够高效生成长文本的重要基础。
KV-Cache 的代价是占用大量的显存
KV-Cache 似乎非常完美。能够避免大量重复计算,还能优化推理。但是实际上,KV-Cache 本质上是一种空间换时间的优化。它通过额外保存历史 K/V 张量,减少后续的重复计算,这些缓存需要占用显存。
因此,首先,KV-Cache 不会消除历史上下文的计算开销。在每一步 Decode 中,当前 Query 仍然需要访问允许关注的历史 Key,并聚合对应的 Value。因此,上下文越长,每一步需要读取和处理的历史 K/V 通常也越多,随着上下文增长,生成的 Token 不断增加,KV-Cache 的显存占用和数据读取量也会增加。这也就是为什么 GPU 推理时,尤其是逐 Token Decode 阶段,性能瓶颈往往是显存。
在典型 Transformer 架构中,KV-Cache 的显存占用可以近似表示为: \[ M_{\mathrm{KV}}=2\times L\times B\times N\times H_{\mathrm{KV}}\times D_{\mathrm{head}}\times S \] 其中:
- \(L\):Transformer Block 的层数。
- \(B\):批处理中的请求数量。
- \(N\):每个请求缓存的 Token 数量。
- \(H_{\mathrm{KV}}\):KV Head 的数量。
- \(D_{\mathrm{head}}\):每个 KV Head 的维度。
- \(S\):每个数值占用的字节数。
- 前面的 \(2\):因为需要同时保存 Key 和 Value。
这个公式其实就是计算:每个 Token 在所有层中需要保存多少 K/V 数据,再乘以缓存的 Token 数量和请求数量。
KV-Cache 虽然降低了重复计算,但长上下文和高并发会让缓存显存占用迅速增加。
这也是为什么实际 LLM 推理服务不仅需要考虑模型权重的显存占用,还必须为 KV-Cache 预留足够的显存空间。
前面在多头注意力章节中,我们已经简单介绍过 MHA、MQA 和 GQA,这里就可以理解它们与 KV-Cache 的实际关系了。
从上面的显存公式可以看到,缓存占用与 \(H_{\mathrm{KV}}\),也就是 KV Head 数量成正比。
例如,假设 Query Head 数量为 32:
1 | MHA:32 个 KV Head |
如果其他参数保持相同,那么相比 MHA,具有 8 个 KV Head 的 GQA,其 KV-Cache 理论存储量可以减少到原来的四分之一。而 MQA 由于共享一组 K/V,缓存占用还可以进一步降低。
所以说,GQA、MQA 的重要工程价值之一,就是通过减少需要缓存的 K/V Head 数量,降低长上下文推理中的显存压力和缓存读取开销。
推理优化
前面我们已经了解了 LLM 的完整生成过程,包括 Transformer 前向传播、Token 采样、自回归生成循环,以及用于避免重复计算的 KV-Cache。
那么,到这里是不是就已经能够高效运行一个大语言模型了?
实际上还远远不够。
因为在实际应用中,一个 LLM 服务可能需要同时处理大量用户请求,而每个请求的输入长度、输出长度和生成进度都不一样。
例如,有的用户只输入一句话,有的用户上传几万 Token 的文档;有的请求只需要返回一个 JSON,有的则需要生成数千 Token 的回答。
如果只是简单地把每个请求交给 GPU 执行,即使已经使用 KV-Cache,也可能出现 GPU 利用率不高、显存浪费、请求排队严重等问题。
因此,现代 LLM 推理优化不仅要减少单次模型计算的成本,还需要解决如何高效利用 GPU、管理缓存以及调度并发请求的问题。
实际 LLM 服务最常关注以下几个指标:
| 指标 | 含义 | 主要反映 |
|---|---|---|
| TTFT(Time To First Token) | 从请求发送到收到第一个输出 Token 的时间 | 首字响应速度 |
| TPOT(Time Per Output Token) | 生成阶段平均每个输出 Token 的耗时 | 持续生成速度 |
| ITL(Inter-Token Latency) | 相邻两次流式输出之间的时间间隔 | 输出是否流畅 |
| Throughput(吞吐量) | 单位时间内系统处理的请求数或 Token 数 | 整体服务处理能力 |
| GPU Memory Usage | 模型权重、KV-Cache 等占用的显存 | 资源使用情况 |
推理优化并不存在一个唯一的速度指标,而是需要在响应延迟、服务吞吐量、显存占用以及模型输出质量之间取得平衡。
首先,推理框架需要区分 Prefill 和 Decode,这两个阶段在计算方式上存在明显差异,而它们的性能瓶颈也不一样。
Prefill 通常更偏向计算密集型
因为模型需要一次处理整个输入序列,可以执行大量矩阵乘法,并利用 GPU 的并行计算能力。特别是输入包含大量 Token 时,注意力和其他网络层都需要执行相应的计算。
Decode 则往往更偏向显存带宽密集型
因为普通自回归生成每一步只产生一个新 Token。在单请求或较小 Batch 场景中,GPU 需要反复读取模型权重和历史 KV-Cache,但每一步能够进行的计算相对有限。
因此,GPU 可能大量时间花在等待数据从显存送到计算单元。
现代 LLM 推理引擎的核心目标,是在有限的计算与显存资源下,尽可能降低请求延迟、提高 Token 吞吐量,并维持稳定的服务能力。
这就引出了推理优化的几个主要方向:
- 计算优化:减少不必要的计算和显存读写,提高计算内核效率。
- 缓存优化:提高 KV-Cache 的显存利用率和复用能力。
- 调度优化:让不同请求更加充分地利用 GPU。
- 模型压缩与并行:降低模型运行成本,或者利用多张 GPU 承载更大的模型。
- 生成算法优化:减少获得相同生成结果所需的串行计算步骤。
下面介绍其中最有代表性的技术。
连续批处理 Continuous Batching
假设现在有三个用户同时调用 LLM:
1 | 请求 A:需要生成 100 个 Token |
传统的静态批处理(Static Batching),通常会将一批请求组合起来执行。
但问题在于,这些请求的生成长度并不相同。
例如,请求 B 在生成 20 个 Token 后就结束了,而请求 C 还需要继续生成很长一段内容。
如果整个 Batch 一直保持固定,就容易产生资源浪费,而且新到达的请求可能还需要等待当前 Batch 完成。
Continuous Batching 的思路是:连续批处理不是等一批请求全部结束后才接收下一批,而是在推理过程中不断调整活跃请求集合。
例如:
flowchart TD
    A["请求 A、B、C 进入推理引擎"] --> B["调度器选择本轮请求"]
    B --> C["GPU 执行本轮批处理"]
    C --> D{"检查请求状态"}
    D --> E["已结束的请求释放资源"]
    D --> F["未结束的请求继续保留"]
    E --> G["允许新请求加入"]
    F --> H["形成下一轮执行批次"]
    G --> H
    H --> B
与传统静态 Batch 相比,Continuous Batching 可以减少 GPU 空闲和等待,提高整体吞吐量。它也是 vLLM 等现代 LLM 推理引擎的重要调度机制。
分块预填充 Chunked Prefill
Continuous Batching 解决了动态调度的问题,但还有一种情况比较麻烦。
假设:
- 请求 A 正在 Decode,用户已经开始接收流式回答。
- 请求 B 突然进入系统,携带了 16000 个 Token 的长文档。
如果推理引擎直接执行请求 B 的完整 Prefill,那么这一轮可能占用较长的 GPU 计算时间。对于正在生成回答的请求 A 来说,就会卡顿。
为了解决这个问题,可以采用 Chunked Prefill(分块预填充)。它的思路是,将较长的 Prefill 拆分成多个较小的计算块,再与其他请求的 Decode 任务进行调度。此时,推理引擎就可以在不同调度轮次中安排 Prefill Chunk,并穿插其他请求的 Decode 计算,能够减轻长 Prefill 对正在执行的 Decode 请求造成的阻塞。
Chunked Prefill 的价值不是减少输入 Token 的总数,而是改善长输入任务与其他请求之间的计算资源分配。
当然,分块大小也需要权衡。分块过大,长 Prefill 仍然可能影响 Decode 的延迟;分块过小,则可能增加调度和计算执行的额外开销。
PagedAttention
接下来是 PagedAttention,这是 vLLM 最有代表性的技术之一。PagedAttention 提高 KV-Cache 的显存管理效率,从而让有限显存能够服务更多请求
假设一个推理服务同时处理大量请求。由于每个请求的输入与输出长度不同,其 KV-Cache 大小也会不断变化。如果为每个请求预留一整块连续显存,就容易产生两个问题:
首先是显存浪费。
因为无法提前准确知道每个请求最终会生成多少 Token,如果预留空间过大,就会产生大量没有实际使用的显存。
其次是显存碎片。
当不同请求不断进入和退出时,即使剩余显存总量足够,也可能因为连续空间分配困难而降低利用率。
PagedAttention 的思路与操作系统的分页内存管理非常相似。它将 KV-Cache 分成固定大小的 Block,通过逻辑 Block 到物理 Block 的映射,管理实际的缓存存储位置。
flowchart LR
    subgraph Logical["请求 A 的逻辑 KV Block"]
        A1["逻辑 Block 0"]
        A2["逻辑 Block 1"]
        A3["逻辑 Block 2"]
    end

    subgraph Physical["GPU 显存中的物理 Block"]
        P1["物理 Block 9"]
        P2["物理 Block 2"]
        P3["物理 Block 15"]
    end

    A1 --> P1
    A2 --> P2
    A3 --> P3
可以看到,逻辑上连续的缓存,并不需要存储在物理上连续的显存空间里。当请求继续生成新的 Token 时,推理引擎只需要根据需求分配新的缓存 Block,而不是一开始就预留整个最大输出长度对应的空间。这样可以减少显存碎片和预留空间浪费,提高能够同时容纳的请求数量。
而且,PagedAttention 也为多个请求之间共享部分 KV-Cache 提供了更加灵活的管理基础。
前缀缓存 Prefix Caching
KV-Cache 可以避免同一个请求在 Decode 阶段重复计算历史 Token。
那么,如果是两个不同的请求,能不能也复用已经计算过的内容?
例如,某个企业 AI 助手具有一段固定的 System Prompt:
1 | 你是一名企业内部研发助手。 |
作为系统提示词,肯定是之后每个请求都需要携带这段相同的内容。如果每次都重新计算整段 System Prompt,显然会产生重复开销。因此,可以使用 Prefix Caching(前缀缓存)。核心思路是:当不同请求具有相同的 Token 前缀时,复用此前已经计算好的前缀 KV-Cache,跳过这部分重复 Prefill。
flowchart TD
    A["请求 A:公共前缀 + 问题 A"] --> B["计算公共前缀 KV-Cache"]
    B --> C["缓存公共前缀"]
    C --> D["处理问题 A"]

    E["请求 B:相同公共前缀 + 问题 B"] --> F{"前缀缓存命中?"}
    F -->|命中| G["复用公共前缀 KV-Cache"]
    F -->|未命中| H["重新计算前缀"]
    G --> I["只计算尚未缓存的部分"]
    H --> I
这个机制对于多轮对话、长文档问答,以及具有固定系统提示词的应用都非常有价值。
但是需要注意,Prefix Caching 依赖的是可复用的相同 Token 前缀,比较严苛,只要是 Token 序列不同,就不能直接当成同一份缓存复用。另外,Prefix Caching 主要节省的是重复的 Prefill 计算,并不会直接减少生成后续 Token 时必须执行的 Decode 工作。
KV-Cache 解决的是请求内部的历史计算复用,Prefix Caching 则进一步实现满足条件的跨请求前缀复用
FlashAttention
前面讲的 PagedAttention 主要针对 KV-Cache 管理,而 FlashAttention 则更关注注意力计算本身的执行效率。
我们已经知道,标准注意力涉及 \(QK^T\)、Softmax,以及与 V 的矩阵乘法。
在一种直接实现中,计算过程可能需要将较大的中间注意力矩阵写入 GPU 显存,再重新读取,完成后续计算。其实,因为显存的原因,很多时候,性能瓶颈并不是数学运算本身,而是数据在显存与计算单元之间反复移动。
FlashAttention 通过分块计算(Tiling)、融合计算等技术,减少注意力计算过程中不必要的显存访问。
它通常会将 Q、K、V 分块加载到 GPU 片上高速存储中,在局部完成更多计算,并通过在线 Softmax 等方法避免显式保存完整的注意力分数矩阵。
量化 Quantization
模型的参数本质上是一大批数值,它们需要存储在显存中,并在推理时参与计算。
如果使用 FP16,每个参数通常占用 2 字节。那么,假设一个模型有 80 亿个参数,仅模型权重的理论存储量就约为,\(8\times10^9\times2=16\times10^9\ \text{Bytes}\),也就是约 16 GB。这就很夸张了
如果能使用更低的数值精度表示这些参数,就可以减少存储空间。
| 数值格式 | 每参数理论位数 | 相比 FP16 的理论权重存储 |
|---|---|---|
| FP16 / BF16 | 16 bit | 100% |
| FP8 / INT8 | 8 bit | 50% |
| INT4 | 4 bit | 25% |
量化的价值主要有两个方面。
首先是降低模型权重的显存占用,使原本无法装入单张 GPU 的模型,有机会在更有限的设备上运行。
其次是减少部分权重读取的数据量,并在硬件支持对应低精度计算时进一步提高推理效率。
不过,量化也存在精度损失与计算实现上的权衡。
例如,INT4 权重量化虽然可以显著减少显存,但如果硬件没有高效的计算内核,或者运行过程中频繁需要反量化,实际速度未必比 FP16 更快。
此外,量化也可能对模型输出质量产生影响,尤其是一些对数值精度敏感的任务。
常见的量化技术和格式包括 GPTQ、AWQ、FP8 等。不展开细说了。
推测解码 Speculative Decoding
前面我们知道,自回归生成存在串行依赖,每个新 Token 通常都需要一次新的模型前向计算。
推测解码致力于减少大模型的串行 Decode 次数,它的一种经典实现方式,是使用两个模型:
- Draft Model(草稿模型):参数量较小、运行速度快,负责提前提出多个候选 Token。
- Target Model(目标模型):真正需要使用的大模型,负责验证候选 Token。
例如,草稿模型先生成一段候选:
1 | 今天天气 / 很 / 不错 / 。 |
随后,目标模型利用一次能够并行处理多个候选位置的前向计算,对这些候选进行验证。如果前几个候选满足接受条件,就可以一次确认多个 Token,而不必让大模型分别执行同样数量的串行 Decode 步骤,减少了 Decode 夸张的计算量
整个过程可以表示为:
flowchart TD
    A["当前上下文"] --> B["Draft Model 提议多个 Token"]
    B --> C["Target Model 并行验证"]
    C --> D{"候选是否被接受?"}
    D --> E["接受连续通过验证的 Token"]
    D --> F["在首个拒绝位置按规则重新采样"]
    E --> G["更新上下文"]
    F --> G
    G --> H{"是否满足停止条件?"}
    H -->|否| B
H -->|是| I["结束生成"]它之所以能够加速,是因为草稿模型提出候选的成本较低,而目标模型可以利用并行计算能力批量验证候选,从而减少昂贵的串行生成步骤。
但是吧,如果草稿模型经常预测错误,或者额外验证成本过高,那么加速收益就会下降,甚至可能得不偿失
除了独立的 Draft Model,还有 EAGLE、Multi-Token Prediction(MTP)等推测解码方案,核心目标都是减少目标模型需要执行的串行生成次数。依旧不展开细说了。
多 GPU 并行
一个模型的权重已经大到单张 GPU 无法容纳是很常见的,那么还需要通过多 GPU 并行进行推理,这是现代 LLM 的基础。
比较常见的方式包括:
- Tensor Parallelism(张量并行,TP):将同一层中的权重矩阵和计算拆分到多张 GPU 上。
- Pipeline Parallelism(流水线并行,PP):将不同 Transformer 层分配到不同 GPU 上。
- Data Parallelism(数据并行,DP):部署多个模型副本,分别处理不同的请求。
这三种方式的区别可以简单理解为:
| 并行方式 | 分配对象 | 主要解决的问题 |
|---|---|---|
| TP | 同一层的矩阵计算 | 单卡装不下模型,或需要加速层内计算 |
| PP | 不同的模型层 | 将深层模型分布到多个设备 |
| DP | 不同的请求 | 通过多个模型副本提高服务吞吐量 |
大规模推理服务中还会使用 Prefill-Decode Disaggregation(PD 分离)。它将 Prefill 和 Decode 安排在不同的推理实例上,使两个阶段能够分别配置资源、调度策略和并行方式,这样可以减少长 Prefill 对 Decode 延迟的干扰
训练与对齐
预训练
预训练的核心过程可以概括为:
大量训练数据 → 下一 Token 预测 → 计算 Loss → 反向传播 → 更新参数 → 不断重复。
在这个过程中,模型通过降低预测误差,逐渐学习语言规律、知识关联、代码结构以及一定的推理模式。
因此,预训练主要负责建立模型的基础能力,而后续的指令微调和对齐训练,则进一步塑造模型如何使用这些能力来响应用户需求。
靠下一 Token 预测目标如何训练出能力
前面我们已经知道,LLM 的核心任务是根据已有上下文,预测下一个 Token 的概率分布。
但问题是:模型最开始并不知道哪些 Token 应该出现,也没有人提前把语言规则、知识和推理方法写进 Transformer 的参数里,那么这些能力究竟是怎么学出来的?
答案就是预训练(Pre-training)。
预训练是大语言模型学习基础能力的主要阶段。模型通过大量文本、代码等训练数据,不断执行下一 Token 预测,并根据预测误差调整内部参数。
假设训练语料中有一句话:
1 | 二狗 喜欢 吃 披萨 。 |
这里为了方便理解,将它表示为几个独立的 Token。在训练时,我们可以将这个序列错开一个位置,得到输入与预测目标:
| 输入上下文 | 正确的下一个 Token |
|---|---|
| 二狗 | 喜欢 |
| 二狗 喜欢 | 吃 |
| 二狗 喜欢 吃 | 披萨 |
| 二狗 喜欢 吃 披萨 | 。 |
因为因果掩码的存在,在实际训练中,并不需要针对表格中的每一行都单独执行一次完整的 Transformer 前向传播。
而训练时,模型会看到真实的历史 Token,并学习预测每个位置对应的下一个 Token。这种方式通常称为 Teacher Forcing。所以,训练和推理存在一个重要区别:
- 训练阶段:后续真实 Token 已经存在于数据集中,可以并行计算多个位置的预测误差。
- 推理阶段:后续 Token 尚未生成,需要使用模型自己生成的 Token 继续预测。
完整预训练过程可以表示为:
flowchart TD
    A["大规模文本与代码语料"] --> B["数据清洗与 Tokenization"]
    B --> C["构建 Token 训练序列"]
    C --> D["Transformer 前向传播"]
    D --> E["预测各位置的下一个 Token"]
    E --> F["与真实目标 Token 比较"]
    F --> G["计算训练损失 Loss"]
    G --> H["反向传播 Backpropagation"]
    H --> I["优化器更新模型参数"]
    I --> D
总之,大概流程是这样,展开挨个细说太多了。,。
为什么预测下一个 Token,能够训练出复杂能力呢?
因为下一 Token 预测任务表面上非常简单,但想要在大量复杂文本上持续预测准确,实际上需要学习非常丰富的信息。
因此,下一 Token 预测虽然只是一个统一的训练目标,但为了完成这个目标,模型需要学习的不只是词语出现的频率,还包括上下文中的复杂结构与关系。所以说,LLM 的很多复杂能力,是在大规模语言建模任务中,通过参数优化逐渐形成的。
但是,能够预测和续写文本,但是按照用户指令完成任务,也不是一回事。一个仅经过预训练的基础模型,可能继续补全文本,也可能生成类似的指令示例,而不一定稳定地遵守用户要求。因为预训练主要优化的是对训练数据的语言建模能力,并没有专门要求模型始终遵循用户指令、遵守输出格式或者符合人类偏好。这个就涉及到监督微调以及其他对齐训练,使模型更擅长按照指令进行回答。
Loss
预训练中最重要的数学概念,就是损失函数(Loss Function)。玩 RVC 和 comfyui 的应该都知道
模型预测出来的是整个词表上的概率分布,而训练数据已经提供了正确的下一个 Token。因此,我们需要衡量,模型究竟给正确 Token 分配了多大的概率?来判断这个模型的本次训练,是否能够基本正确
这里通常使用交叉熵损失,对于一个正确 Token,其损失可以简化表示为: \[ L=-\log P(\text{正确 Token}\mid\text{上下文}) \] 假设正确答案是“苹果”:
- 如果模型只给“苹果”分配了 10% 的概率,损失约为 \(-\log(0.1)=2.30\)。
- 如果经过训练,模型给“苹果”分配了 80% 的概率,损失就降低为 \(-\log(0.8)=0.22\)。
可以看到,正确 Token 的预测概率越高,Loss 就越小。
对于包含多个 Token 的训练序列,模型会计算各个有效预测位置的损失,再进行求和或平均。所以,预训练的优化目标,就是让模型在大量训练数据上,尽可能降低下一 Token 预测的损失。
反向传播
得到了 Loss 之后,还需要将预测误差转化为参数来更新。这就是反向传播(Backpropagation)与梯度下降优化的工作。
我们之前介绍过,Transformer 中的 Embedding、QKV 投影矩阵、FFN、LM Head 等都包含可训练参数。
训练时,模型首先通过前向传播计算 Loss,随后通过反向传播,计算这些参数对 Loss 的影响,也就是梯度(Gradient)。优化器再根据梯度更新参数。不断计算预测误差,再通过梯度优化调整参数,让模型逐渐提高对真实训练数据的预测能力。
可以用最基本的梯度下降公式理解: \[ \theta_{\mathrm{new}} = \theta_{\mathrm{old}} - \eta \nabla_{\theta} L \] 其中:
- \(\theta\):模型中的可训练参数。
- \(\eta\):学习率(Learning Rate),决定每次更新的步长。
- \(\nabla_{\theta}L\):Loss 对参数的梯度,表示参数变化会怎样影响损失。
经过海量 Token 和大量训练步骤后,模型就会逐渐学习到数据中反复出现的规律。
对齐技术:SFT、RLHF、DPO 在改变什么
前面在说,一个经过充分预训练的模型,即使已经具备很强的语言建模能力,也不一定能够成为一个好用的 AI 助手。
例如,用户输入:
1 | 请解释 Java 中的 HashMap 为什么线程不安全。 |
一个基础模型可能继续生成类似的问题,也可能补全一段教材内容,而不一定按照用户的要求,给出准确、清晰、有条理的解释。因为预训练主要教模型如何预测文本,而不是专门教模型如何遵循用户指令、判断回答质量以及满足人类偏好。
因此,现代 LLM 通常还需要经过后训练(Post-training),通过不同的训练方法进一步调整模型行为。这里最有代表性的就是 SFT、RLHF 和 DPO。
对齐的核心并不是改变 Transformer 的基本运行机制,而是通过不同训练目标更新模型参数,让模型原本具备的能力更符合用户指令、回答质量要求与偏好标准
这部分的经典技术依据分别来自 InstructGPT:SFT、奖励模型与 PPO 和 Direct Preference Optimization 原论文
监督微调 SFT
SFT(Supervised Fine-Tuning,监督微调)通常是对齐训练的基础阶段。
核心是:使用人工编写、筛选或其他方式构造的高质量指令与回答数据,教模型学习符合预期的回答方式。
例如,一条 SFT 训练数据可能是:
1 | User: |
在训练过程中,模型接收用户指令及对应的标准回答,学习在给定指令的情况下生成期望的回答内容。其训练目标本质上仍然可以使用前面介绍过的交叉熵损失 \[ \mathcal{L}(\theta) = -\sum_{t=1}^{T}\log P_{\theta}(y_t \mid x, y_{<t}) \] 其中:
- xx:用户指令及相关上下文
- ytyt:标准回答中的第 tt 个 Token
- y<ty<t:标准回答中第 tt 个 Token 之前的所有 Token(即 y1,y2,…,yt−1y1,y2,…,yt−1)
- TT:标准回答的 Token 总数
- Pθ(yt∣x,y<t)Pθ(yt∣x,y<t):模型在给定上下文和前面已生成 Token 的条件下,预测第 tt 个 Token 为 ytyt 的概率
- L(θ)L(θ):以 θθ 为参数的损失函数
这个公式的含义是:对标准回答中每个位置的 Token,模型预测其概率的对数取负后求和,等价于最小化负对数似然,也就是让模型在看到用户问题后,提高生成标准回答中各个 Token 的概率。
经过 SFT 后,模型就能够逐渐学习如何理解指令、组织回答、遵守输出格式,以及在不同任务中采取合适的表达方式。
但是,SFT 也存在局限。
因为对于同一个问题,可能有很多种合理回答,你很难为每个问题定义唯一的标准答案。
SFT 擅长让模型模仿高质量回答,却不一定能够充分表达不同回答之间的相对优劣。
这就引出了基于偏好反馈的训练方法。
基于人类反馈的强化学习 RLHF
这就是很多 AI 后训练公司天天在做的事情,工作内容就是 AI 生成很多份回答,你对回答进行排序,两两比较哪个好哪个不好,然后给出原因,让 AI 重新生成,然后重复,据我所知豆包就是依赖大量的 RLHF 来进行一些生成代偿的
RLHF,Reinforcement Learning from Human Feedback,基于人类反馈的强化学习:它不只是告诉模型应该怎样回答,还通过人类偏好反馈,让模型学习哪些回答更值得选择。
例如,对于同一个问题,模型生成两个回答:
1 | 问题: |
很明显,回答 A 更准确,回答 B 则存在错误的性能判断。因此,可以让标注人员比较这两个回答,并选择更好的那个。
在经典 RLHF 实现中,训练通常分为两个主要步骤。
训练奖励模型
模型针对同一个 Prompt 生成多个候选回答,再由人工进行排序或两两比较。通过这些偏好数据,训练一个奖励模型,使它能够预测某个回答获得人类偏好的程度。
使用奖励信号优化语言模型
有了奖励模型以后,就可以让语言模型继续生成回答,再根据奖励模型的评分调整模型参数。
经典的 InstructGPT 方案使用 PPO(Proximal Policy Optimization,近端策略优化)进行强化学习。具体公式长的要命,不占阿卡i了,总之,训练希望提高期望奖励,使模型更倾向于生成符合偏好的回答。
因为如果只追求奖励模型的分数,模型可能学会利用奖励模型的缺陷,生成评分很高但实际质量不佳的回答,这类问题通常称为 Reward Hacking(奖励投机)。
其典型流程可以表示为:
flowchart TD
    A["经过 SFT 的模型"] --> B["针对 Prompt 生成多个回答"]
    B --> C["人工比较回答质量"]
    C --> D["构建偏好数据集"]
    D --> E["训练 Reward Model"]
    E --> F["奖励模型为新回答评分"]
    F --> G["PPO 等强化学习算法"]
    G --> H["更新语言模型参数"]
    H --> F
直接偏好优化 DPO
经典的 RLHF-PPO 虽然能够利用偏好反馈,但训练流程相对复杂。因为它需要额外训练奖励模型,还需要在强化学习过程中不断生成回答、计算奖励并更新策略。而且需要依赖大量人力。
那么,既然我们已经知道人类更喜欢哪个回答,能不能直接利用这些偏好数据来训练语言模型?
这就是 DPO(Direct Preference Optimization,直接偏好优化)的思路。
DPO 的核心特点,是不再单独训练显式奖励模型,也不需要执行传统的 PPO 强化学习循环,而是直接利用偏好数据优化语言模型。
假设一条训练数据包含:
1 | Prompt: |
DPO 会同时考虑这两个回答。
它使用的是一种基于偏好差异的优化目标,并引入参考模型(Reference Model)作为比较基准。
其流程可以表示为:
flowchart TD
    A["经过 SFT 的模型"] --> B["准备偏好数据集"]
    B --> C["Prompt + Chosen + Rejected"]
    C --> D["当前模型计算回答概率"]
    C --> E["参考模型计算回答概率"]
    D --> F["计算 DPO Loss"]
    E --> F
    F --> G["反向传播更新当前模型"]
G --> D因此,DPO 本质上是在直接调整模型对不同回答的相对偏好,而不需要先训练一个独立的奖励模型,再通过 PPO 更新模型。
他虽然更简单,不过,DPO 的优化效果仍然依赖偏好数据质量、参考模型和训练配置,并不意味着一定比所有 RLHF 方法表现更好。另外,DPO 的偏好数据也可以来自人工标注、AI 评审或者其他来源,因此它并不要求每一条训练样本都必须由人类直接标注。
上下文学习与提示 In-Context Learning
前面我们已经知道,预训练和 SFT、DPO 等后训练方法,都需要通过优化目标更新模型参数,从而改变模型的能力或者回答行为。
现代 LLM 还有一种非常有意思的能力:即使不修改模型参数,只需要在 Prompt 中提供任务说明和少量示例,模型就可能学会按照示例中的规律完成新的任务。
这就是上下文学习(In-Context Learning,ICL)。
它最具代表性的研究来自 2020 年 OpenAI 发表的论文 《Language Models are Few-Shot Learners》。
假设我们希望模型对用户反馈进行分类,分类结果只能是:
- 性能问题
- 稳定性问题
- 功能建议
如果只是直接提出要求:
1 | 请对下面的反馈进行分类: |
模型可能知道应该怎么回答,但如果我们希望它严格遵守某套业务分类规则,可以在 Prompt 中增加几个示例。
例如:
1 | 你需要将用户反馈分为: |
这时,模型就有可能根据前面的示例,进行更加准确的输出
关键是,我们并没有为这个分类任务专门训练模型,也没有修改模型的任何权重,而是在输入上下文中临时提供了任务示例。模型通过这些示例,可以推断当前任务的输入形式、候选标签以及分类规则,并将这些信息应用到新的输入上。这个内容引起了提示词工程的热潮,人们发现,可以从提示词的角度大幅的优化 AI 的输出,这就叫做 In-Context Learning。
根据 Prompt 中提供的任务示例数量,上下文学习相关的提示方式通常可以分为以下几种:
| 类型 | 提供的示例数量 | 主要特点 |
|---|---|---|
| Zero-shot | 0 | 直接通过任务说明完成任务 |
| One-shot | 1 | 提供一个输入输出示例 |
| Few-shot | 少量 | 提供多个示例,帮助模型识别任务规律 |
其中,Zero-shot 更准确地说属于不提供示例的提示方式,而典型的 ICL 研究主要关注模型如何利用 Prompt 中的示例进行任务适应。
那么,是不是示例越多越好?肯定不是啊。示例增加会占用更多上下文 Token,而且如果示例存在错误、相互矛盾,或者与目标任务差异很大,反而可能干扰模型的判断。所以说,Few-shot 的关键在于通过少量具有代表性的示例,让模型准确识别当前任务。
从机制上说,ICL 依赖的是模型预训练形成的模式识别和上下文建模能力。
从工程上说,它为应用开发提供了一种低成本的任务适配方式,可以通过设计高质量 Prompt 和 Few-shot 示例,改变模型在当前请求中的回答行为。
ICL 为什么不需要更新模型参数?因为,ICL 可以理解为一种发生在推理过程中的任务适应能力。
原本模型只根据当前问题预测回答,而加入示例后,模型会同时参考这些示例来预测回答。发生改变的是模型的输入上下文,而不是模型参数。示例和当前问题会一起进入 Transformer,模型通过注意力机制处理它们之间的关系。模型就可以利用上下文中的示例,识别输入应该是怎样的文本、输出应该使用哪些标签,以及不同反馈特征可能对应什么分类。
flowchart TD
    A["模型已有的预训练参数"] --> D["Transformer 前向传播"]
    B["Prompt 中的任务说明与 Few-shot 示例"] --> D
    C["当前需要处理的新输入"] --> D
    D --> E["结合示例推断当前任务规律"]
    E --> F["生成符合任务要求的回答"]
    F --> G["返回结果"]
在这个过程中,不需要执行反向传播,也没有新的参数更新步骤。因为不同的 Prompt 会形成不同的隐藏状态和注意力关系,进而改变模型的输出概率分布。
接下来是一个更深入的问题:为什么模型只看几个示例,就能够知道自己应该做什么?
从原理上看,这与预训练形成的能力密切相关。在大量文本和代码中,模型接触过许多具有共同结构的内容,例如问答、分类、翻译、程序示例和连续的输入输出对应关系。为了准确预测这些文本的后续内容,模型需要学习如何识别上下文中的模式,并利用已有模式预测后续结果。
因此,模型可以在推理阶段,将 Prompt 中提供的示例看作当前任务的线索,利用已有参数和上下文计算能力进行模式识别。
2022 年的论文 《An Explanation of In-context Learning as Implicit Bayesian Inference》,就提出了一种理论解释:模型可以通过上下文中的多个示例,推断它们所共享的潜在任务或概念,再利用这个概念完成新的预测。
示例并不是直接向模型写入新的规则,而是在帮助模型从已有能力中识别当前应该使用哪一种规律。
模型可以根据 Prompt 中的少量示例,识别当前任务的输入特征、输出形式和潜在规律,并利用已有参数完成新的预测,而不需要执行微调或更新权重。
当然,这是一种具有理论与实验支持的解释框架,并不是所有大语言模型内部都严格按照某一种贝叶斯推断算法工作。ICL 的完整机制,目前仍然是研究课题。谁研究明白了,IEEE 肯定就给谁狠狠的展示
LLM经典问题
幻觉、上下文窗口与长文本处理
前面我们已经完整了解了 LLM 从预训练、Transformer 前向传播到自回归生成的过程。
但是,有一个很实际的问题,模型可以生成语言流畅、结构完整,甚至看起来非常专业的回答,却不代表回答中的事实一定正确。而且,当输入上下文越来越长时,即使我们已经把相关信息提供给模型,它也可能遗漏关键内容、错误关联不同段落的信息,甚至生成与原文不一致的结论。
幻觉是指模型生成了与事实不符、与提供的证据矛盾,或者缺乏相应依据的内容。
在论文 《Survey of Hallucination in Natural Language Generation》 中,研究者将与源内容相关的幻觉分为两种典型类型:
- Intrinsic Hallucination(内部幻觉):生成内容与提供的源信息直接矛盾。
- Extrinsic Hallucination(外部幻觉):生成内容无法从提供的源信息中得到验证。
相关的,在实际工程中,有两个概念:
- Factuality(事实正确性):回答是否符合客观事实。
- Faithfulness(来源忠实性):回答是否忠实于指定的输入文档或证据。
我们都知道,LLM 的生成目标并不是直接验证一句话是否真实,而是根据当前上下文计算下一个 Token 的概率分布。这能不产生幻觉就怪了,都是条件概率,造成幻觉的原因通常很复杂,但是一些最后都会归因到沟槽的条件概率中。自回归生成会让前面生成的错误内容影响后续预测。
而且,前面我们已经介绍过,上下文窗口限制的是模型能够接收多少 Token,而不是保证模型能够准确理解其中的全部信息。
- 信息进入上下文:目标内容已经包含在输入 Token 中。
- 模型定位相关信息:能够从大量内容中识别哪些部分与问题有关。
- 模型正确使用信息:能够结合证据完成推理、比较或者生成准确结论。
很明显,完成第一步,不代表后面两步也一定成功。
例如,我们将一份包含数百页内容的项目设计文档直接提供给模型,询问:
1 | 任务进度计算模块中,权重发生变化时, |
假设文档中确实存在相关说明,但是它位于大量架构介绍、接口定义和其他业务规则之间。那么,模型需要先找到这部分内容,再结合其他相关约束进行判断。如果没能正确定位或者理解这些条件,就可能给出错误答案。
关于这一现象,2024 年发表于 TACL 的论文 《Lost in the Middle: How Language Models Use Long Contexts》 进行了系统研究。研究发现,在其测试的多文档问答和键值检索任务中,模型对相关信息的位置比较敏感,信息位于上下文开头或结尾时,表现往往更好;而位于中间时,性能可能明显下降。
所以,长上下文问题并不只是上下文长度的问题,还涉及相关信息的定位能力、不同信息之间的关联能力,以及无关内容对模型判断的干扰。
这也意味着,即使模型支持 128K、200K 甚至更长的上下文,也不应该默认把所有资料一次性塞进去。那么,面对几百页的文档、整个代码仓库或者大量企业知识资料,应该如何组织模型输入?从工程角度来看,需要先区分任务到底是寻找局部信息,还是理解整份文档。
局部信息查询,优先采用RAG。先将文档切分并建立索引,查询时检索相关片段,再将这些内容作为证据提供给模型
全文理解与归纳,采用分块处理和层次化汇总。如果用户希望分析的是整份文档,而不是其中某个局部问题。此时,可以采用分块处理、分层摘要以及汇总归纳等方法。
例如,将大型设计文档按照章节和语义边界划分成多个部分,先分别提取各部分的关键内容,再将结果进行合并分析。
这种方式通常被称为层次化摘要(Hierarchical Summarization),Map-Reduce 式汇总也是其中一种常见实现思路。
到这里,我们已经知道幻觉可能来自知识不足、上下文利用错误以及生成过程中的错误延续。
因此,缓解幻觉不能只依靠修改 Prompt 或采样参数,而应该根据错误来源选择相应的解决方式。
| 问题来源 | 常见缓解方式 |
|---|---|
| 模型缺少事实知识 | RAG、外部知识库、联网检索 |
| 输入上下文过长或无关信息太多 | 检索过滤、重排序、上下文压缩 |
| 回答与来源不一致 | 来源引用、事实核验、证据一致性检查 |
| 数学或精确计算不可靠 | 调用计算器、代码执行器等确定性工具 |
| 输出格式不稳定 | JSON Schema、约束解码、结果校验 |
| 缺少足够证据 | 明确允许模型表达不确定性或无法判断 |
给模型提供引用来源,并不意味着它的回答一定正确。因为概率。。。因此,在需要较高准确性的系统中,最好能够将模型输出拆分为具体的事实性陈述,再逐项判断它们是否具有足够的证据支持。
2023 年 EMNLP 的论文 《FActScore: Fine-grained Atomic Evaluation of Factual Precision in Long Form Text Generation》 就提出,将长文本回答拆分为多个原子事实(Atomic Facts),再检查这些事实能否得到可靠知识来源的支持。
所以说,降低幻觉的关键,不只是让模型生成更加可信的文字,而是让事实性回答能够被外部证据验证。
最后,幻觉与长文本处理,是 LLM 运行机制中两个紧密相关的经典问题。
- 幻觉的根本问题在于,模型通过学习和生成 Token 概率来构造回答,并不天然具备严格的事实验证机制。因此,即使输出语言流畅,也可能包含错误或缺乏依据的内容。
- 长文本处理的问题则在于,上下文容量并不等于上下文利用能力。即使相关资料已经进入上下文,模型仍然需要准确定位、关联并使用这些信息。
机制视角下的能力边界总结
LLM 究竟擅长什么,又为什么在一些看起来非常简单的任务上,仍然可能出现明显错误?
根本在于沟槽的条件概率啊,概率建模能力,不等于事实验证能力,LLM 的核心能力建立在对复杂数据分布的学习上。它可以从大规模训练数据中学习语言、知识、代码和推理模式,再根据输入上下文生成相应的内容。
但是,模型能够生成一个合理的回答,不代表它已经验证了这个回答。所以,对于要求较高的事实准确性,不能完全依赖模型自身生成的答案,还需要引入检索、事实核验或者其他验证机制。这也是后训练中的重要一步,也是很多 skill,插件 要做的任务。
其次,模型在预训练中学到的知识,主要通过参数表示。
这些参数可以让模型在不访问外部数据库的情况下回答很多问题,但参数并不是一个能够随时更新的实时知识库。学到的知识,不等于能够实时获取的知识,模型参数决定它已经学会了什么,而上下文与外部系统决定它当前还能利用什么信息。
推理能力,不等于所有计算都能可靠完成
经过预训练和后训练,现代 LLM 可以表现出复杂的数学推理、代码理解、逻辑分析和问题求解能力。但是,模型生成推理步骤,和传统程序执行严格确定的运算,并不是同一种机制。当任务涉及大量精确数值计算、复杂状态变化或者必须严格执行的业务规则时,仅依靠 Token 生成就可能出现错误。
因此,LLM 可以负责理解问题、组织求解过程和选择计算方法,但对于必须保证正确的结果,应该优先交给确定性工具执行。
上下文容量,不等于稳定的信息利用能力
这个前面已经说的很详细了,Lost in the Middle,还是那句话,真正有效的上下文管理,需要根据当前任务决定哪些信息应该保留、压缩、检索或者重新加载。上下文窗口解决的是模型能接收多少信息,而上下文工程解决的是如何让模型获得并有效使用真正需要的信息。
语言模型能够规划任务,不等于能够独立执行任务
LLM 可以理解用户目标、制定执行步骤,甚至生成工具调用所需的参数。但是,操作是否成功、是否满足权限要求,以及失败后如何重试,都需要执行系统进行处理。而这就引出了 LLM 与 Agent 系统之间的重要区别:
LLM 主要提供语言理解、推理和决策能力,而 Agent 系统通过工具调用、状态管理、执行反馈与流程控制,将模型的决策连接到真实的业务环境。
模型能力提升,不等于可靠性自动得到保证
最后,还有一个值得注意的问题。
我们经常看到模型随着参数规模、训练数据和计算资源增加,在很多任务上取得明显进步。但这并不意味着模型规模越大,所有能力都会以相同速度提高,更不意味着某个任务一旦能够完成,就会始终稳定完成。
例如,同一模型可能在常见的代码生成任务中表现很好,但面对少见的业务约束、复杂的跨步骤依赖或者训练数据覆盖不足的情况时,仍然可能出现错误。
所以,评估一个模型不能只看参数规模、某几个 Benchmark 分数,或者一次成功的生成结果,而应该关注它在实际任务中的正确率、稳定性和错误类型。
最后,结合前面的讨论,我们可以把现代 LLM 应用理解为两个层次。
- 第一个层次是模型本身的能力,包括自然语言理解、知识表达、推理、生成和任务规划。
- 第二个层次是外部系统提供的可靠性保障,包括数据检索、工具执行、权限控制、状态管理和结果验证。
二者可以按照下面的方式配合:
flowchart TD
    A["用户任务"] --> B["LLM 理解任务与制定方案"]
    B --> C{"任务需要什么能力?"}

    C -->|知识与证据| D["RAG / 数据检索"]
    C -->|精确计算| E["计算器 / 代码执行"]
    C -->|业务操作| F["API / 业务工具"]
    C -->|普通文本生成| G["直接生成回答"]

    D --> H["获取外部结果"]
    E --> H
    F --> H

    H --> I["LLM 整合信息并生成结果"]
    G --> J["输出验证"]
    I --> J

    J --> K{"是否满足任务约束?"}
    K -->|否| L["修正、重试或报告失败"]
    L --> B
    K -->|是| M["返回最终结果"]
最后,LLM 通过大规模训练学习复杂的数据规律,通过 Transformer 建立上下文表示,通过自回归生成完成语言输出,并通过后训练和上下文学习适应不同任务。LLM 的能力边界并不等于它绝对无法完成某类任务,而是意味着某些任务仅靠模型本身,无法提供我们在实际工程中所要求的可靠性保证。
基础大模型的允许机制,就差不多讲完了,写死我了
分享文章
微信扫码
 用微信扫一扫打开,再从微信菜单分享给好友或朋友圈。